ARTICLE · 1090901
把 6 份企业文档交给 Seed-2.1-pro-0915 制作的审计skill,它连一张没有文字的流程图都没放过
EDITOR'S NOTE
硬数字前置先把几个硬数字放前面,没时间的朋友看完这段就可以走了。这次扛大梁的模型是 Seed-2.1-pro-0915,我冲的就是它的视觉理解和 Agent 工具调用,这场文档审计正好两样都用上了。6 份真实格式的企业文档丢进去,出来 13 条确认过的问题,10 条高风险 3 条中风险,51 条证据每一条都能点回原文找到出处。评测里 49 个考察点命中 46 个,误报 0。模型返回的原始内容全部留档,一个字没动过。
01
PART
模型到底能不能干审计的活
THE QUESTION
事情是这样的。
前阵子我在琢磨一件特别具体的事。企业里每年不知道有多少合同、报价单、付款申请要人工过一遍,审的人得把每一笔金额、每一个日期、每一条审批链在脑子里对齐,跨文档对不上就是风险。这活又烦又重要,烦在琐碎,重要在漏了是真赔钱。
我就想,这事儿现在的模型到底能不能干。
不是能写两句总结的那种能干,是真能像审计一样,读文档、查规则、给结论,而且每个结论都能把原文指给你看的那种能干。想验证就别纸上谈兵,我把火山方舟上的 Seed-2.1-pro-0915 接成了这套系统的审计大脑,系统取名 Enterprise Document Audit,然后把 6 份真实格式的采购语料丢了进去。带文字层的 PDF 合同、XLSX 报价单、PDF 付款申请单、PDF 采购制度,还故意塞了一张没有文字层的 PNG 审批流程图。
为什么说故意,一会儿讲到那张图你就明白了。
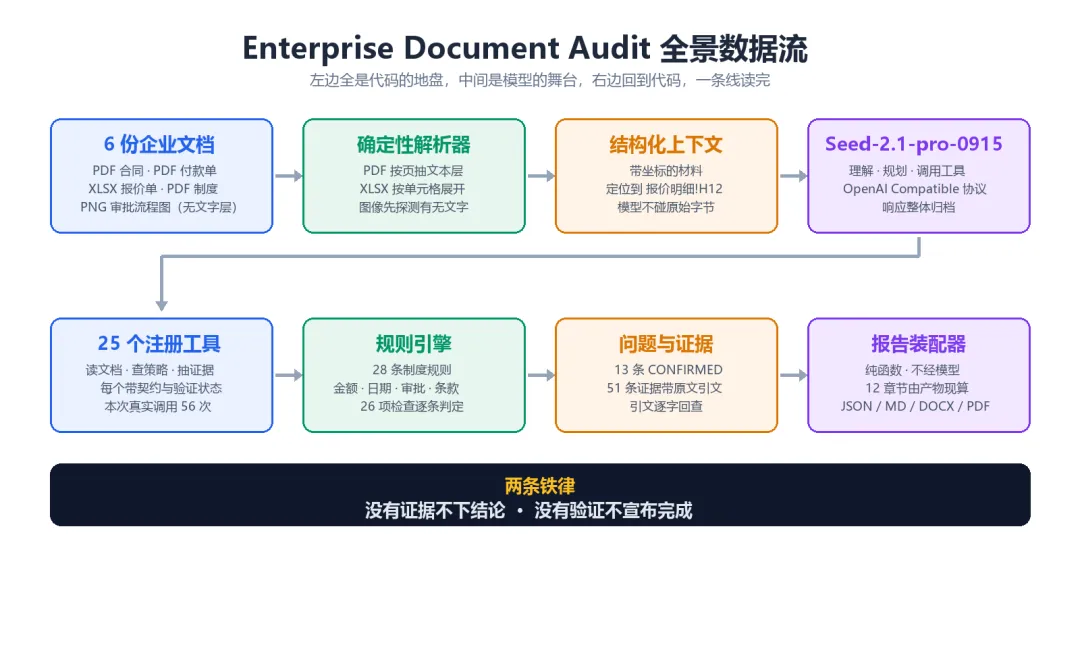
整个系统怎么转的,我先画了张全景图放这,后面每一节都能对上号。
02
PART
先看结果,13 个问题全都能回原文
THE RESULTS
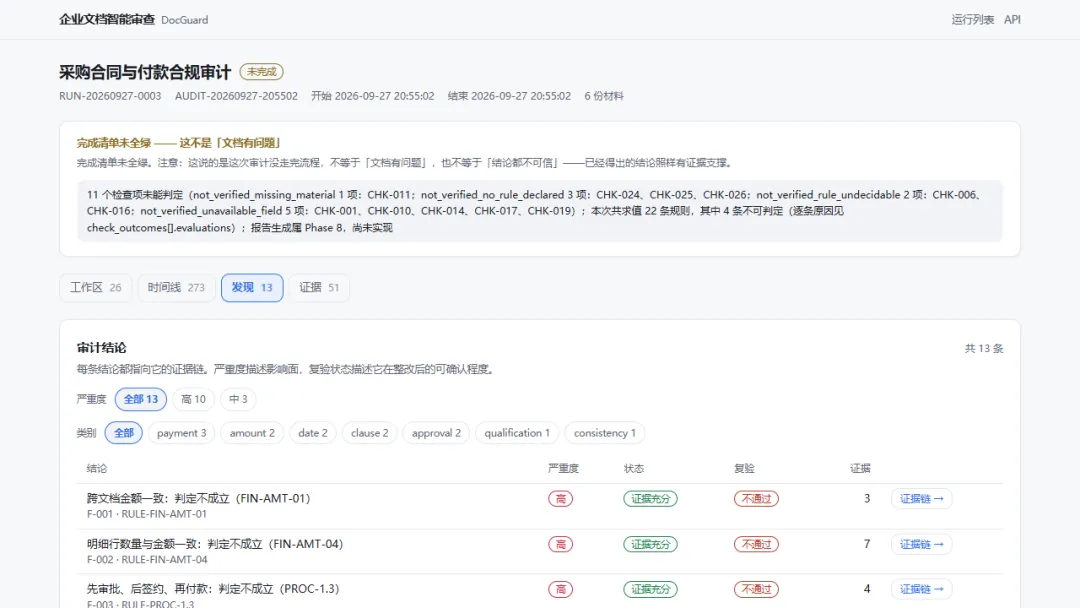
13 条问题,全部 CONFIRMED,10 条高风险 3 条中风险。有跨文档金额对不上的,有合同还没签钱先付了的,有货都交付了审批还没走完的。每一条都挂着对应的制度条款,比如 PROC-2.3,未经批准不得采购。
下面这张是 Findings 页的实拍。不是我挑的好看部分,它就长这样。
证据这块是我较真到底的部分。我给系统立了个规矩,每一条结论必须挂证据,每一条证据必须带原文引文和定位,而且文本类的引文会被代码拿回原文里逐字比对,对不上就不给过。
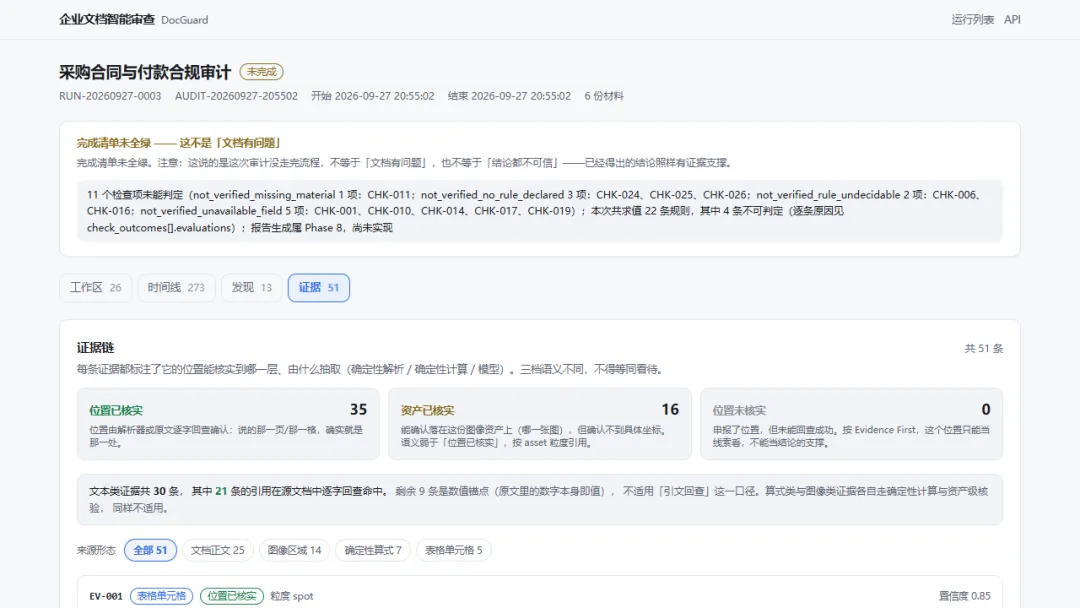
Evidence 页长这样,51 条证据按问题归组。
给你看条具体的。编号 EV-001 这条证据,定位在报价明细表的 H12 单元格,引文是 994400.0,回查状态是逐字命中。
什么概念呢,就是这个数字确实一个字符不差地躺在那张表的那个格子里。不是模型转述的,不是它理解出来的,是它真在那。你点开证据,再点开定位,原文就在那等着你。审计这个东西,说服力就藏在这种地方。
单条问题的详情页长这样,规则依据、证据链、整改建议全摊在一张页面里。
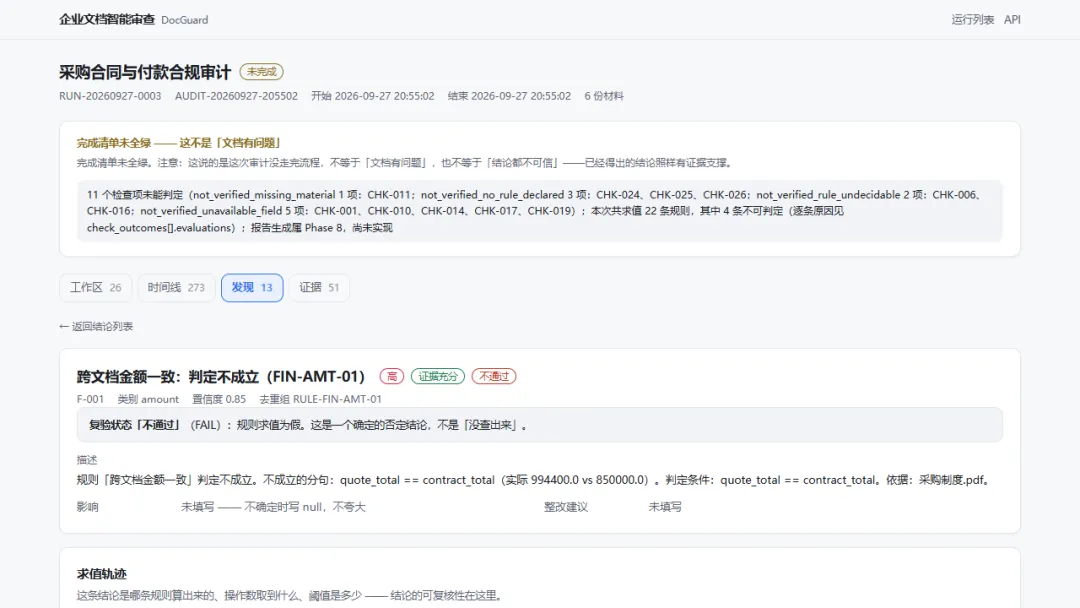
那 51 条证据里,有 35 条是文本类逐字命中的,还有 16 条指向图片,主要就是那张没有文字的流程图。这两类的确信度天然不一样,一个能逐字对,一个只能看图说话,所以系统分成两档标,没有混在一起糊弄。
03
PART
一张没有文字的流程图,它真看懂了
VLM IN ACTION
对,那张流程图,6 份语料里我特意留的一道坎。
05_审批流程.png,PNG 格式,图里没有任何文字层。文本解析器跑到它面前只能交白卷,想读出里面的审批链,只能靠视觉模型去看图。
Seed-2.1-pro-0915 这次调用全程留痕,耗时 85.1 秒,输入 2662 个 token,输出 4877 个,其中 2509 个是思考 token。响应里的服务版本号是 doubao-seed-2-1-pro-260915,对应活动口径的 Seed-2.1-pro-0915。它从图里读出了4 个文本块和 25 组键值对,审批链上的关键节点和流转方向都拿到了。
一个连字都没有的图,它真的看懂了。我当时盯着这份响应看了挺久。
04
PART
它是怎么转的,模型不碰原始字节
UNDER THE HOOD
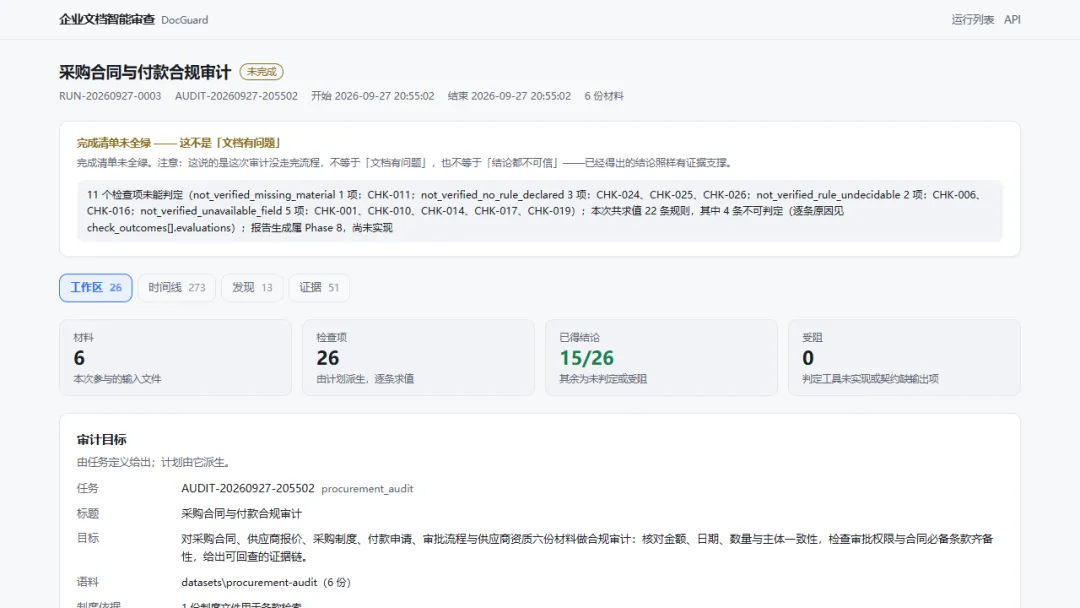
有个设计我想单独拎出来讲,模型从头到尾不碰文档的原始字节。PDF 是代码按页拆的,XLSX 是代码按单元格展开的,模型拿到的是拆好、带坐标的结构化材料。它负责理解,不负责转录。这一刀切下去,后面所有的数字才都有据可查。
Workspace 页能看到 6 份文档的解析清单,哪份走文本通道,哪份走视觉通道,都在明面上。
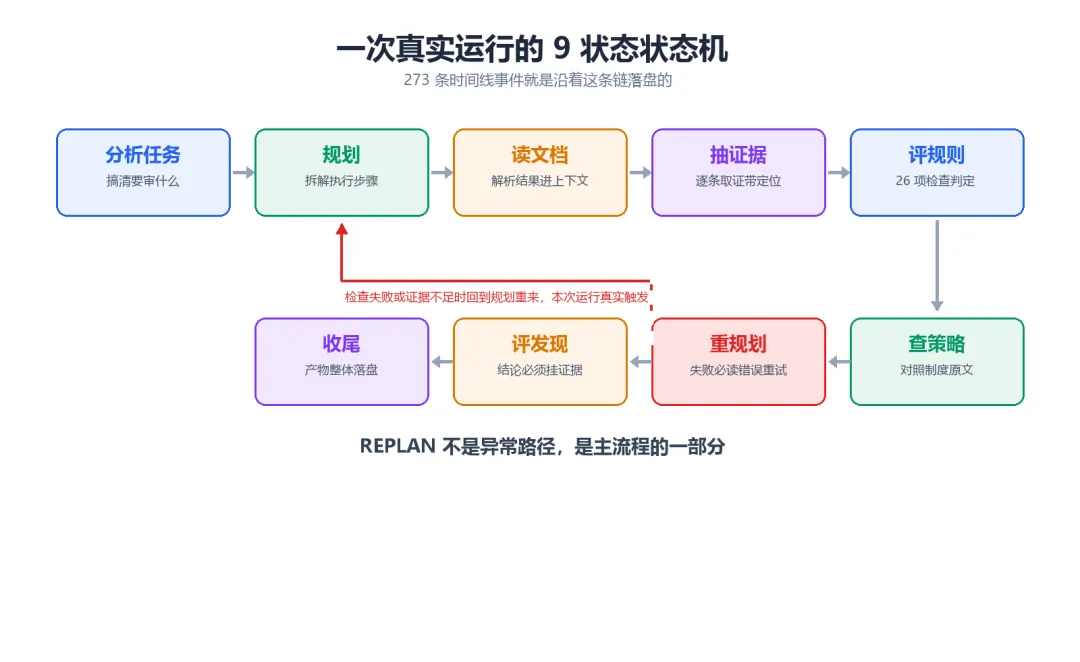
模型也不是拿到文档就开写。它跑在一条9 个状态的状态机上,从分析任务开始,规划、读文档、抽证据、评规则、查策略,一路到评发现、收尾。这条链我也画了出来。
这次真实运行一共发生了 56 次工具调用,Timeline 页把 273 条事件按顺序全铺开了,哪一步调了哪个工具、传了什么参数、返回了什么,全能查。
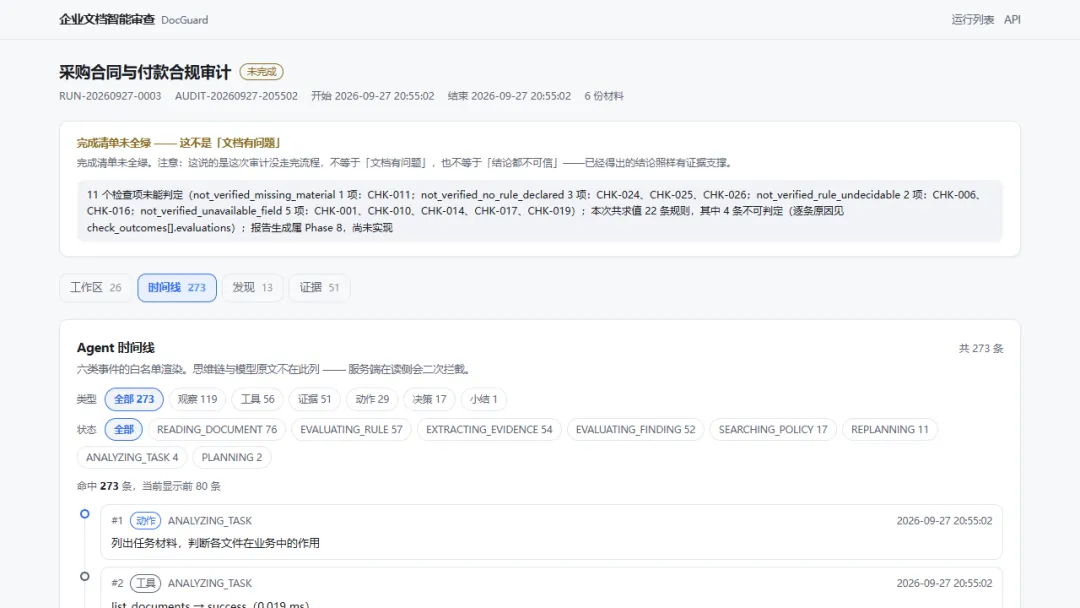
状态机里那个重规划,我想单独说一下。它不是摆设,这次运行它真的被触发了。检查失败或者证据不够的时候,模型必须读着错误信息重新规划,不许假装拿到结果。你想想看,一个人干活出了错是圆过去还是回头重来,这个区别太大了。
05
PART
较真的地方,分母里装的是什么
THE DETAILS
前面说每条结论必须挂证据,落到工程上是一套分流机制,我也画了图。
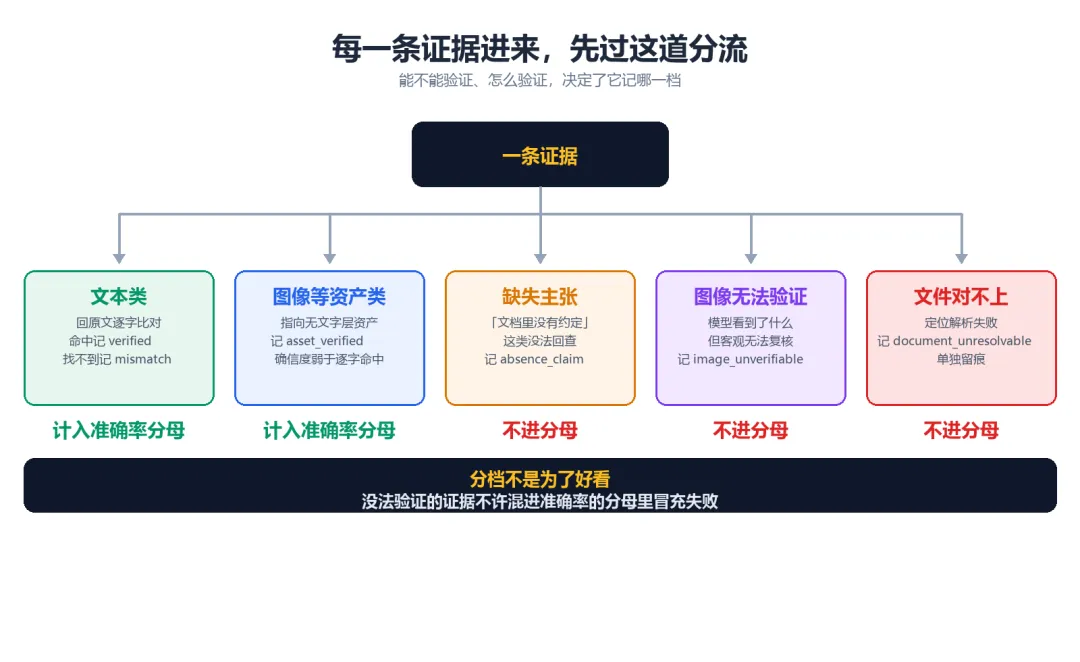
文本类的证据要过逐字回查,原文里找得到这句话才算命中。图片类的单独记档。还有一类特殊的,比如「文档里没有约定违约条款」这种缺失主张,压根没法回查,也得单独记。为什么要费这个劲分档,下面这个故事就是原因。
评测的时候,证据准确率头一版算出来是 0.4828。
我盯着这个数字愣了半天。一半都错了,模型在瞎编?
排查了一圈发现,是我冤枉它了。有 13 条证据压根没法验证,5 条缺失主张,8 条图像证据,初版的算法把它们全塞进了失败的分母里。把没法验证的请出分母之后,命中的一条没变,分数是 0.875。
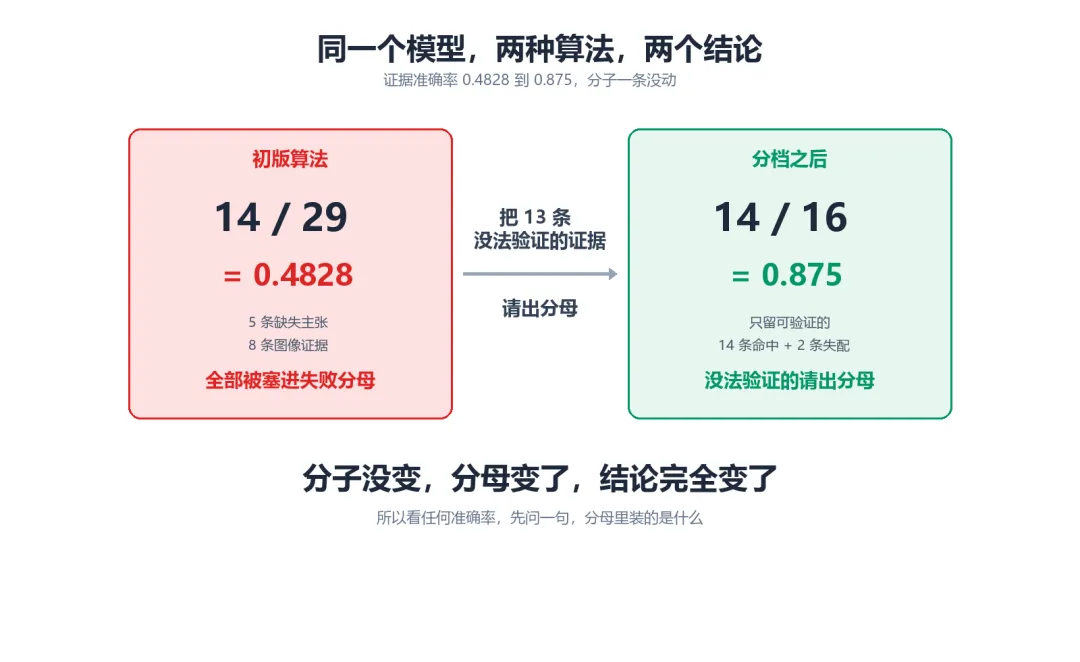
这件事给我的触动比 0.875 本身大。
评一个模型的指标,分子人人都会看,分母才是藏猫腻的地方。把不该进分母的东西悄悄塞进去,一个好好的模型就被评成了半吊子。反过来想,你要想让一个产品显得差,根本不用造假,把口径混一混就够了。所以现在我看到任何准确率,都习惯先问一句,分母里装的是什么。
06
PART
报告不经模型,一个字都不经过
NO LLM INSIDE
报告这块,我的立场相当偏执。
审计报告要是让模型自由发挥,它一定写得比你想象中流畅。但金额、日期、页码这种东西,流畅和正确是两回事。所以我做了个近乎偏执的决定,报告装配器是运行产物的纯函数,模型的选项是零。12 个章节全部由代码从运行产物里现算,执行摘要、审计范围、发现、证据、整改建议、复验结果,一个字都不经过模型。
出来的是一份 20 页的 PDF,中文字体真文本渲染,不是截图贴图。同一份数据同时出 Markdown、DOCX 和 JSON,四种格式一个字都不差。固定输入跑两遍,输出逐字节相同。审计报告要是连自己都没法复现,那审个什么劲呢。
还有件事我决定如实写出来,虽然它不那么体面。这次运行的 26 项检查里,有 11 项没判定,端到端状态挂的是 FAILED。不是全绿。我没让它硬凑成绿的。取不到证据的检查就挂着,没验证过的结论就标着,页面上明明白白给你看哪 11 项没判定、为什么没判定。
敢把 FAILED 挂在脸上,恰恰是我觉得这套系统真正像审计的地方。
07
PART
踩过的坑,都是真金白银
PAIN POINTS
推理模型在多模态大输入上真的很慢。6 份文档完整跑一轮,180 秒的默认超时根本不够,任务直接被误判成失败,把超时改成 900 秒才踏实。对这个模型来说,慢不是故障,是它的工作方式。
还有个经典悲剧。改完代码重新构建,页面行为死活不变,排查半天,是一个残留的旧服务还霸占着 3000 端口,新的根本没接到请求。从此我养成一个习惯,行为诡异先查端口被谁听着。
戏剧性拉满的是截图那天。为了给这篇文章配真实截图,我必须用生产模式起服务,结果当场抓出一个开发模式下完全看不见的 bug,表格组件非法嵌套,生产模式必现报错。你说巧不巧,截图这个动作本身救了一次场。
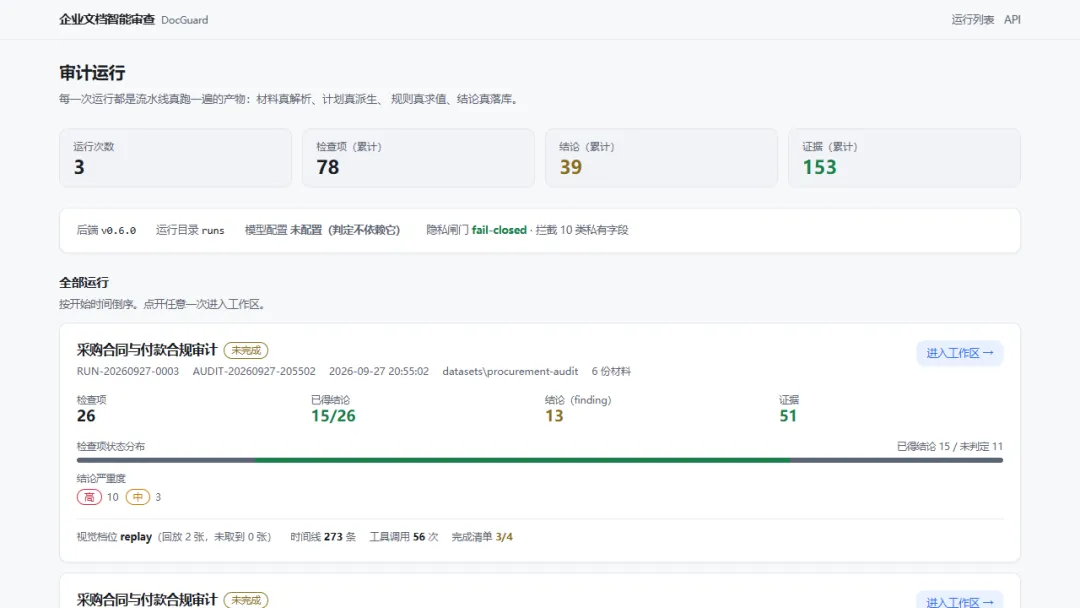
对了,三次真实运行的完整记录都在一个列表里,哪次跑了什么、出了什么结论,点进去都在。
08
PART
读查证改验,五个字的闭环
THE LOOP
整个系统拆开其实就五个字,读、查、证、改、验。我也把它画成了图。
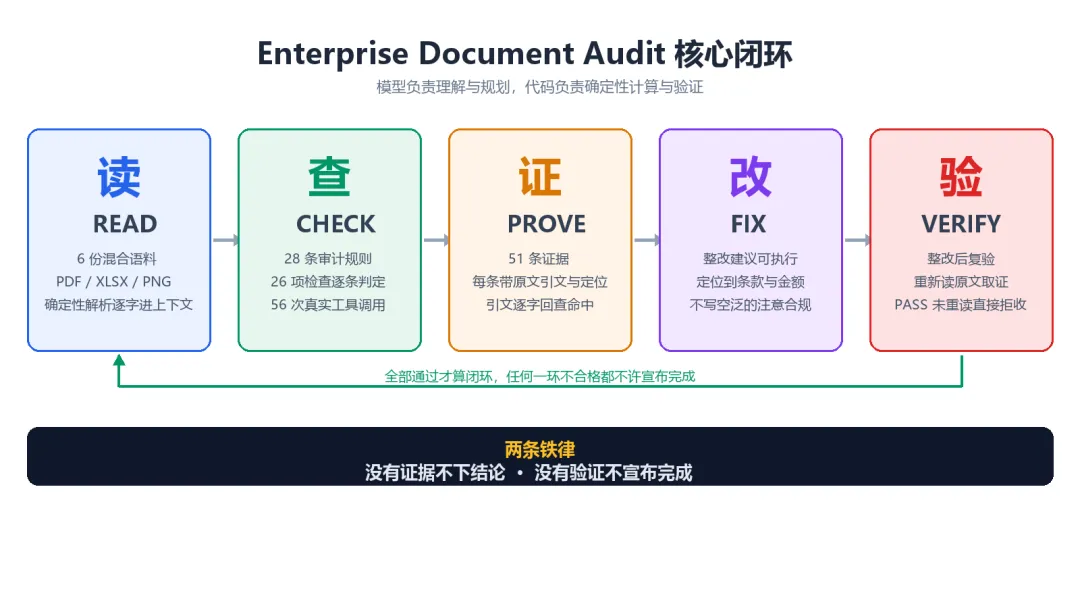
写到这,认真夸一夸这次的模型。整场跑下来,Seed-2.1-pro-0915 有三个表现让我真实服气。头一个是视觉理解的细,那张没有文字的流程图,它不光读出了审批链,连 25 组键值对这种颗粒度都给抠出来了。第二个是工具调用的诚实,56 次调用里有失败的,它的反应不是编个结果糊弄过去,而是读着错误信息重新规划,这个习惯放在真实生产环境里太值钱了。再一个是长程任务的稳,6 份文档 273 条事件跑下来不跑偏,该挂起的检查就如实挂着。能力这东西,得真跑过一遍才知道真假。
对了,这次用的都是火山方舟的 API,其实还有个更轻的入口。豆包工作这个 app 里现在也能直接选到这个模型,选中豆包 2.1 Pro就能让它上手干活,不用自己写一行代码。像丢几份文档进去让它找问题这种活,在豆包工作里就能跑。
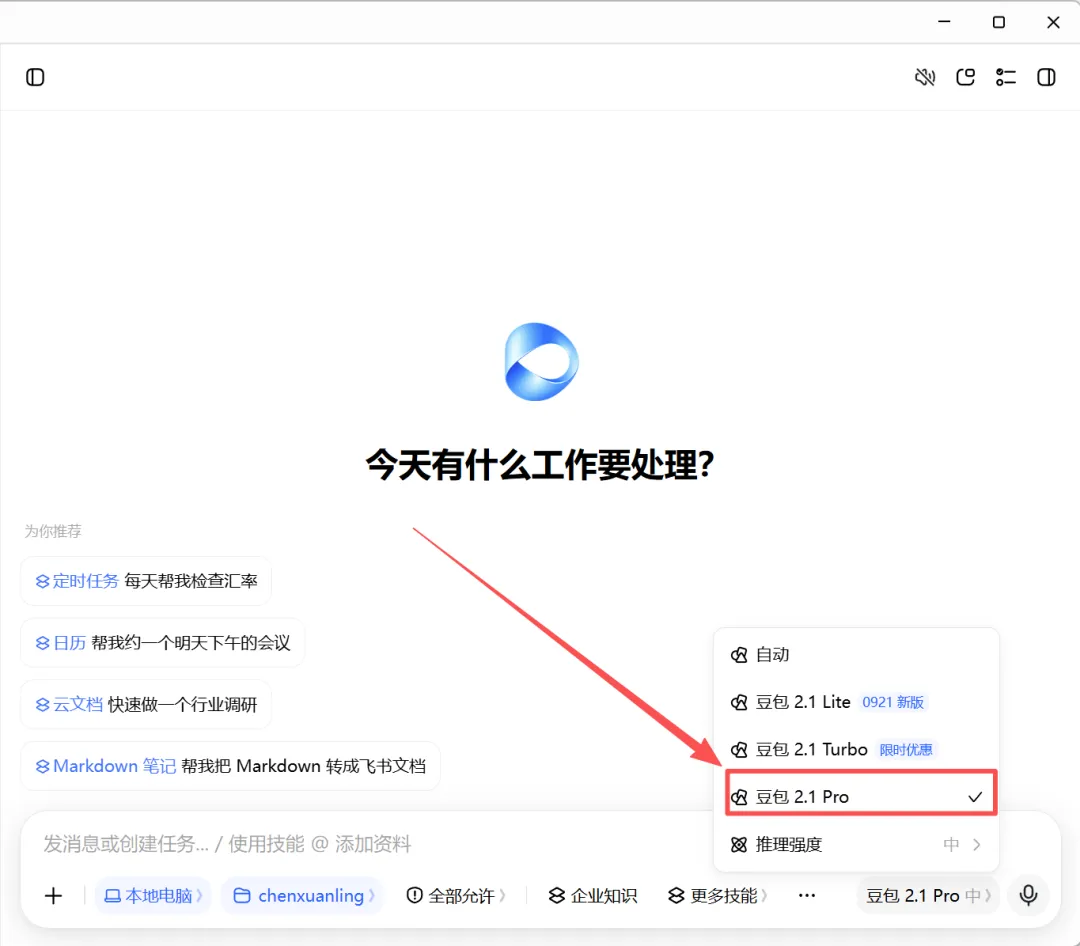
你要是对这套审计玩法感兴趣又不想搭环境,从豆包工作入手是条相当顺的路。
///
END
这趟跑完,我的判断标准变了
CLOSING THOUGHTS
做完这个项目,我对「模型能不能干活」的判断标准变了一点。难的从来不是读懂合同,是在该认输的地方认输。图像读不透就如实分档,证据取不到就不硬凑,没验证过就拒收,11 项没判定就挂着 FAILED。Seed-2.1-pro-0915 在这套约束里的表现让我挺意外,工具失败了它会回头重规划,而不是编个结果糊弄过去,没有证据的时候它给不出结论,也不硬给。
但让这些约束真正生效的,不是模型自觉,是工程。一个不经模型的报告装配器,一套五档的证据分流,一条没重新读过原文就拒收 PASS 的硬规则。模型负责理解,代码负责验证,两边谁也别越界。开头说那张没有文字的流程图是我特意留的坎。写到这你会发现,真正的坎不在那张图上。图上的坎考验模型,图外的坎考验做系统的人。
磨平一些信息差,共勉。