ARTICLE · 1092327
AI 时代,最稀缺的还是注意力
2017 年 6 月,Google 的八位研究员在arXiv上挂出一篇论文,标题起得很狂:《Attention Is All You Need》——你需要的只是注意力。文章的核心意思是:以往让机器翻译信息,靠的是一层一层往后传的循环神经网络,像接力赛一样,一个字一个字往下递:慢,而且远处的信息递到后面就磨没了。他们换了个思路:别排队了,让每个词直接跟所有词对上眼。该看谁,就算出一个权重来。这篇论文核心架构叫 Transformer。今天你用的每一家大模型,骨架都是它。有意思的是:机器用"注意力"三个字解决了信息分配的问题;九年过去,人自己的注意力反而越来越不够用。
这不是巧合,也不是一句"大家都刷手机"能解释的。往下看。
一、先看三条曲线
要理解"注意力为什么缺",先得看清一组不对称。
| 变量 | 增长方式 | 含义 |
| 指数增长 | ||
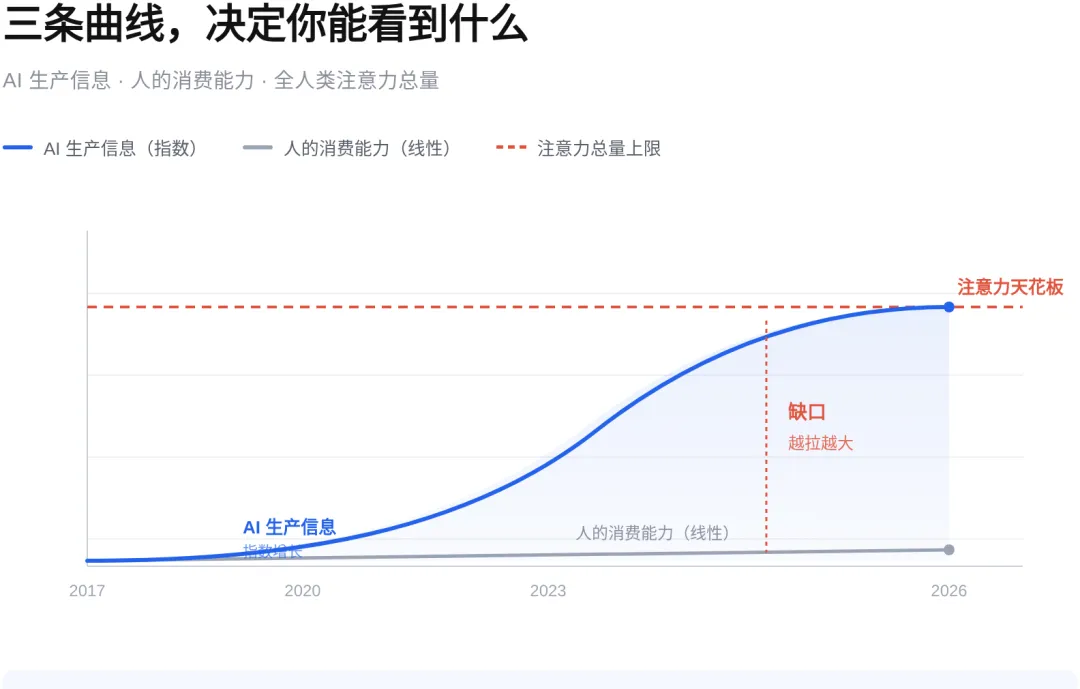
三条画在一起,就是一个楔形缺口:上面那条是指数,下面那条是线性,而所有人的注意力加起来只有那条红线那么高。
换句话说,AI 每天造出来的东西,人类全体再怎么努力也看不完——而且差距是以复利速度拉开的。
这就是缺口的物理来源:它不是你的自控力问题,是供给增速和你的处理速度之间,差了一个指数级。
二、同一个词,两个根本不同的问题
论文里有个核心公式,长这样:
Attention(Q,K,V) = softmax(QKᵀ/√dₖ)·V翻译成人话:拿一个"问题"去和一堆"候选项"逐一算相关度,归一化成权重,再加权求和。
注意这里的本质:注意力在这里是被"算"出来的。给定问题、给定候选,权重是唯一确定的最优解。它不纠结,不焦虑,不会被下一个弹窗带跑。
人的注意力恰恰相反。它不是算出来的,是选出来的——而且每次选择都意味着失去其他可能。
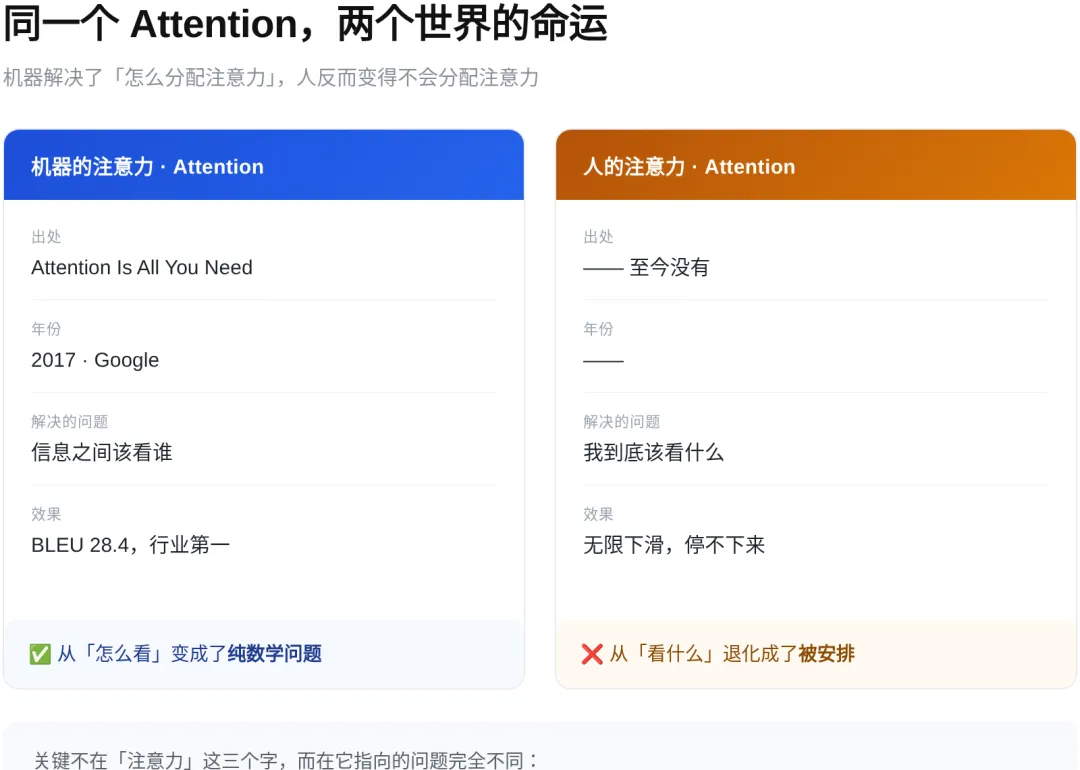
所以那个缺口从一开始就注定了:机器把"怎么分配注意力"解决了,但"该把注意力放在哪儿"——这个方向性的问题,它一天也没替你解决过。
三、论文自己给出的证据:注意力确实能"自己学会该看哪"
论文最漂亮的部分不是公式,是附录那几张注意力可视化图。
他们把一个长句拆开,看每个词在"看"哪里。结果发现:在第 5 层(总共 6 层)的某个注意力头里,模型在没有任何人教的情况下,自动学会了指代消解——句子里的"its",被牢牢地连到了它真正指的那个名词上。
另一个头,专门负责远距离的动词搭配。一个难以理解的句子"The teacher refused to change the seating because making the class more difficult",词与词隔着老远,模型却能连对。
没有人告诉过它语法规则。它自己从"该看谁"里,长出了对语言结构的理解。
这说明了一件事:注意力不是一个技巧,是一种理解世界的方式。会分配注意力,才谈得上理解。
对照今天的大模型也一样。让它翻译、总结、写代码,它交出的是"认真看过资料之后的结果"——只是它认真看的方式,是几千个维度同时打分。
四、一张账单,说明"认真看"有多便宜
论文 Table 2 里有一组数字,我重绘出来给⬇️
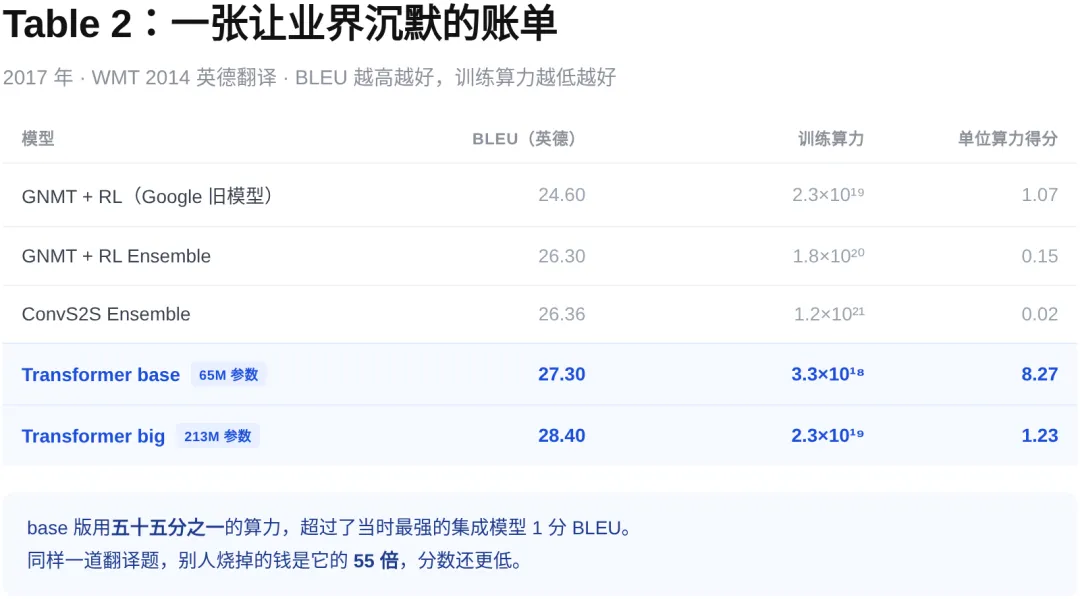
当时业界最好的集成模型,用 1.8×10²⁰ 次浮点运算,把英德翻译做到 26.30 BLEU。Transformer 基础版只用了 3.3×10¹⁸——算力是对方的五十五分之一,分数反而高出 1 分。
后来 big 版把纪录推到 28.4 BLEU,用的算力仍不到当时最强集成模型的六分之一。再往后,2018 年的 BERT 把这套"认真看"的思路搬到理解任务上,之后的事,就是你和 AI 天天在用的现在。
"怎么干"这一块的注意力,从此被摊薄到了极致。找一个信息、比对一个版本、把三十页资料压成三页,从昂贵的人工活,变成了几乎免费的按钮。
五、人缺的正好是它替不了的那部分
AI 可以替你"看完",但它替不了你三件事:
| AI 能做的 | 只有你能定的 |
前一件事叫"怎么做",叫执行;后一件事叫"做什么",叫判断。
AI 越是把前者做到极致,后者的价格就越贵。因为稀缺从来不由供给决定,由不可替代性决定。
六、最该被认真对待的,是"方向的注意力"
这个道理放到学习上,杀伤力最大。
大部分人的学习,从第一步就把注意力放错了位置:盯着"做了多少题",而不是"掌握了哪个概念"。一套卷子刷完,对答案,改错题,然后翻下一页。下一页大概率还是错在同一个地方,只是换了个数字。
刷题的动作很勤,勤到让人误以为这就是努力。但题目只是概念的投影。你反复练的是影子,影子背后的东西一直没碰过。
正确的顺序应该是反的:先看清"哪个概念没懂",再让题目为这个判断服务。判断错了,刷一万道也是在南辕北辙。
题是无限多的,概念是有限的。把注意力花在无限的那一半,你永远做不完。
七、所以我们做了「不止考试」
市面上的工具,基本都在优化"怎么做卷子"这件事:题库更大、判分更快、组卷更省事。这没错,但那是机器的注意力——本来就该被无限供给的那部分。
不止考试想做的是另一半:帮你把注意力放回"概念"上。
| 机器负责的(怎么做) | 你负责的(做什么) |
一句话区别:传统工具问"你做了几道题",不止考试问的是"这个知识点,你到底会不会"。
📍 不止考试 ——上传一份资料,AI 抽知识点、出题、判卷。你不必跟卷子较劲,只需要跟概念较劲。
回到 2017 年那篇论文。它用一个数学公式,把"怎么分配注意力"变成了人人可用的东西。这是这十年里最伟大的进步之一。详情见阅读原文。
但它也顺手把另一件事照得更清楚:能被算出来的部分,终将被算得越来越便宜;不能被算出来的部分——你想去哪、你信什么、你决定把时间花在哪儿——会越来越贵。
AI 把"怎么看"解决了。看什么,这个问题永远归你。