ARTICLE · 1103415
文献研读|256M参数如何把整页PDF变成结构化DocTags
arxiclaw 官网:https://arxiclaw.reduct.cn/
来源:arXiv
论文:SmolDocling: An ultra-compact vision-language model for end-to-end multi-modal document conversion
作者:Ahmed Nassar, Andres Marafioti, Matteo Omenetti, Maksym Lysak, Nikolaos Livathinos, Christoph Auer
机构:IBM Research, HuggingFace
论文链接:https://arxiclaw.reduct.cn/paper/4918?paperSource=paper_detail
项目主页:https://huggingface.co/ds4sd/SmolDocling-256M-preview
【30 秒速览】
核心症结:复杂PDF不仅要识别文字,还要恢复元素类型、结构、位置和相互关系;传统流水线难维护,大型视觉语言模型又昂贵且可能产生幻觉。
创新突破:SmolDocling用视觉编码器、投影池化和语言模型,把整页图像转换为统一的DocTags序列,序列同时记录元素类型、内容和空间位置。
适用场景:读者能区分这项工作的真正创新——统一整页表示和数据构造——与尚需完整实验表验证的具体性能优势。
一、一页 PDF 最难的不是读字,而是同时保住内容、结构和位置
想象一页技术报告:左侧是多栏正文,中央嵌着表格,底部有终端输出和公式,旁边还有一张图表。系统不仅要读出文字,还要判断每个区域到底是段落、代码、表格还是图片,恢复它们在页面上的位置,并理解这些元素怎样组成整页结构。只做 OCR 会丢掉版式;只做布局分析又无法保证内容准确。
传统方案通常把 OCR、布局分析、表格结构识别和分类拆成多个专用模块,再用预处理、后处理和条件规则把结果拼起来。模块越多,调参和泛化越困难;另一条路线是交给大型视觉语言模型端到端处理,但计算资源成本更高,也可能生成页面中不存在的内容。SmolDocling 的核心主张很明确:用 256M 参数的视觉语言模型,把整页图像直接转换成统一的 DocTags 表示;作者还声称,它可以与参数规模最多约27倍的视觉语言模型竞争。读完这篇论文,最值得带走的判断不是“小模型一定赢”,而是统一输出表示和整页数据构造,确实可能成为替代复杂流水线的一条路线。
论文的假设是:只要训练数据覆盖代码、公式、图表、表格、列表等多种元素,并让模型一次性生成包含类型、内容和空间位置的结构化序列,许多原本分散的文档理解任务就能被放进同一个生成目标。这个假设把问题从“分别识别若干元素”改成了“恢复一整页可计算的文档结构”。
二、SmolDocling 把整页视觉流压缩成一条能被语言模型继续生成的序列
沿用刚才那页同时含表格、终端输出和图表的报告来看,第一步不是把页面裁成许多孤立小块,而是把整页图像送入视觉编码器,得到页面视觉特征。随后,特征经过 projection 和 pooling,被重塑为更紧凑的 projected visual embeddings;它们再与用户文本提示的嵌入拼接,必要时交错排列,形成语言模型能够处理的联合视觉语言序列。这个设计的关键不在于某个独立识别头,而在于让整页上下文一路保留下来。
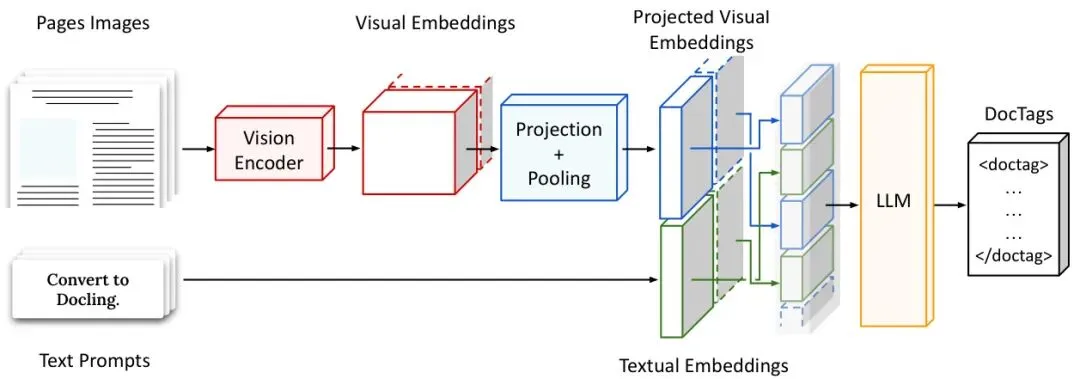
*图注:看清从页面图像到 DocTags 的四步链路:视觉编码、投影池化、提示拼接和自回归生成。*
第二个决定性设计是 DocTags。语言模型根据联合序列自回归生成统一输出,不只写出“这里有一张表”,还要在同一表示中记录元素类型、页面位置和内容。对于报告中的表格,输出可以同时表达它是 table、位于页面哪个区域,以及单元格或相关文本内容;对于终端区域,则应表达为 code,而不是普通段落。这样,布局、语义和文本不再需要由多个模型分别产出后再手工对齐。
第三个设计是紧凑的 SmolVLM-256M 视觉语言骨干。论文把它放在较小模型规模与多元素任务覆盖之间做权衡,并将 SmolDocling 描述为比可比文档理解视觉语言模型小约5到10倍。这里能确认的是参数规模定位和架构路径;不能直接把参数缩小比例等同于推理延迟、显存、能耗或训练成本按相同比例下降。
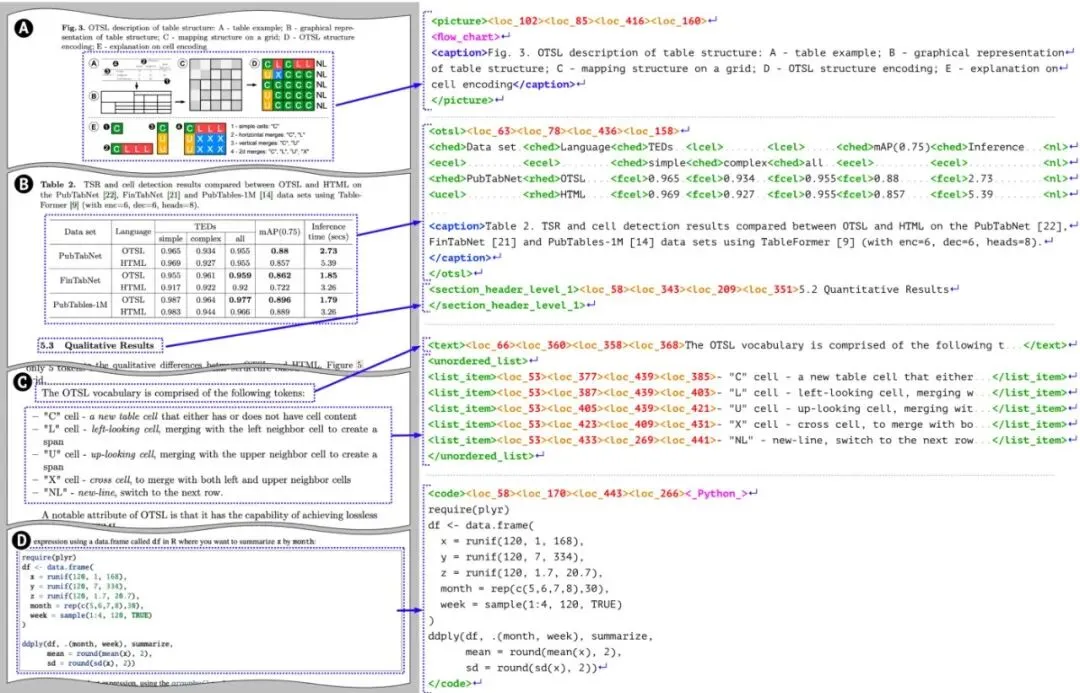
*图注:重点观察 DocTags 如何把元素类型、位置和内容放进同一份结构化表示。*
三、现有结果支持“紧凑且覆盖广”,却没有给出一张可核对的总排行榜
实验主线覆盖结构化文档文本识别、表格结构与单元格内容重建、代码解析,以及多种布局和文档元素。可见材料确认,作者报告了 256M 参数规模,并把它与最多约27倍参数规模的其他视觉语言模型放在竞争性叙述中;但论文正文没有呈现完整实验表中的数据集划分、指标、基线名称和具体数值,因此不能把这句话改写成某个任务上的确定胜负。
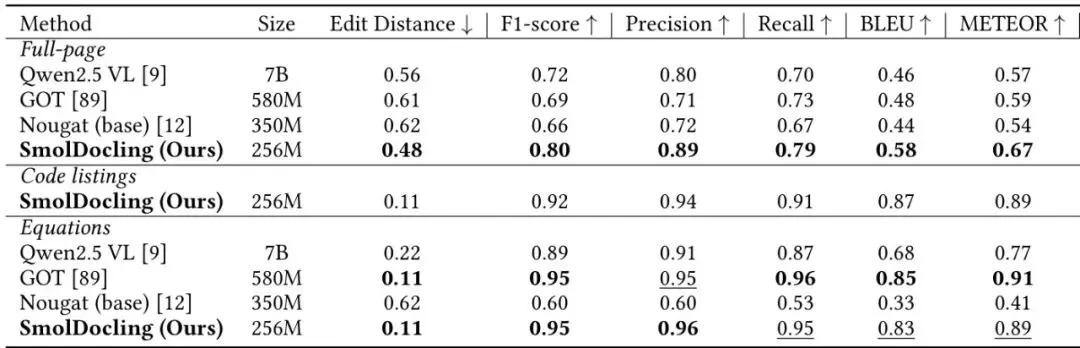
*图注:核对任务、评价指标和各模型列,避免把结构化识别结果泛化成所有文档任务的结论。*
在结构化文档文本识别表中,比较对象和评价条件需要结合原表逐项阅读,不能把其中一个任务的结果外推到代码、公式或图表。代码解析更需要谨慎:论文明确只报告 SmolDocling,因为其他模型没有针对这一任务明确训练。这个设置能说明论文把代码解析作为新增任务纳入展示,却不构成公平的跨模型性能比较。布局案例则以 DocLayNet ground truth 作对照,并在案例中与 Qwen2.5-VL 并置观察;它展示了多栏页面和嵌套列表上的可用输出,但属于定性样例,不是总体测试集统计。
因此,实验已经回答了“256M 模型能否尝试把多种复杂元素放进一次整页转换”这一工程问题,却还没有回答“在每一种任务、每一个指标和统一计算条件下,它究竟比谁好多少”。27倍规模比较对应哪些模型和指标?完整表格里的优势是否集中在某一类文档?这些问题需要读者回到原始实验表,而不能由摘要中的规模数字代替。
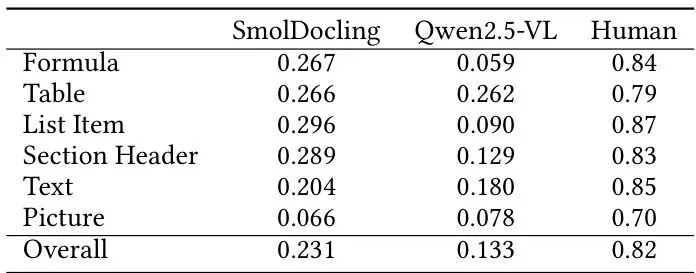
*图注:注意这里不是公平的多模型排行榜,而是论文新增代码解析任务的单模型报告。*
四、案例已经暴露出失败模式,因此它还不能证明整页转换在复杂页面上稳定泛化
对上一个问题,论文给出的直接答案是:SmolDocling 展示了可行性,但还不足以证明稳定的总体泛化。布局案例中,模型在部分多栏页面和嵌套列表上能够生成有用结果;与此同时,终端输出页面出现边界框召回不足或位置不准确,带表格和图表的报告页还可能出现重复生成,并虚构不存在的文本单元格。这些不是抽象的“可能出错”,而是统一生成机制在空间定位和长结构输出上的具体失误。
这也构成论文最重要的目前能确认的范围。DocTags 把类型、位置和内容放进同一序列,确实减少了显式任务拼接;但当一个页面同时包含表格与图表时,生成式模型仍可能混淆元素类型,或在结构没有正确闭合时重复循环。论文没有提供这类错误的系统发生率,也没有完整呈现长页面、多页输入和高分辨率输入下的延迟、吞吐量或显存。因此,“模型更小”可以支持紧凑性定位,却不能自动推出生产部署已经成熟。
从方法新颖性看,公开证据更清楚地支持两点:紧凑视觉语言骨干与 DocTags 统一输出的组合,以及围绕代码、公式、图表和整页自然上下文进行数据构造。至于它相对于所有既有文档模型的独立算法创新,论文正文没有足够实验和消融结果来下结论。尤其是材料中没有可核验的消融实验,无法分离数据构造、输出格式和模型骨干各自贡献了多少。
五、真正值得借鉴的不是“256M 替代一切”,而是把文档任务改写成统一结构生成
这篇论文适合三类读者精读。第一类是研究文档视觉语言模型的人:DocTags 提供了一个具体例子,说明怎样把元素类型、内容和空间位置组织进单一输出目标。第二类是正在维护 OCR、布局、表格识别多模块流水线的工程师:论文提出的整页输入和统一输出,值得作为系统重构的参照,但部署前必须自行补齐公平基线、错误统计和资源测量。第三类是准备构造代码、公式、表格和图表联合数据集的团队:论文把“保留元素在整页中的自然上下文”放在数据设计中心,这比只收集孤立裁剪区域更值得迁移。
如果要复现,最有价值的不是先追逐摘要里的27倍数字,而是分别验证三个问题:统一 DocTags 是否比多模块拼接更容易维护;整页上下文是否改善跨元素关系;边界框错误、重复循环和虚构单元格是否能被明确指标捕获。相反,如果你的目标是拿到完整排行榜、精确提升幅度或端到端吞吐量,当前提供的材料还不够。
六、原文最值得核对的是实验条件,而不是摘要里的参数倍数
想继续判断这项工作,建议直接阅读论文详情页,重点核对完整实验表中的任务、数据集、划分、指标和基线条件,再对照布局案例中的失败样例。站内原文入口为https://arxiclaw.reduct.cn/paper/4918?paperSource=paper_detail:论文同时提供了 SmolDocling-256M-preview 模型链接:HuggingFace 仓库:ds4sd/SmolDocling-256M-preview。现阶段最稳妥的结论是:SmolDocling 证明了 256M 参数模型可以沿着 DocTags 统一表示路线处理复杂整页文档;它能否在真实部署中稳定接管传统流水线的一整环,还要看完整数值、资源条件和失败率统计。
点击文末「阅读原文」,可直接进入 arxiclaw 论文详情页,继续查看论文信息、主图主表与相关资源。
扫描下方二维码加入 arxiclaw 用户交流群,欢迎反馈使用问题和改进建议,一起把产品做得更好。