ARTICLE · 1110220
我常用的AI工具, Ollama五款中文嵌入模型评测 !
—模型选对,检索翻倍。
软件介绍
01/嵌入模型到底在干嘛
搭建本地知识库、做 RAG 检索 时,很多人第一反应是换更大的大模型,检索效果却纹丝不动。问题常常出在地基—— 嵌入模型 没选好。
嵌入模型不「说话」,它把一段文本压缩成一个 数字向量 。两个意思接近的句子,向量在空间中离得近;语义无关的,离得远。RAG 检索本质上就是:把用户提问也变成向量,再去知识库里找「最近的几个向量」,把对应原文喂给大模型。地基准了,召回才准。
「大模型负责「说」,嵌入模型负责「找」——找不准,说得再漂亮也是答非所问。」
02/我使用的五款中文嵌入模型横评
在 Ollama 里能直接拉到的嵌入模型不少,但中文场景差异很大。
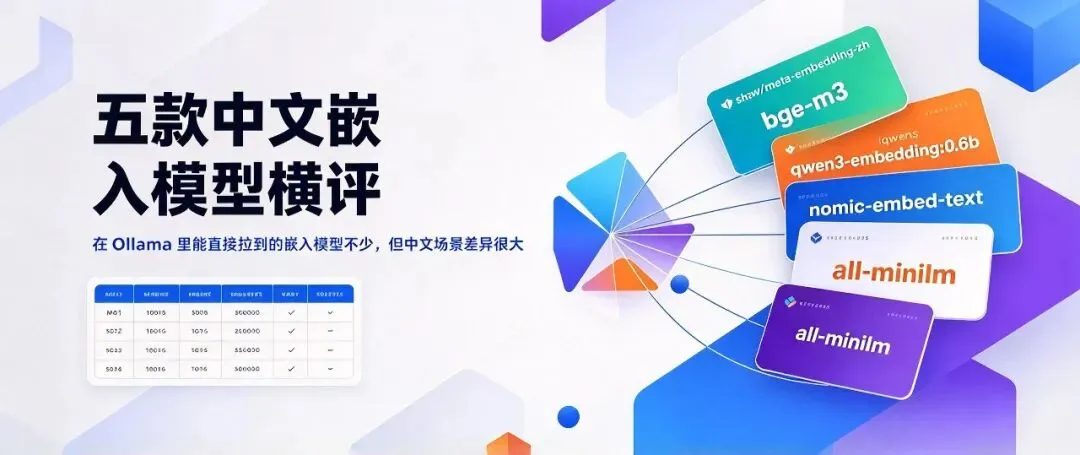
下面五款是本地部署最常见的候选,维度、体积、中文支持一并摆出来。
维度一致(都是 1024)的模型之间可以直接换着试;维度不同(768、384)则需要重建向量库,迁移成本高。中文优先看「中文」一列。
03/为什么首推 dmeta
一句话:中文场景里,它把「效果、速度、体积」三件事同时拉满了。直接上shaw/dmeta-embedding-zh就够了。
01
中文专优
100M 参数专为中文训练,语义匹配明显强于通用模型
02
速度最快
比 qwen3-embedding 快约 5 倍,批量建库不卡
03
体积小巧
仅 409MB,8GB 显存轻松跑
Ollama 本地部署
确认本机已装 Ollama,一行命令拉取 dmeta:
ollama pull shaw/dmeta-embedding-zh
确认本机已装 Ollama,一行命令拉取bge-m3:
ollama pull bge-m3
确认本机已装 Ollama,一行命令拉取qwen3-embedding:0.6b:
ollama pull qwen3-embedding:0.6b
确认本机已装 Ollama,一行命令拉取nomic-embed-text:
ollama pull nomic-embed-text
确认本机已装 Ollama,一行命令拉取all-minilm:
ollama pull all-minilm
04/AnythingLLM 接入 dmeta 的正确路径
Ollama 跑通后,把它接进AnythingLLM做可视化知识库。这里最容易踩的坑是:点进了workspace 级设置,而不是真正的 app 级设置。下面给的是官方正确的进入路径。
点左上角返回箭头(在 通用设置 / 聊天设置 / 向量数据库 / 代理配置 那行最左边的那个),回到 AnythingLLM 主界面。
在主界面左下角侧边栏最底部,找「设置」(一个扳手 / 齿轮图标,贴着底部状态栏)。注意区分:workspace 级那个齿轮是工作区自己的;app 级那个在侧边栏最下面,是和「代理配置」长得不一样的小扳手。
在 app 设置里找 AI Providers(LLM 提供者 / 嵌入提供者 / 文本分割器 都在这一区),需要改的是下面两样:
A
Embedding Provider
选 Ollama,模型下拉里选 shaw/dmeta-embedding-zh,保存
B
Text Splitter
Chunk Size 改 1000、Overlap 改 200(同页下方子区块)
两个重要提醒:改完只对新文档生效(官方文档明说)。你还没上传过任何 txt,现在改完正好,下次拖入就直接用 1000 字符分块。
05/ChatBox 接入 dmeta 的正确路径
全局设 Ollama 为模型提供方
Chatbox 主界面右上 齿轮 ⚙️ → 进入 设置。
找到 模型 区块(或 Model Provider):
模型提供方 →选 Ollama API(也叫 Ollama)
API Host / Base URL → 填 http://127.0.0.1:11434
API Key → 留空(本地不需要)
点获取按钮 shaw/dmeta-embedding-zh:latest
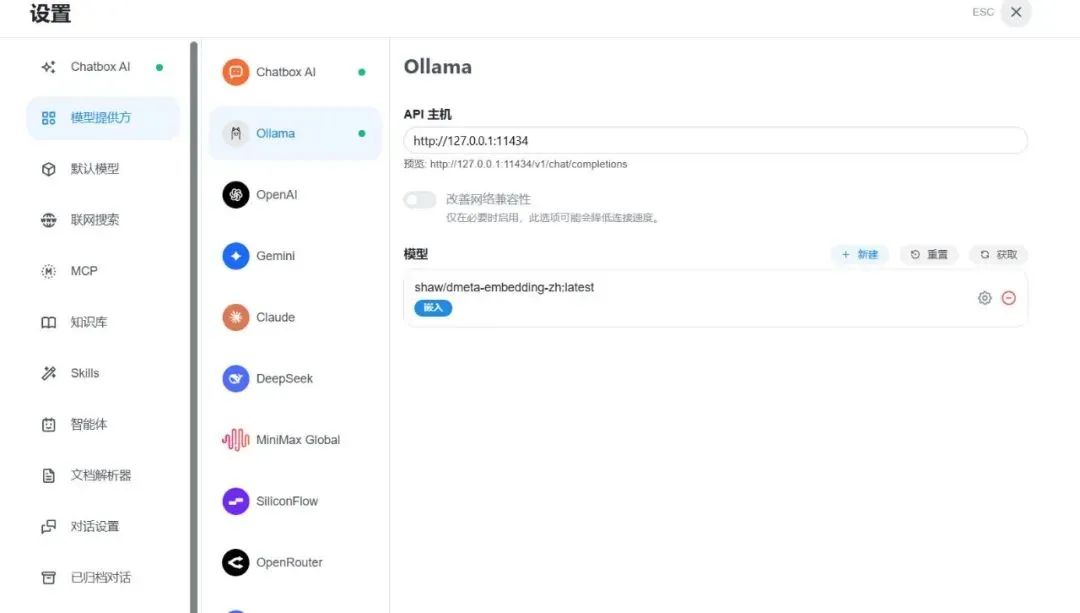
点小齿轮 设置
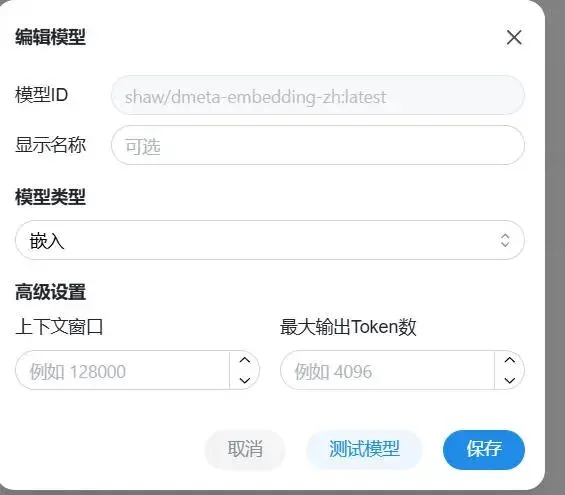
模型类型 选择 嵌入
保存。这一步是嵌入下拉激活的前提。
回知识库编辑窗口选嵌入模型
设置 → 知识库 → 编辑你那个 知识库xx(或新建)。
现在 嵌入模型 下拉不再灰色 → 选 Ollama | shaw/dmeta-embedding-zh:latest。
其他选项(重排/视觉)留空。
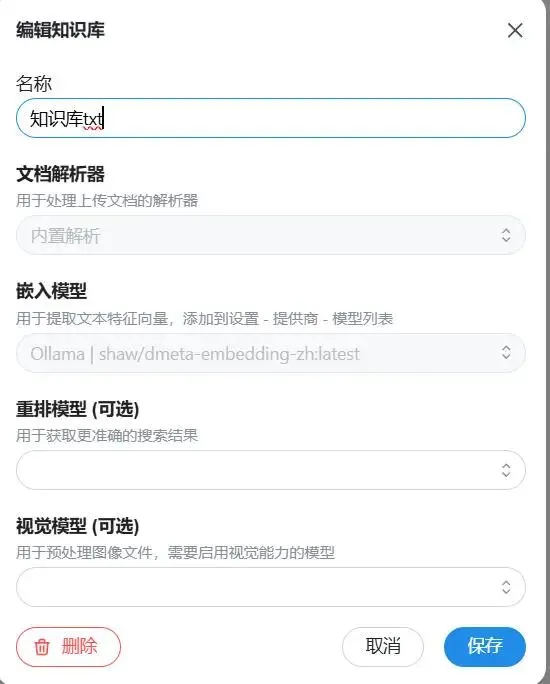
点 保存。
06/写在最后
RAG 检索的地基,一半在分块策略,一半在 嵌入模型 。本地部署选 shaw/dmeta-embedding-zh ,再按上面的路径接进 AnythingLLM,你的中文知识库检索就已经站在了及格线之上。剩下的,就是往里喂质量够高的文档了。
Ollama 官网:https://ollama.com/
报告版权归原撰写/发布机构所有,如涉侵权,请联系删除 ;资料为推荐阅读,仅供参考学习,如对内容存疑,请与原撰写/发布机构联系。

【关注“零售创新” 公众号后台回复2610有福利发放哟!】
个人介绍
和平老师
从业数据行业15年以上。
历任上市集团数据总监,世界五百强、中国知名零售企业高管。
Excel专家、可视化专家、数据分析专家。
零售创新相关案例分享 。
知识星球每年更新上千份行业分析报告。
个人网站 Excelbook.cn
知识星球精彩内容展示
常见问题

加 小琥微信 加入运营交流群,Excel学习群,行业研究群,请备注需求!
领取相关报告的方法(任选一):
1. 分享此篇文章到朋友圈,不要分组,保留一小时以上。
2. 分享到100人以上的数据分析相关微信群(慎重),保留5分钟。
完成后,加微信 my21ke007,并发截图,我们会在12小时内给您发送相关报告。
--------------- End ----------------
免责声明:公众号涉及资料均系创新君通过公开、合法渠道获得,报告版权归原撰写/发布机构所有,如涉侵权,请联系小琥删除 (my21ke007),如对报告/模板存疑,请与撰写/发布机构联系。