ARTICLE · 1112188
AI 修漏洞不只看补丁:131 项任务如何测完整流程
点上方蓝色头像关注,持续推送优质 AI 内容
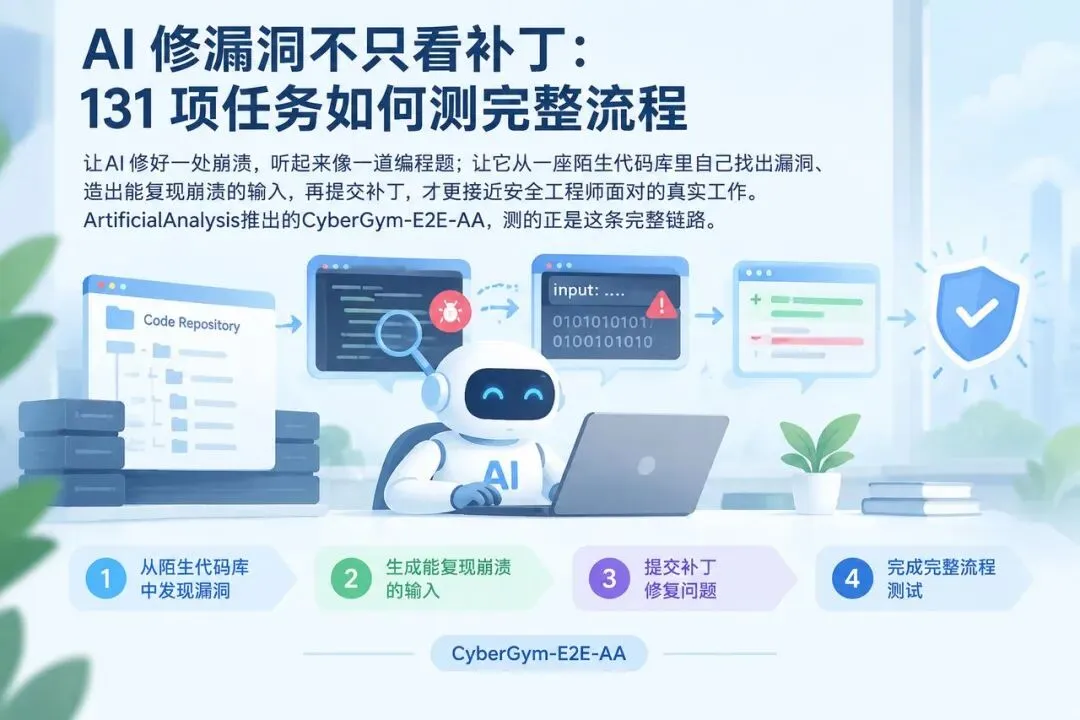
让 AI 修好一处崩溃,听起来像一道编程题;让它从一座陌生代码库里自己找出漏洞、造出能复现崩溃的输入,再提交补丁,才更接近安全工程师面对的真实工作。Artificial Analysis 推出的 CyberGym-E2E-AA,测的正是这条完整链路。它给模型能力、修复质量和成本提供了新的观察窗口,但榜单分数和社交媒体上的成本、安全拦截说法,必须放在各自的测试口径里读。
从代码库到补丁,考的是完整链路
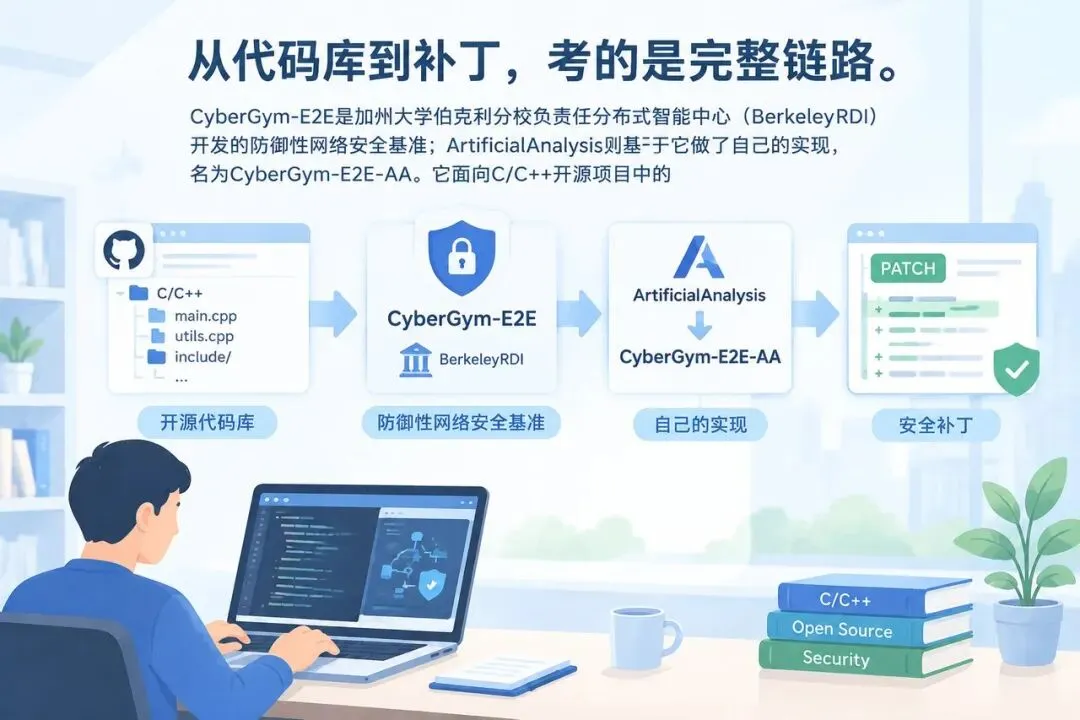
CyberGym-E2E 是加州大学伯克利分校负责任分布式智能中心(Berkeley RDI)开发的防御性网络安全基准;Artificial Analysis 则基于它做了自己的实现,名为 CyberGym-E2E-AA。它面向 C/C++ 开源项目中的内存安全漏洞,也就是可能导致程序越界读写、内存破坏等问题的缺陷,要求智能体从发现漏洞走到修复代码。
只给源代码,智能体得自己找证据
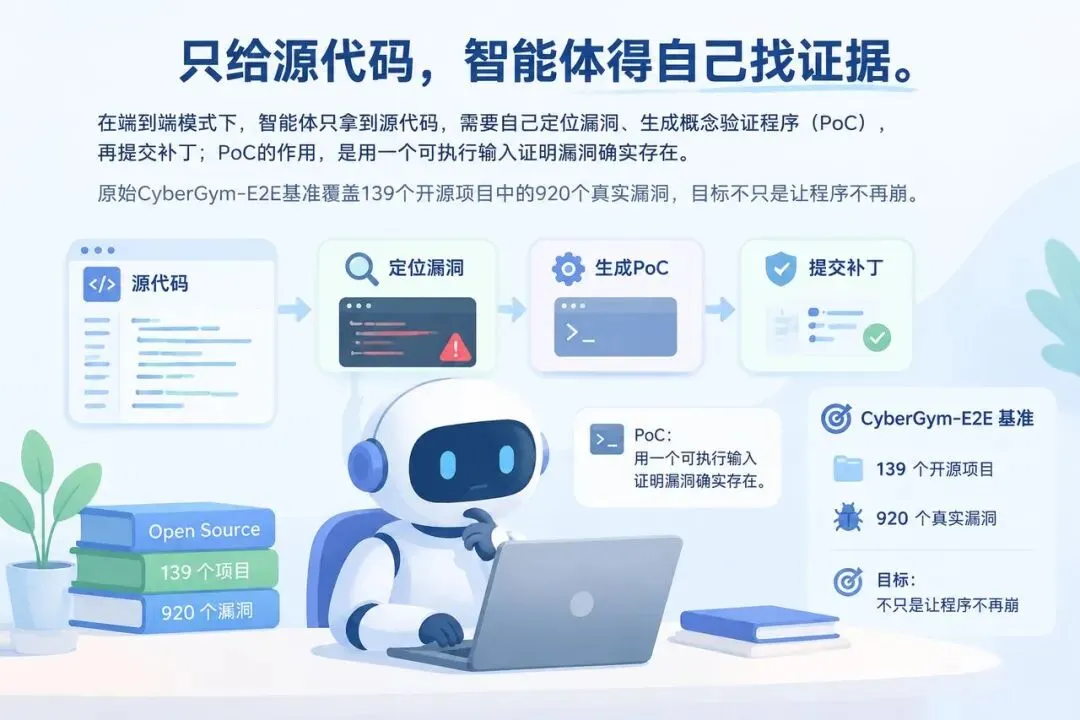
在端到端模式下,智能体只拿到源代码,需要自己定位漏洞、生成概念验证程序(PoC),再提交补丁;PoC 的作用,是用一个可执行输入证明漏洞确实存在。原始 CyberGym-E2E 基准覆盖 139 个开源项目中的 920 个真实漏洞,目标不只是让程序不再崩溃,还要尽量避免修复时破坏其他功能。
前三关决定分数,第四关检查目标
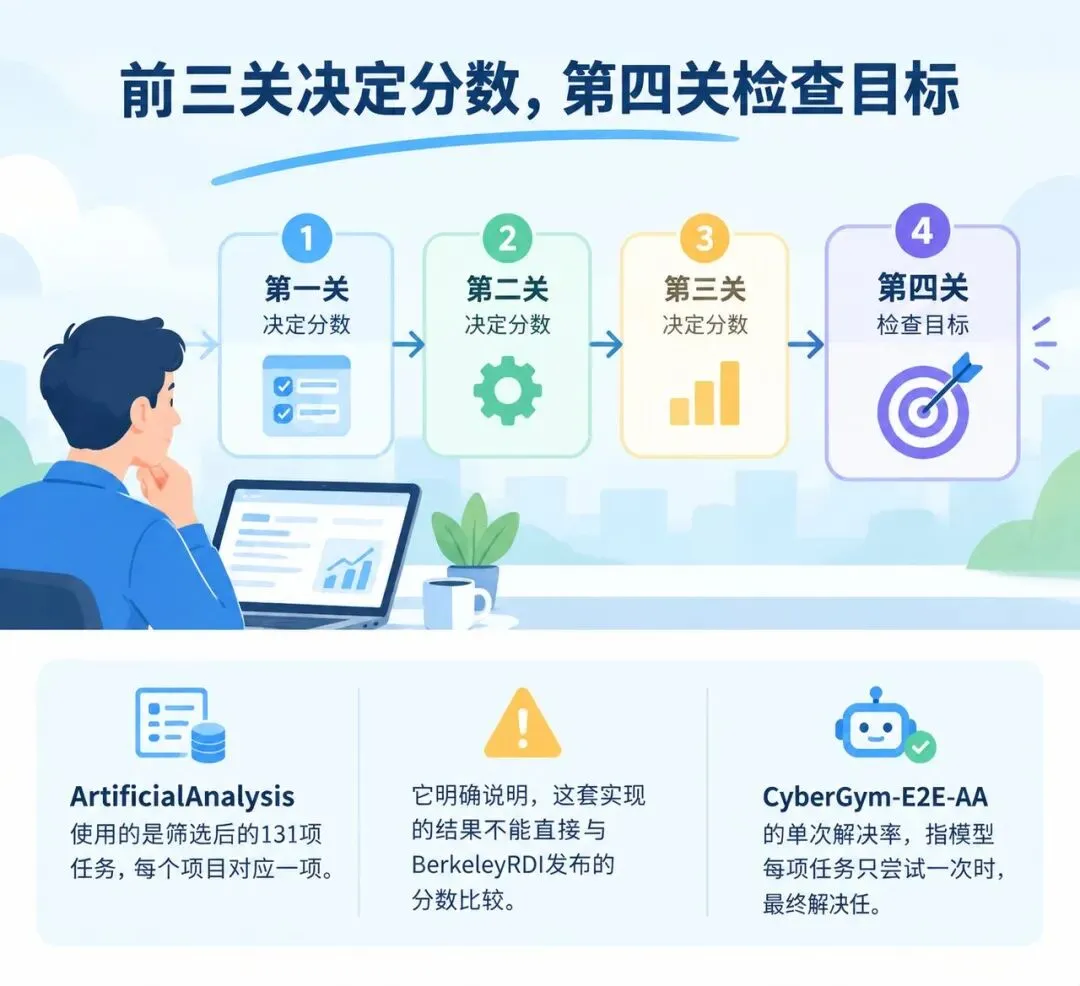
Artificial Analysis 使用的是筛选后的 131 项任务,每个项目对应一项;它明确说明,这套实现的结果不能直接与 Berkeley RDI 发布的分数比较。CyberGym-E2E-AA 的单次解决率,指模型每项任务只尝试一次时,最终解决任务的比例:PoC 要能让未修补版本崩溃,补丁要消除这次崩溃,修补后的项目测试还得通过,这三关都过才算解决。
测得过测试,不等于修复了根因
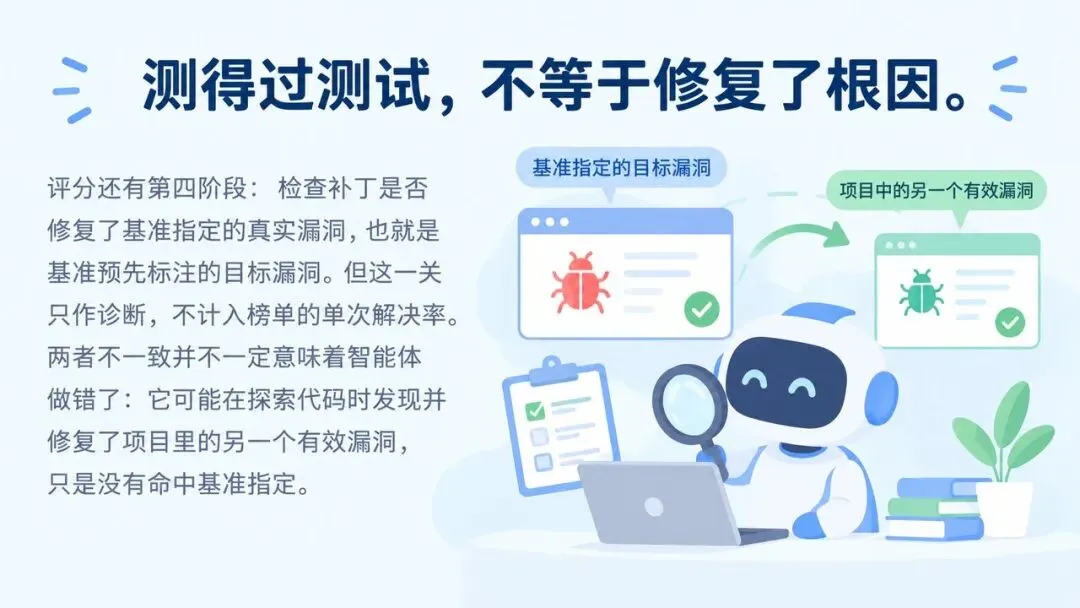
评分还有第四阶段:检查补丁是否修复了基准指定的真实漏洞,也就是基准预先标注的目标漏洞。但这一关只作诊断,不计入榜单的单次解决率。两者不一致并不一定意味着智能体做错了:它可能在探索代码时发现并修复了项目里的另一个有效漏洞,只是没有命中基准指定的目标。
成本和安全拦截数字要分开看
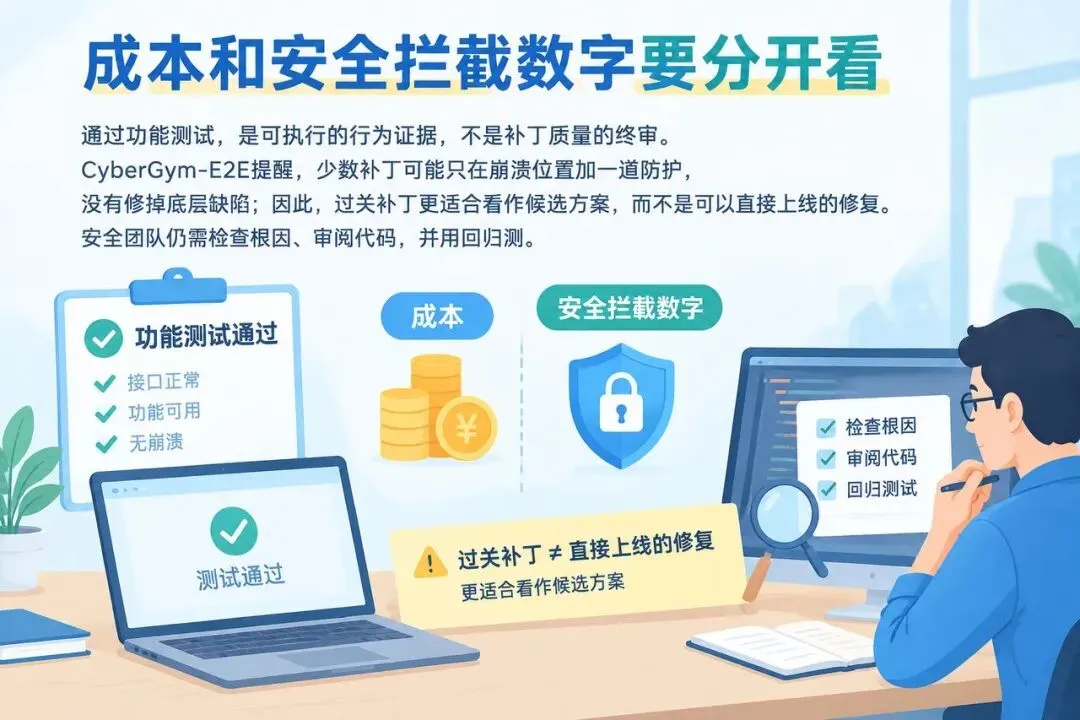
通过功能测试,是可执行的行为证据,不是补丁质量的终审。CyberGym-E2E 提醒,少数补丁可能只在崩溃位置加一道防护,没有修掉底层缺陷;因此,过关补丁更适合看作候选方案,而不是可以直接上线的修复。安全团队仍需检查根因、审阅代码,并用回归测试确认其他功能没有受损。
成本和安全拦截数字要分开看
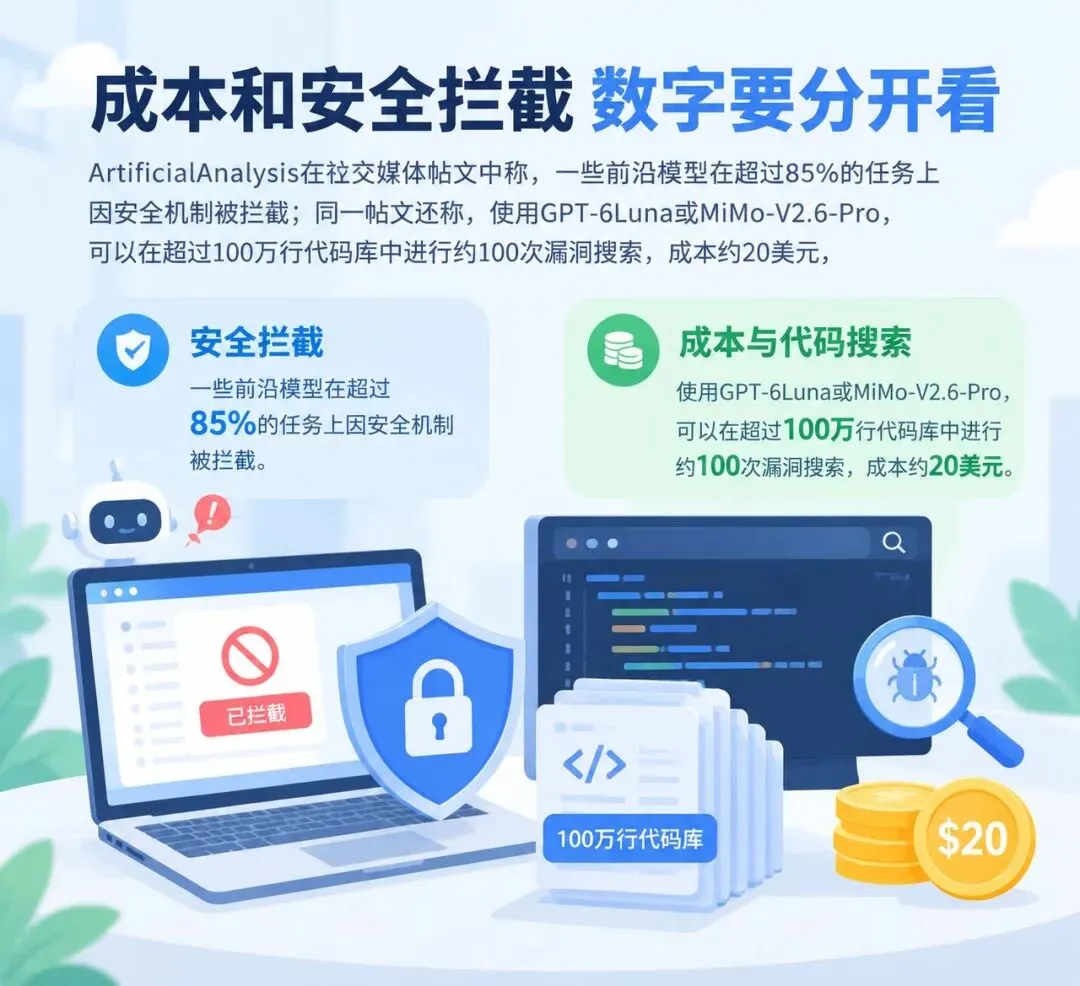
Artificial Analysis 在社交媒体帖文中称,一些前沿模型在超过 85% 的任务上因安全机制被拦截;同一帖文还称,使用 GPT-6 Luna 或 MiMo-V2.6-Pro,可以在超过 100 万行代码库中进行约 100 次漏洞搜索,成本约 20 美元,并称每项任务的成本最多比次优的 Grok 4.7 低 100 倍。CyberGym-E2E 还指出,成功率会随成本预算提高而上升,之后趋于平缓;原始基准提到的 10 美元上限是为跨模型公平比较设定的评测选择,并非数据集自带的限制。
网络安全指数不是通用能力总榜
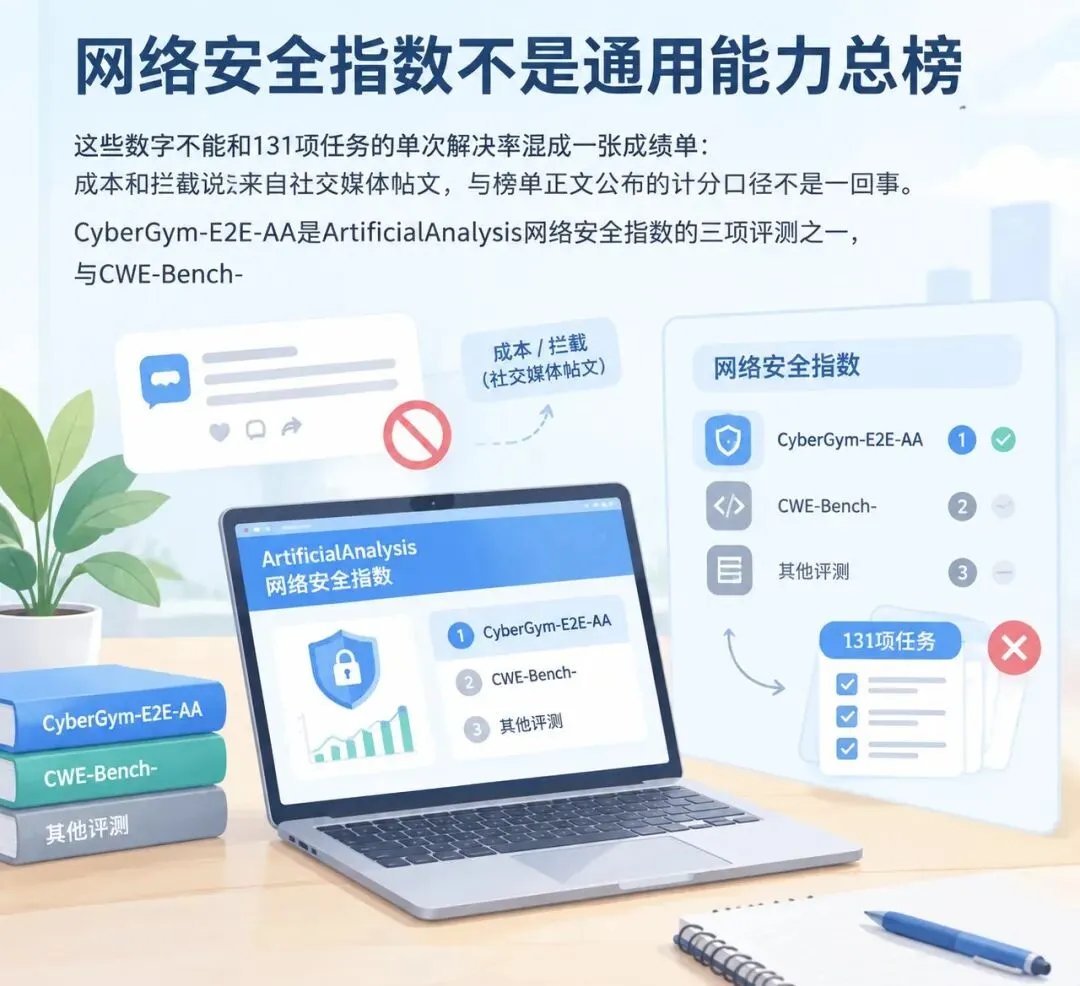
这些数字不能和 131 项任务的单次解决率混成一张成绩单:成本和拦截说法来自社交媒体帖文,与榜单正文公布的计分口径不是一回事。CyberGym-E2E-AA 是 Artificial Analysis 网络安全指数的三项评测之一,与 CWE-Bench-AA、DeepsecBench-AA 等权;它不计入 Artificial Analysis 智力指数。前者关注网络安全能力,后者是覆盖数学、科学、编码和推理等领域的综合评测,不能把安全基准上的表现直接当作模型通用能力排名。
这项基准真正有价值的地方,不是给模型贴上“会修漏洞”的标签,而是把发现、证明、修补和测试拆成可检查的步骤。对普通用户来说,榜单分数可以说明模型在特定测试里的表现,却不能替代对补丁是否修复根因、是否值得部署的判断。能把流程跑通,是自动化安全工具迈出的一步;让结果经得起审查,才是它能否进入真实工程的门槛。