ARTICLE · 1112358
计费倍率变成0.0x那天我的主力AI工具从workbuddy变成了Qoder
我没打算换工具,直到看见 0.0×
9 月 18 日上午,我在 Qoder 的活动页上看到一行字:Qwen3.8-Flash 的计费系数由 0.1× 降至 0.0×,活动持续到 9 月 30 日。0.0 的意思很直接——调用这个模型不消耗任何 Credit,账号余额为 0 也能用。
第一反应是不信。免费的东西通常最贵,它要么在能力上偷偷降级,要么在别处埋着代价。我做医疗软件产品,日常一半的时间在读代码、跑脚本、整理资料,这些活烧额度的速度我心里有数。
所以我用一个下午做了件事:把日常那些「高频、低判断」的活全部搬到 Qoder 上,看它扛不扛得住。
结果是扛住了。但过程中我踩了三个坑——也正是这三个坑,让我改掉了用 AI 编程的习惯,而不只是换了个工具。
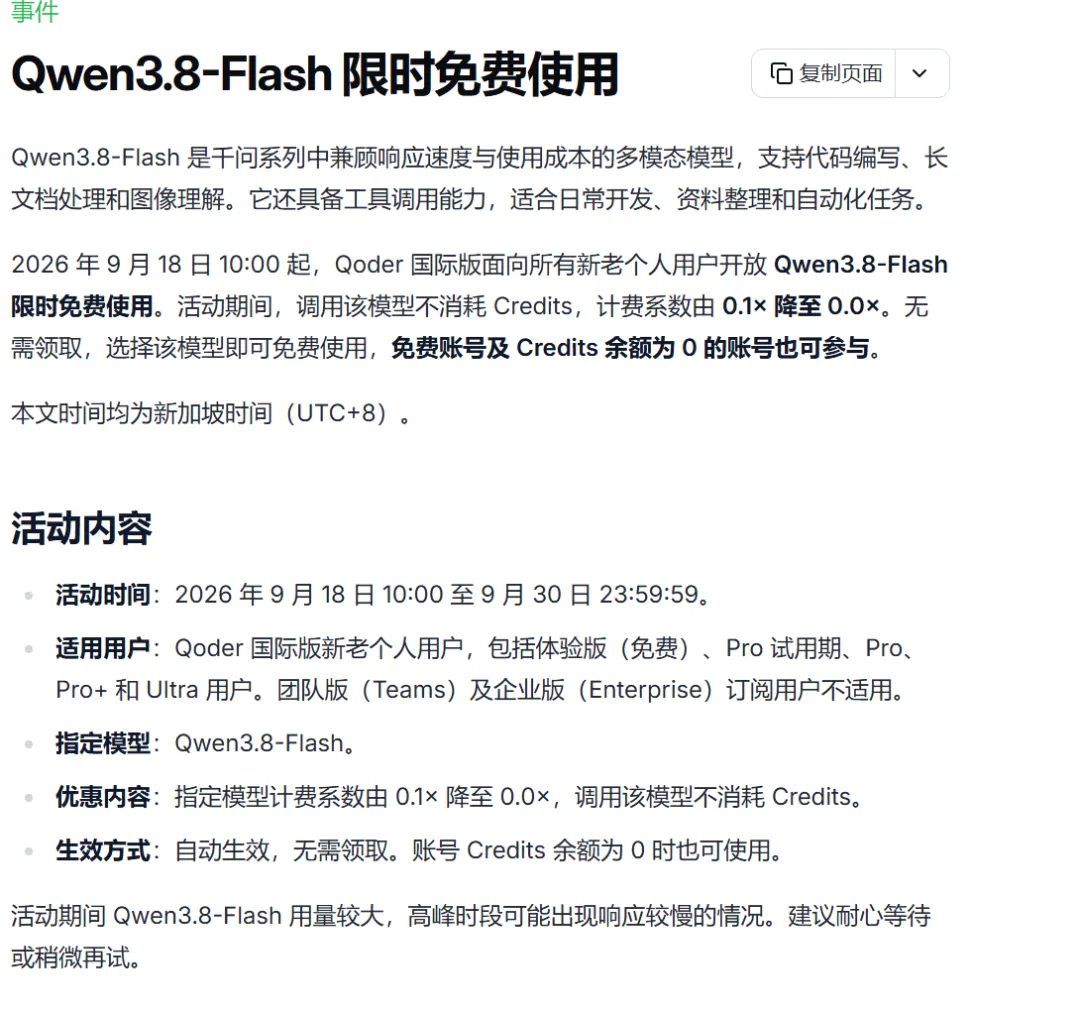
图1:官方活动公告——Qwen3.8-Flash 计费系数由 0.1× 降至 0.0×(来源:Qoder 官方文档)
一、为什么转换AI工具
先说清楚我原来在用什么,以及成本焦虑从哪来。
我平时用 WorkBuddy 处理工程杂活和内容生产:读仓库结构、批量改脚本、抓页面整理素材、把一堆文件重命名归档。它在「操作本地文件 + 交付成品」这件事上做得很好。真正出问题的不是工具,而是我交给它的任务颗粒度变了。
以前是对话:问一句答一句,一轮几十秒,消耗是线性的。现在是任务:说一句「把这个仓库的通读文档整理出来」,它自己规划、自己翻文件、自己写,跑二十分钟到两小时。
Qoder 官方把这个演进拆成三段——代码助手、协同编码、自主编程,并称第三阶段能带来 1 到 10 倍的效率提升。但同一份材料里还有一句更诚实的话:成本、质量、速度构成「三难约束」(triple-constraint)。
翻译过来就是:当你把 AI 从「助手」变成「员工」,账单也开始按员工算。
而恰好在这个节点上,Qwen3.8-Flash 出现了。2026 年 8 月 26 日发布并同步开源,125B 总参数只激活 6B,训练成本比上一代 Qwen3.7-Plus 下降近 90%,API 定价压到每百万 tokens 输入 1 元、输出 3 元。一个能把边际成本压到这个位置的模型,才配去做「免费入口」。
所以我要验证的从来不是免费不免费,而是:这个零成本档位,到底能吃下我多少活。
二、0.0× 到底意味着什么
Qoder 的计费单位是 Credit,但官方文档里有一句必须划重点的话:A Credit rate is a billing multiplier——倍率是计费系数,不是每次固定扣多少。同一个任务的实际消耗,还取决于输入输出长度、缓存命中、思考强度、上下文窗口和工具调用次数。
按官方给出的示例口径:同一个示例任务,走 Auto 档约 10 Credits,Ultimate 档约 16 Credits,Performance 档约 11 Credits,Efficient 档约 3 Credits。最高与最低之间差了五倍多,而这还只是档位之间的差距。
Qwen3.8-Flash 的 0.0×,意味着它连「3 Credits」那一档都不占。
为什么会有一个模型敢把自己定成 0?我去翻了技术侧的原话:架构上用了 QSA(Qwen Sparse Attention)与 GDN 融合的混合注意力机制,官方称在 1M tokens 长上下文、缓存命中的实际场景中能提速 8 倍以上;稀疏 MoE 只激活 6B 参数,推理成本本就很低;训练成本相较上一代下降近 90%。
换句话说,免费不是营销预算在兜底,而是模型本身的成本已经低到可以当入场券送。
但看清全局之后,事情更有意思。我把 Qoder 里能选的档位和模型倍率排了一遍:
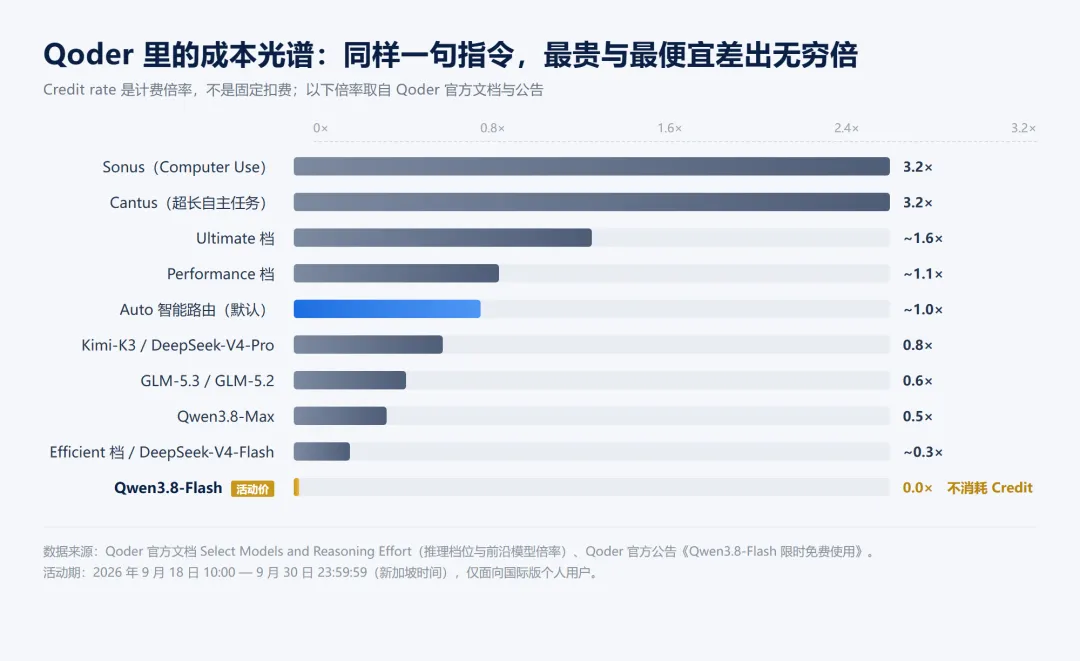
图2:Qoder 的成本光谱——计费倍率从 0.0× 一直排到 3.2×(数据来源:Qoder 官方文档)
最上面是 Sonus 和 Cantus,3.2×,主打长时间自主任务和 Computer Use;中间是 Ultimate 1.6×、Performance 1.1×、Auto 1.0×;最底下才是 Flash 的 0.0×。
这张图让我想通一件事:免费的不是模型,是入口。阿里把操作电脑、深度推理这些能力放在最贵的一档,把 Flash 放在漏斗底部拉新——它赌的是你用完免费入口之后,会为上面那些 3.2× 的能力付钱。
想明白这一层,Flash 的定位就清楚了:它不是替代品,是分流阀。
三、手把手:我是怎么把它接进工作流的
步骤 1:准备环境
我的环境是 Windows 10 台式机 + Qoder 桌面端国际版个人账号。之所以强调「国际版个人账号」,是因为活动范围写得很明确——免费、Pro 试用期、Pro、Pro+ 和 Ultra 都在范围内,但团队版(Teams)和企业版(Enterprise)不参与。
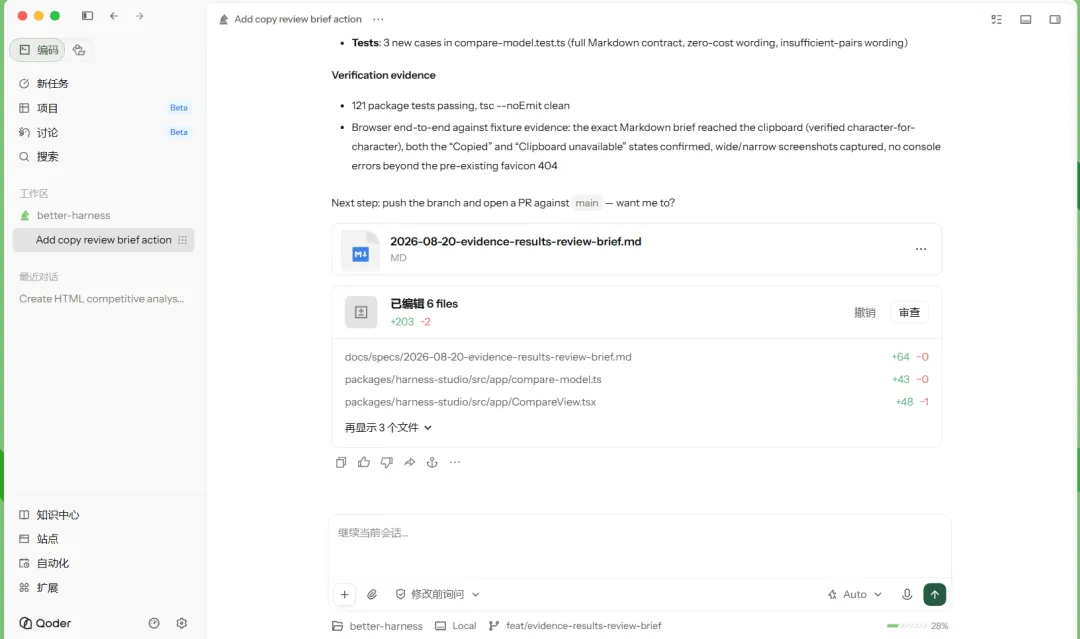
图3:Qoder 桌面端界面,右下角是模型选择器与 Credit 用量指示(来源:Qoder 官网)
如果要在终端里用,官方给出的安装与查看命令是两行:
curl -fsSL https://qoder.com/install | bash
qoder --list-models
第二行可以直接打印出当前账号可用的模型清单,不必先打开界面。
步骤 2:复现问题——我一开始根本没找到它
这是第一个坑。装好之后我打开模型选择器,看到的是四个档位:Auto、Ultimate、Performance、Efficient。一个个点开,没有 Qwen3.8-Flash。
我又去翻官方文档的「选择模型和推理强度」页面,把前沿模型那张倍率表从头看到尾:Qwen3.8-Max 0.5×、Qwen3.7-Max 0.5×、Qwen3.7-Plus 0.1×、Kimi-K3 0.8×、Kimi-K2.7-Code 0.3×、GLM-5.3 0.6×、GLM-5.2 0.6×、DeepSeek-V4-Pro 0.8×、DeepSeek-V4-Flash 0.3×、MiniMax-M3 0.2×。
没有 Flash。而表格上面有一行小字,我第一遍直接跳过了——
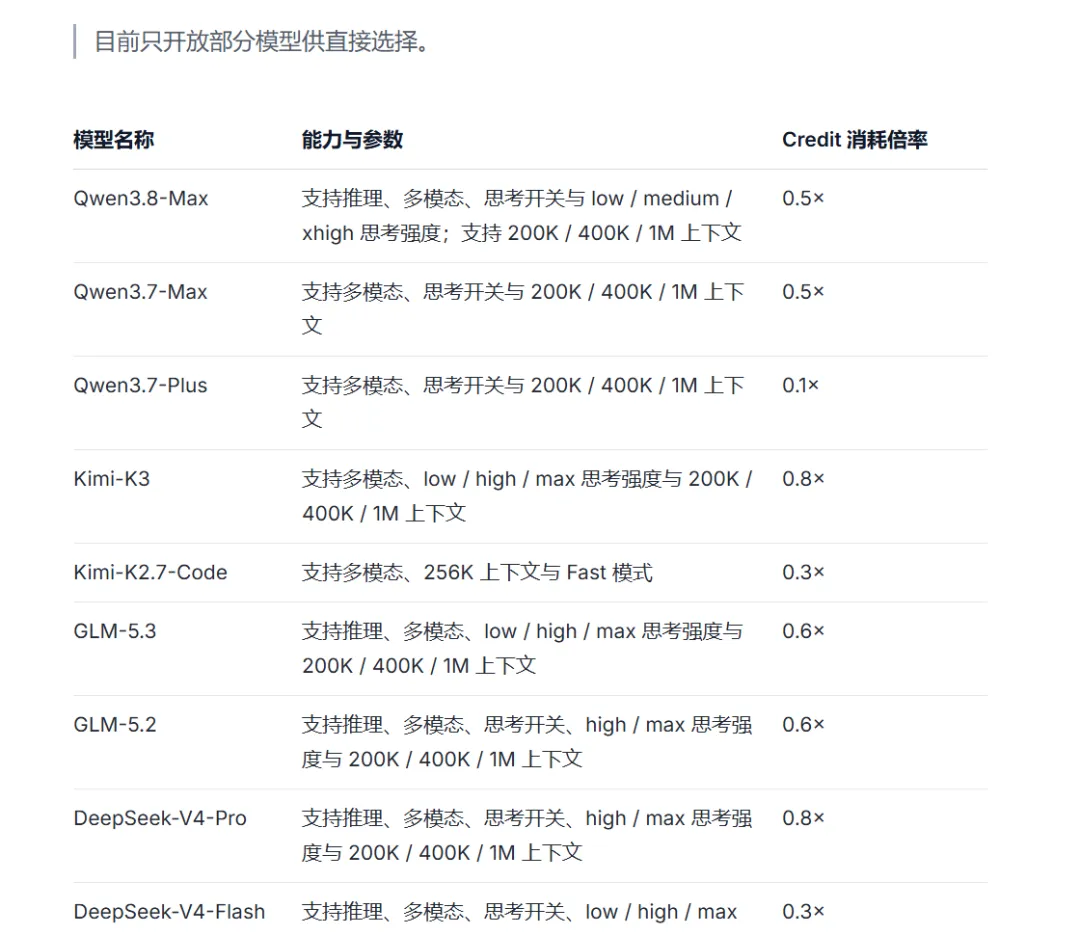
图4:官方文档里那行小字——「目前只开放部分模型供直接选择。」(来源:Qoder 官方文档)
「目前只开放部分模型供直接选择。」
那一刻我的判断是:要么活动页是营销口径,模型其实没上;要么它藏在别的地方。后来我在选择器里发现了它——模型选择器有三个标签页:默认档位、新模型、自定义模型。Flash 不在「默认」里,在「新模型」里。
第二个坑更实际。切到 Flash 之后我连跑两个任务,第二个卡了将近两分钟才出结果。我一度以为是配置问题,回去翻活动公告才发现官方早就写了:活动期间 Qwen3.8-Flash 用量较大,高峰时段可能出现响应较慢的情况。
免费必然带来排队。这跟模型能力无关,是容量问题,也是所有补贴策略的宿命。想通这点之后我的应对很简单:把不着急的批量任务挪到非高峰时段跑。
步骤 3:解决方案——不是切模型,是切任务
踩完这两个坑,我意识到真正的问题根本不是「哪个模型免费」,而是:我从来没有给自己的任务分过级。
于是我定下三条规则。
第一条:阅读类的活,全部交给 Flash。整仓通读、长文档归档、日志排查、素材归纳——这些任务吃的是上下文容量,不吃推理深度。Qwen3.8-Flash 原生支持 100 万 token 上下文、最大输入 99 万,把整个仓库塞进去一次读完完全够用,而这恰好也是它最便宜的地方。
第二条:只有「会出错的地方」才配用高倍率档。跨模块重构、疑难缺陷定位、需要反复自我否证的判断——这类活一旦返工,我付出的时间成本远高于那点 Credit 差价,所以留给 Ultimate。
第三条:把「思考强度」当成第二个成本旋钮。Flash 默认开启思考模式,推理力度可以用 reasoning_effort 调节。日常的信息提取、格式清洗用 medium 甚至 low 就够,只有架构梳理这类活才需要 xhigh。
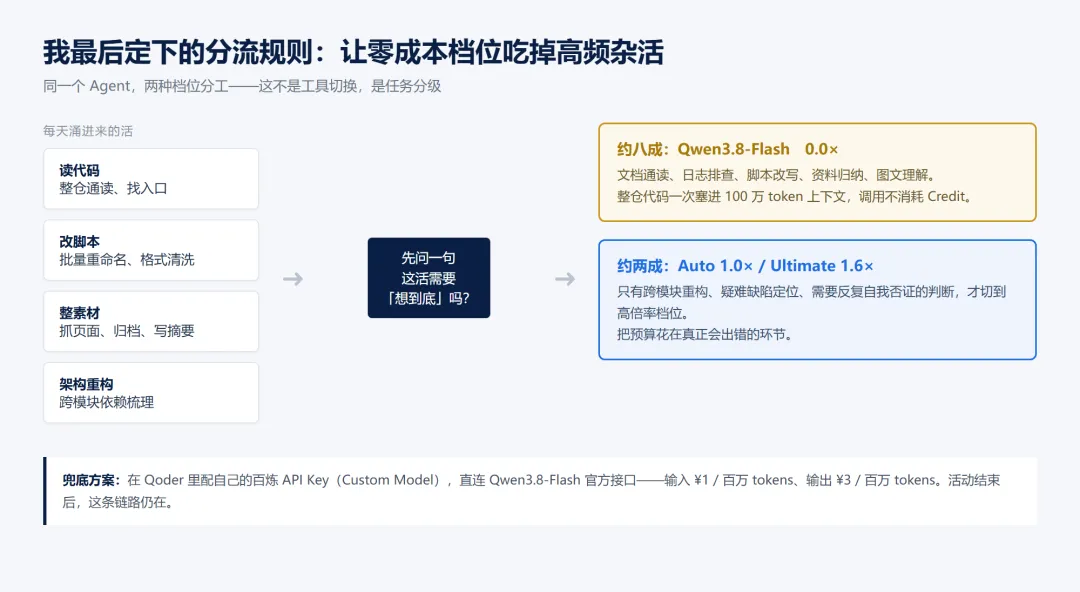
图5:我最后定下的分流规则——让零成本档位吃掉高频杂活
另外我还准备了一条兜底链路。活动 9 月 30 日结束,之后呢?我的答案是:不要在 Qoder 里等答案。
Qwen3.8-Flash 是开源的,接口完全兼容 OpenAI 协议。我在 Qoder 的「自定义模型」标签里配了自己的百炼 API Key,直连这条链路:
from openai import OpenAI
import os
client = OpenAI(
api_key=os.getenv("DASHSCOPE_API_KEY"),
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
)
resp = client.chat.completions.create(
model="qwen3.8-flash",
messages=[{"role":"user", "content": "梳理这份需求文档里的全部风险点"}],
extra_body={"enable_context_cache":True},
)
print(resp.choices[0].message.content)
这条链路的价格是明码的:输入 1 元 / 百万 tokens,输出 3 元 / 百万 tokens。活动是限时的,接口是长期的——真正不会被活动期限绑架的,是这一层。
步骤 4:测试验证——省下来的到底是什么
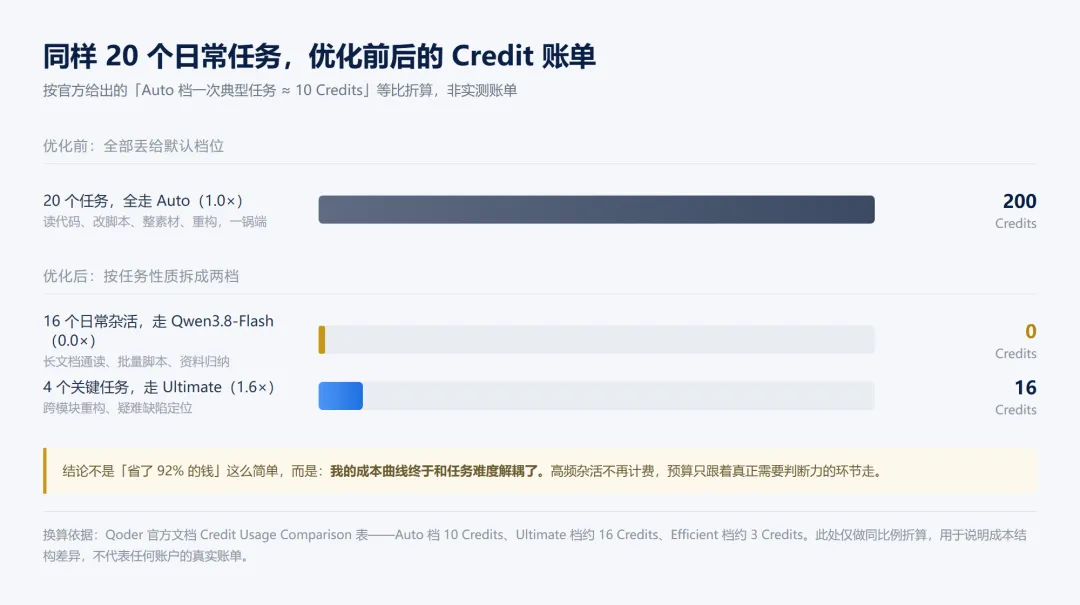
图6:同样 20 个日常任务,优化前后的 Credit 账单(按官方示例倍率折算)
按官方口径折算:同样 20 个日常任务,如果全部丢给默认的 Auto 档,大约是 200 Credits;拆成「16 个走 Flash + 4 个走 Ultimate」之后,大约是 16 Credits。
但我想说清楚的是,账面上省下的不是钱,是决策成本。
以前的真实状态是:每次派任务之前我都要先算一笔账——这个活值不值得花额度。很多本来可以交给 AI 去试的小事,我因为舍不得额度就自己动手了。现在高频杂活的边际成本是 0,我反而更愿意让它先去试。
这才是 0.0× 真正的价值:它把「要不要用 AI」这个决策,从成本问题变成了习惯问题。
当然,这次实践也有明确的边界,我一并写下来。
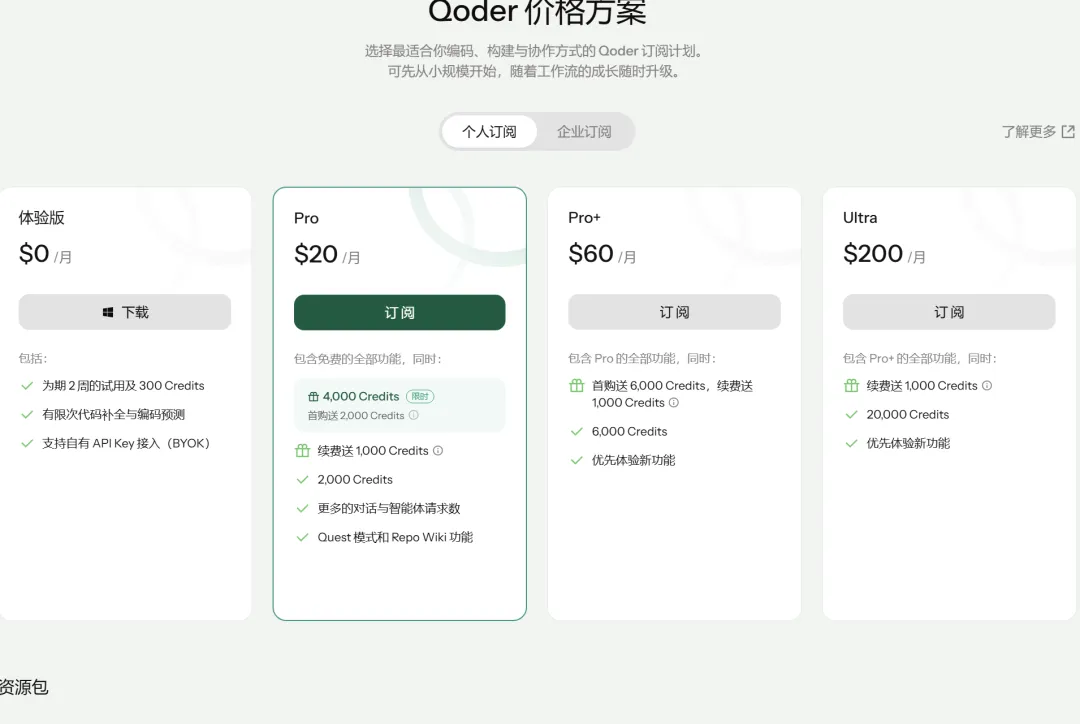
图7:Qoder 价格方案——体验版免费、Pro 20 美元/月含 2000 Credits(来源:Qoder 官网)
一是时间,活动只到 9 月 30 日 23:59:59(新加坡时间),是个十二天的窗口;二是容量,高峰排队说明「免费」和「随时可用」在物理上很难兼得;三是范围,企业版不在补贴内,团队协作链路暂时接不上;四是位置,真正难的任务仍然在 3.2× 那一档——免费档位解决的是频次,不解决难度。
四、我的判断:贬值的不是模型,是「用不用」这件事
第一,工具之间的能力差正在快速收敛。今天你觉得 A 比 B 强,可能一周之后这个差距就没了。真正的差异不在谁更聪明,而在谁的成本结构更适合你的任务分布。选工具的锚点应该从「能力榜」移到「我一天里有多少活属于哪一档」。
第二,被平权的从来是工具,不是方法。同样一个 0.0× 的模型,有人拿它省钱,有人拿它做完以前不敢做的尝试。差距不在谁先看到活动,而在谁先想清楚任务该怎么切。
第三,免费的东西确实是最贵的——前提是你的用法没变。如果你只是把原来的任务换个模型跑,收获的只是一张更低的账单;只有当你因为成本归零而改变了任务分配方式时,它才是真的免费。
模型正在变成水电,而定价权, 正在从「你用什么模型」转移到「你怎么切分任务」。