ARTICLE · 1116622
AI时代最稀缺的不是答案,而是验证
过去获得一个好答案很贵。一个复杂工程问题,可能需要几十名工程师工作几个月;一种新材料,需要科研团队反复实验;一个芯片架构,需要大量专家共同设计。AI正在迅速降低这部分成本。未来,一个AI系统可能在几分钟内提出1000种芯片布局、10000种冷却方案、100万种材料组合。于是一个新的问题出现了:当答案几乎可以无限生成,我们怎么知道哪一个是真的?这可能成为AI进入科学和工业之后最重要的瓶颈。AI时代真正稀缺的,可能不再是答案,而是验证。
生成正在变得越来越便宜
生成式AI已经证明了一件事情:信息生产的边际成本可以快速下降。文章可以生成,代码可以生成,图片可以生成,设计方案同样可以生成。随着模型能力提高,AI能够进入越来越复杂的领域。未来工程师面对的可能不是“想不出方案”,而是方案太多了。
一个数据中心冷却系统,AI可以同时提出风冷、液冷、混合冷却以及大量不同管路、流量和温度组合。一个燃气轮机叶片,可以产生大量不同的内部冷却流道。一个芯片,可以产生大量不同的布局和互连方案。一个新材料,可以产生海量候选配方。这时候,人类面临的问题发生了反转。
过去是:
没有足够多的答案。
未来可能变成:
有太多答案,却没有足够能力证明哪些答案正确。
AlphaZero为什么能够成功?
AlphaZero有一个现实世界很难复制的优势:验证极其便宜。棋盘是一个近乎完美的实验室。规则确定,状态清楚,胜负明确。一盘失败之后,可以立刻重新开始。机器因此可以进行海量试错,但工业世界完全不同。如果AI设计一座桥梁,不能真的建10000座桥测试。如果AI优化一台燃气轮机,也不能让10000台发动机全部运行几年以后再选择最好的一台。如果AI设计一种药物,更不能直接在人身上进行大规模试错。所以从AlphaZero走向Physical AI,中间横着一道巨大的鸿沟:现实世界的验证成本。谁能够降低这个成本,谁就可能掌握AI进入工业世界的重要入口。
仿真会成为第一层验证
最便宜的办法,是尽量把现实世界搬进计算机。CFD模拟流体。FEA分析结构。EDA验证芯片。数字孪生模拟工厂和设备。分子模拟研究材料和药物。AI产生100万个方案之后,不需要全部制造出来。可以首先通过低成本模型淘汰90%。再通过高精度仿真淘汰剩余方案中的90%。最后只把最有希望的一小部分送入真实实验。未来的研发体系可能越来越像一个漏斗:
百万级AI生成
↓
十万级快速模拟
↓
万级高精度仿真
↓
千级工程验证
↓
百级原型
↓
十级真实测试
↓
最终产品
AI负责扩大探索空间。仿真负责快速缩小空间。现实世界负责最后确认答案。
仿真本身也必须被验证
这里存在一个容易被忽略的问题:
Simulation is not Reality.
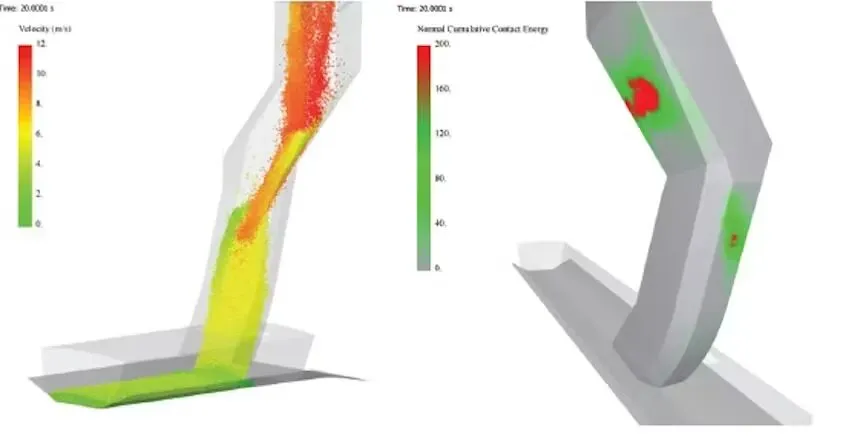
一个方案在CFD里表现完美,并不意味着真实世界一定成立。边界条件可能设置错误。材料参数可能不准确。制造公差可能没有考虑。设备老化可能没有进入模型。甚至AI可能找到仿真系统中的漏洞,产生一个数学上优秀、现实中荒谬的答案。所以真正成熟的体系必须形成第二个闭环:
现实实验 → 修正仿真 → AI重新探索 → 再实验。
真实世界不断校准数字世界。数字世界再帮助人类减少真实世界的试错。这才是工业AI真正可以长期运行的结构。
自动实验室可能成为下一代“AI数据中心”
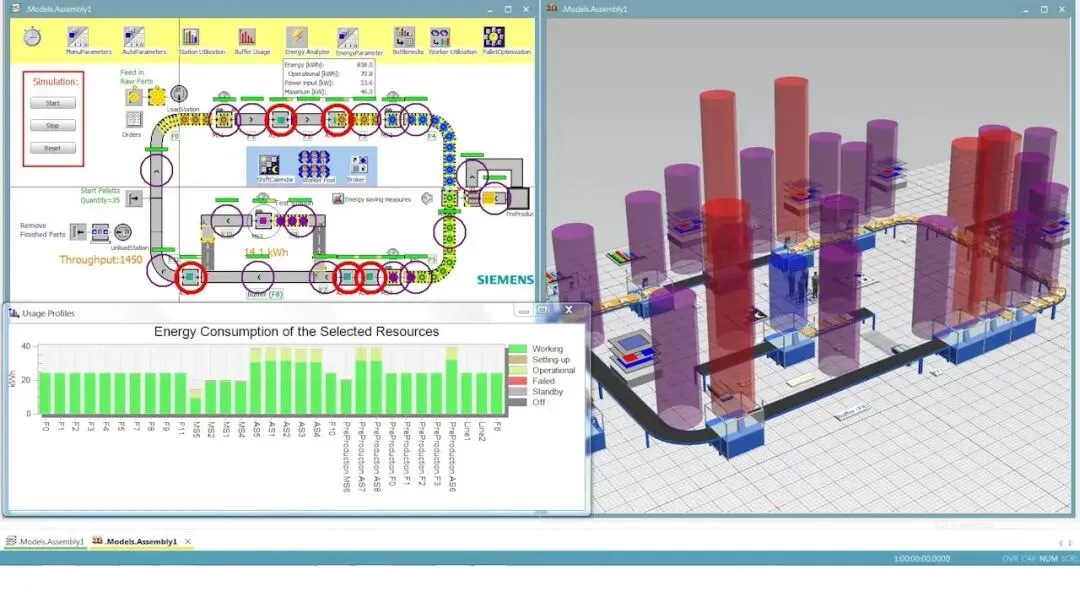
如果这个逻辑成立,一个很有意思的产业机会就会出现:Automated Lab。今天的大型AI数据中心,本质上是在规模化生产计算。未来的自动实验室,则可能是在规模化生产:经过验证的数据。AI提出实验方案。机器人完成取样、配料、加工。仪器自动测试,机器视觉观察变化,检测设备采集结果。AI分析数据,然后决定下一轮实验。实验室从一个由人逐项操作的地方,逐渐变成一台24小时运行的“经验机器”。这对材料、化学、电池、半导体、生物技术等行业尤其重要。过去一个博士一天完成几组实验。未来一个自动化实验平台可能持续运行数百甚至数千个实验循环。科学发现开始拥有工业生产的节拍。
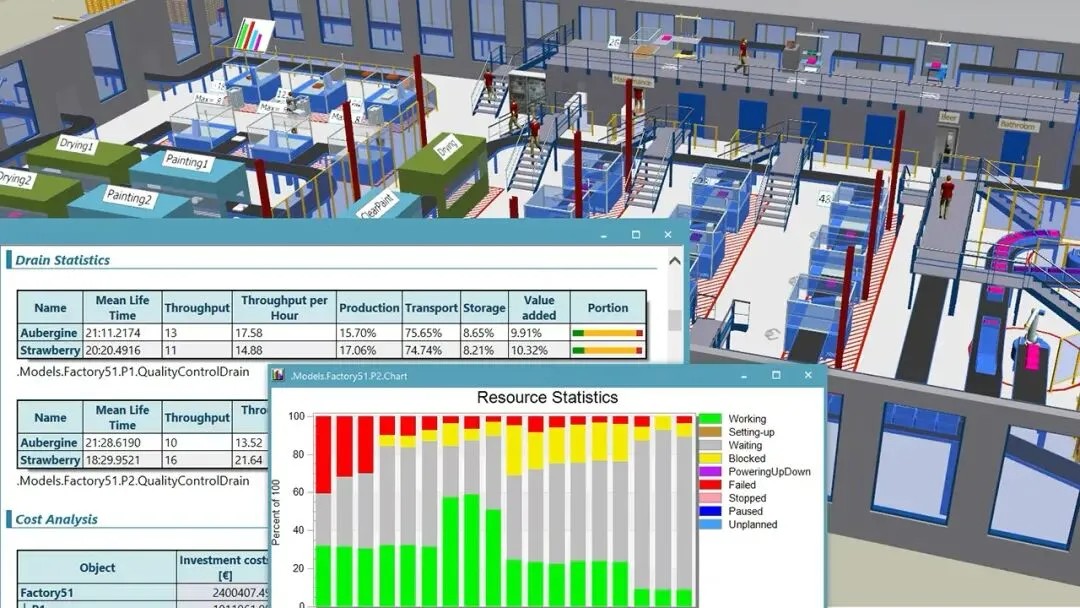
制造能力本身,也会成为AI基础设施
再往前一步,会发现一个更加重要的变化。当AI开始设计物理产品以后:工厂本身就是AI基础设施。AI设计一个新的涡轮叶片。首先进行仿真,然后需要增材制造或精密加工制造样品。再进入高温、高压、疲劳测试。测试结果重新进入模型。没有制造能力,AI就停留在屏幕里。所以未来所谓“AI基础设施”,可能不能只理解为:
GPU + Data Center
它还会包括:
GPU + Data Center + Simulation + Robotics + Factory + Laboratory + Testing。
这是一套连接数字世界与物理世界的完整基础设施。为什么工业数据会越来越值钱?今天的大模型主要依赖互联网数据。但互联网有一个天然限制:它记录的是人类已经产生的信息。
而真正高价值的工业数据,很多根本不存在于互联网上。一个燃气轮机叶片运行50000小时之后出现裂纹的数据。一条半导体产线某个微小参数变化导致良率下降的数据。一个液冷系统运行三年之后不同材料腐蚀程度的数据。一块电池经过数千次充放电后的内部变化。这些数据无法简单从互联网抓取。它们必须通过真实设备、真实生产和真实时间获得。因此未来可能出现一种非常重要的数据:
Ground Truth Data——现实世界验证数据。
这种数据可能比普通互联网文本更加稀缺。因为它背后需要工厂、设备、实验室、能源、材料和时间。
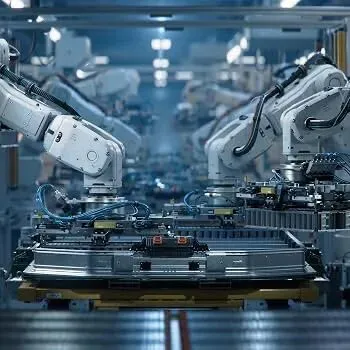
AI越强,物理世界反而越重要
这似乎有些反直觉。很多人认为AI越强,现实资产越不重要。但如果AI真正进入科学和工业,情况可能恰恰相反。当生成能力趋近于无限之后:现实世界成为最后的裁判。AI可以设计100万种飞机,风洞告诉你哪些真的有效,AI可以设计100万种材料,实验室告诉你哪些真的存在,AI可以优化100万种工厂方案。生产线告诉你哪些真的能够稳定制造。因此,AI越强大,能够连接AI与现实世界的基础设施可能越重要。
未来企业真正的护城河:闭环速度
所以未来评价一家工业AI公司,也许不能只看:模型参数多少?GPU有多少?而应该问:
一天能够完成多少次真实有效的学习循环?从提出方案,到仿真,到制造,到测试,到获得数据,再回到模型,需要多久?
一年?
一个月?
一天?
还是一小时?
这个周期可以称为:
Learning Loop Time——学习闭环时间。
过去企业竞争产品开发周期。未来可能进一步竞争:经验更新周期。谁的闭环更快,谁就能够更快发现错误、更快积累经验、更快形成下一代产品。
AI产业的价值正在继续迁移
如果把AI过去几年的发展放在一起,会看到一条很清晰的路径。
最初稀缺的是:模型。
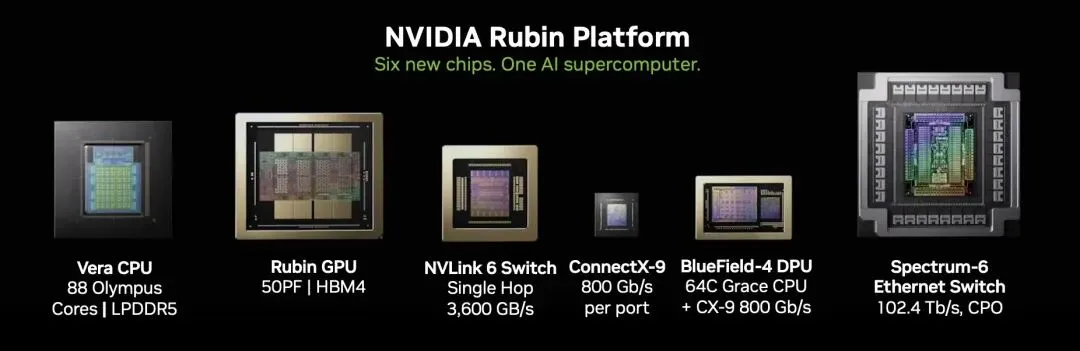
然后稀缺的是:GPU。
GPU越来越多以后,开始稀缺:电力、数据中心、网络、存储。
当AI进一步进入工业世界,又会开始稀缺:高质量工业数据、仿真、实验、制造和验证能力。价值永远向瓶颈迁移。所以寻找AI下一轮产业机会,一个很重要的方法不是预测哪家公司会推出下一个模型。而是不断问:当这一层能力变得无限便宜之后,下一层什么东西会变得稀缺?
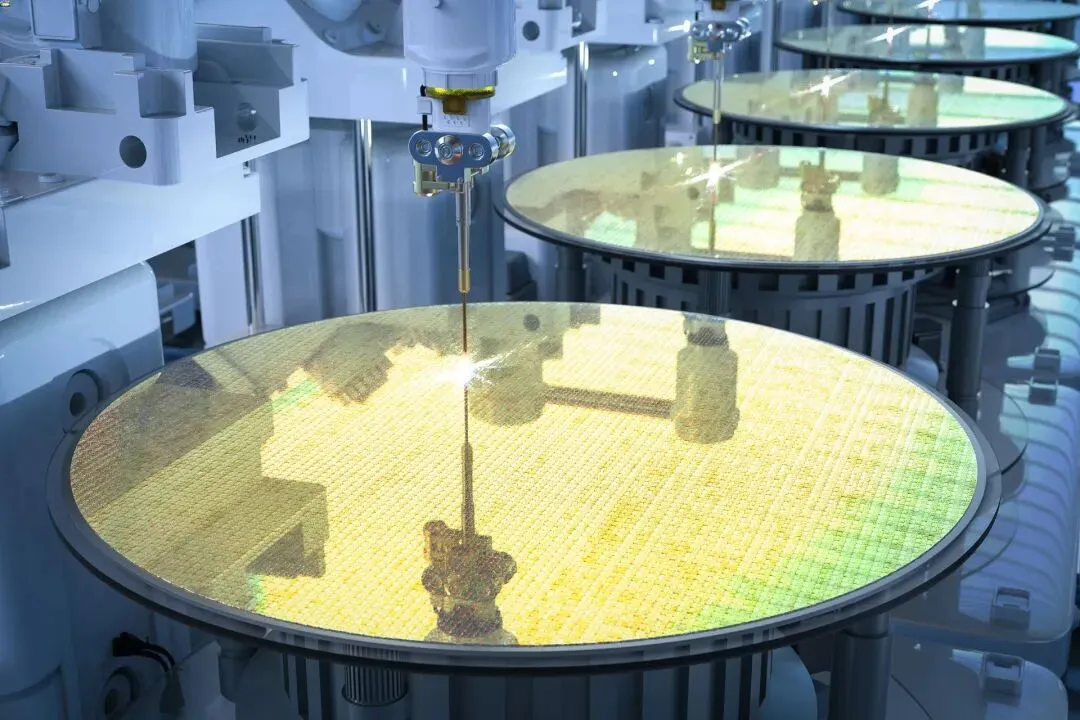
从智力工业化,到经验工业化,再到验证工业化
这可能构成AI发展的另一条主线。
第一阶段:
智力工业化。大量认知任务开始由机器完成。
第二阶段:
经验工业化。机器通过仿真和探索,大规模产生新的候选经验。
第三阶段:
验证工业化。自动化实验、机器人、测试设备和真实工业系统,大规模验证机器产生的答案。
当这三个环节连接起来之后:
AI → Explore → Simulate → Build → Test → Learn
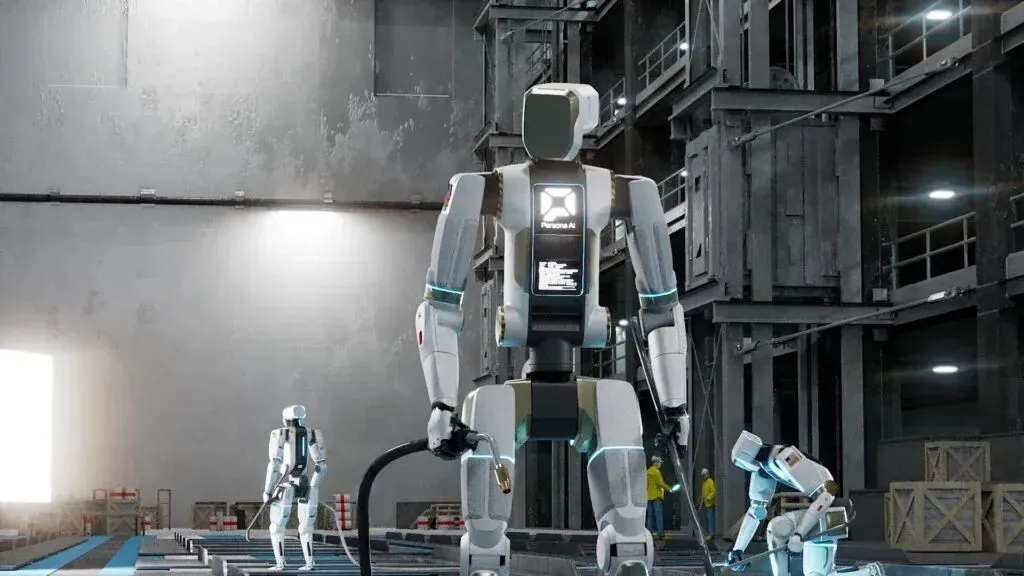
AI就不再只是一个回答问题的软件。它开始成为一个持续发现新知识的系统。而那个时候,人类真正获得的可能不只是更便宜的智能。而是一种过去从未拥有过的能力:把科学发现和工程试错本身,变成可以规模化运行的生产过程。AI可以生成无限种可能。但现实世界只能接受其中真正成立的那几个答案。所以AI时代最稀缺的,最终可能不是创造答案的能力,而是证明答案的能力。