ARTICLE · 1116992
篇九 AI制药入门:计算化学与新工具到底在做什么?
本篇是“新药研发全景系列”AI特别篇。在《Drug Discovery and Development: Technology in Transition》的成书年代,“计算化学”还是药化团队里的一个支持岗位;而今天,“AI制药”已经是资本市场的关键词。工具在换代,但研发的问题清单没有变——还是那个漏斗:找靶点、找分子、优化性质、过临床。这一篇我们不追热点名词,而是逐个回答三个朴素的问题:AI和计算方法正在研发链条的哪些环节干活?它们干得怎么样?边界在哪里?
一、开场:先泼一盆冷水,再画一张地图
先说一个许多宣传材料不会告诉你的事实:
药物研发的核心困难不是“分子太多算不过来”,而是“数据太少、噪声太大”。
一个靶点的高质量活性数据,往往只有几千条,且来自不同assay、不同实验室,可比性存疑;
临床失败数据大多不公开——AI最想学的“为什么失败”,恰恰是行业的私有财富;
生物系统本身高维、非线性、动态——分子进细胞后的故事,远比“结合能算准”复杂。
因此判断AI制药项目的成色,第一个问题永远是:“它在哪个环节、用什么数据、回答什么决策问题?” 带着这个问题,我们看地图。
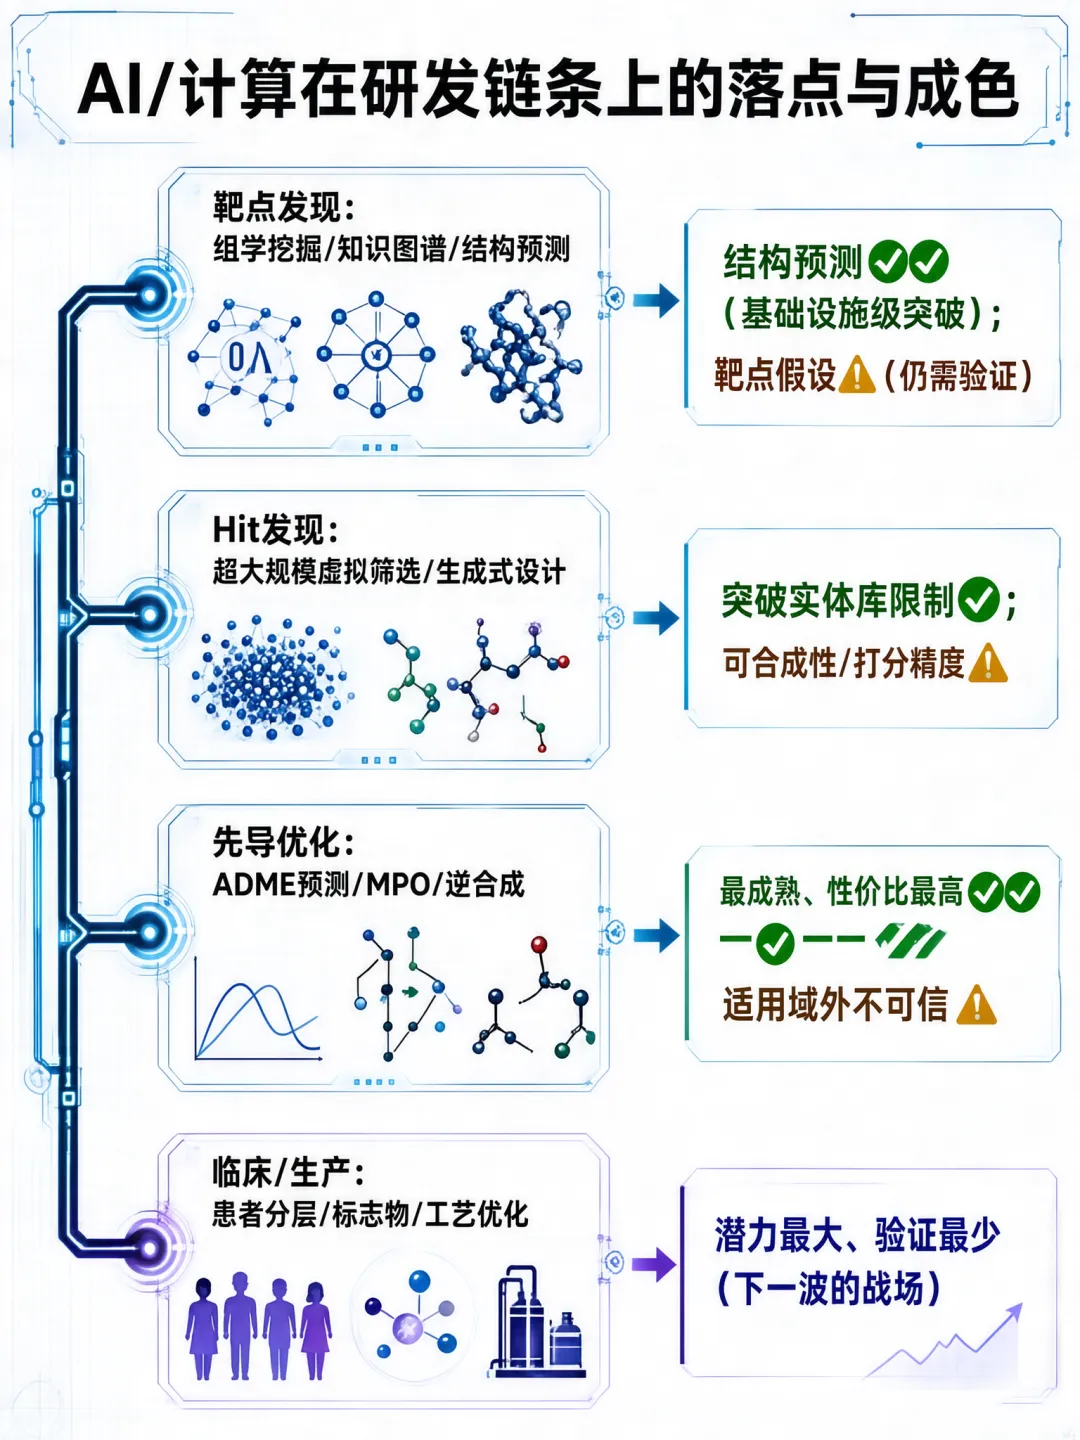
二、地图:AI/计算工具在研发链条上的落点
我们一站一站逐段来看。
三、第一站:靶点发现——“从文献和组学里淘金”
在做什么
组学数据挖掘:从单细胞测序、蛋白组学数据中寻找疾病相关的分子特征(呼应第五篇靶点发现的五大来源);
知识图谱与文献挖掘:把数百万篇文献、专利、数据库中的“基因-疾病-通路-药物”关系抽成图谱,寻找隐藏关联——AI的强项之一是在海量弱证据里发现人的注意力覆盖不到的连接;
蛋白结构预测:AlphaFold类模型把蛋白结构预测从“按年计的晶体活”变成“按秒计的计算活”,间接让所有下游基于结构的工具(对接、FBDD、PROTAC设计)获得了几乎无门槛的起点结构。
成色如何
✅ 结构预测是近十年最确定的突破——它没有直接发现药,但改写了整个“基于结构设计”的基础设施;
⚠️ 靶点发现环节,AI的价值是“提出更好的假设”,不是“证明假设”——因果验证仍要回到CRISPR、动物模型、人体遗传学(详见篇三)。
四、第二站:Hit发现——虚拟筛选与生成式设计
1. 超大规模虚拟筛选
可合成分子空间(如REAL库)已达百亿级,AI打分模型 + 高性能计算可以全空间扫描。相比传统对接,机器学习打分函数在速度上有数量级优势,但打分准不准仍是最大短板——记住篇四的提醒:虚拟筛选给的是“候选名单”,不是“命中证明”,湿实验确认一步不能省。
2. 生成式设计(Generative Design)
这是“AI制药”最出圈的方向:不筛已有分子,而是让模型按目标性质“画”出新分子——
条件生成:输入“要结合这个口袋、logP<3、不要hERG活性”,模型输出分子结构;
三大技术流派:基于SMILES序列的自回归模型、基于3D口袋结构的扩散/等变模型、基于片段连接的组合生成;
闭环验证:头部团队的实践是“生成→计算评估→合成→测活性→数据回流再训练”的主动学习循环,AI的产出质量高度依赖这个闭环转得多快。
3. 成色与边界
✅ 在“化合物可得性”上,生成式AI确实打破了实体库的限制;
⚠️ 可合成性(synthesizability)是最大软肋——模型画出的分子,有机化学家可能根本做不出来。成熟的平台必须内置“合成可达性”约束与逆向合成评估;
⚠️ 生成的分子再漂亮,也只是候选名单——从分子到先导的十万八千里(篇五和篇六的SAR/ADME优化),依然要靠实验化学家一步步走。AI压缩的是“发现Hit”的时间,不是“优化分子”的时间。
五、第三站:先导优化——ADME预测与MPO的“计算化”
在做什么
这是AI在药研中最成熟、性价比最高的应用(因为它有最规整的数据):
ADME性质预测:微粒体清除率、Caco-2渗透、溶解度、CYP抑制、hERG——用历史积累的海量数据训练的回归模型,准确度已能支持“合成前预筛”;
性质空间导航:把篇五的MPO打分与预测模型结合,设计分子时在电脑上先“合成”一遍,淘汰明显不及格的方向;
反应预测与逆合成规划:AI辅助设计合成路线,缩短类似物迭代的周期——SAR迭代的瓶颈常常不在想法,而在合成速度。
成色如何
✅ ADME预测是目前AI制药“投入产出比最高”的应用——数据规整、决策成本低、错了重算就行。篇五说的“预防一次违规,省下一轮合成”,AI让这个原则可以规模化执行;
⚠️ 但要理解模型的天花板:训练数据分布之外的分子,预测不可信。模型给的是概率,不是判决——关键分子仍要实验确认。
六、第四站:临床与开发——AI的“第二增长曲线”
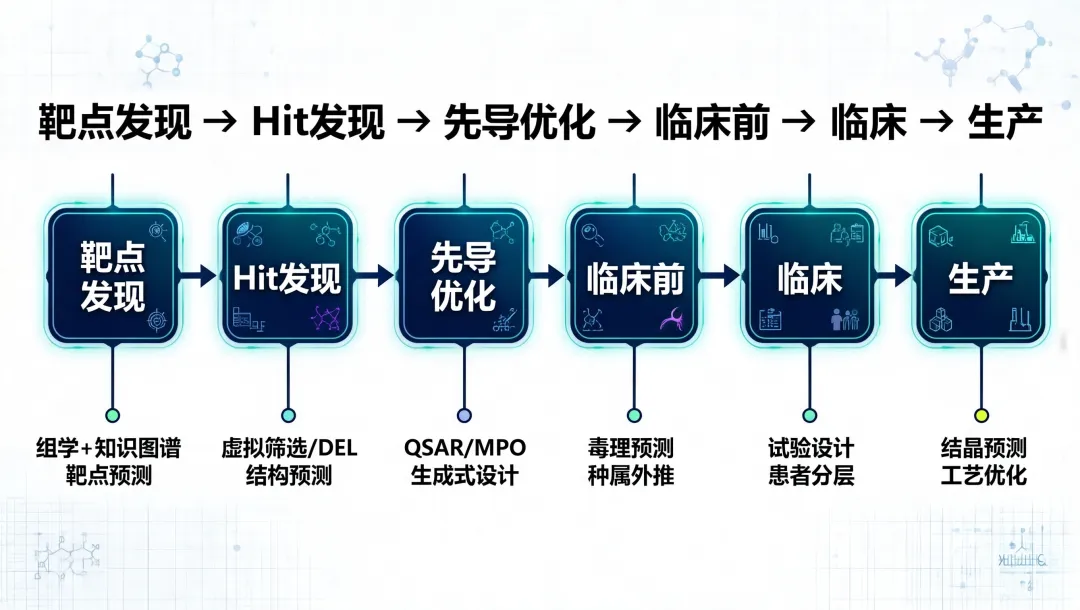
很多人以为AI制药只管找分子,其实临床阶段的AI应用潜力可能更大:
试验设计与患者分层:用真实世界数据找最可能响应的患者亚群、优化入组标准——II期PoC失败的最大原因之一就是人群没选对(第五篇靶点验证的逻辑在临床的延伸);
生物标志物开发:多组学数据训练的响应预测模型,为临床提供分层依据;
毒理信号预测:用历史毒理数据库预测化合物的器官毒性风险,辅助候选物排序;
工艺与生产:结晶条件预测、工艺参数优化(工艺化学的数字化趋势)。
七、冷静剂:AI制药的四个真相
真相一:AI改变的是“概率分布”,不是“游戏规则”。 药物研发的成功率由靶点假设质量、生物学理解深度决定。AI能让每个环节更快、更便宜,但靶点错了,AI只是帮你更快地走向失败——篇三的靶点验证逻辑依然是总纲。
真相二:数据是护城河,算法不是。公开算法人人可用,但私有、高质量、成体系的数据(自产SAR、内部PK、临床数据)才是差异化竞争力。评估任何一家AI制药公司,先问它的数据从哪来、闭环在哪。
真相三:AI与实验不是替代关系,是“设计-验证”循环的两半。最有效率的团队不是“AI团队+实验团队”,而是深度融合的DMTA闭环:计算提出假设、化学快速合成、生物快速验证、数据当天回流。闭环速度,才是新范式下真正的研发效率指标。
真相四:人才的需求变了,但没有变夸张。 行业最缺的不是“会调参的程序员”,而是**“懂药化的计算人”和“懂计算的药化人”** ——能判断模型的适用域、能把业务问题翻译成计算问题的人。这与补充篇“角色分工”的结论一脉相承:未来最值钱的,仍然是能在接口处说双方语言的人。
八、本篇小结:一张卡带走
一句话总结:AI没有改变药物研发的漏斗逻辑,它改变的是漏斗每一层的“流速”和“成本”——而漏斗的入口质量(靶点)和出口质量(临床验证),依然由生物学、化学和医学的硬功夫决定。
📌 预告·下一篇:《生物药发现:抗体、大分子与小分子世界的差异》
如果这篇对你有帮助,欢迎点赞、在看、转发。评论区聊聊:你觉得AI制药最有可能先在哪个环节真正兑现价值?