ARTICLE · 1122053
AI 科研日报 | 2026-10-04
今日 arXiv 的关键词是 "会看、会想、会算得更聪明"。一边是多模态模型的能力正被"外围组织"彻底激发(VISTA):不训练模型、只装上一个"长时程视觉挂载",就足以把交互式推理拉到满分,这已经是连续第二天有此类工作出现,说明"harness 即能力"的范式正在成型;另一边是模型训练的底层成本被大幅压缩(TACO):一个把优化器状态做到三元稀疏的优化器,就能在单卡上全参微调 32B 模型,让"人人都能训大模型"又近了一步。同时,数学与扩散的交叉正在变深——The Missing Primitive 用"数学原语"诊断模型推理的真正瓶颈,HC-DLM 则继续在离散与连续潜空间的融合上前进。本文将深入介绍这 4 篇有框架图的代表性工作。
一、精选论文
1. VISTA:给多模态模型装上"长效视觉"的 Harness
链接:https://arxiv.org/abs/2610.02200 作者:Qiushi Han, Keya Hu, Linlu Qiu, Cathy Wu, Kaiming He
多模态模型本身已具备相当强的推理能力,但能否在复杂交互环境中实际完成任务,往往取决于包裹它的"harness"。本工作提出 VISTA,一个为通用多模态模型提供长时程视觉的挂载:模型透过视觉观察直接感知环境,并维护一份无损视觉记忆,把历史观测的原始形态保存下来;模型可以主动取回这些观测,在推理过程中重组自己的视觉输入。
实验结果是惊人的:在 ARC-AGI-3 上,VISTA 把 Claude Opus 5.0 的 Relative Human Action Efficiency 从 40.68 直接提升到满分 100.00,模型仅用 25 个公开游戏、比首次游玩的人类少 57.4% 的动作便全部完成。由于设计简单,VISTA 还能以最小改动自然扩展到多样视觉环境,在覆盖不同视觉游戏与谜题的三个额外基准上,均显著优于使用同一底层模型的"裸"基线。
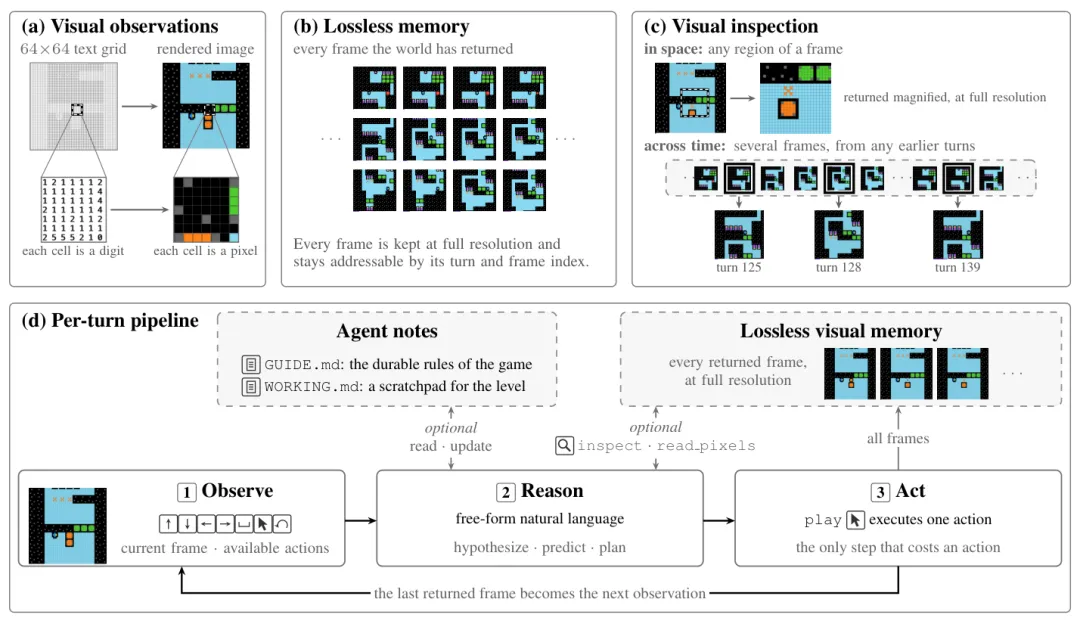
意义:再次印证"模型能力是否显现,取决于外围组织"——一个不引入任何新训练、仅靠记忆与检索策略的 harness,就能把已有多模态模型的交互式表现拉满,为通用视觉智能体提供了一块可复用的"外脑"。
2. TACO:把 LLM 全参微调的显存需求压缩 174 倍
链接:https://arxiv.org/abs/2610.02199 作者:Jichao Jiang, Cristian McGee, El Houcine Bergou, Hanqin Cai, Aritra Dutta
大模型全参微调的核心瓶颈之一,是 Adam 类优化器要同时保存一阶动量与二阶动量,其状态内存往往比模型权重本身还要大。本工作提出 TACO(Ternary Absolute-max Column-wise One-sparse Optimizer),把优化器状态压缩到极致:只保留每个列的最大绝对值并做成三元稀疏表示,将 LLM 全参微调的优化器状态内存相对 AdamW8bit 压缩约 174×,峰值内存降低 2.9×。
这一极致的压缩不是免费的幻觉——TACO 在保持收敛性与任务精度的同时,让单张 80GB H100 上就能全参微调 30-32B 参数模型,把此前需要多卡甚至更大显存才办得到的事情,压缩进了一块常用工业级 GPU。作者在多种规模与任务上系统验证了该优化器的稳定性与效果。
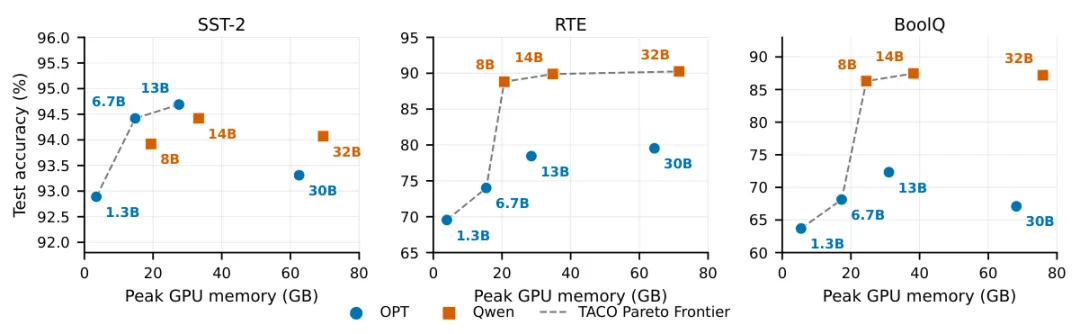
意义:优化器状态常是微调显存的最大作弊者之一,TACO 用"列级三元稀疏"的巧妙设计把它砍到几乎可以忽略,显著降低了大模型全参微调的硬件门槛,是高效训练方向上一份很实在的工程贡献。
3. The Missing Primitive:诊断并修复 LLM 的数学推理
链接:https://arxiv.org/abs/2610.02191 作者:Shuo Xing, Zilin Dai, Chengyuan Qian, ... Zhengzhong Tu
我们常说"大模型数学能力不足",但具体差在哪一环?本工作提出一个引人深思的答案:差在**数学原语(mathematical primitive)**上。作者把数学推理拆解为四个可单独考核的维度——Discovery(发现)、Generation(生成)、Digestion(消化)、Execution(执行),并据此构建一个细粒度基准,逐一探明模型在哪一步真正掉链子。
结论相当有导向性:Discovery 是数学推理的主导瓶颈——模型往往不是不会生成或执行算式,而是"找不到"正确的解题思路。基于这一诊断,作者提出 primitive-privileged 自蒸馏框架:专门强化 Discovery 环节,让教师在"拥有原语先验"的设定下指导学生,从而更精准地修复推理短板,在基准上取得显著提升。
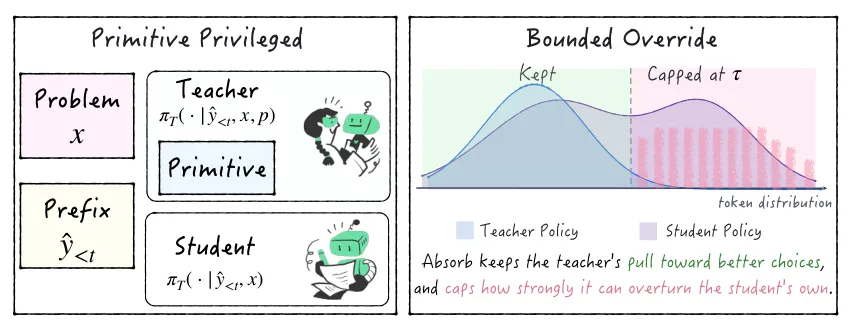
意义:把"数学能力"从笼统的体感拆解为可诊断、可修复的具体模块,并为"瓶颈在哪、该往哪儿使力"给出了数据支撑的答案,对后训练与推理增强都有直接指导价值。
4. KaliBench:给 LLM 一把可验证的"网络安全瑞士军刀"
链接:https://arxiv.org/abs/2610.02206 作者:Pengfei Li, Naufal Suryanto, Sicheng Zhang, Muzammal Naseer
让 LLM 真正"用工具干活",在网络安全领域格外困难——指令往往模糊、错误代价高、且难以自动化验证。本工作提出 KaliBench,一个针对 Kali Linux 的自然语言→CLI 翻译细粒度基准与数据集:包含 8504 条查询-命令对、覆盖 1642 个工具,并设计了无需运行时(runtime-free)的可验证奖励,即既不需要真实执行危险命令,又能客观校验答案是否正确。
评测结果相当冷静:目前最先进的开源模型,其 exact-command 准确率仍不足 42%——这意味着 LLM 在真实安全工具调用上,离"可靠拿来用"还有很大距离。KaliBench 把这一差距量化和结构化,为安全智能体的评测与训练提供了稀缺的公共基座。
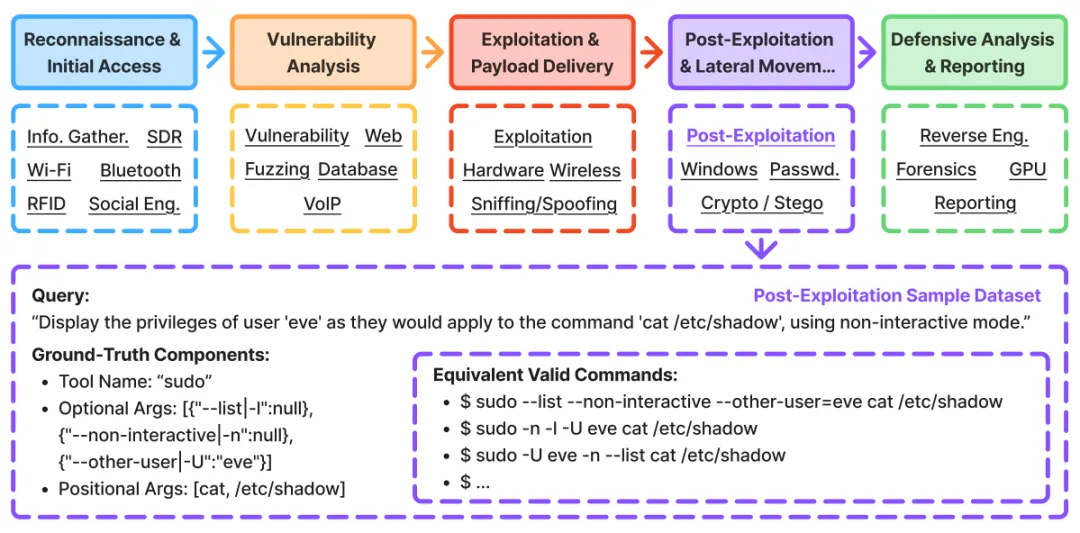
意义:在安全这一"高风险、难评测"的应用场景,KaliBench 用免运行时可验证奖励解决了"不敢实测、难以打分"的痛点,为 LLM 工具调用研究补上了一块空白拼图。
五、简讯(10-04 最新)
Sphere Encoder 2(arXiv:2610.02208):修复球面纬度稀疏与像素级重建造成的模糊,提升一步图像生成质量,同时保持自编码器速度。 Reconstruct, Practice, Go Real(arXiv:2610.02204):无需更新权重的自主机器人技能改进框架,22 个操作任务成功率从 28.6% 提升到 95%,冻结系统在真实 30 次物理试验全部成功。 FERPO(arXiv:2610.02198):不微分 critic 动作梯度的在线最大熵强化学习,用 forward-KL 鼓励多模式覆盖,在 MuJoCo Playground 与 ManiSkill 上刷新样本效率。 HC-DLM(arXiv:2610.02193):把离散 token 生成与连续潜轨迹耦合进单一去噪过程,在 Sudoku/Countdown/LM1B 上优于离散与连续扩散基线。 HiPhy、SILSA、ScholarCatalyst、GALA、InterEvolve、ROWBench 等亦于同日发布,涉及物理推理、3D 生成、工具调用与演化基准等方向,可后续补看。
三、趋势观察
"Harness 即能力"进入爆发期:VISTA 连续第二天证明,不训练模型、只改进感知与记忆组织方式,就能把多模态模型的交互表现拉满。越来越多工作开始意识到,模型潜力与"外围装配"之间的鸿沟才是真正的可优化空间。 训练成本"贴地飞行":TACO 把优化器状态压到三元稀疏,让全参微调 32B 落到单卡——结合此前多篇低显存训练工作,大模型的"平民化"训练正从口号变成可复制的工程现实。 "诊断优先"成为后训练方法论:The Missing Primitive 用四个维度定位数学推理的真实瓶颈,HC-DLM 等继续探索更合理的生成结构——两者共同说明,与其盲目堆算力,不如先搞清楚"模型到底在哪一步想不明白"。
本期日报由自动调研流程生成,内容基于公开学术预印本,仅供参考。