ARTICLE · 1125134
AI 编程最烧钱的是工具输出,这个 MCP 管家把它们全拦在沙盒
如果你用 Claude Code、Codex 或者 Cursor 干过稍大的活,对下面这个场景不会陌生:让 AI 抓个网页看看结构,它调一次 Playwright,快照原文 56KB 直接进对话;让它翻 20 个 GitHub issue,又是 59KB。半小时下来,上下文窗口四成的空间被工具的原始输出占掉了。然后触发压缩(compaction),压缩完 AI 忘了自己刚改到哪个文件、任务做到哪一步,你只能从头再讲一遍。
这是 AI 编程工具目前最实际的一笔隐形成本:你付的 token 账单里,很大一部分不是花在「思考」上,是花在搬运原始数据上。
context-mode(github.com/mksglu/context-mode,GitHub 搜索同名即可找到)是一个专门堵这个漏洞的 MCP server。它的一句话介绍是「context 问题的另一半」——市面上多数优化在管「系统提示和工具定义有多大」,它管的是「每次工具调用吐出来的数据有多大」。我把它 9.4 万字符的 README 从头到尾翻了一遍,这篇说说它的原理、用法、数字怎么理解,以及哪些场景它帮不上忙。
先看它的核心逻辑:数据不过对话,过沙盒
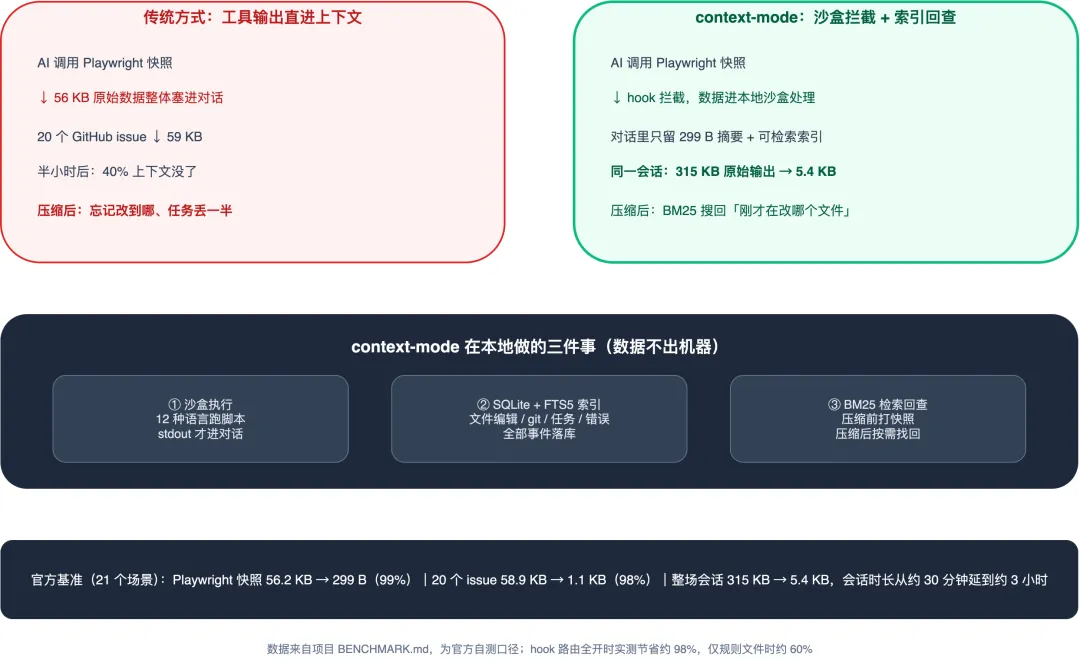
传统方式下,AI 调用工具,工具的完整输出直接进入对话上下文——快照、日志、API 响应,有多少进多少。context-mode 在中间加了一层 hook 拦截:AI 调用 Playwright 或者读文件时,hook 把这次调用重定向到沙盒,原始数据在沙盒里处理完,只有一小段摘要回到对话。
具体拆开是三件事,全部在本地完成:
第一件,沙盒执行。 ctx_execute 工具支持 12 种语言跑脚本,脚本在独立子进程里运行,只有 stdout 进入对话。也就是说 AI 想分析一个 45KB 的访问日志,它写一小段脚本去数、去过滤,把结论带回来,日志原文从头到尾不进对话。
第二件,会话事件落库。 每次文件编辑、git 操作、任务创建、报错和修复,都被 hook 捕获后写进本地 SQLite。这些事件按优先级分层——文件和任务是最高级,延迟统计这种是最低级。
第三件,压缩时打快照,之后按需检索。 对话要压缩时(PreCompact hook 触发),它把会话事件整理成一份 2KB 以内的结构化快照存起来;压缩完成后新上下文里注入这份快照,AI 就知道「上个会话改了哪些文件、有哪些任务没做完、用户纠正过什么」。更细的事件数据进了 SQLite 的 FTS5 全文索引,AI 需要时用 BM25 搜索找回来,而不是把全部历史塞回上下文。
那些数字怎么看
README 里最抓眼球的数字是「98% 降幅」:整场会话 315KB 原始输出压到 5.4KB。这是官方自测口径,出自仓库里的 BENCHMARK.md,一共 21 个场景。几个有代表性的:
| 场景 | 原始大小 | 进入上下文 | 降幅 |
|---|---|---|---|
| Playwright 快照 | 56.2 KB | 299 B | 99% |
| GitHub issue × 20 | 58.9 KB | 1.1 KB | 98% |
| 访问日志 500 条 | 45.1 KB | 155 B | 100% |
| Git log 153 次提交 | 11.6 KB | 107 B | 99% |
| 仓库调研(子代理) | 986 KB | 62 KB | 94% |
怎么理解这些数字:场景都是「原始输出极大、而 AI 实际需要的结论极小」的形态,这正是沙盒化收益最大的场景。如果你的工作流是让 AI 反复细读同一份小文件,节省比例不会有这么夸张。README 也给了诚实的前提:hook 路由全开的平台节省约 98%,只靠规则文件提示的平台(比如 Zed、Antigravity 这种没有 hook 机制的)只有约 60%——因为模型可能不听话,直接用原生工具把 56KB 又拉进来了。
另一个值得注意的设计:它不强制模型说话简短。README 里引用了 Moonshot AI 对 kimi-k2.5 的反馈——激进的简洁指令会损伤模型的编码和推理能力——所以它的路由块只管「数据往哪走」,不管「模型怎么说话」。这个取舍我觉得是对的。
实际用起来什么样
支持的平台列表长得有点吓人:Claude Code、Codex CLI、Gemini CLI、Cursor、VS Code / JetBrains Copilot、OpenCode、KiloCode、Qwen Code、Kimi Code、Kiro、Zed、Pi、OMP(Oh My Pi)、OpenClaw 等 17 个客户端。不同平台的接入完整度不一样,拿最常用的几个说:
Claude Code(接入最完整):两条命令装好,走插件市场:
/plugin marketplace add mksglu/context-mode
/plugin install context-mode@context-mode
装完重启,跑 /context-mode:ctx-doctor 体检,所有检查项过掉就能用。SessionStart hook 会自动注入路由指令,不需要往项目里写任何文件。会话连续性(压缩后恢复状态)在这个平台是全量支持的:PreToolUse、PostToolUse、UserPromptSubmit、PreCompact、SessionStart、Stop 六个 hook 全接。
装好后你不用改任何习惯,正常让 AI 干活就行。想看效果,在对话里敲一句 ctx stats:
ctx stats
→ 本会话节省:原始输出 87.3 KB → 进入上下文 4.1 KB
→ 调用明细:ctx_execute ×12、ctx_search ×5、ctx_fetch_and_index ×2
Gemini CLI / VS Code Copilot / JetBrains Copilot:全局装一个包,往各自的配置文件里抄一段 hooks 配置,覆盖度「高」——文件编辑、git、任务、错误都追踪,但用户的口头纠正(「别用 X,用 Y」)抓不到,因为这几个平台缺 UserPromptSubmit 这类 hook。
Cursor:覆盖度「部分」。preToolUse/postToolUse 能用,但 sessionStart 目前被 Cursor 的校验器拒绝(官方论坛有报告),所以压缩后恢复状态这个功能在 Cursor 上还没有。
Zed / Antigravity:只有 MCP,没有 hook。省 60% 左右,且没有会话追踪。README 对此写得很直白。
一句话总结兼容性:Claude Code 和 OpenCode/KiloCode 是完整体验,其余平台按各自 hook 能力打折。README 里那张 17 平台 × 8 hook 的兼容矩阵是我见过开源项目里写得最老实的,每个格子都注明了为什么缺。
「让 AI 写脚本算结果」这个范式
比省 token 更有意思的是它强推的一个工作范式:LLM 应该「编程做分析」,而不是「亲自读数据算结果」。
README 的例子很直观:想知道项目里 47 个 TypeScript 文件各有多少行,传统做法是 AI 调 47 次 Read,把 700KB 文件内容拉进上下文再逐个数;context-mode 的做法是 AI 写一个脚本,脚本去遍历、数行数,最后只把 47 行结论打出来,3.6KB 进对话。一次脚本调用替代十次工具调用,这是官方说的「100x 节省」的来源。
这个范式不是 context-mode 发明的,但它做了一件别人没做的事:用 hook 强制执行。模型想偷懒直接 Bash cat 一个大文件时,PreToolUse hook 会拦截并引导它改走沙盒。光靠提示词「请你尽量写脚本」的遵从率是六成,加了 hook 是九成八——这个对比数据也是 README 自己给的。
什么情况下它帮不了你
几条实话:
小任务用不上。 十几轮就结束的对话,上下文根本不会膨胀,装它纯属增加复杂度。它收益明显的场景是长会话:大范围重构、跨多文件的调研、需要反复抓网页看文档的活。
非 hook 平台体验打折。 前面说了,Zed 这类平台只有六成节省,而且没有压缩恢复。如果你的主力工具恰好是这类,期望值要调低。
它是本地工具,不是云服务。 数据全部留在你机器上(这其实是优点),但也意味着没有团队报表这类东西——有个 hosted 的 Insight 面板,但那是对团队分析场景的补充,不是核心。
许可不是标准开源。 它用的是 ELv2(Elastic License 2.0),源码公开、可以自由使用,但不允许把它作为托管服务转售。个人和团队内部使用完全没问题,想二开商业化的团队要留意这条。
项目还很年轻。 2026 年 2 月建仓,issue 区有 295 个开放 issue——对一个日增上百星的项目来说正常,但也说明边界情况还不少。它上了 Hacker News 首位(570+ 分),热度带来的 bug 报告还在消化中。
和 mcp2cli 那类「砍工具定义」的项目是什么关系
五月份我写过 mcp2cli,那个项目的思路是把 MCP 工具的定义从上下文里挪出去、按需查询,省的是「工具清单」那一侧的 token。context-mode 管的是另一头——工具执行结果的输出侧。两个不冲突,一个管入口一个管出口,理论上可以同时装。如果你的痛点是「装了太多 MCP server 每轮都带着几十个工具定义」,看 mcp2cli 那篇;如果痛点是「AI 调工具一调一个大输出,会话半小时就满」,用这个。
写在最后
context-mode 解决的问题每个 AI 编程用户都遇到过,只是多数人把它当成了「模型不行」或者「工具太吵」,没意识到这是可以工程化拦截的。它把「工具输出不进上下文」这件事做成了跨 17 个平台的基础设施,光是这个覆盖面就值得点个收藏。
建议的尝鲜路径:如果你日常用 Claude Code,五分钟装上,跑一个平时要半小时的长任务,结束前敲 ctx stats 看一眼节省量,再故意把对话压到触发压缩,看它能不能把「改到哪了」找回来——这两个体感比任何基准数字都有说服力。
项目地址:github.com/mksglu/context-mode(GitHub 搜索 context-mode 即可找到,npm 包同名)
有什么想法可以随时留言沟通。
喜欢就先收藏,万一找不到了呢!⭐