ARTICLE · 1127331
AI 助手记得住事,却学不会东西,这个 4.5 万星项目专治后半句
大家好,我是左手。
前两天我翻出自己维护了半年的一个 CLAUDE.md,第一行写着「本项目使用 Python 3.12」。
我盯着这行字看了两秒,才想起来这仓库三周前就迁到 3.13 了。。。
那份文件我当初是一字一句斟酌的,写得挺好。问题是它得靠人续命。人一忙,它就烂在那儿,而且烂得毫无声响。
这事本来也不算什么。直到我意识到,我们现在给 Agent 加「记忆」,绝大多数人做的就是这份 CLAUDE.md 的加强版。你往里存了很多东西,但你存的都是「当时发生了什么」。没有任何一个地方,能回答「现在我认为什么」。
这俩问题差一个词,中间差着一整层东西。
今天要聊的这个项目,是我今年看到的、把「记忆」这两个字解释得最认真的一次。
它叫 Hindsight,vectorize.io 出品的开源 Agent 记忆层。GitHub 上 45,231 星,5,901 个 fork,MIT 协议,Python 写的,最新版本 v0.10.2 是 9 月 29 号发的。
它自述里有句话,我读完坐直了。
Most agent memory systems focus on recalling conversation history. Hindsight is focused on making agents that learn, not just remember.
大部分记忆系统忙着回忆聊天记录,它想让 Agent 学会东西。
记住和学会,差的就是开头那份 CLAUDE.md 的命门。
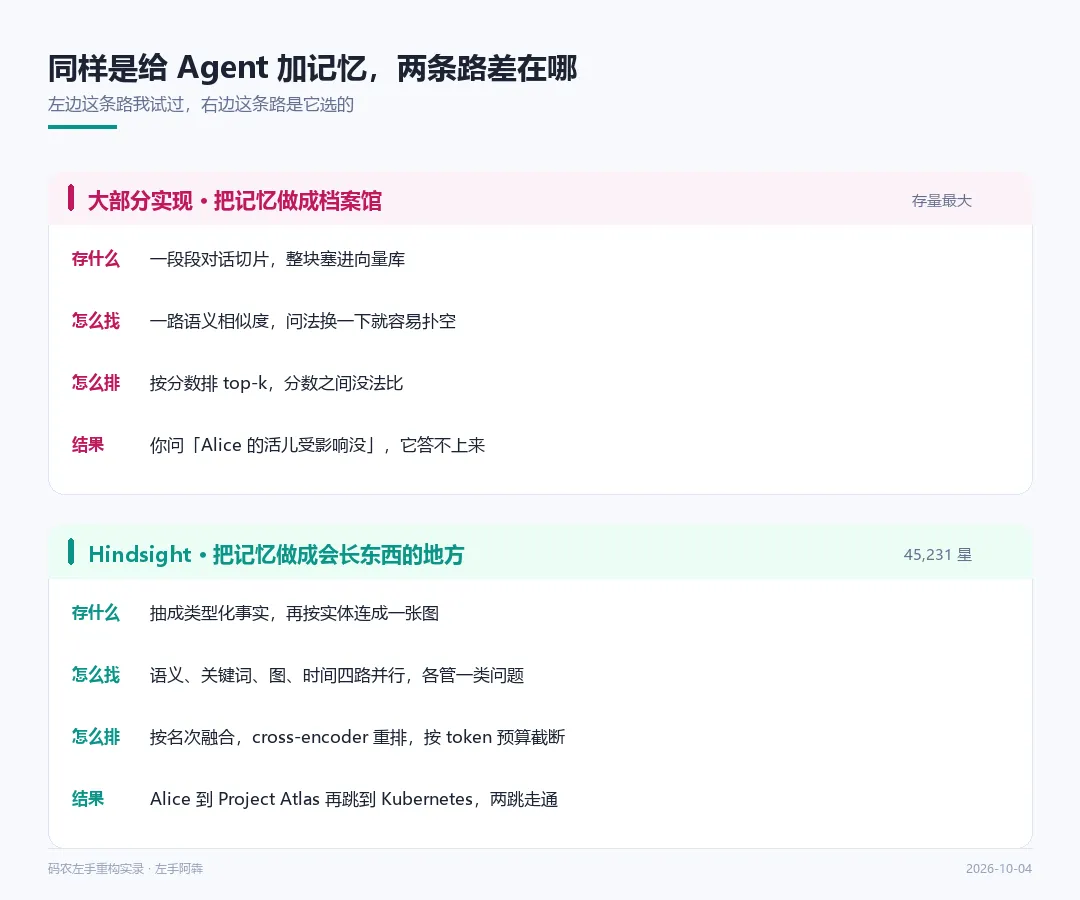 左边这条路我踩过,右边这条路是它选的
它做的第一件反常识的事,是不存对话
官方 README 里有句我认为是全篇题眼的话。
Hindsight does not store conversations.
它不存对话。
第一次看到我有点懵。
一个做记忆的系统,卖点是它不存东西???
翻完文档才明白它在干嘛。你丢进去一段对话,它不把那块文本留着,而是拿 LLM 把它拆成类型化的事实,然后往上长。
拆成四类。
一类是「世界事实」,客观陈述,别人告诉它的。比如你说 Alice 在 Google 工作,这是一条世界事实。
一类是「亲身经历」,记忆库自己干过的事。它给 Bob 推荐过 Python,这条也是记忆,但它记的是自己做过什么,不是世界的真相。
第三类叫「观察」,这类最有意思。它不是从某一次对话里来的,是从很多条事实里熬出来的。比如同一个人前三个月一直在问 React,这个月开始问 Vue,后台会把这两堆事实合成一条信念,这位用户原来是 React 派,现在转 Vue 了。而且每条观察都挂着支持它的原始证据。
第四类叫「心智模型」,这个是你出的题,它自己写答案。你定义一个问题「这个用户的技术偏好是什么」,它自己维护这份答案,后台随着新信息不断重写。读它的成本是一次数据库读,不走检索,不调模型。
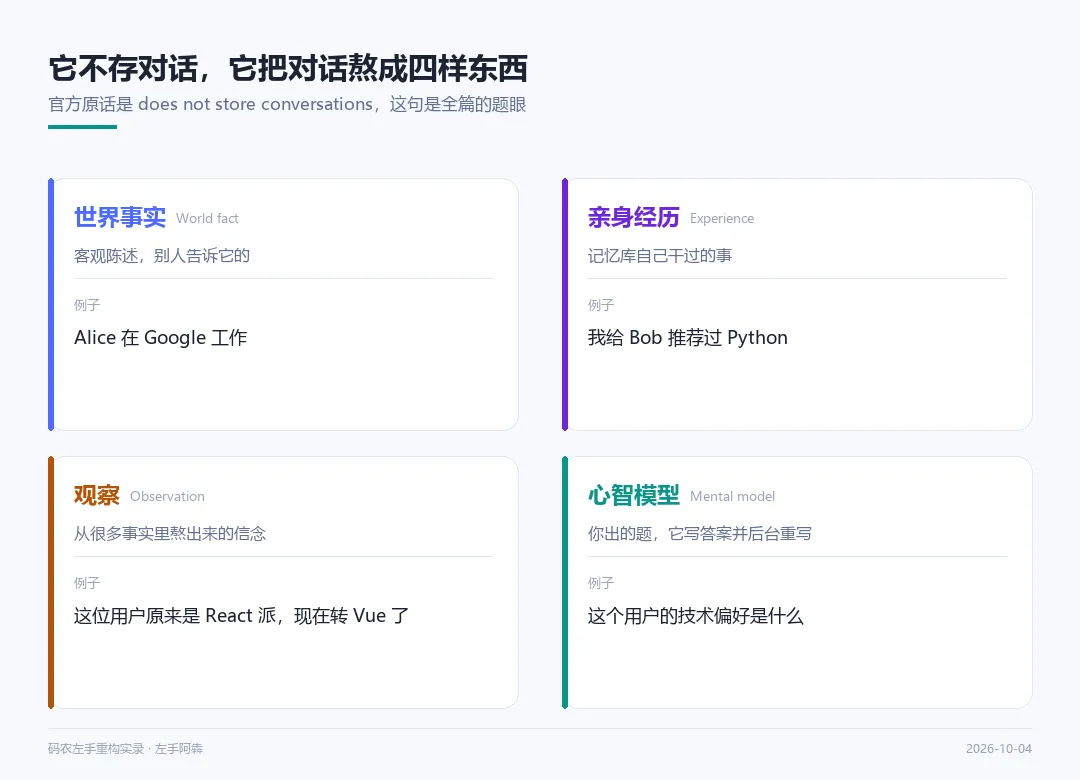 四类记忆,最后一类读起来不用调模型,这一点对延迟敏感的场景很要命
看到这四层的时候我想起一件事。
我们平时说的「AI 记忆」,其实混了两件完全不同的活儿。一件是档案馆,负责低成本调出「你之前说过什么」。另一件是脑子,负责维护「我现在认为什么」。
档案馆不需要理解,只要索引做得好。脑子需要下判断,还需要能改主意。
大部分产品把这两件事一起塞进了向量库,然后指望它俩都干。
三个动作,四路并行
跟外面打交道的只有三个动作,官方管它们叫 retain、recall、reflect。
retain 是你丢东西进去,recall 是你往外找,reflect 是让它想。
听着平平无奇。有意思的是每个动作里面塞了什么。
先说 recall,因为这一路最能看出这个项目的脾气。你想想看,一个做记忆的系统,脾气全花在「怎么找」上了。
你发一句查询过去,它不会只做一次向量检索。它同时跑四路。
语义那一路走意思,所以「Alice 的活儿」能找到「Alice 是软件工程师」这种字面不重合的。关键词那一路走 BM25,专门捞那些被 embedding 揉成一团的名字和技术名词。图那一路走实体跳转,一条事实只要两跳之内能够到,哪怕跟查询一个字都不重合也能捞回来。时间那一路把「去年春天」这种说法解析成区间,然后按相关性填,还要铺开在整段区间上,不然问 2023 年发生了什么,回来的全是 12 月的事。
四路跑完,合并的方式是重点。
它不按分数合并,按名次合并,用的是 reciprocal rank fusion。原因很实在,四路的分数尺度根本不可比,按分数加和等于让某一路的尺度把其它三路吃掉。按名次就不会,而且一个记忆如果被好几路同时选中,它会赢。
融合完再交给 cross-encoder 重排,最后一步是把结果按 token 预算截断。
注意,是按预算截,不是按 top-k 截。
官方那句原话我抄下来了,一字没改,agents budget in tokens and not in result counts。Agent 的上下文是按 token 算账的,你给它固定 10 条,可能 3 条就把窗口撑爆了。你告诉它你还有多少 token,它自己填满,这个设计我觉得比 top-k 诚实得多。
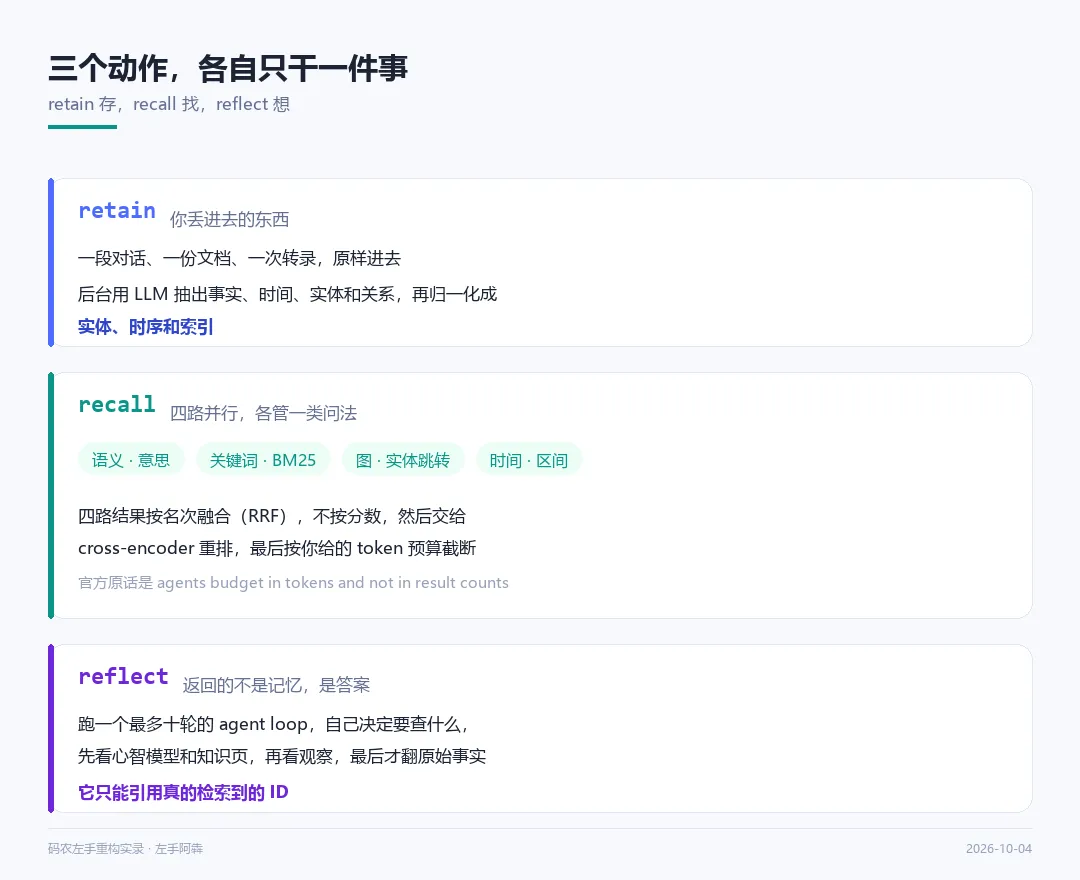 三个动作里,recall 的四路并行和按名次融合是它最硬的工程细节
一个记忆层,凭什么拖个数据库进来
翻代码之前我一直觉得这是个偷懒的选择。翻完发现不是。
四路分散在四个系统里也能跑,代价是四次网络往返,回来还得对齐一遍。它选的是把四路塞进同一个查询计划。
向量那一路用 <=> 算余弦距离,关键词那一路用 Postgres 原生的 ts_rank_cd 配 search_vector 列,图那一路是一段带 CROSS JOIN LATERAL 的 CTE,时间那一路按列过滤。向量和 BM25 甚至本来就是一条 SQL,UNION ALL 拼起来一次发出去。
图那段的实现里有句注释我印象很深,大意是过滤必须压在限量之前执行,别的类型或者不在时间窗口里的候选,不能占用这个实体的扇出配额。这句话只有在过滤和限量同属一个查询计划的时候才写得出来,拆到应用层就得自己写循环维护。
所以它绑的其实不是 Postgres 这个名字,是「一个能同时做向量排序、全文排序、关系跳转和事务写入的通用引擎」。别的后端它也接了 Oracle,换个配置的事。
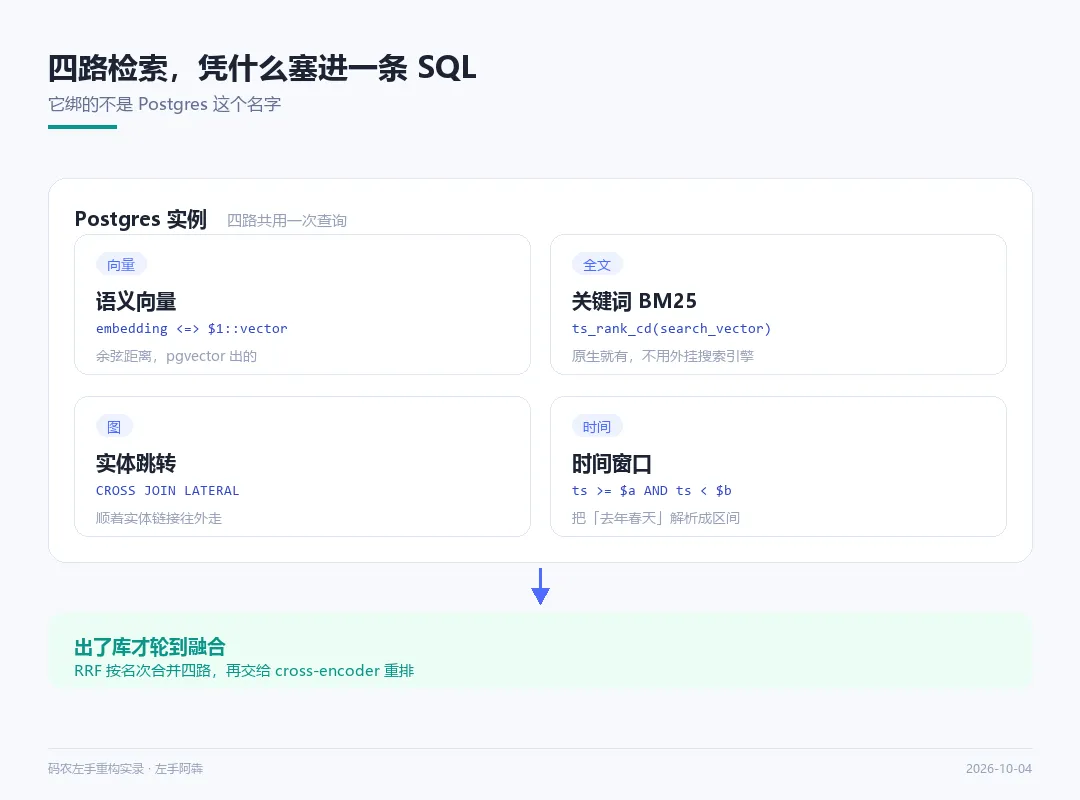 四路各用一种数据库能力,出库之后才轮到融合
那用户为什么要为它多装一个数据库。这个问题它自己回答了。它支持一个 pg0:// 的地址写法,起服务的时候自己在你机器上拉起一个 Postgres 18.1 实例,二进制扔在用户目录下。这一句「一定要用 PG」落到使用者身上,变成了什么都不用做。
我把它跑起来了
官方给了三条路,Docker、pip、还有 Kubernetes。我走的 pip,就一条命令 pip install hindsight-all。
装之前我把依赖树拉出来数了一眼,两百多个包。torch 一个就一百多兆,还有 onnxruntime、transformers、sentence-transformers,加上内置的 Postgres 二进制和 claude-agent-sdk。它不是个薄薄的 API 壳子,嵌入模型、重排模型、整个数据库全在你自己的机器上,装完不用 Docker,也不用申请向量库账号。
然后是第一个坑。装完启动要往 HuggingFace 拉两个模型,嵌入的 bge-small-en-v1.5 和重排的 ms-marco-MiniLM,国内直连不通,得先挂镜像。它的快速开始里没写这件事,第一次跑的人会看到一串下载超时,然后以为是自己装坏了。
第二个坑我更想说。它文档里有个 provider 叫 claude-code,不用 API key,直接借本机 Claude Code 的登录态,等于说手上一个模型凭证都没有,也能把整套东西跑起来。
结果没跑起来。它明确拒绝执行 claude.CMD。理由写得特别硬,Windows 跑 .bat 和 .cmd 必须经过 cmd.exe,而 cmd.exe 的参数没法可靠转义,等于给命令注入开了个口子,所以它只认原生的 claude.exe。这个判断挺少见,宁可少认一个平台,也不肯在转义上赌一把。
行,那我退一步,用一个不需要模型的模式先把链路跑通,官方管这个叫 provider=none。
服务三十点七秒起来了,四个探针打下去全是 200,其中一个 /mcp/lefthand-demo/ 就是它自称的一库一 MCP 端点。我上个月还在想这种设计会不会有人真做,它是真做了。
我往那个库里塞了五条事实,故意设计成需要多跳才能回答的那一种。
client.retain(bank_id="lefthand-demo", content="Alice 在 2026 年 3 月加入了 Google,她在研究团队。", timestamp="2026-03-10T09:00:00Z") client.retain(bank_id="lefthand-demo", content="Alice 是 Project Atlas 的技术负责人。", timestamp="2026-03-12T09:00:00Z") client.retain(bank_id="lefthand-demo", content="Project Atlas 跑在 Kubernetes 上。", timestamp="2026-04-02T09:00:00Z") client.retain(bank_id="lefthand-demo", content="Kubernetes 集群上周二出了一次故障。", timestamp="2026-06-18T09:00:00Z") client.retain(bank_id="lefthand-demo", content="Alice 最近在研究团队里主要负责性能优化。", timestamp="2026-09-20T09:00:00Z") |
五条都进去了,第一条 1.1 秒,后面每条 0.4 到 0.5 秒。写完我查了三次,其中一次的内部日志原样抄下来了,我觉得这段比结果本身好看。
[2] Parallel retrieval (3 fact_types): semantic=5(0.000s), bm25=3(0.000s), graph=0(0.000s), temporal_extraction=0.091s [3] RRF merge: 5 unique candidates in 0.002s [4] Reranking [cross-encoder]: 5 candidates scored in 0.029s [4.6] Combined scoring: ce * recency_boost(0.2) * temporal_boost(0.2) [5] Truncated to top 5 results [6] Token filtering: 5 results, 57/4096 tokens in 0.000s |
这段日志里有个细节我在文档里没见过。最后一步叫 combined scoring,实现是 cross-encoder 的分数,乘一个新鲜度系数,再乘一个时间系数,两个都是 0.2。也就是说重排完之后它还要再压一次时间,文档只说了按 token 预算截断,没说中间还有这一层。另外三次查询端到端 0.198 秒、0.143 秒、0.059 秒,全在本地 CPU 上跑,固定开销是几十毫秒量级。
reflect 我本来没抱希望,结果它回了个 400,理由直白得可爱。
Reflect requires an LLM provider. Current provider is set to 'none'. Set HINDSIGHT_API_LLM_PROVIDER to a real provider. |
它没假装成功,也没塞个空对象给我,直接告诉你这一层省不了钱。
行吧。我去搞了个 key,把漏掉的那三件事补齐了。下面这段全部是拿真模型跑出来的,一步没省。
换成真模型之后
Hindsight 里 deepseek 是一等公民,base_url 都内置好了。我选的模型是 deepseek-flash,在 DeepSeek 那边的显示名是 V4.1 Flash。同一个 key 覆盖 retain、consolidation、reflect 三个角色,没有第二个凭证要配。
顺便说一句,我一开始把名字写成 v4-flash,它照收不误,回包里的 model 字段却归一成 deepseek-flash。同一个后端挂两个名字,光看返回看不出来。
服务这次八点九秒就起来了,比上一轮还快。原因不神秘,两个模型都在本地缓存里躺着,不用再去核对远端。
动手前我打了个探针。那个端点默认是关的,得先开。它把三个角色各打一次真实调用,返回 retain、consolidation、reflect 三行,全是 connected,一次八百九十五毫秒。手上有一堆 key 不知道哪个能用的时候,这个探针能省半小时。
然后是重头戏。同样那五条事实,我重新灌了一遍。
这回每条两到四秒,比上一轮慢了五六倍。慢得合理,上一轮它压根没读懂我写了什么,只是把文本切块存下来,这次它真的在读。
代价也有数字。一条二十二个字的记忆,写入花掉三千二百个输入 token,其中绝大部分是它的抽取提示词,跟你写了多少字关系不大。写入成本是固定开销型的,存一条和存十条,摊下来差别很大。
抽出来的东西确实比我预期多。五条原始事实躺在 world 这一类里,另外自己冒出来四条 observation,就是前面说的那种观察。这部分我没手动触发任何东西,写进去它自己就开始熬了。
实体抽了七个,Alice、研究团队、Kubernetes、Project Atlas、性能优化、集群、Google。中文实体是原样留着的,没有转拼音。
链接一共三十条,语义十五、时间十、实体五。
观察那四条里有一条我想单独拎出来。它的正文是「Alice 于 2026 年 3 月加入 Google,在研究团队工作,主要负责性能优化」,底下挂着两个编号,分别对应「Alice 于 2026 年 3 月加入 Google,在研究团队工作」和「Alice 最近在研究团队里主要负责性能优化」这两条原始事实。
两条独立的世界事实,被熬成了一条新陈述,而且证据链上挂着编号,顺着能爬回原文。它不是我写进去的,是后台自己长出来的。
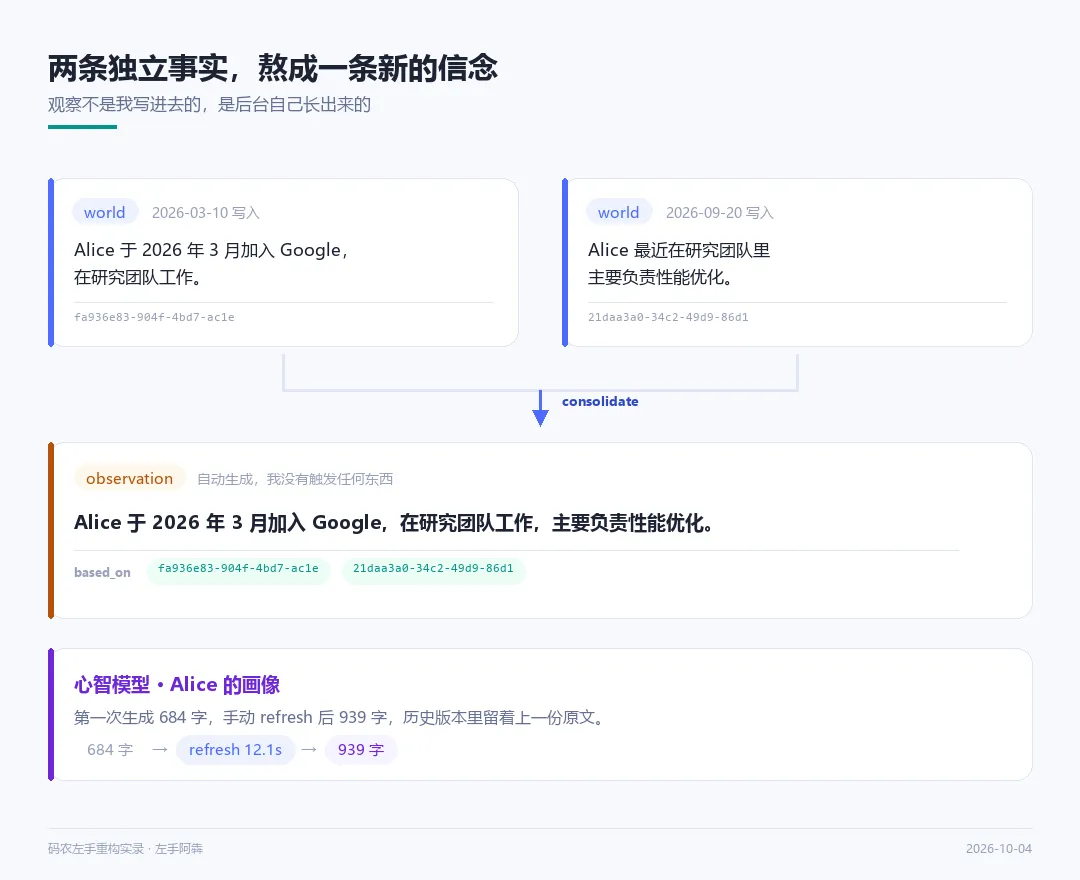 这条观察的正文我一个字没写,那两个编号也是它自己挂的
心智模型那个更有意思。我给它出的题是「关于 Alice 这个人,结合她在研究团队的角色和项目经历,我该知道些什么」。十点一秒之后它交卷,六百八十四字,带小标题,分了基本信息、当前职责、项目经历,还有一节专门讲那次集群故障。
然后它自己加了一节,叫「需要注意的不确定性」。里面写的是,现有记忆没有记录 Alice 从 Project Atlas 技术负责人这个角色是否发生变化,也没有把性能优化这个职责和 Project Atlas 明确关联起来,所以这两项角色是并存还是接替,数据无法确定。
我盯着这段看了挺久。这是它自己给自己划的边界,没人要求它写。
我又手动 refresh 了一次。十二点一秒,内容从六百八十四字长到九百三十九字,历史版本里留着前一份原文,你要比对它改了什么,直接看就行。
最后是 reflect。十二点二秒,输入一万七千八百九十八个 token,输出一千七百三十个。
它的回答里有张表,有条时间线,最后是一节「给她安排活儿时的注意事项」。最让我意外的是第四条,标题写着「信息空白较大,别做补白」,它明说记忆库里没有她加入 Google 之前的经历、技能栈、教育背景,所以无法推断她擅长什么,这些空白得直接问本人,而不是从既有记录推演。一个记忆系统主动告诉你它不知道什么,这比它多说两句有用得多。
它还有一层新鲜度处理挺妙。有些记忆落库了但后台还没熬成观察,这时候 reflect 会把受影响的观察标成过期,信它之前回去跟原始事实对一遍。不信任未整理的中间态,这个自觉很少见。
顺便说一句它在「修改」上的克制,也是我实测才看明白的。新证据进来,它不会把旧的那条覆盖掉,而是更新它,并且把更新历史留着。你在 Agent 里跑生产,最怕的不是它记错,是它记错了还查不出来。
收尾时我看了眼用量。整个过程二十四次模型调用,十万五千八百九十六个 token,其中七万多个命中了缓存。
那个 graph=0,我一开始想错了
回头看上一轮日志里的 graph=0,我当时的解释是没有 LLM 就抽不出实体,图是空的。
这个解释错了。换成真模型之后,四路并行的日志变成语义 9 条、关键词 5 条、graph 还是 0。实体有了,链接三十条也有了,它照样是 0。
说实话我不甘心,做了三件事。
先把库里的向量捞出来直接算。我自己也写了个脚本,加载同一个嵌入模型,拿查询和九条记忆逐条算余弦相似度,最低 0.74 最高 0.90,九条全部远高于 0.3 那个种子阈值。种子不缺。
再绕开这个可能性,用一个能改阈值的接口把语义下限抬到 0.9,等于逼图那一路自己去捞种子,不再复用语义的结果。跑完还是 0。
最后去读代码。图那一路的扩展 SQL 里有一句,mu.id != ALL($1::uuid[]),种子本身不在扩展结果里。
这一句加上我们那个库的规模,答案就出来了。库里一共九条记忆,种子阈值一划,九条全在种子里,而图那一路要干的事是从种子顺着链接走到别的节点,它偏偏把种子排除在外。九条全是种子,那就一个节点都走不到。
所以它不是坏了,是这个库太小,小到图那一路没有活可干。
反正这个结论对想自己试的人有用。你拿三五条记忆去测它,永远看不到那一路干活,然后你会以为那条路是假的。前面官方那个 Alice 三跳的例子走的正是这一路,想看它真跑起来,先喂够数据,让种子集合变成整个库的真子集。
坑我集中列一下,你要是也打算试。
路径别带中文,我在中文目录里建环境,pip 装到一半就崩在文件改名上,换到纯英文路径立刻就好了。前面那两个坑我就不重复了。
内置 Postgres 第一次初始化我遇到过一次失败,重来一次就过了。
还有个坑很不明显。这个 SDK 的默认模型是给 groq 准备的,你只换 provider 不换模型名,它就把那个名字原样发给新家,报出来的错还沾着模型名,很容易让你去怀疑 key。
最后一条最要紧。想看到完整的 Hindsight,你必须有真能调的模型。它不是装完自带魔法,它是个要烧燃料的系统,燃料就是 LLM 调用。我这一轮二十四次调用烧掉十万 token,小样本在本地玩一天没问题,真要往生产里灌,这是笔得提前算的账。
跟 RAG 比,差在哪
官方专门写了一页 RAG vs Memory,我摘三个例子,都是日常最容易翻车的场景。
存进去三条事实。Alice 是 Project Atlas 的技术负责人。Project Atlas 用了 Kubernetes。Kubernetes 集群周二挂了。现在问,Alice 受影响了吗。
RAG 会把带 Alice 的那条捞出来,然后发现它跟「受影响」没有语义相似度,交白卷。Hindsight 走 Alice 到 Project Atlas 到 Kubernetes 再到故障,三跳走通。
再比如问「Alice 去年春天做了什么」。RAG 会把 Alice 的所有事实不分时间全给你,Hindsight 把「去年春天」解析成时段再过滤。
还有一个我最喜欢,叫知识演进。第一周用户在异步 Python 上吃瘪,用线程跑通了。第三周他开始问 asyncio,并且真的写了异步的数据库调用。RAG 对此毫无感知,Hindsight 会把它原来那句「用户偏好同步」改写成「用户正在适应异步」。
这三个例子看下来,RAG 和记忆层的分界线不在于检索精度,而在于一个问题。
你存的是证据,还是结论。
它的分数,和分数怎么看
benchmark 这块我想多说一句,因为这行数字水分太大。
官方公布的最新数字,LongMemEval-S 拿到 94.6%,次好的系统 74.0%。LoComo 92.0% 对 80.3%。BEAM 那个 1000 万 token 的长上下文任务,64.1% 对 40.6%。
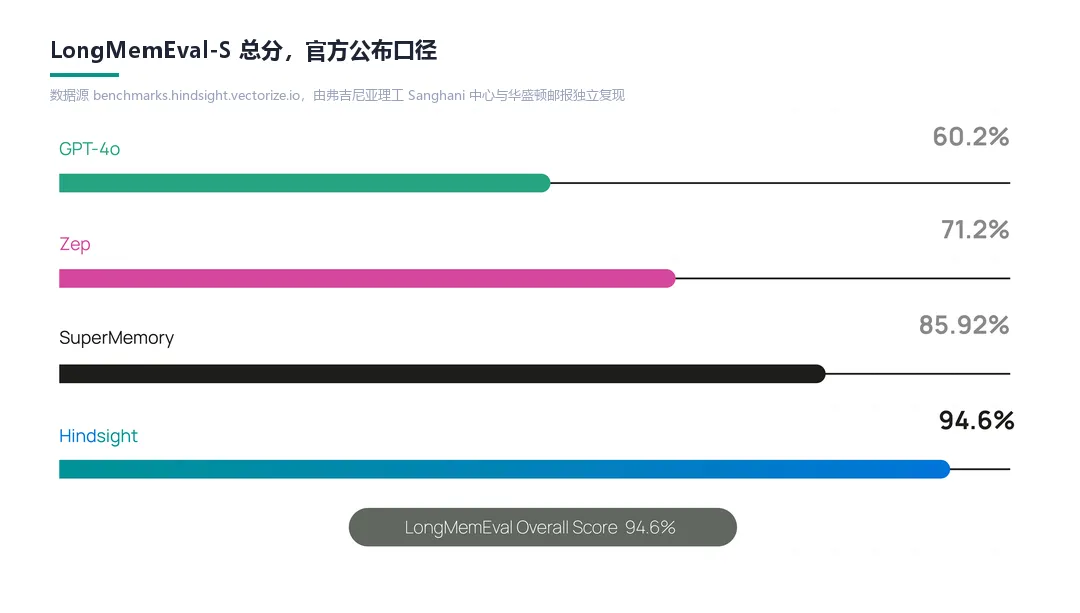 官方图里的四个点,GPT-4o 60.2%,Zep 71.2%,SuperMemory 85.92%,Hindsight 94.6%
但真正让我觉得他们还算诚实的是另一句注解。官方写明,它自己的数字由弗吉尼亚理工的 Sanghani 人工智能与数据分析中心和华盛顿邮报独立复现过,其他家的是厂商自报。一边是第三方复现,一边是自测自报,并排看等于拿苹果比橘子。所以这个 94.6% 可以信它挂在第一梯队,但别当成「比某某高 20 个点」的依据。
arxiv 上还有一篇论文,编号 2512.12818。里面有个数字我更愿意引用。同一个开源 20B 底座,把全上下文基线换成 Hindsight 之后,LongMemEval 和 LoCoMo 的综合准确率从 39% 提到 83.6%,而且超过了全上下文的 GPT-4o。
39 到 83.6 这个跨度,比 94.6 更能说明它在干嘛。它说明的不是「我检索得准」,而是「光有全上下文也没用,得有结构」。
说到这我想起上个月那篇 Jev
9 月 21 号,Hindsight 0.10.1 的更新里加了一个新的重排器,叫 Jev。这个号半个月前刚写过它,就是那个一个字都不生成、只回你「选了哪个」和「有多大把握」的模型,来自 typesafe.ai。
当时我从它的字段定义里推了一个判断出来,绝对打分比相对选择难,因为「0.6 分」到底是什么意思,模型每次都得重新回答一遍。半个月后,有人用 200 道题和两个失败设计,把我那个判断验证了。
做重排最自然的选择是拿每个候选问一遍「这条相关吗」,按概率排。他们也是这么做的,然后停下来了,因为这个做法还是逐一比较,三百个候选就是三百次互不知情的判断。他们改成把整个池子当成选项交给它,一次请求,回来的概率本身就是排序。
同一个模型上两种做法对打,listwise 的 recall@1 是 0.94,逐条问是 0.87,调用次数只有后者的三十分之一。
然后是那两个失败的。第一个,他们想在选项里加一个「以上都不是」,模型选它就代表没一条相关,结果 200 道题里有 35 道空手而归。原因是选项之间是竞争关系不是刻度关系,「以上都不是」压根不在跟候选比相关性,它只在题目难的时候直接赢。
第二个更小也更典型。他们改用打分做截断之后,又在刻度里加了一档「都不相关」,结果 7% 的查询返回空,gold 留存率从 0.81 掉到 0.65。同一件事上,他们给了模型两次「干净地说什么都没有」的机会,两次都用过头了。
半个月前我只是从字段定义里推出「类型化比自由文本好」,现在一个 4.5 万星的项目把 Jev 收成了零件,还把踩过的坑连着数字写出来了。我当时盯着那张表看了好一会儿,脑子里就剩一个词,好家伙。
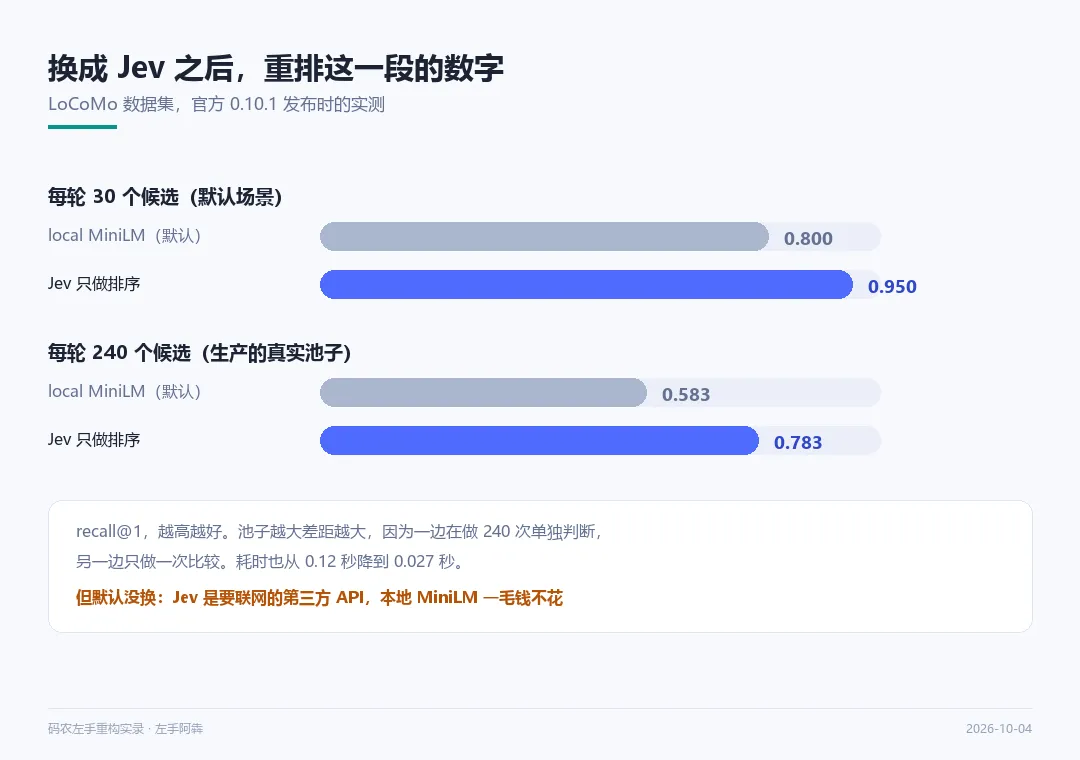 顺带一提,他们最后没把默认换成 Jev,因为 Jev 是要联网的第三方接口
对你最有用的一节,给 coding agent 装记忆
说了这么多架构,如果你跟我一样主要拿 coding agent 干活,真正能马上用上的其实是这一段。
Hindsight 出了个专门的包,一条命令给本机的 CLI coding agent 接上长期记忆。
npx @vectorize-io/hindsight-coding-agents install all
它做的事是给每个仓库建一个独立的记忆库,从 git 历史和过往会话里自动长出来,然后在 Agent 开工的时候注入进去,再配一套自动维护的知识页,盖住架构、约定和当前在做的事。
官方的原话说接入是自动的,没有单独的 setup 命令。支持的 Agent 名单我数了一下,十三个,Claude Code、Codex CLI、Cursor CLI、GitHub Copilot CLI、opencode、Kilo、Cline、Antigravity、Devin、pi、Prime Agent、Grok Build,还有 DeepSeek Harness。
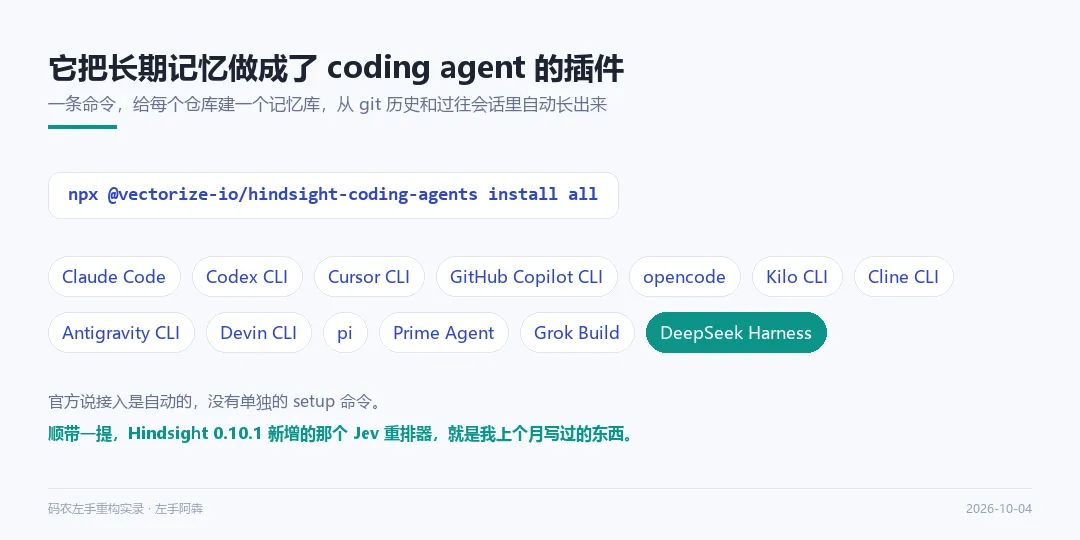 名单里那个 DeepSeek Harness,本号的老读者应该眼熟
另外它每个服务自带一个 MCP 端点,一个记忆库一个,地址就是 localhost:8888/mcp/你的库名。你拿任意 MCP 客户端指过去,retain、recall、reflect 就变成三个工具。
说到这我想插一句。它还有个细节挺对味,官方文档专门写了一节叫多语言。它会把输入语言检测出来并且一路保留,事实留在原语言,实体保留原字形,张伟就是张伟,不会变成 Zhang Wei。
做过中文知识库的人都懂这坑多烦。默认把中文实体转拼音再进图谱,检索效果能掉一大截。愿意为这件事单独写一节文档,说明是真在中文场景踩过。
那它不适合谁
夸了这么多,说点要泼冷水的。
第一,它需要一个大模型来干活,而且不只是查询要,写入也要。每一次 retain 都要走一次 LLM 做事实抽取,也就是说写入是有成本的,不是白存。我实测一条二十二个字的记忆,写入要三千二百个 token 加两秒钟。海量日志往里灌的场景,先算算账。
第二,它要 Postgres 加 pgvector。三条路,云端托管、嵌入式本地跑、或者接你自己的集群。嵌入式那条就是前面说的 pip install hindsight-all,我这次走的就是它。但规模化还是得有正经数据库。企业版也支持 Oracle,对已经在用 Oracle 的团队是加分项。
第三,重排默认还是本地的 MiniLM,不联网不花钱,分数就是前面表里的 0.800。换 Jev 好得多,但那是第三方接口,记忆内容要出你的机器。官方自己在博客里写得很直白,如果你自建的理由就是记忆不能出内网,那这个选项无论 benchmark 多好看都不成立。
第四,有一说一,这是我觉得最要紧的一条。官方在 claude-code 的文档里明确写了,它是给个人本地开发用的,不要用在生产或者共享环境,因为它借的是你个人的订阅凭证,条款可能变。
第五,官方自己承认,如果你只是搭个 n8n 那种简单工作流,用它可能是过重的。
最后
回到开头那份 CLAUDE.md。
我这两天算是想清楚了一件事。它之所以会烂掉,不是因为我懒,是因为方向从一开始就错了。手册这种东西天生滞后于现实,你写下来的那一刻它就旧了。而记忆不是手册,记忆是一堆事实自己长出来。
Hindsight 这个名字我觉得起得很准,事后才看得清楚。但它做的事恰恰不是事后,它是让一个 Agent 在每一次对话之后,都比上一次多知道一点,而且知道自己上次错在哪。
它现在已经 4.5 万星了,五天前刚发 v0.10.2。官方自己说,前两万星花了十个月,后两万星只花了 45 天。
一个还在快速长的开源项目肯定有糙的地方,我这次跑也踩到几个坑,前面都写了。但把「记忆」拆成事实、观察、心智模型这三层,并且坚持每条结论都挂着证据,我觉得是目前这个方向上做得最清楚的一份答卷。
值得试。
我是左手,我们下篇见。
参考链接
Hindsight 仓库 https://github.com/vectorize-io/hindsight
官方文档 https://hindsight.vectorize.io/
benchmark 榜 https://benchmarks.hindsight.vectorize.io/
论文 https://arxiv.org/abs/2512.12818
Jev 作为重排器的实测复盘
https://hindsight.vectorize.io/blog/2026/09/24/adding-jev-reranker-what-we-learned