ARTICLE · 1133974
多张A4纸图片如何生成一个PDF文件?| 一起来看
多张A4纸图片如何生成一个PDF文件?| 一起来看这个问题我们丢到DS中看有什么答案: 方案一:PS自带能力 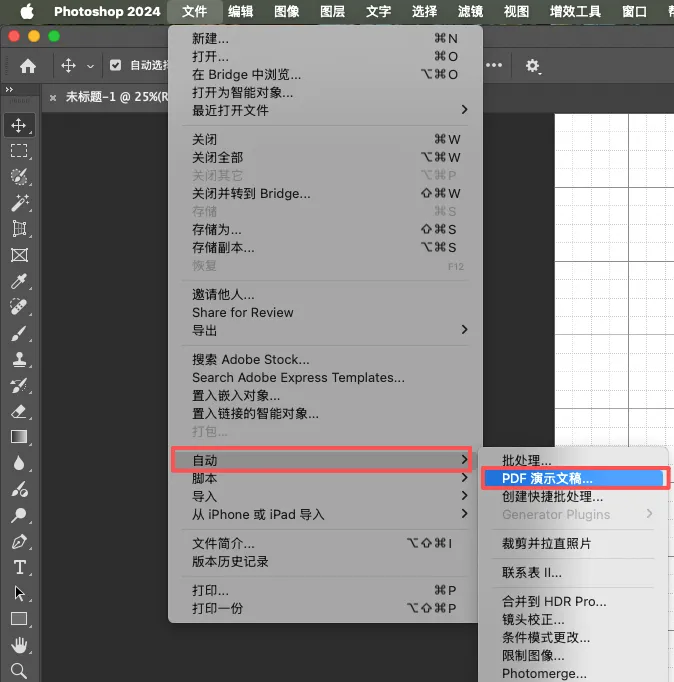
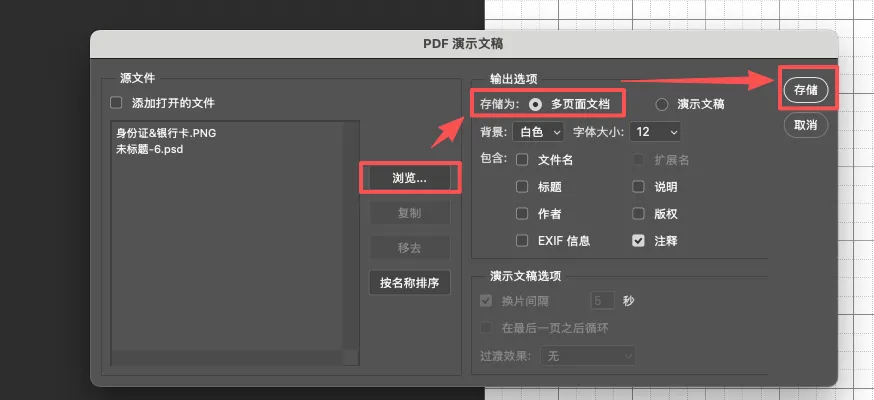
你还有哪些可用的好方法,评论区一起交流。
最简单、最推荐用 Photoshop 自带的 “PDF 演示文稿” 功能,把多张图合成一个多页 PDF。关键是:输出时选 “多页文档”,不要选“演示文稿”。
在弹出的PDF演示文稿面板中选择浏览,添加你所需写入到PDF中的图片即可。然后依次选择多页面文档和存储即可。
那么成本就是电脑需要安装一个PS软件。
注意
不要直接“文件 > 存储为 PDF”,那只会把当前一张图保存成单页 PDF。
如果生成后页面大小不是 A4,通常是图片分辨率不对。A4 在 300 dpi 下必须是 2480 × 3508 像素,并且分辨率标记为 300 dpi。
如果图片尺寸不统一,先回 PS 里统一成 A4 画布,再合并,否则 PDF 页面会大小不一。
那么在没有这个软件的时候,替代方案又有哪些呢?
方案二:系统自带转换能力
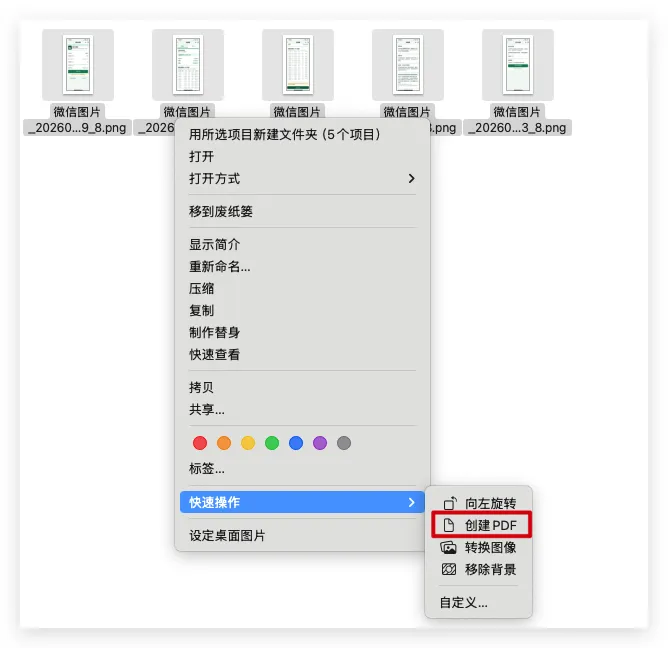
照片合理命名和排序后,选中所有照片,在MacOS中右键的快速操作就有创建PDF选项:
点击后就会在当前目录下快速生成一个PDF文件。
方案三:利用Typora的导出能力
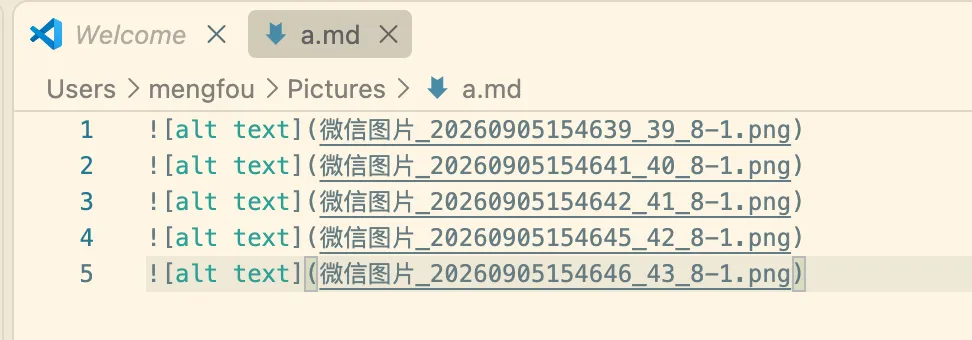
安装Typora,然后粘贴图片进去即可,比如我的markdown文件中为:
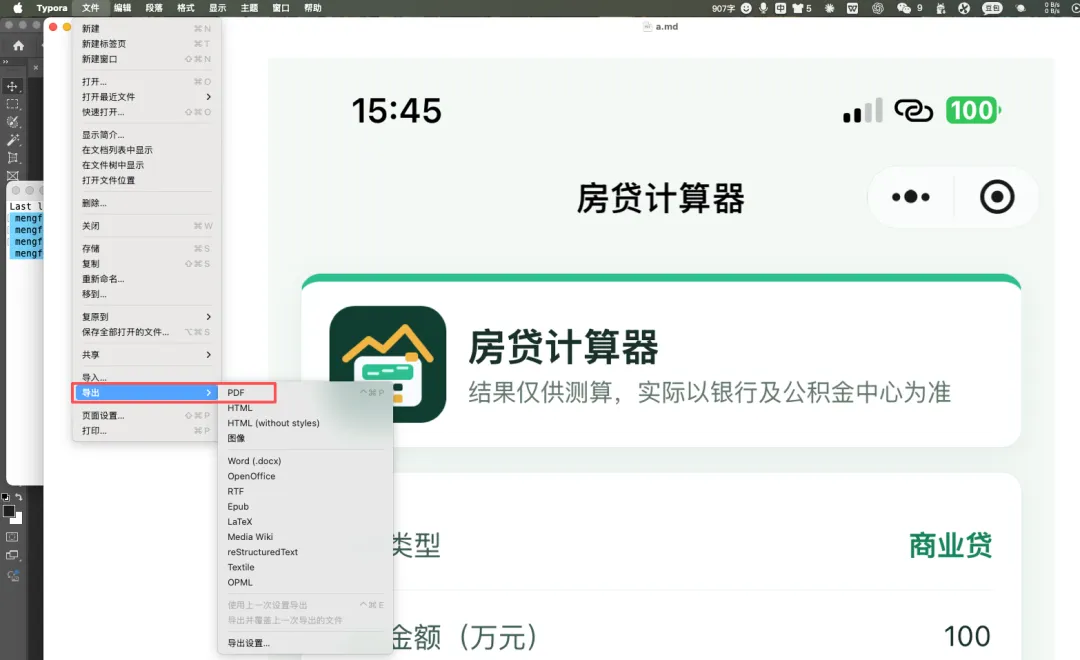
一共添加了五张图片。编辑好这个文本文件后,使用typora软件打开,然后选择导出-PDF:
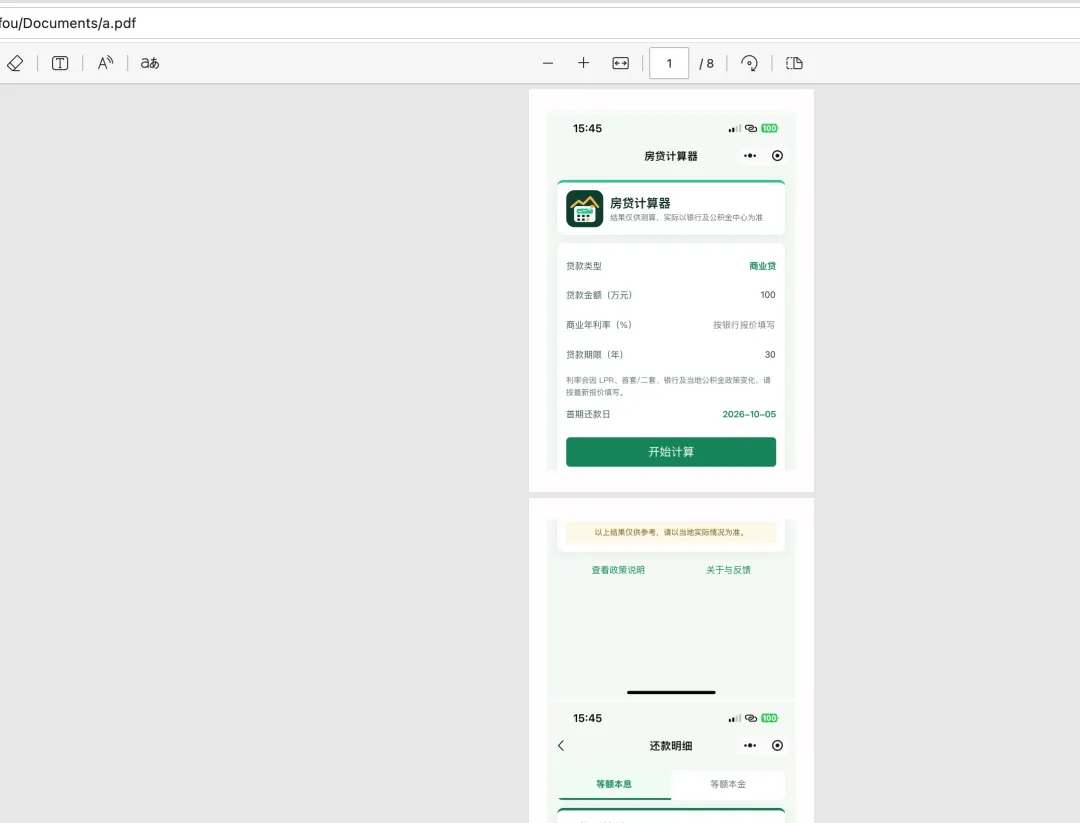
但这样导出的会有问题,A4图片会截断,比如:
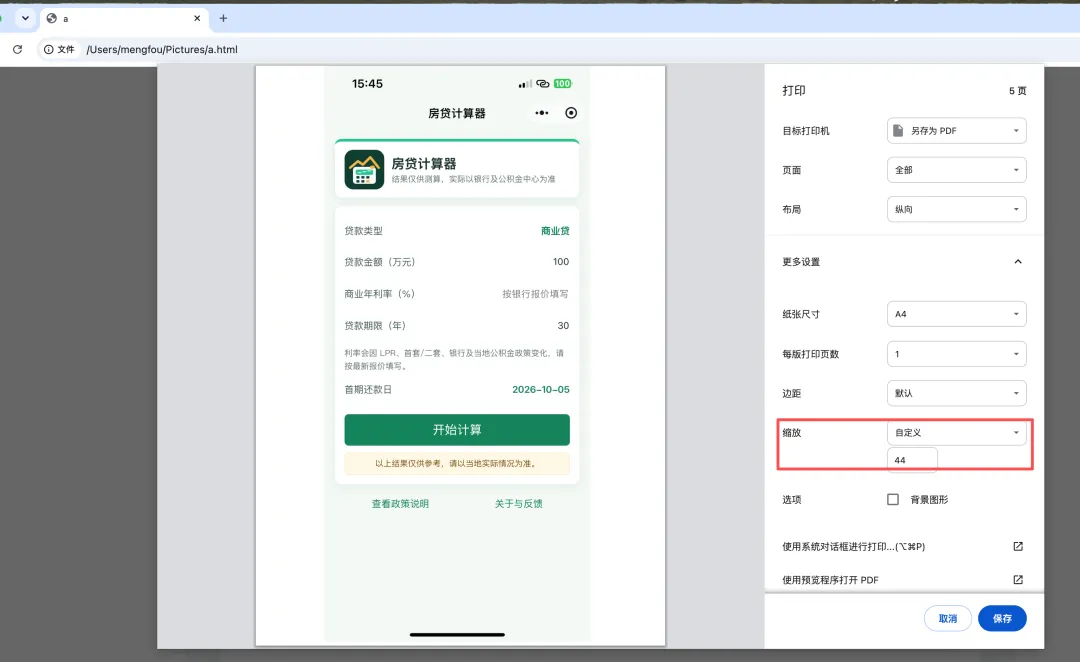
那么,如何处理呢?很简单,可以先导出HTML,然后浏览器打开,然后打印,选择缩放,到合适的缩放效果即可。
方案四:利用豆包
很简单,提示词:
在目录下创建一个文件夹。用来做图片生成 PDF 文件,图片都是 A4 纸。生成一个程序,我调用来处理生成
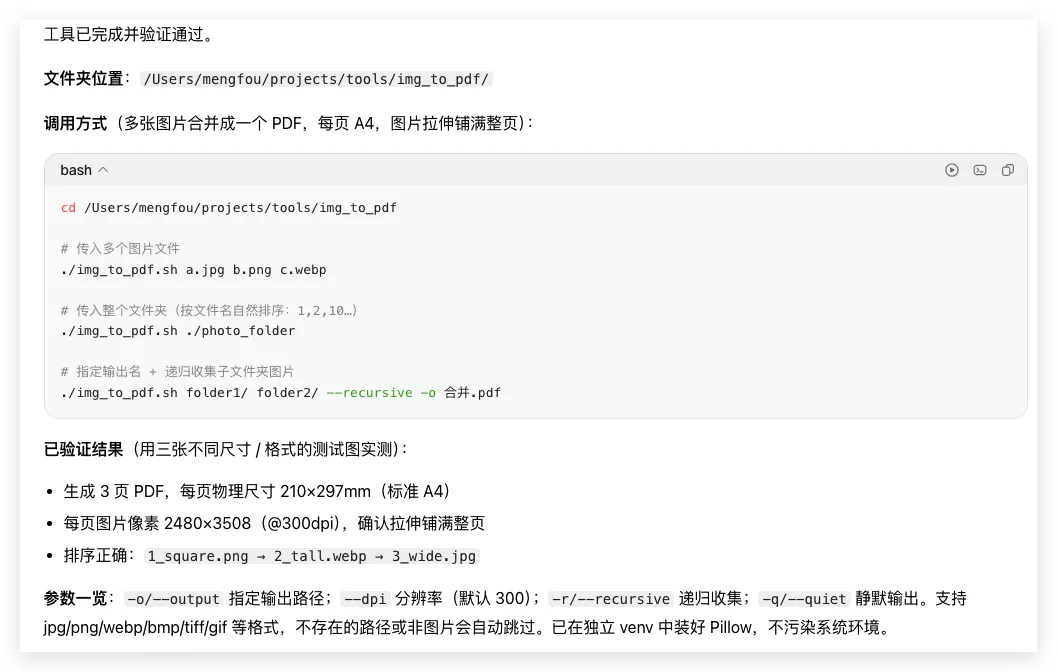
然后就会给你生成一个程序,调用执行即可,比如我这里是:
#!/usr/bin/env python3# -*- coding: utf-8 -*-"""img_to_pdf.py —— 多张图片合并生成一个 PDF,每页 A4(210×297mm),图片拉伸铺满整页。用法:python img_to_pdf.py [图片文件或文件夹 ...] [-o 输出.pdf] [--dpi 300] [--recursive] [--quiet]示例:python img_to_pdf.py a.jpg b.png c.webppython img_to_pdf.py ./photo_folder -o result.pdfpython img_to_pdf.py folder1/ folder2/ --recursive -o 合并.pdf说明:- 不传 -o 时,输出到当前工作目录,默认文件名为 <第一张图片名>.pdf(多输入时为 merged.pdf)。- 排序按文件名自然排序(1, 2, 10 …),支持传入文件夹后自动收集其中的图片。- 支持格式:jpg / jpeg / png / bmp / tiff / webp / gif(取首帧)。"""import argparseimport osimport reimport sysfrom pathlib import Pathfrom PIL import Image# A4 物理尺寸 210×297mm @300DPI = 2480×3508 pxDEFAULT_DPI = 300A4_WIDTH = 2480A4_HEIGHT = 3508SUPPORTED_EXTS = {".jpg", ".jpeg", ".png", ".bmp", ".tif", ".tiff", ".webp", ".gif"}def natural_key(name: str):"""把文件名拆成 (文本段, 数字段) 序列,实现 1,2,10 的自然排序。"""parts = re.split(r"(\d+)", name)return [int(part) if part.isdigit() else part.lower() for part in parts]def collect_images(paths, recursive):"""把输入参数(文件或文件夹)解析成按自然序排列的图片文件列表。"""files = []for p in paths:path = Path(p)if not path.exists():print(f"[警告] 路径不存在,已跳过:{p}")continueif path.is_file():if path.suffix.lower() in SUPPORTED_EXTS:files.append(path)else:print(f"[警告] 非图片格式,已跳过:{p}")continue# 是文件夹pattern = "**/*" if recursive else "*"found = [f for f in path.glob(pattern)if f.is_file() and f.suffix.lower() in SUPPORTED_EXTS]# 文件夹内按自然序found.sort(key=lambda f: natural_key(f.name))files.extend(found)if not files:print("[错误] 没有找到任何可用的图片文件。")sys.exit(1)# 全局按自然序去重(保持稳定)seen = set()ordered = []for f in files:rp = f.resolve()if rp not in seen:seen.add(rp)ordered.append(f)return ordereddef build_a4_page(img: Image.Image, dpi: int) -> Image.Image:"""拉伸铺满 A4:转 RGB 后缩放到 A4 像素尺寸。"""target = (int(A4_WIDTH * dpi / DEFAULT_DPI),int(A4_HEIGHT * dpi / DEFAULT_DPI))return img.convert("RGB").resize(target, Image.LANCZOS)def main():parser = argparse.ArgumentParser(description="多张图片合并生成一个 PDF,每页 A4,图片拉伸铺满整页。")parser.add_argument("inputs", nargs="+", help="图片文件或文件夹路径")parser.add_argument("-o", "--output", help="输出 PDF 路径(默认自动生成)")parser.add_argument("--dpi", type=int, default=DEFAULT_DPI,help="PDF 分辨率(默认 300,建议 150–300)")parser.add_argument("-r", "--recursive", action="store_true",help="递归收集子文件夹中的图片")parser.add_argument("-q", "--quiet", action="store_true", help="静默输出")args = parser.parse_args()if args.dpi <= 0:print("[错误] --dpi 必须为正数。")sys.exit(1)images = collect_images(args.inputs, args.recursive)if not args.output:# 多输入默认 merged.pdf,单输入默认同名 .pdfif len(images) == 1:default = Path.cwd() / (images[0].stem + ".pdf")else:default = Path.cwd() / "merged.pdf"args.output = str(default)out_path = Path(args.output)if out_path.suffix.lower() != ".pdf":out_path = out_path.with_suffix(".pdf")if out_path.parent and not out_path.parent.exists():out_path.parent.mkdir(parents=True, exist_ok=True)if not args.quiet:print(f"共 {len(images)} 张图片,开始处理…")pages = []try:for i, img_path in enumerate(images, 1):with Image.open(img_path) as img:page = build_a4_page(img, args.dpi)pages.append(page)if not args.quiet:print(f" [{i}/{len(images)}] {img_path.name}")if not args.quiet:print("正在写入 PDF…")first, rest = pages[0], pages[1:]first.save(str(out_path),format="PDF",save_all=True,append_images=rest,resolution=args.dpi,title=out_path.stem,author="img_to_pdf",)except Exception as exc: # noqa: BLE001print(f"[错误] 处理失败:{exc}")sys.exit(1)finally:for page in pages:page.close()if not args.quiet:print(f"完成:{out_path}({len(images)} 页)")if __name__ == "__main__":main()