ARTICLE · 1140302
AnythingLLM:把公司文档喂给 AI,做成谁都问得动的私有知识库
有个场景几乎每个团队都遇到过:产品文档散在十几个飞书链接里,新人对着文档翻半天找不到接口参数;客服同学每天被同样的问题问二十遍;你自己写的笔记存了几百篇,真要用的时候一句都想不起来。把这些东西丢给 ChatGPT 不行——文档出不去内网,而且它也不知道你们公司的事。AnythingLLM 解决的就是这一件事:把你自己的文档,变成一个能问、能答、还带出处的私有知识库,全程跑在你自己的机器上。
一、它到底解决了什么
先说清楚一件事:通用大模型很聪明,但它脑子里没有你公司的资料。想让它答得准,业界通用的做法是 RAG(检索增强生成)——先去你的文档里把相关段落找出来,再让模型基于这些段落回答。听起来简单,自己搭可不容易:要选向量数据库、要切分文档、要写嵌入逻辑、要做前端对话页,一整套下来至少一两周。
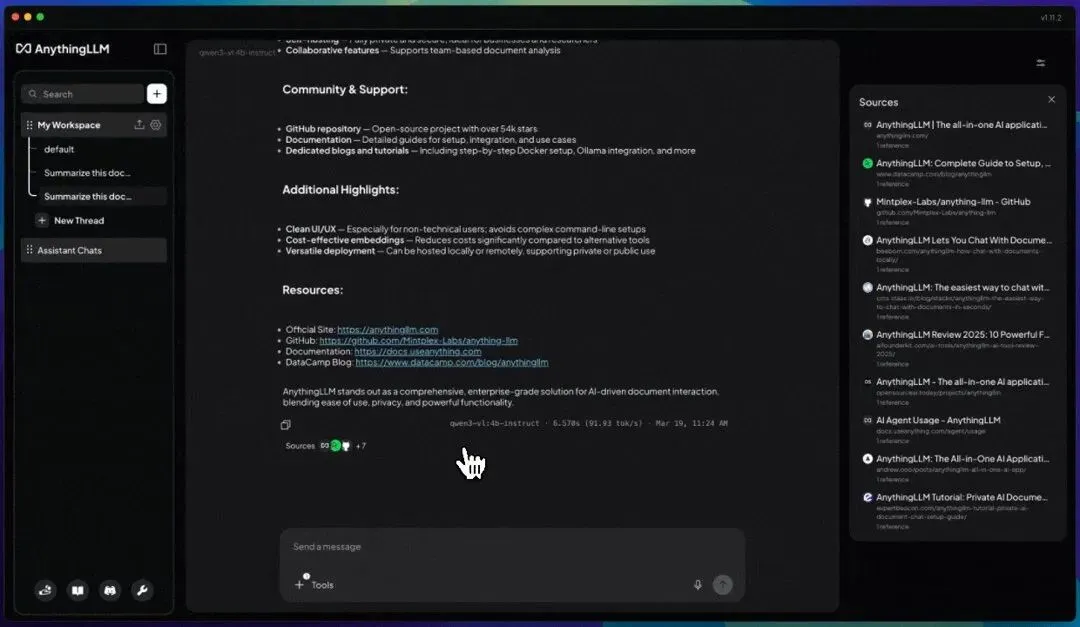
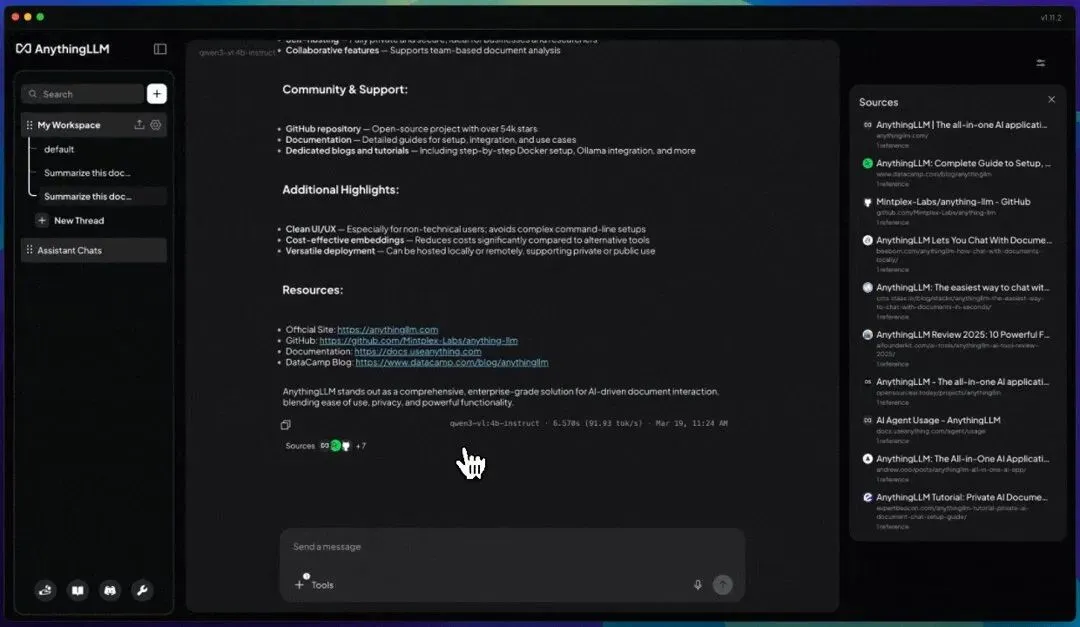
AnythingLLM 把这整套东西打包成了一个开箱即用的应用。它有桌面版,下载安装包双击就能用,不用碰命令行;也有 Docker 版,一条命令起在服务器上给全团队用。你唯一要做的事,就是拖几份文档进去。
二、十分钟装起来
想给团队用就上 Docker,一条命令搞定,数据存在本地卷里:
# 先建目录,避免容器重启后数据丢失
export STORAGE_LOCATION=$HOME/anythingllm
mkdir -p $STORAGE_LOCATION && touch $STORAGE_LOCATION/.env
docker run -d -p 3001:3001 \
-v $STORAGE_LOCATION:/app/server/storage \
-v $STORAGE_LOCATION/.env:/app/server/.env \
mintplexlabs/anythingllm:master
打开 http://localhost:3001 进向导,第一步选大模型后端,第二步选向量库,第三步建管理员账号,完事。个人单机使用直接下桌面版,连 Docker 都不用装。
后端可以按预算随便换:接 OpenAI / Gemini 效果最好但要出网、要花钱;接本地 Ollama 的 qwen2.5 完全离线免费,但推理慢一些、理解力也弱一档。我的建议是先用本地模型把流程跑通,确认知识库真的能用,再决定要不要为效果付费。
三、把文档喂进去的三种方式
① 直接上传文件:PDF、Word、TXT、Markdown、CSV 都能吃,单个文件最大几十 MB,拖进对话框左侧的上传区即可。它会自动切分成小段、转成向量存起来。这是最常用的一种。
② 抓取网页:把文档链接粘进去,它会自动爬下来建索引。适合把那种「写在内部 wiki 上、每周都在更新」的内容同步进来,隔段时间重抓一次就算更新。
③ 连数据源:GitHub 仓库、Confluence、Notion、YouTube 字幕都能对接。比如把整个项目的 README 和 docs 目录接进来,新人问「这个服务怎么本地启动」,它直接从仓库文档里给出答案,还附链接。
四、决定效果好坏的两个设置
分块大小和重叠。文档不是整篇丢给模型的,要先切成一个个小段落(chunk)。默认是 1000 字符左右、重叠 20 个字符。文档偏技术、术语密集,可以把块调小到 500,检索更精准;文档偏叙述、需要上下文连贯,调到 1500 更合适。重叠的作用是防止一句话恰好被切断在两块之间,别设成 0。
聊天模式和查询模式。这是很多人忽略的关键开关。聊天模式(Chat)会结合历史对话和文档一起回答,适合追问;查询模式(Query)每一轮都只看文档、不带历史,答案更稳更可复现。做客服问答、对外输出结论时用 Query,内部探索性提问用 Chat。
五、三个真实场景
技术团队的内部文档库:把 API 文档、部署手册、故障处理记录全传进去,新同事不再追着老同事问。有个朋友的公司把三年的故障复盘传进去,值班同学半夜问「这个报错上次怎么处理的」,直接拿到当时的处理步骤,平均排障时间从四十分钟降到十分钟。
销售和客服的话术库:产品资料、竞品对比、常见异议全塞进去,一线同学遇到客户提问直接搜。比翻 PDF 快,也比让大模型凭空编靠谱——因为每条答案都带出处,能点开核对原文。
个人的第二大脑:把自己几年的读书笔记、会议纪要、技术博客全喂进去,写作时问它「我之前在哪篇笔记里写过 XX 的观点」。这是我用得最多的一种,效果也最明显——以前写完就忘,现在随时能调出来。
六、四个容易踩的坑
① 换模型必须重新嵌:嵌入模型和向量库是绑定的,中途换了嵌入模型,之前建的索引全部失效,必须删掉重建。所以一开始就定好,别中途改。
② 扫描版 PDF 没用:图片型 PDF 没有文字层,它读不出内容。先用 OCR 转一遍,或者干脆换文字版。
③ 别把什么都塞进一个空间:不同用途的文档要分 Workspace(工作区),销售话术和技术文档混在一起会互相污染检索结果,答案反而变糊。
④ 权限别裸奔:它自带多用户和权限体系,但默认配置很宽松。要放到公网给团队用,一定先开登录、配好角色,别把公司文档暴露在匿名访问下。
七、给你的一句话建议
先用桌面版花十分钟传五份文档,问几个你本来就知道答案的问题——答对了,说明这套流程成立;答不对,先调分块大小再换嵌入模型。不要一上来就想「建公司级知识库」,先把一个小而明确的场景跑顺,比如「只装产品 FAQ」,见效最快。等你确认它真的能用,再上 Docker 版给团队用,接 Ollama 保数据不出网,接云端 API 保效果。工具本身不难,难的是想清楚「哪些文档值得喂进去」——垃圾进去,还是垃圾出来。