ARTICLE · 1142186
写满手写的试卷也能"秒懂":我用 WorkBuddy + xParse 搭了个错题整理工作台
错题只能靠手抄?
拍一张卷子,三样产出
分析 · 看板 · 干净重做卷
WorkBuddy × TextIn xParse 实测 · 手写/印刷分离 · 公式 LaTeX 化 · 错题数据持续积累
WorkBuddy × xParse 实测
📦 8 Parts + Conclusion
👉 滑动
PART 01
效果展示
三样产出
PART 02
认识 xParse
数据层定位
PART 03
看懂一张试卷
流水线拆解
PART 04
搭建工作台
从连接器到闭环
PART 05
两条路线之争
直接问 vs 先解析
PART 06
踩坑与建议
四个真实的坑
PART 07
实测评价
准确率与适用人群
PART ///
写在最后
总结与定位
核心结论一句话
拍照的试卷能直接变成结构化数据,错题本从此可积累、可统计、可重做
最近对 AI+教育场景挺感兴趣,偶然发现直接用多模态大模型处理错题照片总是“看着像那么回事”,但数据没法沉淀、公式识别也不稳。于是自己折腾了一套基于 WorkBuddy 和 xParse 的错题整理工作台,没想到真把手写试卷变成了可统计、可重做的结构化资源。
这篇文章记录了从踩坑到跑通的全过程,包括用 WorkBuddy 搭「错题整理工作台」管数据,xParse 连接器做识别,手写/印刷分离、公式识别、版面还原这三件脏活全交给它。
体验地址:错题整理工作台 · WrongBook Bench
01
PART
效果展示
SHOWCASE · WHAT YOU GET
谁没对着满纸红叉的试卷发过愁?手抄错题太累,拍照存相册又乱成一锅粥。错题整理工作台就是为了解决这种“错题焦虑”而生。「错题整理工作台」基于 WorkBuddy × xParse,Agent 负责的内容交给 WorkBuddy,识别的活交给 xParse。职责一句话说完——手写试卷进去,错题分析、薄弱知识点看板、可打印重做的干净卷子出来;错题数据留在工作台里持续积累,越用越清楚薄弱在哪。
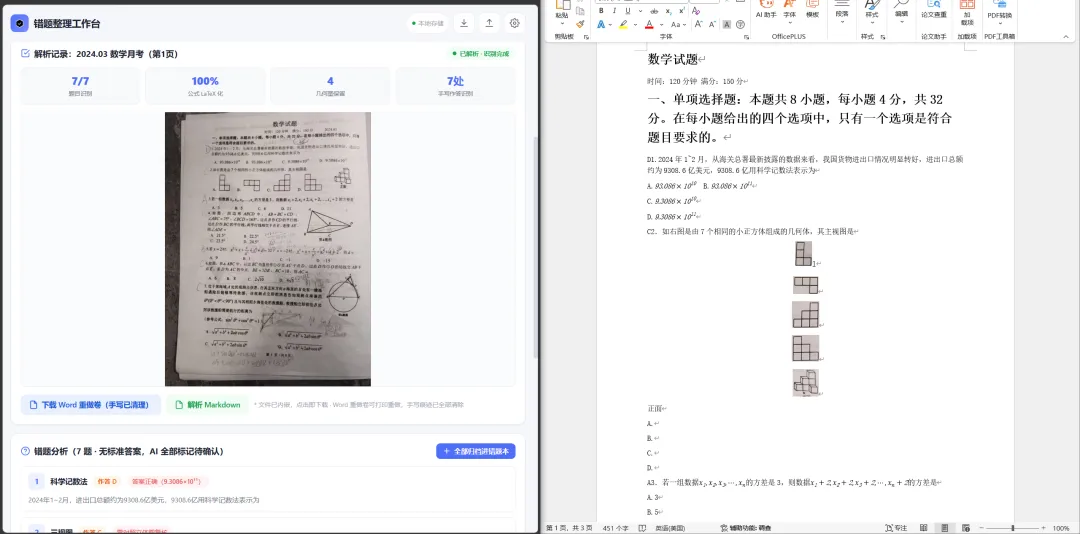
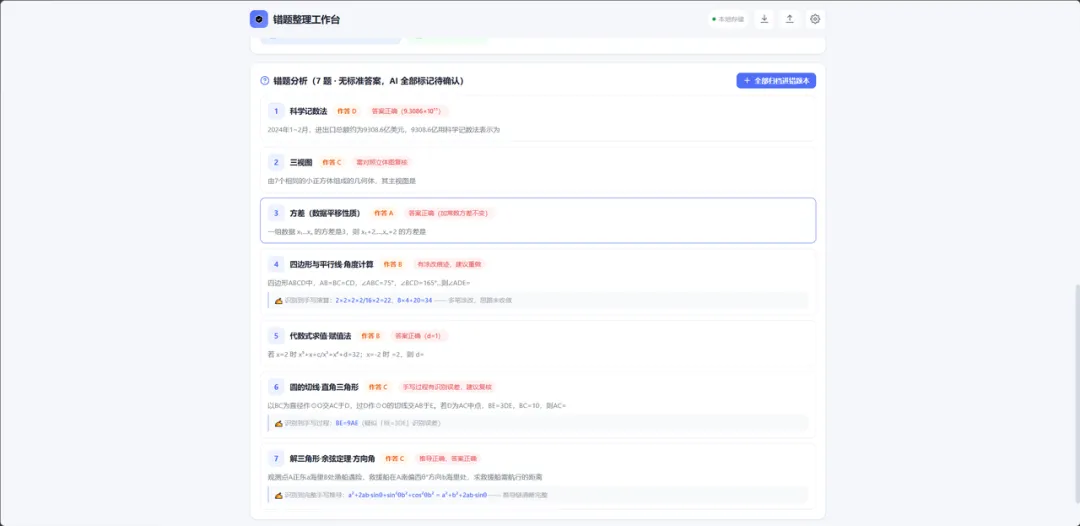
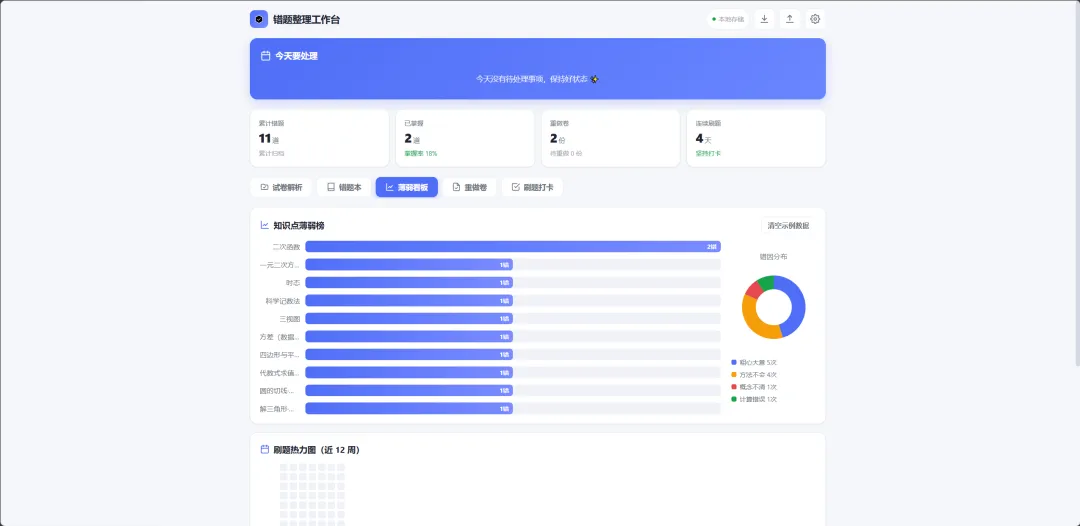
一页手写卷子的照片拖进去,产出区依次出现三样东西:
错题清单:题号、错因、涉及知识点逐条列出,可直接追问;
知识点薄弱看板:柱状图、错因饼图、掌握度趋势自动生成,错在哪块一眼看清;
干净 Word 重做卷:手写痕迹和涂改全部清除,印刷题目、公式、几何图原样保留,导出即打印。
几个让我意外的细节
草稿归入手写层
我在选择题之间随手打的草稿、划掉重写的演算,在解析结果里被单独归到了手写层,没有污染题目文本。
推导逐行可回看
第 7 题的完整推导过程被逐行识别,顺着能回看我当时的思路。
几何图原位保留
四个几何图全部作为图片元素保留在原位,重做卷里图还在。
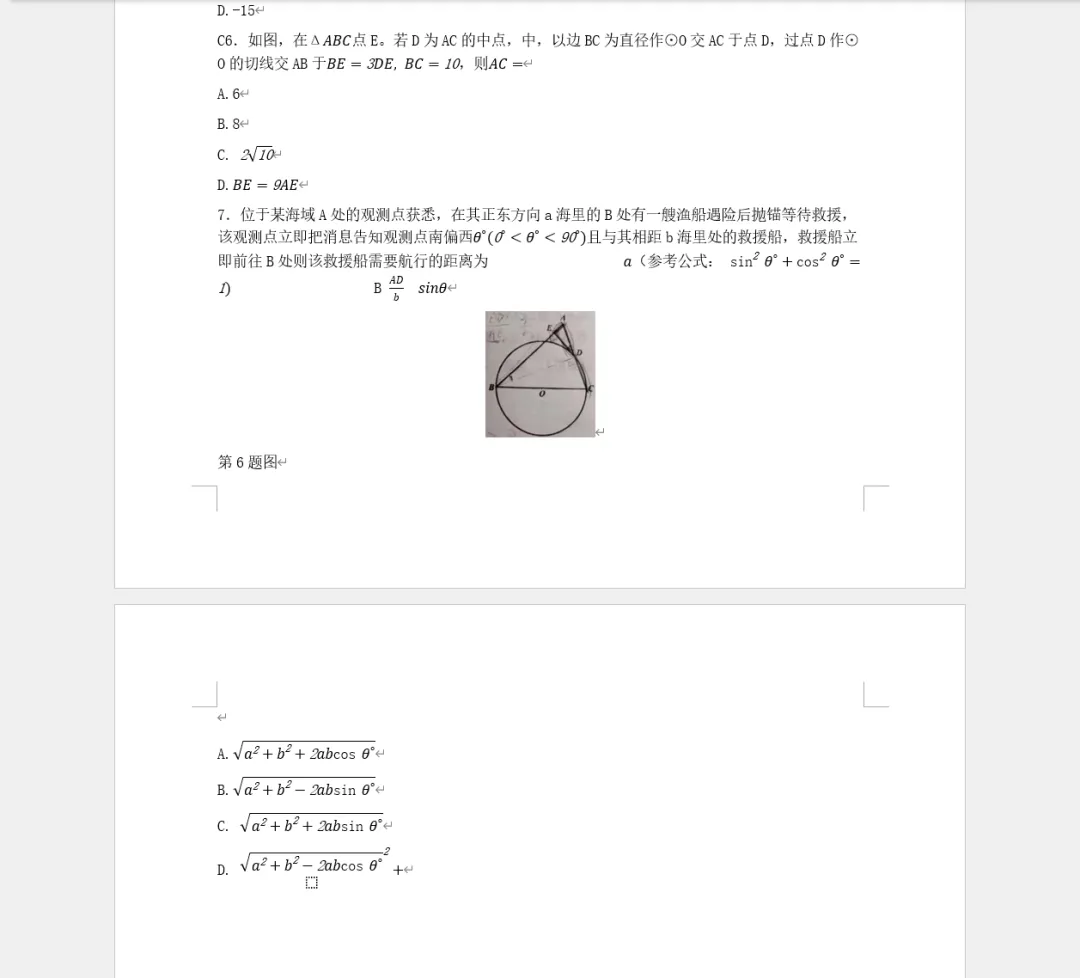
也有翻车现场:第 6 题的手写“BE=3DE”被识别成“BE=9AE”,第 5 题的题号“5.”被认成了“25.”。一张卷子里混着印刷体、手写体、公式、图形,它凭什么能分清、又为什么会认错?下面拆开看。
02
PART
xParse 介绍:它是谁、用了什么技术
MEET XPARSE · TECH STACK
TextIn xParse 与「数据层」定位
xParse 是合合信息旗下 TextIn 推出的 AI 数据层基础设施,职责是把复杂文档变成干净、一致、可被 AI 使用的结构化数据。
学习助手能不能“看懂”卷子,取决于这一层做得好不好。
技术栈
手写体识别(OCR)
认出学生写的答案与涂改。
印刷体识别 + 版面还原
题目结构、题号层级原样保留。
数学公式识别
输出 LaTeX 而不是糊成一团的文本。
图片/图形处理
几何图、函数图像作为图片元素保留。
手写清除与文档重建
剔除手写层、重建干净题目文档,导出 Word。
WorkBuddy 连接器(基于 MCP)
把 xParse 能力接进智能体工作流。
03
PART
拆开「看懂一张试卷」这件事
HOW IT WORKS
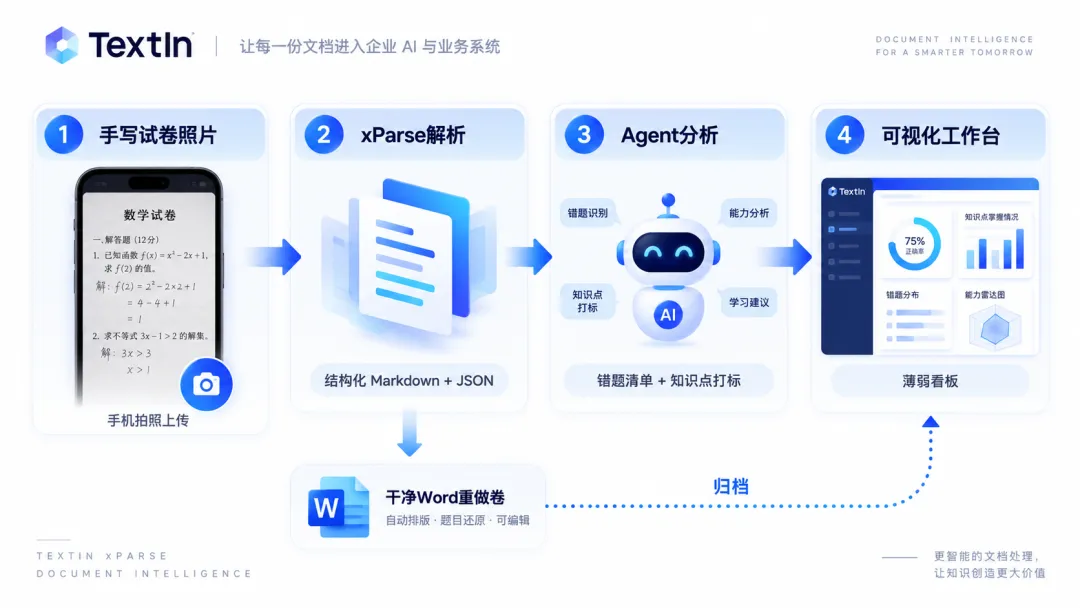
还是那条流水线,只是这次输入是「花」的
拍照/PDF 上传
→ xParse 解析(手写/印刷分离 + 公式结构化 + 版面还原)
→ 智能体分析(错题判定、知识点归类、统计)
→ 输出(薄弱看板 + 干净重做卷)
一张试卷里混着多少东西
印刷题目、手写答案、涂改痕迹、数学公式、几何图形、草稿,全挤在同一页纸上。普通 OCR 只能“识字”,分不清哪些是题目、哪些是学生写的,输出一锅粥。
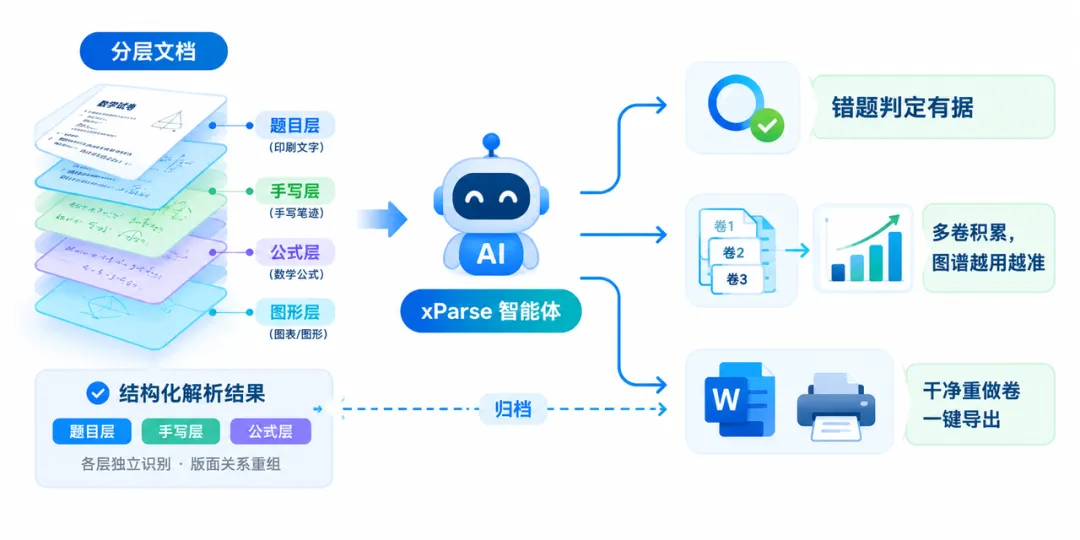
xParse 的解法是分层:印刷层、手写层、公式、图形各自归位,再按版面关系拼回去。
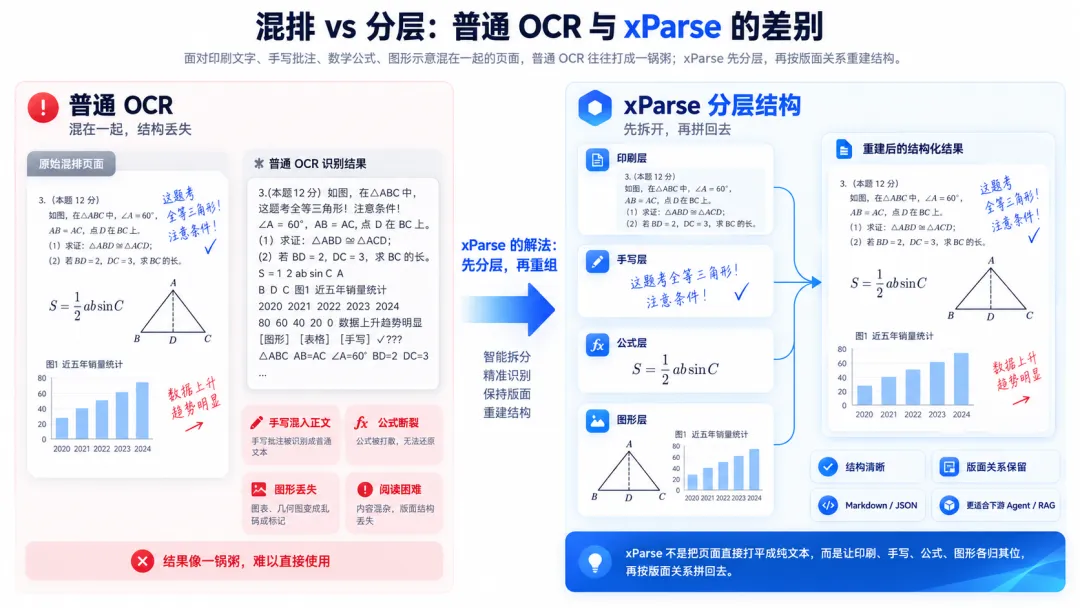
左边是我使用 OCR 进行解析的效果,右边是 xParse 解析出来的效果:
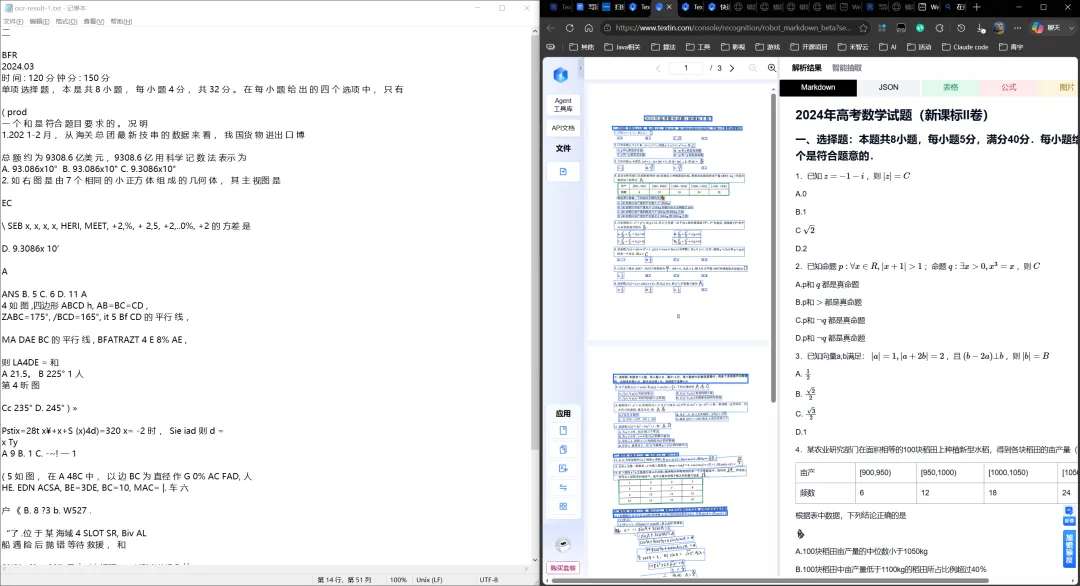
手写清理与重做卷生成
剔除手写层,按原版面重建题目,导出 Word,打印即可重做。
错题本的终极形态
不是抄题,是原卷重现
04
PART
用 WorkBuddy + xParse 搭「错题工作台」
BUILD THE WORKBENCH
后台接入 xParse:连接器优先,API 备选
接入有两条路。连接器模式走 WorkBuddy 原生支持(基于 MCP),配置即用、零代码;API 模式直接调 xParse 接口,参数级可控,适合批量流水线和深度定制。
我选的是连接器,理由很简单:个人错题整理是单卷、交互式的场景,连接器的开箱即用比 API 的灵活更值钱。后面真要做“每天自动处理一个班 40 份卷子”的批量场景,再切 API 不迟,这个取舍过程如实记录在这里。
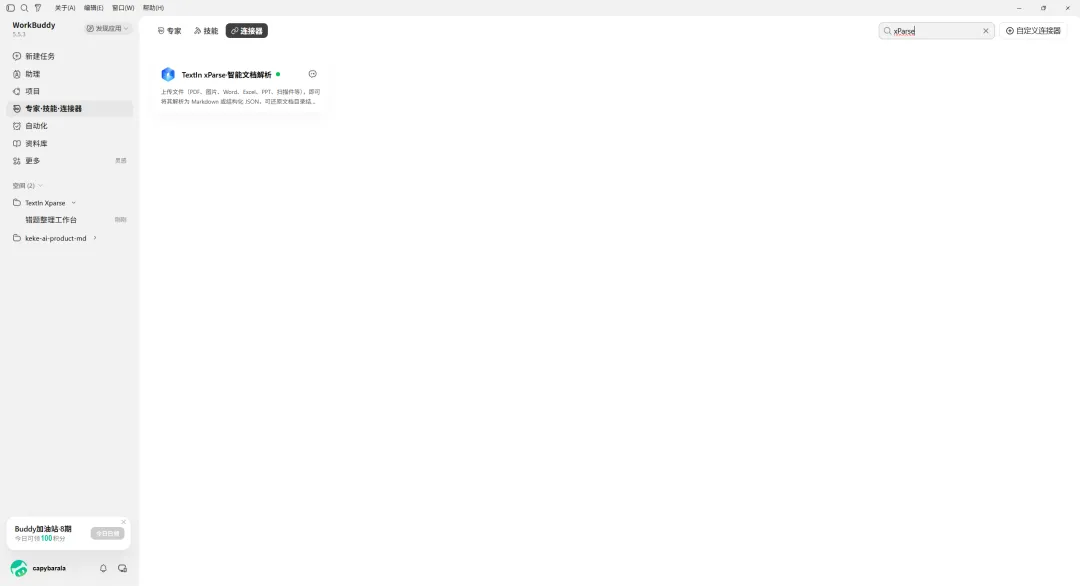
配置本身两分钟:WorkBuddy 左侧「连接器」入口,找到 TextIn xParse,授权,终端里 xparse-cli version 能出版本号就成了。
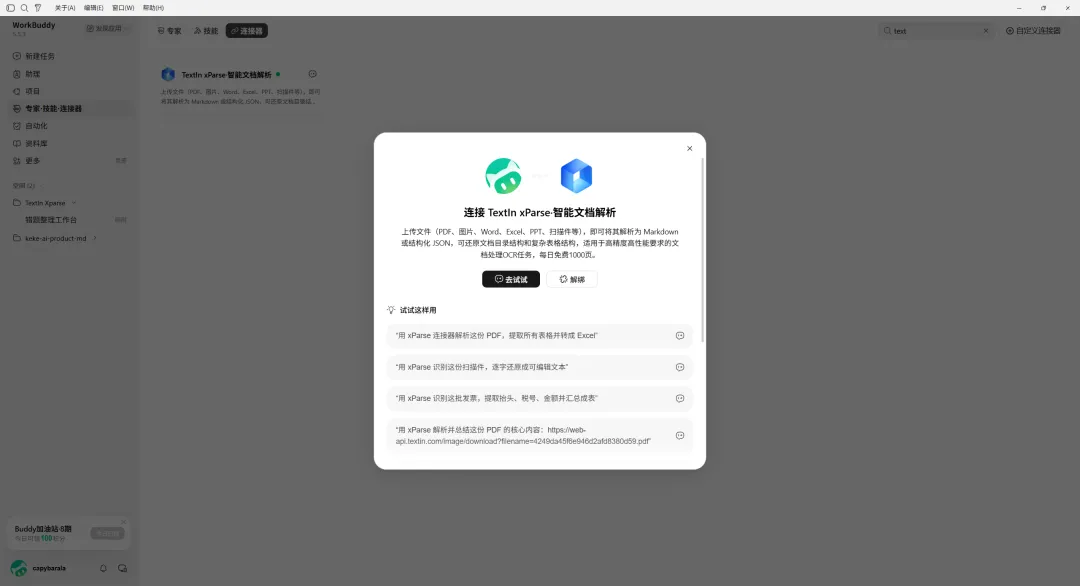
配好之后,解析就是一个可调用的命令:
# 免费解析:图片 → 结构化 Markdown + JSON(--api auto 自动走每日免费额度)
xparse-cli --profile workbuddy parse 试题2.png --api auto --output 解析结果/
产出两份文件:1. 分层清晰的结构化文本;2. 带元素坐标和类型标注的完整数据,给 Agent 做错题分析用。
工作台形态:功能模块与架构设计
这次的工作台全内联、零外链,数据存在浏览器 localStorage 里,围绕「一道错题的生命周期」来设计:被发现、被归档、被复盘、被重做,对应四个模块。
页面顶部还有个「今天要处理」区:逾期未掌握的错题、待重做的卷子自动置顶,红点标红,一键处理,昨天没做完的自动滚到今天。
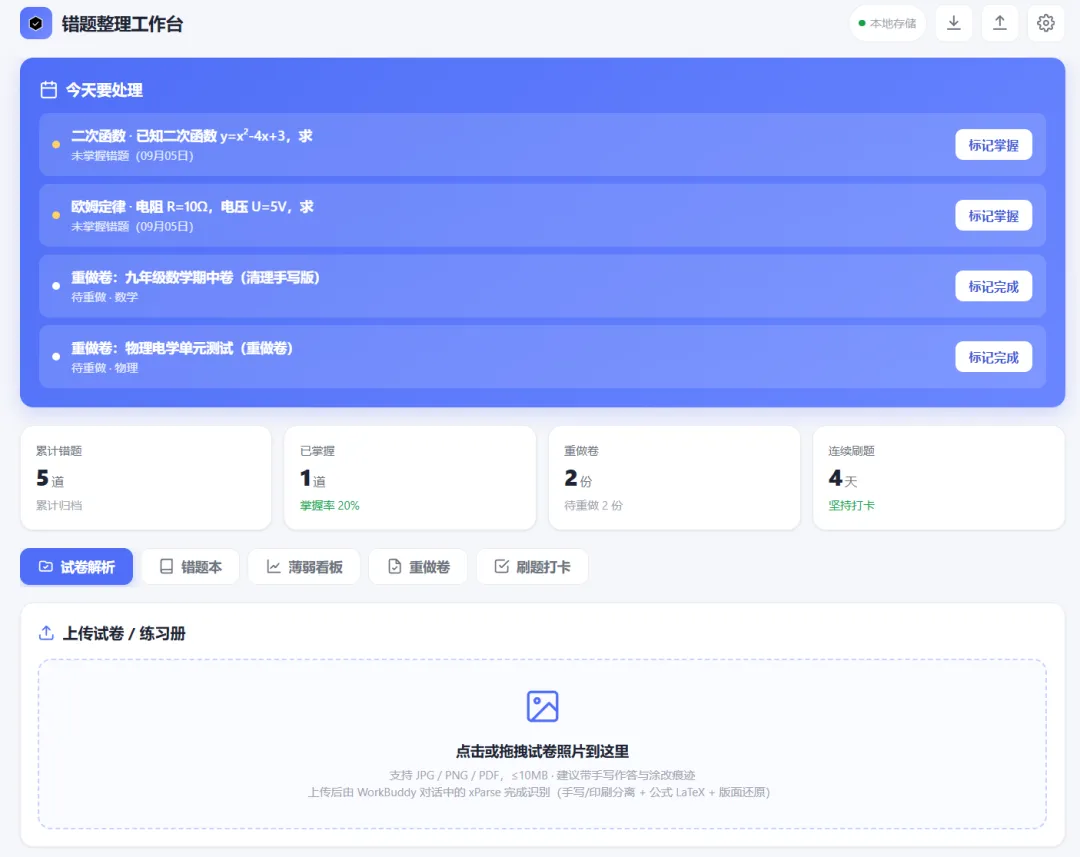
当前版本里,识别入口在 Agent 侧(解析命令 + 错题分析),工作台负责接收分析结果做归档和可视化,两者在「一键导入 JSON」这一步握手,“页面上一个上传按钮跑通全流程”。把数据层和可视化做扎实,加一个轻后端,把上传、解析、分析串成一键,就是完全体。
识别流程怎么接进工作台
关键设计:识别和清理的能力在 xParse,工作台管数据,Agent 在中间做分析。
三步走完闭环:
解析试卷
第一步,解析——就是上面那条命令,免费跑完,产出结构化文本 + 坐标 JSON。
导出重做卷
# 导出干净 Word 重做卷(走付费接口,执行前会明确提示授权,不会静默扣费)
xparse-cli --profile workbuddy parse 试题2.png --api paid --export docx --output 重做卷/
Agent 分析打标
第三步,Agent 基于解析 JSON 做错题判定和知识点打标,输出一份固定格式的分析结果:
{
“wrongQuestions”: [
{
“qid”: “19(1)”,
“knowledge”: “二次函数”,
“content”: “已知二次函数 y=x²-4x+3,求图象的顶点坐标”,
“reason”: “概念不清”,
“master”: “weak”,
“correctSolution”: “配方得 y=(x-2)²-1,顶点坐标为 (2, -1)”
}
]
}
在工作台里点上次试卷/练习题,一键导入 Agent 解析结果,这份 JSON,错题本、薄弱看板、重做卷归档一次到位。
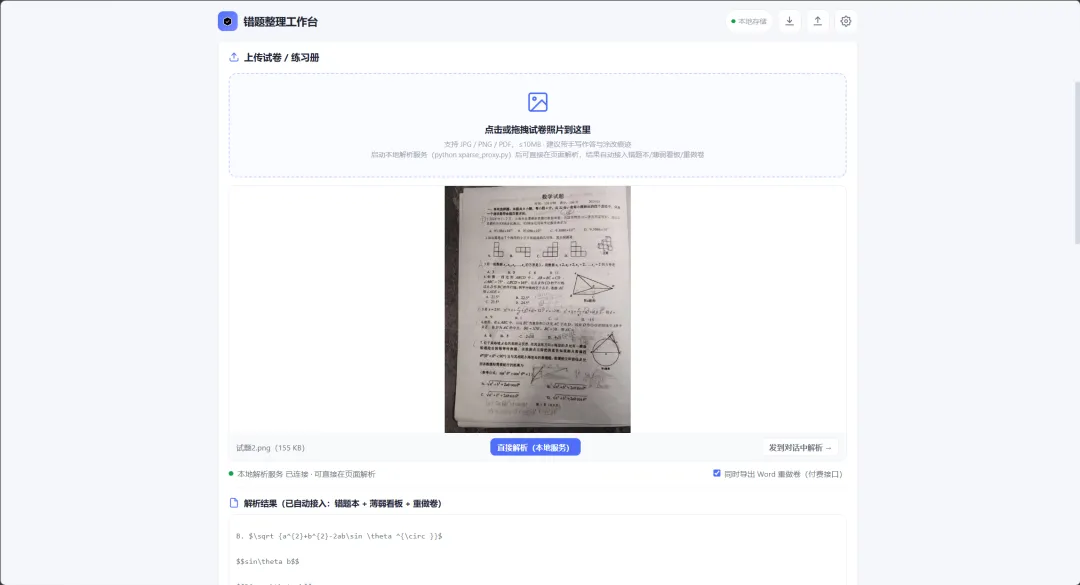
真实体会:AI 搭工作台好不好用
模块拆解、样式、数据持久化这些体力活,AI 一次就搞定,我几乎没改代码。需要手动介入的就两处:错题判定逻辑要先想清楚“对照标准答案还是让学生圈划”;识别精度对拍照质量敏感,这两点都放进踩坑章细说。
05
PART
两条路线之争:直接问 AI vs 解析后再问
TWO ROUTES
路线一:把试卷图直接丢给多模态大模型
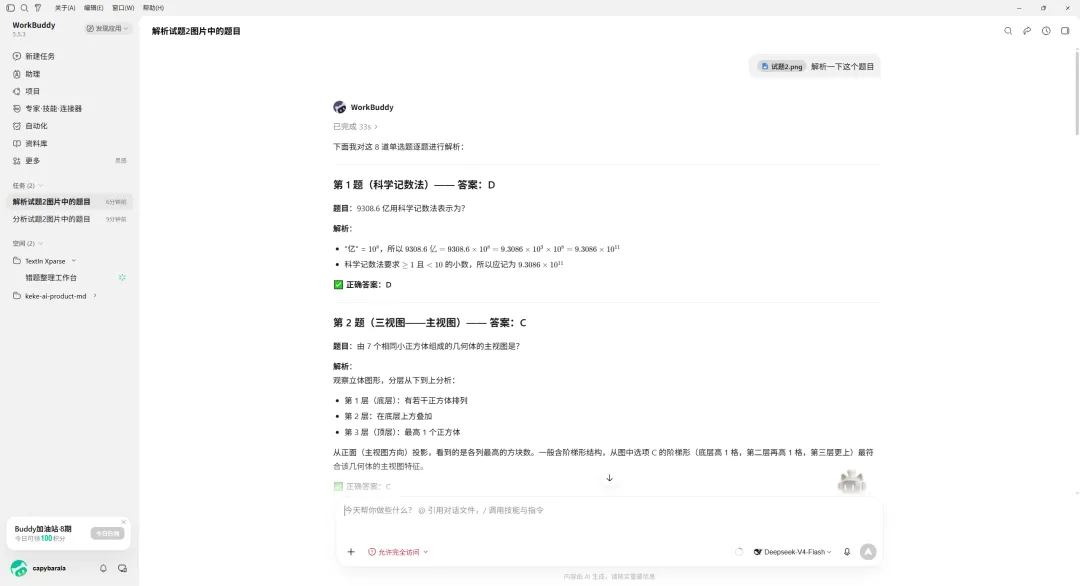
把卷子截图直接发给能看图的大模型,也能聊两句,但做不了错题整理:题目和手写混在同一张图里,判定错题时它分不清“学生写的”和“题目印的”;每次都要重新上传重新问,错题无法积累;更拿不到清理手写后的重做卷。
可以看到,直接丢给多模态大模型后,不管是学生写的,还是印刷的,都会被解析出来。并且丢给大模型解析还取决于你选择的模型的能力强弱;而使用 xParse 解析后,得到统一的 md/json 文件,不再完全依赖模型,即使参数比较小的模型,也能有很不错的效果。
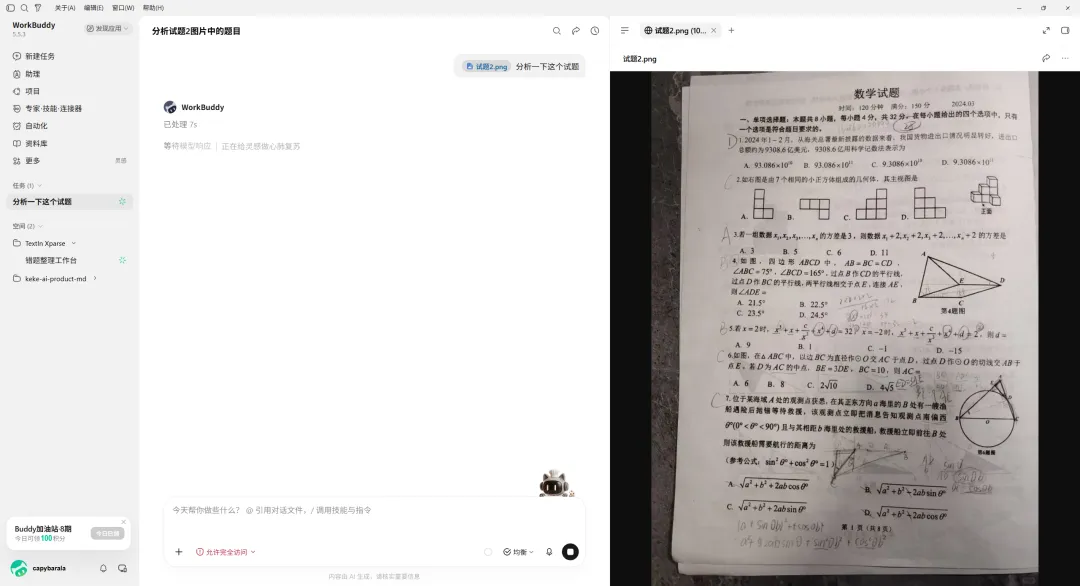
只能分析题目,无法对学生手写的答案作错题分析:
路线二:xParse 解析后交给智能体
判定有据
数据干净,错题判定有据。
越用越准
多卷持续积累,薄弱图谱越用越准。
可再加工
解析结果可再加工,直接产出 Word 重做卷。
怎么选
偶尔问一道题,直接读图也行;要系统整理错题、要重做卷,必须走解析层。
xParse 解析效率
06
PART
踩坑与建议
PITFALLS & TIPS
这次实测留下四个真实的坑,都比想象中具体:
!坑 1 · 题号会被「污染」 🕳
第 5 题的题号“5.”被识别成了“25.”,疑似上一题末尾的数字混了进来。多页卷或答案页有数字结尾时要留意,目前靠人工校正题号兜底。
!坑 2 · 形近手写字会认错 🕳
第 6 题手写的“BE=3DE”被识别成“BE=9AE”,3 和 9 的手写体太像了。手写过程的整体识别率目测在 85% 上下,答案字母这类短内容几乎全对,长推导需要对照原图扫一眼。
✦ 拍照建议
对于前两点:工整或一般潦草的手写识别很好,但极度潦草、连笔重、涂改叠加的题可能认错或漏认。建议拍照时光线均匀、角度正对、分辨率够高,避开阴影和反光。
!坑 3 · 跨行公式偶有截断 🕳
第 7 题选项 D 的 LaTeX 输出少了 θ°,应该是公式跨行排版导致的。简单到中等公式(分式、根式、三角函数)全程稳定,复杂多层嵌套需要人工复核。
!坑 4 · 没有标准答案,错题判定就是无根之木 🕳
AI 判对错得先知道正确答案。我这次用的卷子没带答案页,7 道题全部只能标“待确认”。
AI 判“对错”得先知道标准答案,要么上传答案页,要么让学生在错题上圈划,这样更符合真实使用习惯。图片题在 Word 中的呈现:几何图、函数图能作为图片保留,但清晰度取决于原卷照片质量,极模糊的图可能需要补拍。
07
PART
评价:识别有多准、适合谁
THE VERDICT
实测准确率
xParse 对数学公式识别、几何图保留、印刷/手写分层这三项核心能力表现稳定;手写过程的精细识别(含涂改、相似字符)有少量误差,但已足够支撑「错题整理 + 重做卷」的实际应用。
不如意的地方
极潦草的手写偶尔要重拍;复杂公式不能完全撒手,导出后要扫一眼;错题判定依赖标准答案或人工圈划兜底。
适合谁
中小学生家长
帮孩子整错题、出重做卷。
大学生
真题复盘、薄弱点定位。
教师
班级错题统计的轻量版。
///
LAST
总结
SUMMARY
这次实践最真实的收获,是错题本从“手工抄题”进化成了“拍照、分析、重做”的闭环:拍一张卷子,AI 拆出错题、标出薄弱点、清出干净重做卷,全部归档进一个可积累、可统计的工作台。手写识别不是 100 分,但 85 分的手写识别加上 100 分的印刷和公式还原,已经足够把“抄错题”这个环节从流程里删掉了。
一句话回扣定位
智能体负责「教」,xParse 负责「看」
数据层基础设施,是所有学习类 AI 应用的地基。地基打得足够扎实,上面能盖的房子,远不止一个错题本。
我是 UserTechHub,热衷于分享 AI 实测与效率工具,把踩过的坑和跑通的流程原样记录给你。
既然看到这里了,如果觉得有用,随手点个赞、在看、转发三连吧。
THANKS FOR READING