ARTICLE · 1143906
推理服务网关卸载到 DPU:Scale-In 层的实测与架构含义
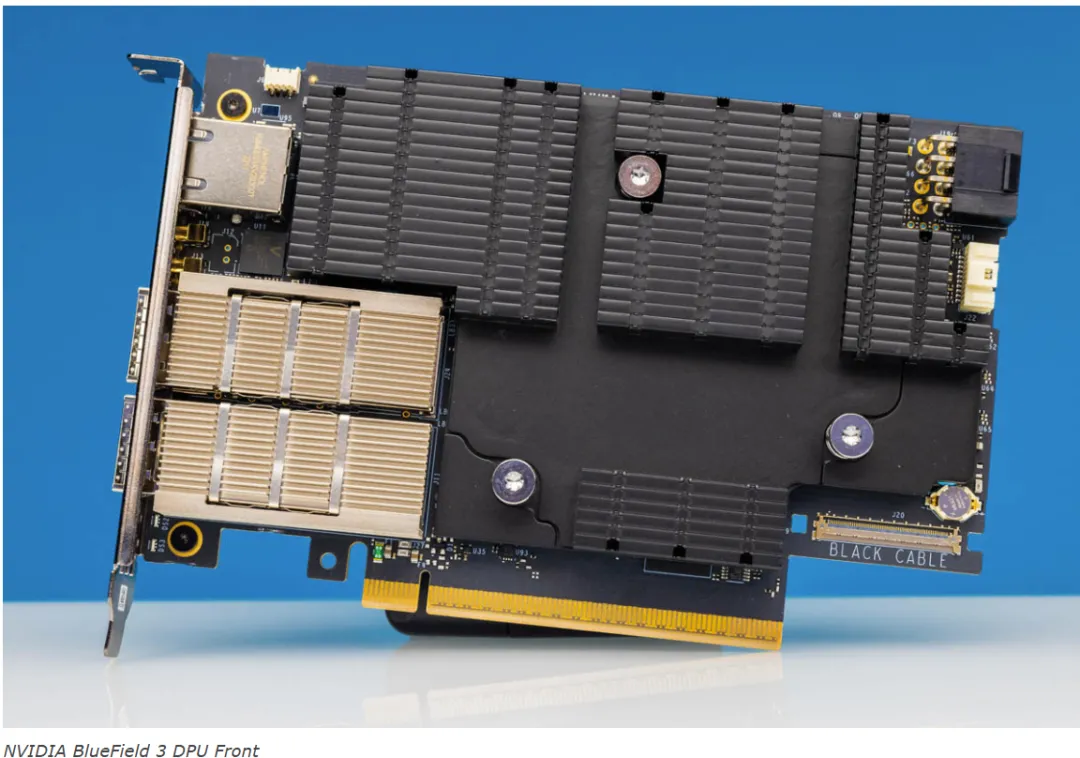
2026 年 10 月 1 日,ServeTheHome 发布了对 F5 加州实验室的实地探访:F5 的应用交付与安全软件栈 BIG-IP Next for Kubernetes 运行在 NVIDIA BlueField-3 DPU 上,承担 GPU 推理集群前置的请求路由、token 治理与四层至七层安全。用本系列的框架表述:这些功能属于 Scale-In 层——此前该层的承载清单是存储卸载与安全策略,本次实测新增了七层网关,而承载器件正是 DPU。同期公布的 Tolly Group 独立基准给出了主机核占用的量化对比。本文以这两个一手来源为基线,分析推理服务网关卸载到 DPU 的架构逻辑与量化收益。
F5 是应用交付控制器(ADC)领域的代表性厂商,其传统产品形态是机架内的专用硬件设备:负载均衡、SSL/TLS 终结、防火墙与流量管理运行在设备本体的专用软件栈上。BNK(BIG-IP Next for Kubernetes)是这一能力向云原生环境的迁移——以 Kubernetes 原生形态交付同样的七层功能。本次实验室展示的关键变化在于部署位置:BNK 不再运行在主机 CPU 或独立设备上,而是运行在 BlueField-3 DPU 内。
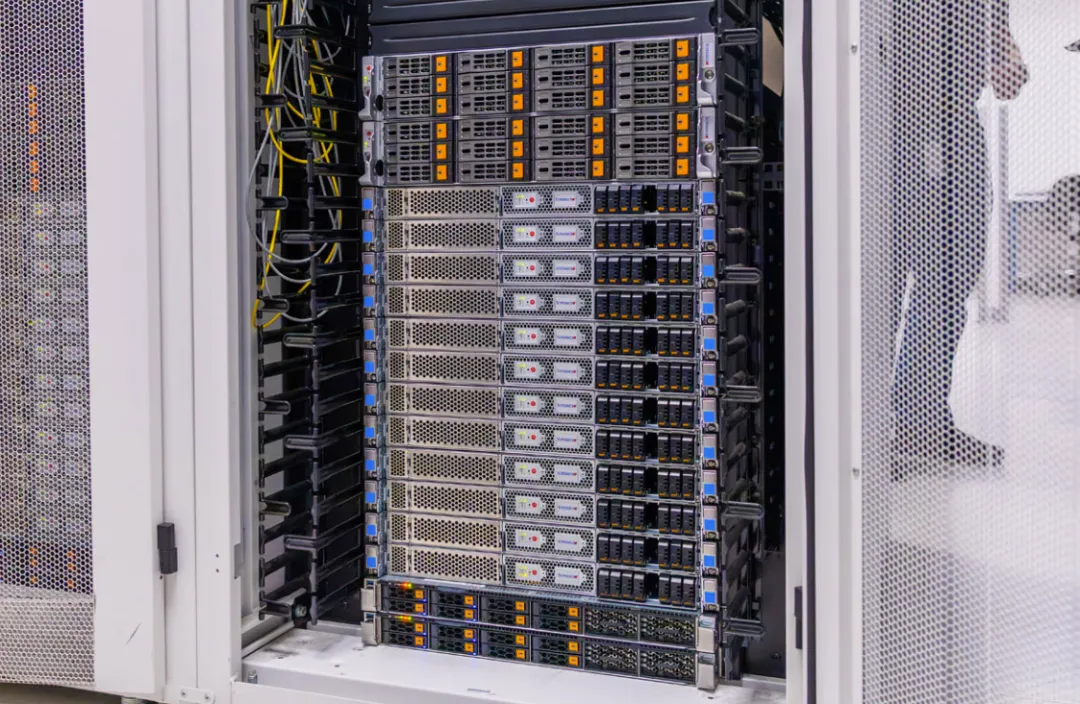
F5 的机房实景说明了三种形态的并存:传统硬件设备仍在近旁机架中;BNK 也可以部署在主机 CPU 上运行;但实验集群选择了 DPU 部署。三种形态承担同一组功能,差别在于资源归属——设备形态独立占用机架空间,主机形态消耗业务核,DPU 形态则把这组功能移入 Scale-In 层的承载位置:主机信任域之外、网络路径之上、具备独立算力的专用器件。这一选择对应一个架构判断:七层网关属于 Scale-In 层的基础设施职责,而 DPU 是 Scale-In 层的承载器件。
外界对 AI 集群的想象通常只有一张高速网络,实际拓扑远为复杂。该实验室的集群中并存多张网络:GPU 之间与 GPU 到存储的高速 fabric(单端口 400 Gb/s 乃至 800 Gb/s)、用户与应用的接入网络、节点与主机操作系统的控制面、交换机管理网,甚至冷却系统、PDU 监控与串口控制台服务器各有独立网络,DPU 自身还带有专属管理接口。每一个平面都需要被路由、被限流、被防护——这正是应用交付功能的用武之地。
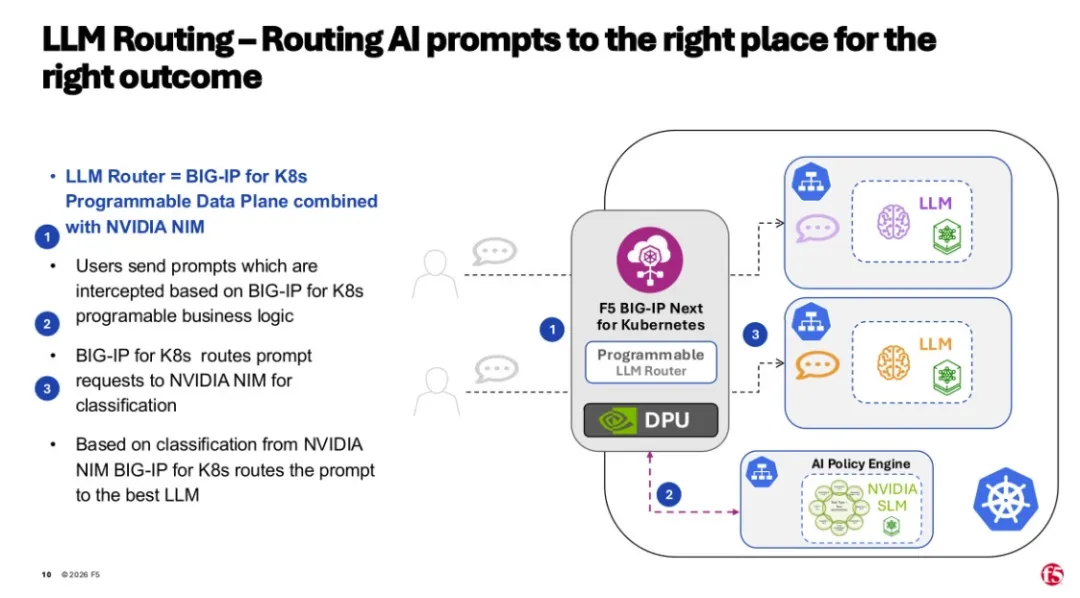
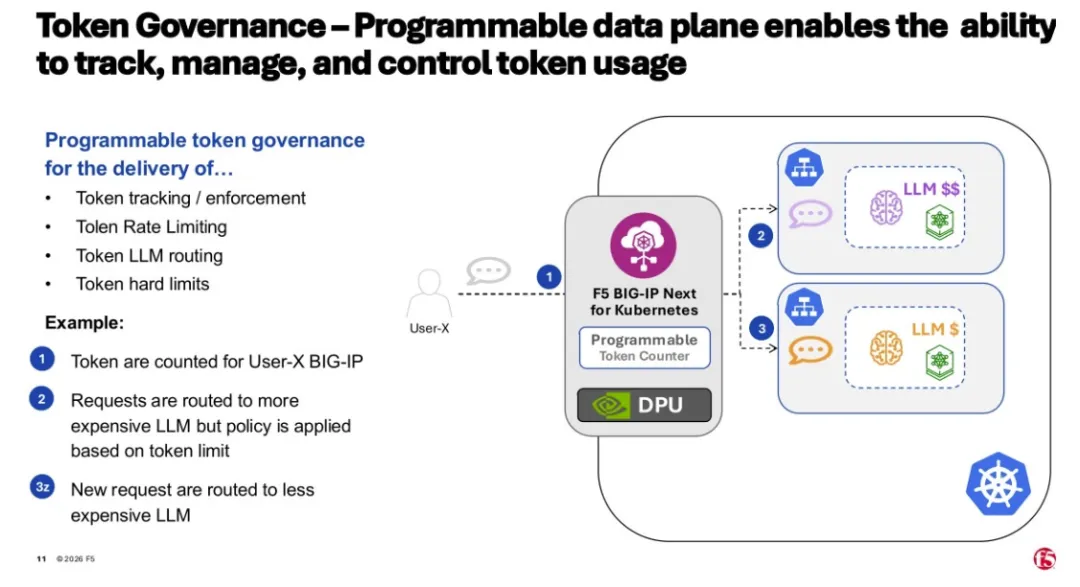
LLM 推理使七层网关的负载模型发生了质变。传统 Web 业务的七层负载以请求数计量;推理业务的每个请求在服务端展开为长时连接与持续的 token 流,路由、限流、认证与加密终结的开销随用户数与 token 量增长,而不随 GPU 数量增长。这类负载全部落在南北向路径上——用户与外部服务进出集群的流量,正是 Scale-In 层的定义范围。它们需要一个不与 GPU 争抢主机核、又在网络路径上的承载位置,而 Scale-In 层的承载器件就是 DPU。
BNK 部署在客户端与 GPU 基础设施之间——这正是 Scale-In 层的位置:所有进出推理集群的南北向流量在此终结协议、执行策略。其功能构成如下:
测试集群的构成同样值得记录:GPU 服务器为 Supermicro 平台、NVIDIA H100(Hopper)代 GPU,每台配置 2 颗 BlueField-3 DPU;两台 2U 管理服务器各配置 8 颗 DPU;流量由 Keysight IxNetwork 与 CyPerf 负载发生器生成,单台能力超过 1.6 Tb/s;辅助连接使用 ConnectX-7 四端口 50 GbE 网卡。这一配置说明七层网关卸载对 DPU 数量的需求可能超过「每服务器一颗」的直觉——管理面集群的 DPU 密度达到每 2U 八颗。
量化数据来自两组来源,口径不同,需分别对待:
第一组是 Tolly Group 独立基准(报告编号 226104,2026 年 3 月):同等负载下,BNK 运行于 BlueField-3 约占用 2 个主机核,开源方案 HAProxy 运行于主机约占用 12 个核。单台服务器释放 10 个核看似有限,但其价值在规模上累加——跨越成百上千个推理节点时,释放的算力相当于可观的额外服务器容量。这一算术在当前周期格外有分量:服务器 CPU 供应在 2026 年至 2027 年持续紧张,释放的核是稀缺资源。
第二组是 F5 自行给出的基准口径:在 GPU 显存占用达到峰值的场景下,将路由功能卸载至 DPU 可使推理吞吐提升约 3 倍。其机理解释是直接的——显存峰值意味着 GPU 已无余量处理抖动,主机侧网关引入的任何调度延迟都被放大;卸载后网关处理与业务负载隔离,抖动来源消除。
本次展示中值得单独讨论的是对 MCP(Model Context Protocol)服务器流量的防护。智能体工作流的本质是自动化执行工具调用序列:模型在推理过程中频繁访问外部工具、检索与数据服务,这些访问以 MCP 协议在主机与外部服务之间高频往返。由此,AI 推理集群的攻击面不再止于 GPU 端点,而是延伸到连接它们的编排层。
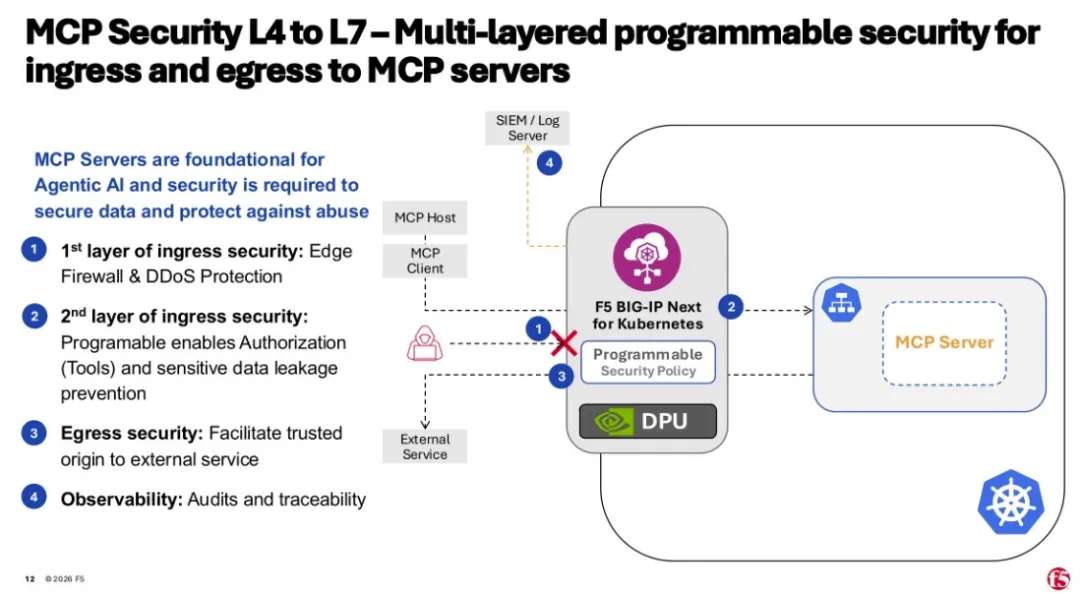
BNK 对 MCP 流量执行四至七层防护,覆盖边缘防火墙、DDoS 缓解、授权执行、响应中敏感数据防泄漏,以及对外部服务出口流量的全程审计追踪。这组能力放在 Scale-In 层的网关(DPU 上的统一执行点)而非各业务节点内实现,有一个结构性理由:MCP 流量的策略一致性要求所有出口经过同一执行点——分布式地在每个节点内实现,策略漂移与审计断点几乎不可避免。
把这一事件放回 Scale-In 层的框架中,其位置一目了然。此前本系列分析中,DPU 在 Scale-In 层的承载清单包括:协议终结点(NVMe-oF、对象、RDMA)、KV 上下文元数据管理、租户隔离与安全策略执行。本次展示新增了一类:七层推理网关——以 token 为单位的流量治理。
七层网关对承载位置的三个要求,恰好逐一对应 DPU 的结构特征:其一,功能需位于主机信任域之外——DPU 天然满足;其二,需要独立于业务负载的算力与内存——DPU 具备通用核与独立内存子系统;其三,必须在网络路径上以保障策略一致性——DPU 就在路径上。三种替代形态各缺一项:主机软件缺第一项,专用设备缺与集群的集成密度, SmartNIC 类方案缺第三项所需的完整软件栈。作为规模背景,NVIDIA 2026 财年数据中心网络业务收入为 314 亿美元,同比增长 142%——DPU 随加速器出货成为标配组件的趋势已由财务数据确认。
对国内智算基础设施而言,这一案例给出三个可操作的参照:
- 七层卸载是门槛最低的基础设施卸载切入点。
与存储卸载、一致性互联相比,七层网关不依赖最尖端的 SerDes 与内存带宽,主要门槛在软件栈成熟度——这恰是国内基础设施处理器厂商可以最快补齐的维度,且 Tolly 式的核占用对比提供了清晰的量化评价方法。 - token 治理是新的调度与计量维度。
以 token 为单位的限流、配额与审计,是多租户推理运营的原生需求,对应计费与配额体系。将这一能力置于器件层,运营平面与业务平面解耦,是推理平台架构的一个确定性方向。 - 形态上跟随 Kubernetes 原生集成。
BNK 以 Kubernetes 原生形态交付而非传统设备,网关能力随集群编排系统部署与升级。国内同类能力如果以设备形态交付,将在云原生环境遭遇集成摩擦;以 Operator 与自定义资源形态接入编排系统,是可与业务方直接对话的产品形态。
概言之:推理网关的器件化表明 Scale-In 层的承载清单仍在加长。从协议终结、上下文管理到 token 级流量治理,基础设施处理器的职责边界随推理业务形态持续扩展——评价一颗国产器件,也要随之增加一个维度:它能否在主机信任域之外,承载以 token 为单位的治理与安全。