ARTICLE · 1147099
论文速递 (ACL 2026) | 文档视觉问答中基于流的页面唯一语义映射架构
论文名称
Flow-Based Page Unique Semantic Mapping Architecture for Document Visual Question Answering
论文作者
Haosen Wang, Jing Xiao, Chaochao Du, Xiaowang Zhang*, Zhiyong Feng
作者单位
天津大学软件学院,天津大学国际工程师学院
发表期刊
ACL2026
摘要
Abstract
文档视觉问答(DocVQA)旨在通过联合理解文档图像中的文本、布局和视觉元素来生成答案。尽管端到端视觉生成式方法减轻了对OCR的依赖,但在页面语义复杂且高度相似时难以实现精确证据定位。然而,现有研究缺乏对问题驱动的页面语义表示空间的深入理论分析,未能从根本上解决语义相似页面的可区分性问题。
针对这一理论空白,我们提出并证明:给定问题,每个页面都具有唯一语义,且存在页面到唯一语义的双射。基于此,我们提出基于流的页面唯一语义映射架构(FUMA),将证据定位从相似度检索重构为唯一语义上的精确选择。FUMA采用细粒度跨模态注意力提取判别性线索,并利用基于流的可逆变换与似然正则化学习双射映射,确保每个页面获得唯一语义表示;此外,通过多专家协作机制对页面内细粒度多模态信息进行互补建模,实现鲁棒答案生成。实验表明,FUMA在证据定位和答案生成上均显著优于现有方法.
PART 1
研究动机
针对DocVQA任务,早期研究主要采用基于OCR的流水线方法,通过OCR系统提取文档中的文本内容及空间位置信息,再结合文本理解模型进行答案定位与生成。
然而,该范式存在存在明显不足:一方面,模型性能受OCR质量强约束,识别错误在流水线各阶段逐级传播并放大;另一方面,在多页文档检索、跨页推理及复杂视觉元素理解等场景下,易出现证据定位偏差、推理链断裂及泛化能力不足等问题。
为克服上述局限,近期研究转向端到端视觉-文本生成范式,通过直接从图像到文本的生成过程弱化对OCR的显式依赖,并实现对视觉结构的端到端建模。尽管该方向已取得显著进展,但在处理长文档、多页面场景时仍面临关键挑战:由于证据页面定位基于粗粒度的问题-页面语义相似度匹配,当页面间语义高度相似时难以实现精准定位;进一步地,现有方法对页面内跨模态细粒度特征的建模不足,导致答案生成的准确性与鲁棒性受限。
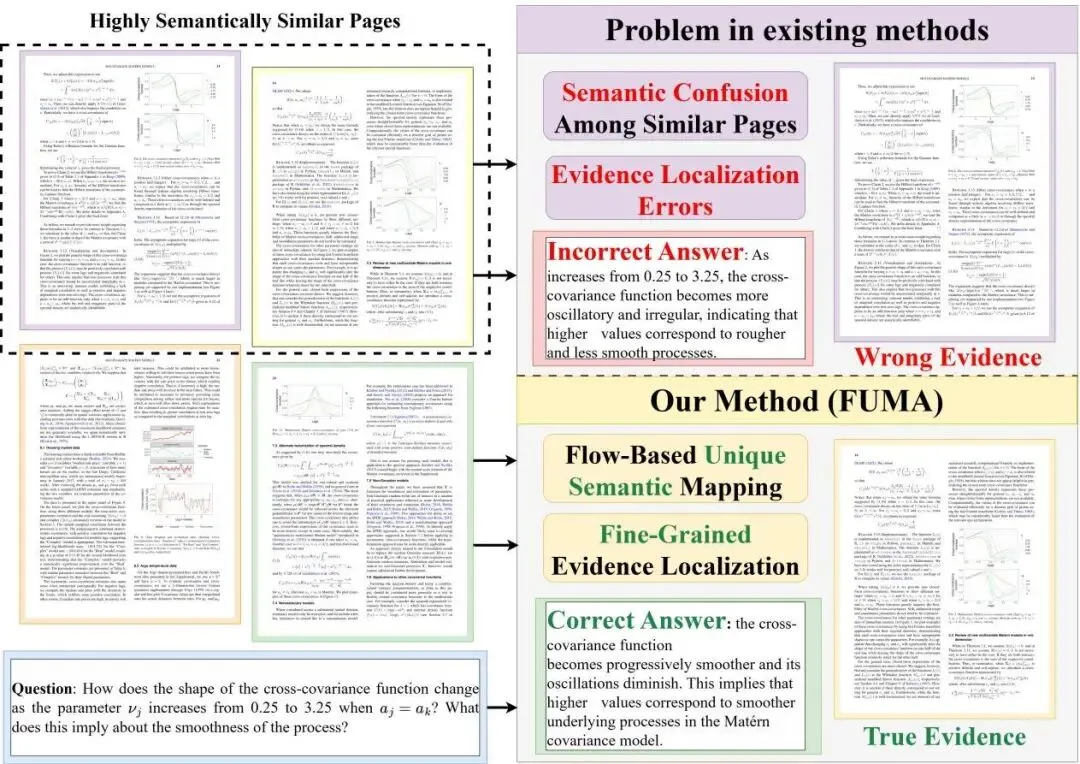
因此,在DocVQA中,挑战不仅来自“语义相似页面的混淆”,更来自一个更本质的问题:问题驱动的证据定位需要一个可分的语义表示空间,即问题条件下的页面语义应具有唯一性与可分性。若每个页面都对应其唯一语义,则不同页面能够在该语义层面被良好分隔,证据页面定位可转化为在唯一语义上的精确选择问题,并为后续答案生成提供稳定、可追溯的依据。
▲图1
现有方法 vs. FUMA:现有方法依赖粗粒度相似度匹配,导致语义相似页面混淆(重叠表示)。FUMA通过流变换建立到唯一页面语义的双射映射,将证据定位从相似度检索转化为在良好分隔语义空间上的精确选择。
PART 2
理论分析
为推动我们的架构设计并为所提框架奠定结构基础,我们对问题条件语义空间的三项关键属性进行了形式化分析:
(1)在问题条件下页面唯一语义是否存在;
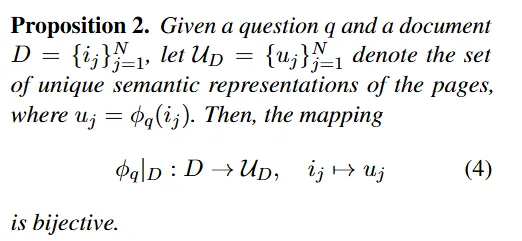
(2)页面到唯一语义的映射是否为双射,保证可逆性与无损表达;
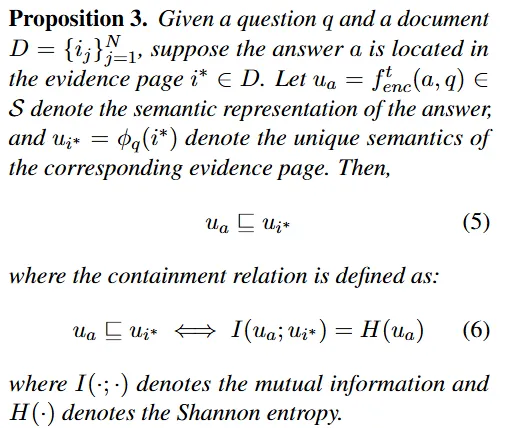
(3)问题答案与证据页面唯一语义间的关系。我们提出并证明以下命题:
▼
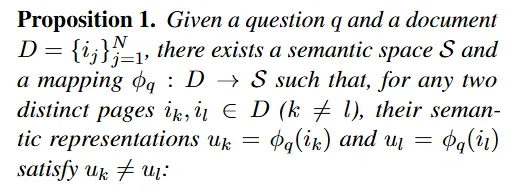
以上三条命题共同构成理论基础:
命题1保证在给定问题q下,每个页面具有唯一且可区分的语义表示;
命题2进一步确保页面与其唯一语义之间存在可逆的双射关系,实现信息的无损映射;
命题3则表明答案语义完全包含于证据页面的唯一语义中。
需要强调的是,以上命题作为设计原则,旨在论证双射、可逆变换的合理性,而非对实际学习得到的神经表征做出形式化保证。具体而言,这些命题刻画了证据定位可简化为适定选择问题的理想条件,并据此指导我们的架构选型。
PART 3
基于流的页面唯一语义映射架构
为满足语义唯一性与双射可逆性,我们采用具有可逆结构的基于流的思想去学习这一映射,提出基于流的页面唯一语义映射架构(FUMA):
一方面通过注意力机制在页面内部选择与问题相关的细粒度跨模态线索,使得模型在语义相似页面之间仍能保留足够的区分证据页的细节;
另一方面通过基于流的似然正则化学习可逆变换路径,克服多页面映射到相似语义的表示坍缩问题,使得每个页面在问题条件下具有独立、可辨识的唯一语义。
进一步地,在基于证据页面唯一语义进行答案生成时,我们引入多专家协同机制,对证据页面内不同模态的细粒度信息进行互补建模与解码生成,从而提升答案生成的准确性与鲁棒性。
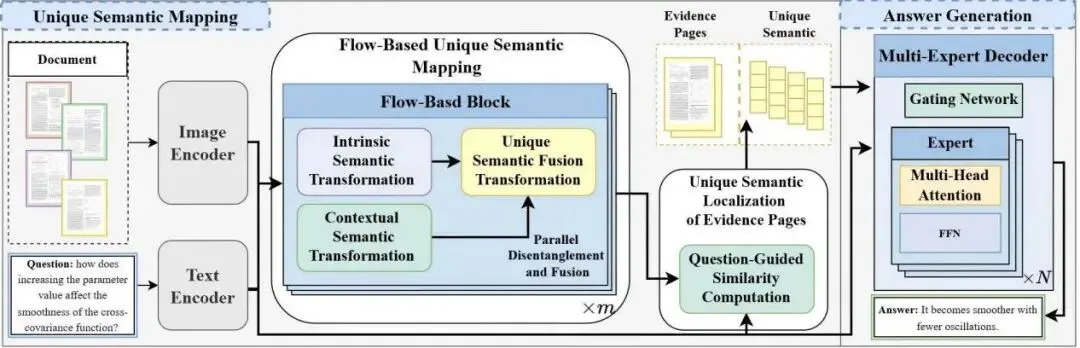
▲图2
基于流的页面唯一语义映射架构
唯一语义映射由m层基于流模块堆叠组成,对页面表示进行逐层变换,最终将页面映射为唯一语义;每个流模块采用“并行解耦-融合”的双路径架构,通过同时建模页面的内在语义与上下文语义,实现页面唯一语义的精细化刻画。
该模块包含三个核心组件:
(1)自身语义变换:在问题引导下提取页面的内在语义特征,聚焦页面关键内容;
(2)上下文语义变换:捕获页面与文档其他页面交互产生的全局语义;
(3)唯一语义融合变换:在问题条件下融合两路语义生成更具判别性的唯一语义。
该设计使模型能够同时建模页面的局部特性与全局定位,增强唯一语义的可区分性.通过对页面语义的层层变换,唯一语义映射将页面表示映射至问题相关的唯一语义空间,使得页面唯一语义在语义层面充分体现页面间的差异性与可判别性。
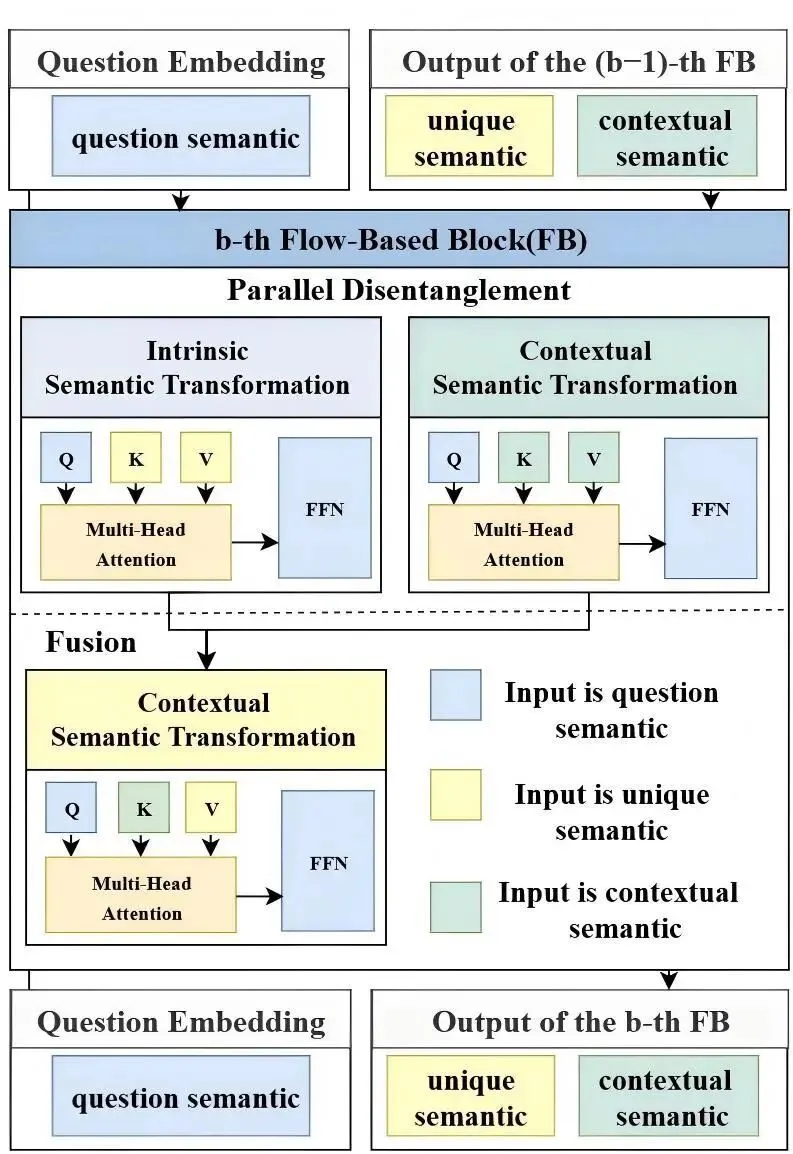
▲图3
“并行解耦-融合”双路径架构的流模块
PART 4
实验验证
我们在四个基准数据集上进行评估并与目前最先进方法进行比较:表1给出了四个基准数据集上的性能比较。FUMA在所有数据集和指标上均取得最优性能。在NiM-Benchmark上,FUMA相较LayoutLMv3在EM、F1和ANLS上分别取得了较高提升,验证了唯一语义映射在多类型文档中的有效性。在长文档基准MMlongBench-Doc上的提升幅度体现了其在复杂多页语义建模方面的优势。在DUDE上的持续领先表明基于流的双射映射能保持细粒度判别能力。在DocVQA上的稳定表现进一步证明了良好的泛化能力。
▼
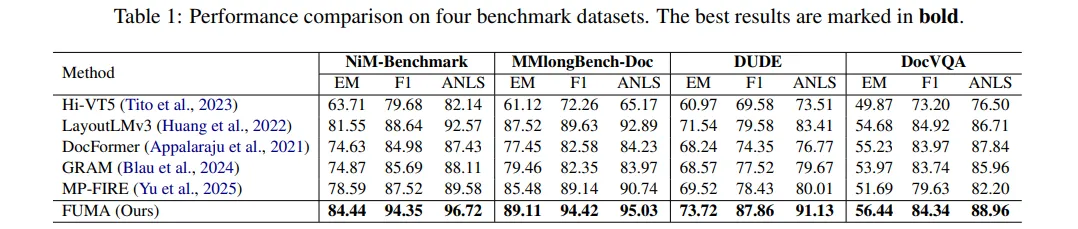
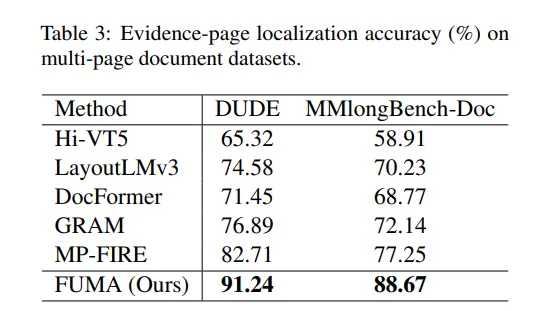
表3显示,FUMA在证据页面定位中显著优于现有方法。这接验证了本文的核心贡献:通过建立从文档页面到问题条件唯一语义的双射映射,FUMA将证据定位从易混淆的相似度检索转化为在良好分隔语义空间上的精确选择,成功解决了语义相似页面难以区分的关键挑战,为后续答案生成提供了稳定可靠的证据基础。
▼
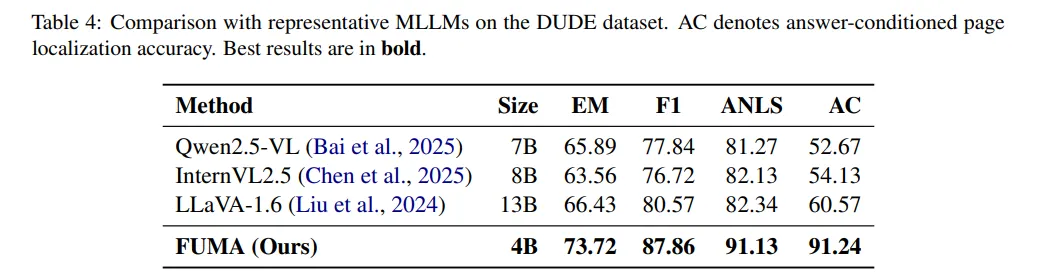
尽管多模态大模型(MLLM)在文档理解基准测试中展现出强大的生成能力与零样本学习性能,但表格结果表明,所有参评的多模态大模型即便在精确匹配(EM)/F1 值上表现不俗,其证据页面定位准确率(AC)却显著偏低。这说明它们常能生成看似合理的答案,却未能将语义精准关联到正确的证据页面。相比之下,FUMA在各项指标上均超越所有对比的多模态大模型,其中定位准确率(AC)相较最优基线模型具有较大提升。改进源于所提出的查询条件语义映射机制,进一步凸显语义双射性在多页文档视觉问答(DocVQA)中的关键作用。
PART 5
总结
本文针对多页DocVQA中证据页面定位的核心挑战展开研究,该挑战源于页面间的语义相似性导致传统基于相似度的检索方法产生混淆。我们通过三条形式化命题从理论层面证明:每个文档页面在给定问题条件下具有唯一的语义表示,且页面与其唯一语义之间存在双射映射。基于这一理论基础,我们提出FUMA,将证据定位重构为在分离良好的唯一语义空间上的精确选择问题,并将基于流的可逆变换模块与多专家协作解码器相结合。在四个基准数据集上的大量实验表明,FUMA在证据定位精度和答案生成质量上均持续优于现有方法。跨骨干网络配置的比较实验以及与代表性多模态大语言模型的对比进一步证实,性能提升源于所提出的语义映射机制而非模型规模,凸显了双射语义学习范式在多页文档理解中更广泛的适用性。
作者介绍
王浩森
王浩森,2024级博士。研究方向:多模态大模型,多模态大模型幻觉缓解,多模态文档视觉问答,多模态视频理解
肖静
肖静,2024级硕士。研究方向:多模态大模型幻觉缓解,多模态大模型内容审核,强化学习。
关于我们
天津大学知识科学与服务工程实验室聚焦人工智能、知识工程、软件工程等核心领域。近年来,实验室以多模态知识表示与推理为主线展开系统研究,研究范畴涵盖大模型的规则学习、知识图谱构建、软件安全、代码生成、多模态理解、多智能体系统、大模型安全及逻辑推理并行系统等方向。实验室在相关基础理论、关键技术与产业应用层面均取得阶段性研究成果。团队致力于为AI大模型建立可表示、可推理与可解释的理论和方法体系,推动大模型性能提升与逻辑可透明化协同演进!
END
作者|王浩森
编辑|杨颖
审核|张小旺
