ARTICLE · 1150762
检查100个候选,而非1000万文档:Elasticsearch 中更快的 kNN 过滤器
检查100个候选,而非1000万文档:Elasticsearch 中更快的 kNN 过滤器
Elasticsearch 现在会针对每个查询自行决定,是在向量搜索之前还是之后应用 kNN 过滤器。在一个包含100万向量的段(segment)上,搜索后检查一个宽泛的 match_phrase 过滤器耗时不到1毫秒,而搜索前检查则需33.4毫秒。在一个包含1000万向量的语料库上,120个基准测试对中有104对显示后过滤(post-filtering)速度更快,且召回率与前过滤(pre-filtering)相差在0.01以内。
knn 子句中的过滤器(例如租户ID或语言)会作为预过滤器(pre-filter)运行,因此它会在搜索开始前对每个段中的每个文档进行评估。当过滤器匹配到足够多的语料时,Elasticsearch 会先执行向量搜索,然后仅对返回的候选结果检查过滤器。候选池的大小会依据统计学原理进行设置,以确保至少有 k 个结果能够幸存。如果幸存结果不足,Elasticsearch 会重试一次,然后回退到预过滤搜索。您的查询保持不变,并且仍然会得到 k 个结果。该功能计划在 Elasticsearch 9.6 中默认启用。
kNN 过滤器在 Elasticsearch 中如何工作
简单回顾一下,Elasticsearch 对于 dense_vector 字段有两种近似最近邻结构。HNSW 是一种邻近图:搜索会从一个邻居遍历到另一个邻居,并将其目前看到的最接近的 num_candidates 个向量作为其波束(beam)。IVF,即 bbq_disk 索引类型,将向量围绕质心(centroids)进行聚类,每个质心都带有其向量的倒排列表(posting list),并扫描最接近查询的倒排列表;它扫描段的比例,即其_访问比率(visit ratio)_,由 num_candidates 和 k 推导得出。关于 HNSW 图 和 DiskBBQ 的文章都对两者进行了深入介绍。
后续所有内容的基础是:两者都不是单一的索引级结构。每个 Lucene 段都携带自己的 HNSW 图或自己的 IVF 倒排列表集,因此 kNN 查询会分别搜索每个段并合并结果,首先在分片内合并,然后在协调节点上合并。因此,搜索在开始探索之前需要准备的任何内容,都需要为每个段准备一次。
现在,让我们在 kNN 查询中添加一个 filter:
1 2 3 4 5 6 7 8 9 10 11 12 POST my-index/_search{ "knn": { "field": "embedding", "query_vector": [0.12, -0.03, ...], "k": 10, "num_candidates": 100, "filter": { "term": { "language": "en" } } }}
由于过滤器位于 knn 子句内部,它是一个预过滤器:这10个结果是在匹配 language: en 的文档中最近的10个文档。为了实现这一点,搜索必须知道它遇到的每个文档是否通过了过滤器。在每个段中,这分两步进行。
第一步:将过滤器物化为位集(bitset)
这两种结构都不是按文档 ID 顺序访问文档的。HNSW 遍历会从节点跳到其图邻居,而 IVF 则一次扫描一个质心的倒排列表,这意味着文档 ID 是按照向量邻近度所决定的顺序到达的。搜索需要能够按需回答“文档 84,219 是否匹配?”,而过滤器的常规 DocIdSetIterator(只能向前移动)无法做到这一点。在搜索开始之前,过滤器会在段上完整运行,并将其匹配结果记录在位集中。对于 HNSW,这在 Lucene 的 AcceptDocs 中完成:
1 2 3 4 5 6 7 // org.apache.lucene.search.AcceptDocsprivate void createBitSetAcceptDocsIfNecessary() throws IOException { if (acceptBitSet == null) { acceptBitSet = Objects.requireNonNull(createBitSet(iterator(), liveDocs, maxDoc)); cardinality = acceptBitSet.cardinality(); }}
createBitSet 会将过滤器的迭代器耗尽,并根据匹配文档的数量,填充一个大小为段 maxDoc 的 FixedBitSet 或一个稀疏位集。IVF 在扫描其第一个倒排列表之前,会通过 Elasticsearch 自己的 ESAcceptDocs 执行等效操作。无论哪种方式,成本都取决于段的大小以及过滤器评估的代价,而不是搜索将要访问的段的比例。
第二步:跳过未通过过滤器的文档
未通过过滤器的文档不计入结果。搜索必须访问段中更多的文档才能收集到足够多的通过文档:HNSW 会沿着图走得更远,而 IVF 会扫描一些额外的倒排列表。两者都保持了这一点有界。例如,HNSW 一旦访问了与过滤器匹配数量相同的向量,就会停止遍历图,并直接对匹配的文档进行评分。对于匹配语料库大部分内容的过滤器,额外的工作量很小,如下一节的性能分析所示。
要点是:由过滤器引起的额外搜索工作是有界的,并且很少成为过滤查询时间的主要去向。第一步中的物化(materialization)没有这样的界限。这就是为什么有趣的情况不是限制性过滤器,而是宽泛的过滤器,例如匹配语料库90%的情况。它几乎没有剪枝,也增加了很少的搜索工作,但仍然在每个段中以全部代价进行物化。
为什么经过过滤的 kNN 搜索可能比未过滤的更慢
搜索性能分析直接显示了这一成本,尽管可能不在您首先寻找的地方。
Lucene 的 kNN 查询几乎在 rewrite 中完成所有工作。对于 HNSW,AbstractKnnVectorQuery#rewrite 会物化过滤器,搜索每个段,合并每个段的结果,并返回一个包含最终文档 ID 和分数的 DocAndScoreQuery。IVF 执行相同的操作,并返回 Elasticsearch 的 KnnScoreDocQuery。当查询在通常意义上执行时,搜索已经结束,剩下的只是返回一个预先计算好的命中列表。
顶层 knn 子句在 DFS 阶段运行,因此其性能分析位于 profile.shards[].dfs.knn[] 下。以下是一个针对包含一百万个向量的单个 HNSW 段,使用 k: 10 和 num_candidates: 100 的未过滤搜索,每个分解项都被裁剪到其非零条目:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 { "dfs": { "knn": [ { "vector_operations_count": 2378, "query": [ { "type": "DocAndScoreQuery", "description": "DocAndScoreQuery[177025,...][0.7580181,...],0.7580181", "time_in_nanos": 5708, "breakdown": { "create_weight": 1250, "build_scorer": 2583, "next_doc": 1041, "score": 834, ... } } ], "rewrite_time": 5158917, "collector": [...] } ] }}
rewrite_time,5.2 毫秒,就是 kNN 搜索。DocAndScoreQuery 条目耗时不到 6 微秒:它只返回这十个命中文档。
现在添加一个匹配 90% 文档的 match_phrase 过滤器。一个匹配几乎整个语料库的短语在实践中并不是常见的过滤器,但它能清晰地隔离出这种效果:它几乎没有缩小搜索范围,而且评估起来代价高昂。大多数匹配如此广泛的实际过滤器,其成本介于这个过滤器和我们稍后比较的 term 过滤器之间。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 { "dfs": { "knn": [ { "vector_operations_count": 2682, "query": [ { "type": "CachingEnableFilterQuery", "description": "(ConstantScore(body:\"red fox\"))^0.0", "time_in_nanos": 33595666, "breakdown": { "create_weight": 9125, "build_scorer": 174083, "next_doc": 15708, "into_bit_set": 33396750, "into_bit_set_count": 1, ... }, "children": [ { "type": "PhraseQuery", "description": "body:\"red fox\"", "time_in_nanos": 33589916, "breakdown": {...} } ] }, { "type": "DocAndScoreQuery", "description": "DocAndScoreQuery[163399,...][0.7200494,...],0.7580181", "time_in_nanos": 4092, "breakdown": {...} } ], "rewrite_time": 40076834, "collector": [...] } ] }}
有三处变化:
• 过滤器有了自己的条目,与 DocAndScoreQuery并列而非在其内部,因为它在 kNN 查询的重写(rewrite)期间运行。CachingEnableFilterQuery是 Elasticsearch 在 kNN 过滤器周围放置的包装器,以使查询缓存始终认为它们值得缓存;您编写的查询是其子项。在bbq_disk字段上,条目名称不同,但过滤器显示方式相同。• into_bit_set是第一步中的物化过程:一次调用,在整个段上运行短语查询,并将每个匹配记录在位集中。耗时 33.4 毫秒。这部分时间包含在rewrite_time中,而不是额外增加的;rewrite_time从 5.2 毫秒增加到 40.1 毫秒,其中过滤器占了 33.6 毫秒的差异。(匹配比例低于约 1/128 文档的过滤器会一次一个文档地收集到稀疏位集中,因此其成本显示在next_doc下。)• vector_operations_count几乎没变。它上升了 13%,大致相当于每十个被访问的文档中就有一个未能通过过滤器时的预期增幅。
此查询超过 80% 的时间用于评估过滤器。在阅读此类性能分析时,需要记住一点:性能分析会绕过查询缓存,并且分析结果总是显示过滤器未缓存的成本,即使对于未分析的请求会在缓存中找到的过滤器也是如此。
kNN 过滤器成本:物化与额外搜索工作
这两个性能分析之间的差异由两种成本构成,值得将它们分开,因为它们的扩展方式不同。
过滤器物化 在任何向量工作之前,按段支付,与段大小成比例。其成本完全取决于查询类型:
term | intoBitSet |
range | index: false)的字段才需要检查每个文档 |
match_phrase | |
bool | |
在上述一百万个文档的段上,一个匹配同样 90% 文档的 term 过滤器在 into_bit_set 中花费约 0.3 毫秒,比短语过滤器快约 100 倍。而且成本随段增长:在下面的基准测试中,一个匹配 10M 文档段 90% 的 match_phrase 过滤器,会使 HNSW 查询耗时从 2.3 毫秒增加到 395 毫秒。
额外搜索工作 会在其上增加一些成本,但正如我们所见,它是有界的,并且对于宽泛的过滤器来说,这部分成本很小:即上面的 13%。物化占主导地位,因此,对于宽泛且昂贵的过滤器,经过过滤的 kNN 搜索可能会将其大部分时间花费在与向量比较无关的工作上。它得出的答案与未过滤的答案也有很大重叠:如果一个过滤器匹配语料库的 90% 并且与查询无关,那么整体上最接近的十个邻居中约有九个已经通过了它,而那些未通过的则被排名仅靠后几位的文档所替代。
这就是本文其余部分要讨论的不对称性。过滤器的成本与其评估所覆盖的文档数量相关,而在向量搜索之后而非之前进行评估,会使这个数量发生数量级的变化:
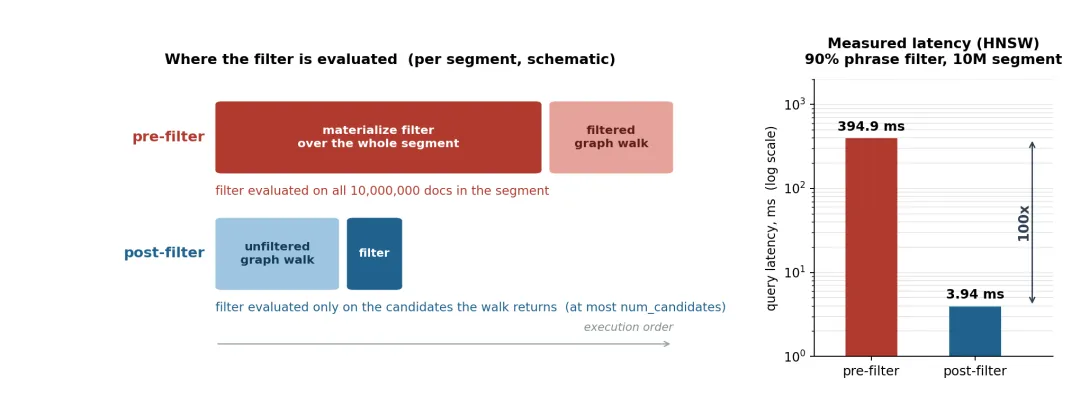
预过滤在向量搜索之前对段中的每个文档评估过滤器;后过滤仅对向量搜索返回的候选结果评估过滤器。
kNN 搜索中的预过滤与后过滤
如果我们直接进行后过滤呢?这个观察并不新鲜,Elasticsearch 一直允许您这样做。将过滤器移到 knn 子句_外部_,它就变成了一个后过滤器(post-filter):kNN 搜索无约束地运行,过滤器应用于它返回的 k 个结果上。
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 POST my-index/_search{ "query": { "bool": { "filter": { "term": { "language": "en" } }, "must": { "knn": { "field": "embedding", "query_vector": [0.12, -0.03, ...], "k": 10, "num_candidates": 100 } } } }}
我们在 如何在 Elasticsearch 中选择精确与近似 kNN 搜索 中详细讨论了这种权衡,其中的缺陷被直白地指出:
在 kNN 中使用后过滤器的问题在于,过滤器是在我们收集到 top k 结果_之后_才被应用的。这意味着我们最终可能得到少于 k 个的结果,因为我们需要从已经通过 HNSW 图检索到的 top k 结果中移除那些未通过过滤器的元素。
请求 10 个,却得到 6 个。或者 2 个。或者 0 个。向量搜索不知道过滤器的存在,因此没有任何机制保证它的 10 个结果能通过过滤器。您唯一能做的就是手动过度收集:请求 k: 50,并希望有 10 个能幸存。这会让您陷入两难的境地:
• 您必须猜测一个乘数,而正确的猜测取决于您的过滤器对_这个特定查询_的选择性如何;这通常是您无法预知的。 • 猜得太低,您会静默地返回不完整的结果集。猜得太高,您会为不需要的探索买单,而这正是您试图避免的成本。 • 无论哪种方式, k都不再是 API 所表达的含义,因此分页、size以及任何下游操作都必须单独考虑。
因此,两个选项都不尽如人意。预过滤是正确的,但可能病态地慢。后过滤很快,但将统计问题转移给了用户,并且仍然无法提供保证。
下表比较了这两个选项与下一节中介绍的自动后过滤。
knn | knnbool 查询中 | knn | |
k 个结果 | |||
k 的乘数 | |||
但我们能做得更好
关键在于,这两者之间的选择不必由用户来做,也不必为整个索引一次性决定。Elasticsearch 在重写(rewrite)时持有过滤器的 Weight。它可以估计过滤器的选择性,决定对于_此查询在此分片_上后过滤是否值得一试,根据该估计而不是猜测来确定过度收集的规模,并在其下保持一个正确性保障网,以便糟糕的估计只会牺牲延迟而不会损害结果。
这就是自动后过滤为 HNSW 和 IVF (bbq_disk) 增加的能力。重要的是,这些都不会改变您编写的查询:您仍然表达一个预过滤器,您仍然获得预过滤语义,而如何满足这一要求成为引擎的决策。
按顺序有四个想法:
1. 估计过滤器的选择性。 2. 使用它来确定过度收集的规模。 3. 如果结果不足,重试一次。 4. 如果仍然不足,回退到原始查询。
估计 kNN 过滤器选择性
首先,我们需要一个数值来表示“该过滤器允许通过语料库的比例是多少?” 一个廉价且出乎意料有效的方法是询问过滤器自己的打分器(scorers)预期匹配多少,然后除以该字段实际索引的向量数:
1 2 3 4 5 6 7 8 9 10 11 public static float computeSelectivity(Weight filterWeight, List<LeafReaderContext> leaves, int totalVectors) throws IOException { long filterCost = 0; for (LeafReaderContext leafCtx : leaves) { ScorerSupplier ss = filterWeight.scorerSupplier(leafCtx); if (ss != null) { filterCost += ss.cost(); } } return totalVectors > 0 ? Math.min(1f, (float) filterCost / totalVectors) : 0f;}
有两件事使其成本低廉。ScorerSupplier#cost() 是一个_估计值_。对于 term 查询,它是从元数据读取的倒排列表长度,因此我们无需物化任何内容即可获得它。分母是来自编解码器(codec)的向量计数,而不是 maxDoc,因此只有部分文档拥有的字段不会使比率失真。
有两件事使其不完全准确,而这两点都在下游处理,而不是被假装不存在。cost() 是连接(conjunctions)的上限,选择性可能被高估。更根本的是,选择性是分片的_全局_属性,而真正重要的是过滤器在查询向量邻域内的通过率。对于与向量内容无关的过滤器,两者是匹配的。对于与向量内容相关的过滤器,它们可能在任何方向上产生偏差。
假设 language: en 匹配一个分片的 90%。对于英文查询,几乎所有最近的邻居都是英文的。因此局部通过率接近 100%,全局估计只是保守的。对于西班牙语查询,最近的邻居可能由 10% 的非英文文档主导,局部通过率可能远低于 90%,即使全局估计没有改变。第二种情况正是下面的重试和回退轮次存在的意义。
使用二项式模型确定候选池大小
给定选择性 p,未过滤的搜索应收集多少原始候选 m,才能获得至少 k 个幸存者?
最简单的答案是 m = k/p。这使您_平均_获得 k 个幸存者,这意味着大约有一半时间会不足。平均值在这里是错误的工具:我们需要一个高概率保证。
因此,将每个候选者独立地以概率 p 通过过滤器来建模。那么 m 个候选者中幸存者的数量是一个二项式变量:
X ~ Binomial(m, p),E[X] = mp,σ = sqrt(mp(1-p))
现在,不是要求均值等于 k,而是要求 k 位于均值_下方_ Z 个标准差处:
mp - Z*sqrt(mp(1-p)) ≥ k
精确求解 m 会得到一个二次方程。将 m ≈ k/p 代入方差项,则得到一个稍微保守的闭式解,而这正是正确的错误方向:
m = ceil( (k + Z*sqrt(k(1-p)/p)) / p )
Z 是一个置信度旋钮:第一轮成功的概率约为 Φ(Z)。实现使用 Z = 2.5,约为 99.4%。
需要明确指出的假设是独立性。我们假设它,因为在没有任何关于过滤器与向量内容相关性的信号的情况下,这是我们_能_假设的唯一东西。下面的重试和回退轮次正是为了覆盖它出错的情况而存在的。
后过滤收集多少额外候选
在代码中,该公式加上其护栏:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 /** * 第 1 轮最小过采样因子。第 1 轮请求的候选数至少是目标数量的这个倍数, * 无论二项式方差公式计算出的结果如何。当选择性接近 1 时,该因子生效, * 因为此时方差项会趋近于 ≈ 0。 */float POST_FILTER_OVERSAMPLE_FLOOR = 1.2f;float POST_FILTER_OVERSAMPLE_Z_SCORE = 2.5f;static double zMargin(int k, float selectivity) { return POST_FILTER_OVERSAMPLE_Z_SCORE * Math.sqrt(k * (1.0f - selectivity) / selectivity);}static int computeScaledK(int k, float selectivity) { double zMargin = zMargin(k, selectivity); double floor = Math.min(Math.ceil(k * POST_FILTER_OVERSAMPLE_FLOOR), NUM_CANDS_LIMIT); return (int) Math.clamp(Math.ceil((k + zMargin) / selectivity), floor, NUM_CANDS_LIMIT);}
1.2 倍的下限很重要,因为当 p→1 时,方差项消失,公式将恰好返回 k,这为极少数确实被过滤掉的文档没有留下任何余量。NUM_CANDS_LIMIT 上限(10,000)防止了非常严格的过滤器请求无限制的候选池。
对于 k=10 且 Z=2.5,由此产生的过采样:
请注意这些数字是多么适中,以及它们如何随着 k 的增长相对于 k 缩小,因为标准差随 sqrt(k) 增长,而均值随 k 增长。在 k=100 且 p=0.55 时,过采样仅为 2.2 倍,而 k=10 时为 3.2 倍。请求 15 个结果而不是 10 个,与在 10M 文档段上物化一个昂贵的过滤器相比,简直微不足道。
还有第二个预算_不能_与 k 混为一谈,搞错这一点很容易意外地重新调整搜索。对于 HNSW,num_candidates 是波束宽度,它是一个独立的旋钮。委派(delegate)保留用户设置的值,并以其下限限制为增大后的 k(比请求的结果数还窄的波束无法让这些结果浮现出来):
1 2 3 static int cappedNumCands(int numCands, int scaledK) { return Math.clamp(numCands, scaledK, NUM_CANDS_LIMIT);}
一个值得指出的结果是:HNSW 委派返回的候选数比增大后的 k 更多。每个段的图遍历都会保留其整个波束(最多 num_candidates 个候选者),并且每个候选者都会针对过滤器进行检查。在 HNSW 上,增大后的 k 主要在 num_candidates 接近 k 时起作用;在通常更宽的波束下,第一轮有充足的候选可供筛选。
对于 IVF,num_candidates 仅在与 k_相对_时才具有意义:编解码器从两者的比率推导出其访问比率。在 k 增长时原样保留 num_candidates 会静默地减少探索,因此 IVF 会按比例缩放它以保持比率:
1 2 3 4 5 6 7 static int numCandsPreservingRatio(int numCands, int k, int newK) { if (k <= 0) { return Math.clamp(numCands, newK, NUM_CANDS_LIMIT); } long scaled = (long) Math.ceil((double) numCands * newK / k); return Math.clamp(scaled, newK, NUM_CANDS_LIMIT);}
当后过滤结果不足时重试
二项式模型校准为约 99.4% 的成功率,并且其独立性假设可能是错误的。因此,第一轮有时会不足。重试轮次是将“通常足够”转变为“足够”的关键。
仅当不足看起来像是运气不好而不是模型错误时,它才会运行。如果第一轮返回的幸存者远少于全局选择性预测的数量,这证明过滤器与查询邻域_相关_;这是二项式模型明确无法处理的情况。更多轮次不会修复错误的模型,因此我们提前退出:
1 2 3 double expectedHits = k * (double) selectivity;double threshold = expectedHits * 0.5;boolean shouldExit = scoreDocsCount < threshold;
幸存者少于预测数量的一半,意味着过滤器对此查询的向量邻域不友好,预过滤是正确的工具。对于 k < 5,该检查会被跳过,因为预期数量太小,比率没有任何意义。
重试不仅仅是使用更大的 k 重新运行;那样会重新找到相同的候选者。它必须搜索_新的_地方,因此它带着三部分状态向前推进:
1 2 3 4 int remaining = expectedBaseQueryDocMatches - scoreDocs.length;int retryK = PostFilterableKnnQuery.computeScaledK(remaining, selectivity);Query retry = postFilterQuery.createRetryQuery(searcher.getIndexReader(), excluded, seedDocsPerLeaf, retryK);TopDocs retryDocs = searcher.search(retry, retryK);
一个排除集。 第一轮中看到的每个文档,无论是通过过滤器的还是未通过的,都会通过 ExcludeDocsQuery 被排除。HNSW 将其组合进接受文档(accept-docs);IVF 将其推入倒排列表迭代,以便编解码器直接跳过这些文档。
种子入口点。 对于 HNSW,从顶层重启图遍历会重走相同的下降路径。相反,重试从最近的第一轮匹配(每个段最多四个)进行种子初始化,以便它从正确的邻域开始并向外探索:
1 int[][] seedDocsPerLeaf = nearestSeedsPerLeaf(matching, MAX_SEEDS_PER_LEAF);
IVF(目前)忽略种子;它已经知道哪些质心最近,只需在跳过被排除文档的情况下重新扫描它们即可。
重新调整大小的目标。remaining 是_幸存者_的缺口。它通过相同的选择性重新输入 computeScaledK,以补偿重试也将遭受的损耗。
只有一次重试。第二次将追逐一个已经被证明模型错误的分布,而下面的回退既更便宜又严格正确。
回退到预过滤
回退轮次使得自动后过滤可以安全地默认启用。如果后过滤未能产生完整的候选池,其结果将被丢弃,并代之以运行原始的预过滤查询。
1 2 3 4 5 6 7 8 if (scoreDocs.length < expectedBaseQueryDocMatches) { logger.debug( "post filtering retrieved only [{}] results, less than the desired [{}] results. Falling back to original query", scoreDocs.length, expectedBaseQueryDocMatches ); return null;}
从 postFilterRewrite 返回 null 会使 rewrite 走普通路径:
1 2 3 Query rewritten = ((Query) innerQuery).rewrite(searcher);this.totalVectorOps += innerQuery.totalVectorOps();return rewritten;
用户的查询就是回退方案。这意味着糟糕的选择性估计的最坏情况是_延迟_(一次浪费的候选收集,然后是您无论如何都会执行的预过滤搜索),而绝不会是结果集不足或错误。正是这个属性使得像 ScorerSupplier#cost() 这样粗略的估计也足够好;它只需要足够频繁地正确,以弥补它错误时的代价。
简而言之,在第一轮之后:
• 如果至少有 k 个候选者通过了过滤器,则返回最近的 k 个。 • 如果通过数量少于预期数量的一半(0.5 · p · k),则提前退出到预过滤查询。 • 否则,重试一次。如果到那时至少有 k 个通过,则返回最近的 k 个;如果没有,则回退到预过滤查询。
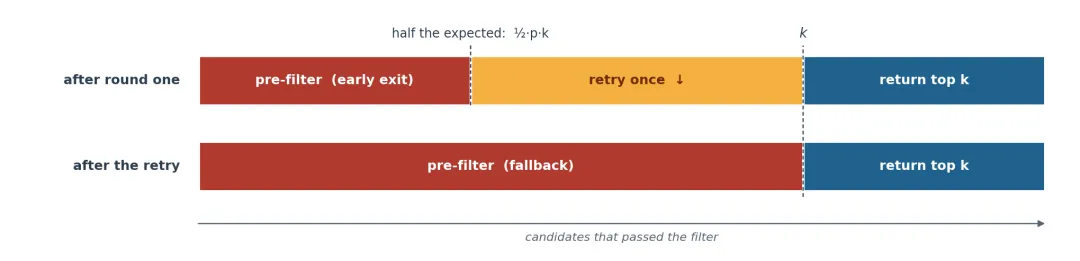
相同的两个检查,每一行对应一轮。每个预过滤结果都精确返回单独使用预过滤所得到的结果。
一个对分数正确性很重要的细节。对于量化字段,近似分数会通过一次精确的重打分(rescoring)过程进行细化。通常,IVF 在其自己的 rewrite 内部执行此操作,但在后过滤委派上,它必须在_过滤之后_发生,否则我们会对即将被丢弃的文档进行重打分。委派跳过它,协调器在候选池最终确定后通过 finalizeTopK 回调。如果没有这个钩子,后过滤结果将携带原始的量化分数,而回退结果则携带精确分数,从而在单次搜索中混合两个分数域。
一个经过过滤的 kNN 查询,端到端
假设您对一个 10M 文档的分片运行此查询,其中 language: en 匹配其中 9M 个文档:
1 2 3 4 5 6 7 8 9 { "knn": { "field": "embedding", "query_vector": [...], "k": 10, "num_candidates": 100, "filter": { "term": { "language": "en" } } }}
1. 重写。PostFilterKnnQuery#rewrite 构建过滤器 Weight,并与 embedding 上的 FieldExistsQuery 连接(conjoin),以便没有向量的文档永远不会被计数,但不执行它。
2. 估计。 对各段的 ScorerSupplier#cost() 给出约 9M 对 10M 索引向量:p = 0.9。这超过了默认阈值 0.7,因此后过滤开启。(如果结果是 0.4,我们将在此停止并运行普通的预过滤查询。)
3. 确定第一轮规模。 m = ceil((10 + 2.5*sqrt(10 · 0.1/0.9)) / 0.9) = 15,因此构建一个无过滤器的委派,请求 15 个结果而不是 10 个。其探索预算遵循上述规则:在 HNSW 上,num_candidates 保持在 100,即波束宽度;在 IVF 上,它按比例缩放至 150,以保持访问比率不变。
4. 无过滤器搜索。 委派在没有接受文档位集的情况下跨所有段运行:没有过滤器物化,也没有额外探索。每个段保留其自身搜索收集的每个候选者,因此协调器无需重新推导它们。在 HNSW 上,这是段的整个波束,最多 100 个候选者;在 IVF 上,这是请求的 15 个候选者的小倍数,因为 IVF 会过度收集以吸收出现在多个倒排列表中的文档。
5. 对候选者应用过滤器,而非对 1000 万文档。applyFilter 按文档 ID 顺序遍历每个段的候选者,并通过 Lucene#asSequentialAccessBits 测试它们。对于暴露 TwoPhaseIterator 的过滤器,每个候选者进行一次近似(approximation)推进,并在近似落在其上时进行一次 matches() 调用。这就是关键所在:过滤器对每个候选者评估一次,而不是对段中的每个文档评估一次。
这也意味着过滤器不再需要为了快速而缓存。使用预过滤时,避免每次查询都为物化付费的常用方法是过滤器缓存,它存储过滤器每个段的位集以供重用。这只有在过滤器被足够频繁地看到并被缓存后才有帮助,而且每个新段都以冷启动开始。后过滤没有值得缓存的东西:applyFilter 告诉过滤器它将被检查的候选者有多少,而 Lucene 的查询缓存会拒绝为一个匹配数百万文档但其中只有一小部分会被查看的过滤器构建位集。过滤器在首次使用时与在第一百次使用时一样快。
6. 对照目标进行检查。 目标是用户要求的 10 个结果。对于一个通过 90% 文档的过滤器,大约十分之九的候选者会通过,远远超过跨段的 10 个。我们去重并保留最近的 10 个。
假设相反,只有 7 个不同的候选者通过了,这可能发生在过滤器与查询相关时,例如前面提到的西班牙语查询。7 高于敌意过滤器阈值(10 × 0.9 × 0.5 = 4.5),因此触发重试:排除所有已经看到的候选者,无论是否通过,从每个段最多 4 个最近通过候选者进行种子初始化,并请求 computeScaledK(3, 0.9) = 5 个更多结果以弥补 3 个的缺口。如果仍然不足 10 个,则运行预过滤查询,后过滤除了候选收集之外没有任何成本。
7. 最终确定。 通过 introselect 按分数选择 top k,并将结果包装在 KnnScoreDocQuery 中。
过滤器仅对向量搜索返回的候选者进行了评估,而不是对一千万个文档。向量搜索不受约束,返回的文档与预过滤会找到的 10 个相同,并保证如果它们不是,您将会得到预过滤的答案。
在多达 10M 向量上的后过滤与预过滤基准测试
基准测试设置
为了测量这里的上限,我们进行了强制比较:每种配置执行两次,一次预过滤,一次后过滤,绕过自适应逻辑,以便两种策略都不能向对方退出。这是对生产行为进行故意更严格的测试;真实实现会针对每个查询进行选择并回退,但它描绘出了每种策略各自获胜的领域。
网格: 5 个数据集,从 523K 到 10M 向量,每个数据集都用 IVF 和 HNSW 索引,采用单段和多段布局,针对 5 种过滤器类型在 7 种选择性下,分别以预过滤和后过滤运行:5 × 2 × 2 × 5 × 7 × 2 = 1400 次测量,或 700 个匹配的预/后对。七种选择性是 0.55、0.7、0.8、0.9、0.95、0.99 和 1.0,其中 其中 1.0 意味着无过滤器。固定参数为 num_candidates=1000、k=10、1% 的访问比率、过滤器不缓存、每个数据点运行 300 个查询。IVF 使用 clusterSize=384;HNSW 使用 m=16、efConstruction=200;全程使用 1 比特量化。
过滤器均未缓存。这是预过滤的冷启动场景:若过滤器缓存已预热,则会缩小那些跨查询重复使用的过滤器之间的差距。对于后过滤来说,这也是唯一可能的场景,因为它在本质上从不依赖缓存。
并非每个数据集都有可供 range、term 和 phrase 过滤器定位的数值、关键字或文本字段。如果缺少,我们会手动添加并用随机内容填充。然后,我们对语料库进行采样,以选取能够匹配目标 D% 文档的过滤器值:
• range是对数值字段的区间查询,其边界经过设置,使 D% 的文档落入该区间。• term匹配 D% 文档所共同拥有的一个关键字值。• phrase是对文本字段的短语查询,用于匹配 D% 文档都包含的一个短语。评估它需要检查词项位置,而不仅仅检查词项是否存在,这使得它在所有这些过滤器中物化成本最高。• range_term在一个bool查询中组合了一个range和一个term过滤器。• random匹配随机选择出的 D% 文档。
跨语料库大小和过滤器类型的结果
对于过滤操作而言,数据集最重要的属性是其大小,因为物化一个过滤器的时间成本与每个段中的文档数量成正比。我们使用这五个数据集来展示随着语料库增长,两种策略的对比情况,并从最大的数据集 cohere-msmarco-10M(10M 向量,1024 维,float32)中提取下面的详细数据。
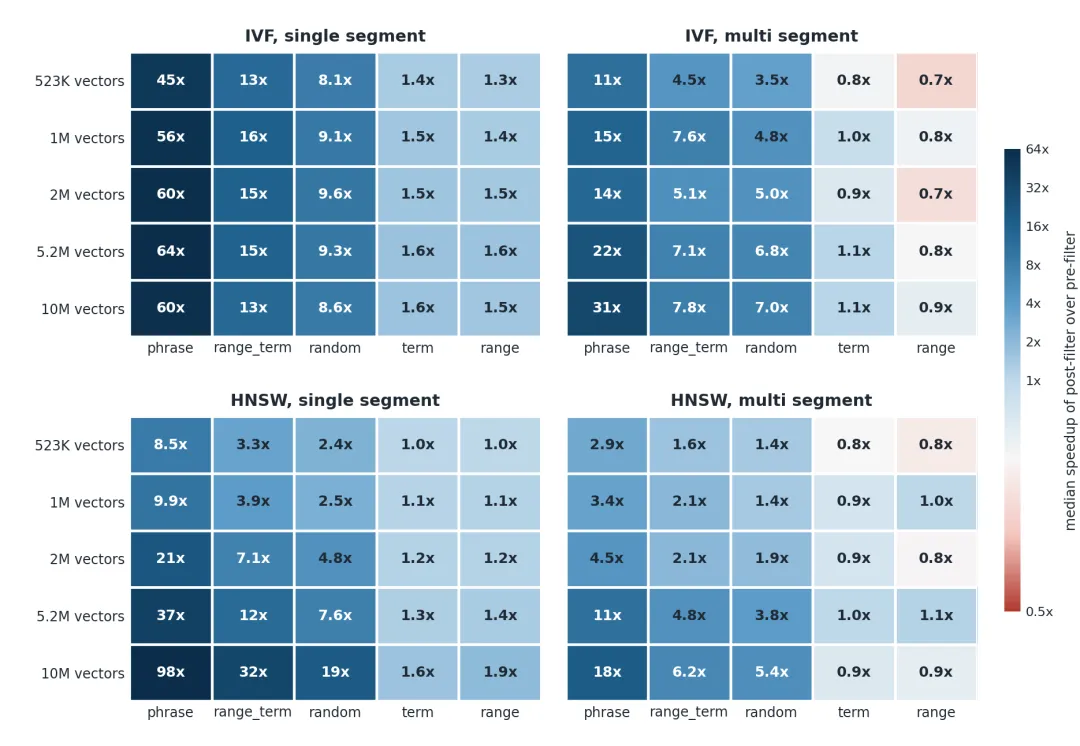
按语料库大小划分的、选择性低于 1.0 时后过滤相对预过滤的中位加速比。蓝色表示后过滤更快,红色表示预过滤更快。
后过滤几乎在所有情况下都胜出:在每种语料库大小、两种索引类型、两种布局下均是如此。领先的幅度取决于过滤器物化的成本,而且在大多数布局中,随着语料库的增长,差距会扩大。100 个单元中仅有 16 个低于 1.0 倍,它们都是多段布局上的廉价 term 或 range 过滤器,最低为 0.68 倍。
在 cohere-msmarco-10M 数据集上,120 个过滤测试对中有 104 个通过后过滤实现了更快的速度,其中包括单段布局上的全部 60 对,另有 2 对为平手(差异在 2% 以内)。其余 14 对是多段布局上的廉价 range 和 term 过滤器,预过滤在这些场景下最多领先 1.33 倍(1.76 毫秒对 2.34 毫秒)。
延迟与选择性的关系曲线直接展示了其机制:
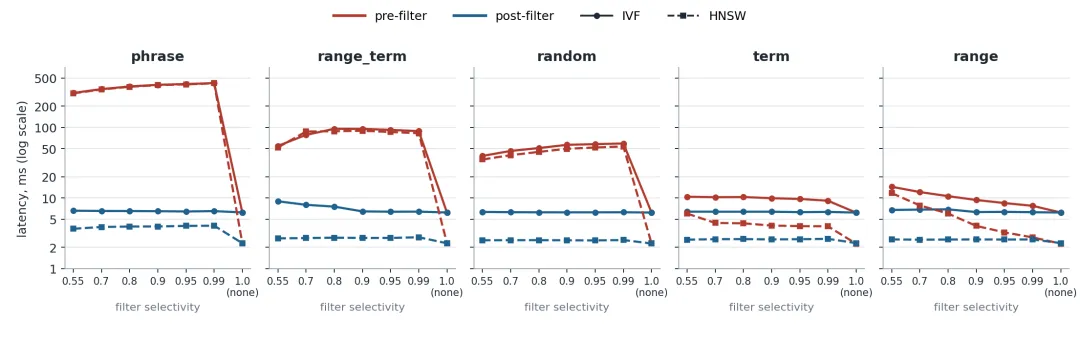
cohere-msmarco-10M 单段上的延迟与过滤器选择性。红色为预过滤,蓝色为后过滤;实线为 IVF,虚线为 HNSW。
蓝色后过滤曲线几乎呈水平状。使用后过滤时,延迟主要由 kNN 搜索本身决定,而该搜索是未经过滤的,因此无论过滤器匹配多少文档,其成本都相同。对候选结果应用过滤器只会增加少量开销,即使过滤器收窄,过度收集的规模也保持较小。对于给定的过滤器类型,延迟对选择性几乎不敏感:在典型配置下,整个 0.55-0.99 范围内的延迟变化约为 10%,而预过滤则约为 50%。红色预过滤曲线位于蓝色曲线之上,差距大致等于物化过滤器的成本,这意味着差距与过滤器的昂贵程度成正比,而所有曲线在 1.0 处汇合,此时没有过滤器可供评估。
召回率基本上与策略无关:所有 140 对测试的召回率差异都在 0.01 以内,因此这一权衡实际上纯粹是延迟问题。
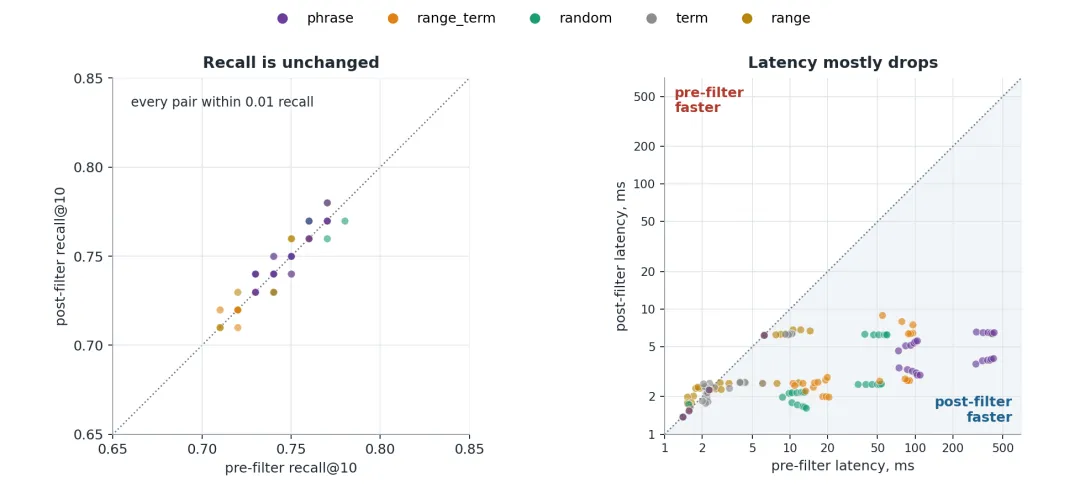
每个点代表 cohere-msmarco-10M 上 140 个预/后测试对中的一个。左侧:召回率。右侧:对数刻度下的延迟;对角线以下的点表示后过滤更快。
局限性:相关过滤器与多段布局
有两个需要注意的方面,值得明确说明。
这些过滤器与向量大体上是不相关的。 基于随机内容构建的过滤器会独立于文档在向量空间中的位置来决定其通过与否,这正是二项式模型所假设的情况。结果也印证了这一点:在任意一组配置内,五种过滤器类型的召回率最多相差 0.04,且在每个选择性水平下中位召回率均为 0.74-0.75。诸如之前 language 示例之类的相关过滤器,则通过重试、提前退出和回退轮次来处理,即使在选择性估计有偏差的情况下也能保证结果正确。衡量加速比有多少能延续到强相关过滤器上,是一个自然的下一阶段基准。
多段布局会缩小后过滤的优势。 对比热力图中的单段和多段面板即可发现。固定的每段成本会被支付更多次,而预过滤的位集在每段较小的 maxDoc 上分摊得更薄。后过滤仍然在昂贵的过滤器上胜出,只是领先幅度变小了。
如何启用和调优自动后过滤
自动后过滤计划在 Elasticsearch 9.6 及即将推出的 Elastic Cloud Serverless 版本中默认启用。一旦启用,您的查询无需任何更改:您仍然在 knn 子句内书写过滤器,而每个分片会针对每个查询独立决定是否值得尝试后过滤。
调优后过滤的选择性阈值
该决策由一个索引设置控制:index.dense_vector.post_filter_selectivity_threshold,默认值为 0.7。当查询的估计选择性大于或等于该阈值时,该查询会走后过滤流水线。因此,该阈值实际上是一个下限,规定了过滤器必须达到多宽泛才能尝试后过滤:
1.0 | |
0.9 | |
0.7(默认) | |
0.0 |
要为某个索引进行调优,如果您的过滤器评估成本往往较高,可以调低该阈值;或者将其设置为 1.0 以完全退出。您可以在索引设置中进行配置:
1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 PUT my-index{ "settings": { "index.dense_vector.post_filter_selectivity_threshold": 0.5 }, "mappings": { "properties": { "embedding": { "type": "dense_vector", "dims": 1024, "index_options": { "type": "bbq_hnsw" } } } }}
适用范围与局限性
以下几点需要了解:
• 适用于 HNSW 和 bbq_disk(IVF) 两种字段,支持float、bfloat16、byte元素类型,以及 HNSW 上的bit向量。• 嵌套向量字段也已支持,但有一个小问题:由于嵌套的 kNN 搜索对每个父文档只保留一个命中,一个已经产生匹配的父文档在重试时会被作为一个_整体块_排除,而一个其子文档仅仅是未通过过滤器的父文档则仍然有资格参与重试——它的更深的子文档可能仍然会通过。 • 查询语义保持不变。 您仍然书写预过滤器并获得预过滤语义。请求体中的任何内容都不会改变;这纯粹是一个执行策略的决定。 • 性能分析(profile)会显示实际采用的策略。 当查询被后过滤时,过滤器条目的 breakdown 中不会出现 into_bit_set:过滤器是逐个候选进行检测的,这意味着它会针对向量搜索返回的每个候选报告一次advance。就前面短语过滤器的例子而言,这相当于 100 次advance调用(波束中每个候选一次),总计远低于 1 毫秒,而不是一次 33.4 毫秒的into_bit_set。此外,还会出现第二个命中列表条目,一个持有最终 topk结果的KnnScoreDocQuery,与向量搜索自身的条目并列。若要查看单个决策(重试、提前退出、回退以及背后的选择性估计),请设置logger.org.elasticsearch.search.vectors.PostFilterKnnQuery: DEBUG。
Elasticsearch 中过滤后 kNN 搜索的下一步计划
我们最感兴趣的改进点如下:
更好的选择性估计。ScorerSupplier#cost() 虽然免费但较为粗糙,而且会高估连接(conjunctions)的成本。Elasticsearch 已经追踪了更丰富的字段统计信息;将这些信息接入,或在一个有界的段切片上对过滤器进行采样,将允许更宽松地设置阈值。
前置检测相关性。 敌意过滤器的提前退出是反应式的:我们只有在花费一轮发现之后,才知道过滤器与查询邻域相关。在投入搜索之前估计过滤器的_局部_通过率(例如,从图下降的种子文档中估计,或从缓存的按查询统计中估计),将把这一过程转变为廉价的预路由决策,并使我们能够安全地降低阈值。
成本感知的路由。 基准测试表明,正确的阈值不仅取决于选择性,还同样取决于过滤器的类型:一个 match_phrase 过滤器在远低于 term 过滤器的选择性水平下就值得进行后过滤,因为其物化成本要高几个数量级。与其仅依赖单一的全索引阈值,一个基于过滤器查询形状的成本模型将使引擎能够逐查询地做出判断。
逐段决策。 当前的路由是分片级别的,但选择性和段大小在段之间可能有所不同。逐段决策将允许在同一查询中,小段进行预过滤而大段进行后过滤。
更广泛的观点可以推广到 kNN 之外。Elasticsearch 已经花费了大量精力来加速向量比较(量化、SIMD、改进的 HNSW 图以及磁盘友好的 IVF 索引),并因此获得了向量比较不再是瓶颈的查询性能提升。当大多数过滤后的 kNN 搜索时间都花在物化一个昂贵的过滤器上时,值得拥有的优化就不是更快的距离函数,而是意识到:要回答关于十个文档的问题,这个过滤器根本不需要运行在千万文档之上。
常见问题解答
在 kNN 搜索中,预过滤和后过滤有什么区别?
预过滤会在向量搜索运行的同时应用过滤器,因此 top k 结果是匹配过滤器的文档中距离最近的 k 个文档。后过滤则是不受约束地运行向量搜索,然后在结果返回后应用过滤器,这虽然更快,但除非搜索首先过度收集候选结果,否则可能返回少于 k 个的结果。
为什么经过过滤的 kNN 查询有时会比未过滤的更慢?
预过滤会在任何向量比较发生之前,为每个段将过滤器物化为一个位集,其成本与段的大小成正比,而不是与搜索实际触及的文档数量成正比。对于一个像 match_phrase 这样的昂贵过滤器,这部分工作可能会主导查询耗时,并且即使过滤器匹配了几乎所有文档、几乎没有排除任何内容,也需要全价支付。
📡 更多 Elastic & AI 可观测性干货
关注公众号「点火三周」,第一时间获取最新技术文章