ARTICLE · 1152269
AI SRE 技术揭秘:Agent 跑到一半被叫停,如何处理 loop?
❝Flashduty AI SRE( https://www.flashduty.com ) 是一个专注 SRE 领域、帮你做故障根因分析、日常运维工作的 AI Agent 产品,注册即可免费试用。这是系列文章《Flashduty AI SRE 技术揭秘》第 3 篇,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。
如果你还没听过 Flashduty,下面的 2min 视频不可错过 👇
手里这批活儿全部收口的那个瞬间,才是可以转身的瞬间。
上一篇讲了"还没开始怎么停":给每轮任务立一块墓碑,停止和开始谁先谁后都不怕。但墓碑只管开工之前。如果 agent 已经跑起来了,模型刚发出十个工具调用、结果才回来三个,这时候用户插了一句话进来——你能立刻停吗?
答案是:不能。随便停,这个会话就直接废了。这篇讲为什么,以及我们的解法:一个叫"工具调用余额"的小算法。
切错位置,会话就"砖化"了
先看清楚 agent 的上下文在协议层面长什么样。模型每发起一轮工具调用,历史里就追加一条 function call;工具执行完,再追加一条配对的 function response。下一轮请求要把整段历史原样发回给 LLM provider。
这里有个硬约束:主流模型 API(OpenAI / Anthropic / Gemini 兼容接口都一样)会校验这段历史的配对完整性。一个 function call 如果没有配对的 response,整个请求直接被拒,返回 400。
所以如果我们在"十个调用回来三个"的时刻把这一轮切掉,落盘的历史里就躺着七个永远不会有 response 的调用。这还不是最糟的——最糟的是这个残缺会一直留在历史里:下一轮请求带着它,400;再下一轮,还是 400。这个会话从此每一次请求都被 LLM provider 拒掉,神仙也救不回来,我们内部管这个状态叫"会话砖化"。
我们在测试里真实复现过这个画面:一次意外在历史里留下了重复的 tool_call id,同一条调用在 wire 上没法被表示两次,注定有一个配不上对——于是每一次后续请求都被 400 打回,会话再也没能恢复。
所以"在哪一行停下来"不是体验问题,是正确性问题:停错位置,代价是这个会话的死亡。
要求"中途停下来"的力量有四种
先盘一下到底谁在要求中断。在我们的系统里,一轮运行(turn)跑到一半,可能有四股力量要求它停:
steer(用户插话):分析跑到一半,用户补充了关键信息:"别查那台机器了,问题在网关"。当前轮应该停下来,把这句话作为下一轮重新跑。 drain(pod 下线):这台机器收到了 SIGTERM 要优雅退出,正在跑的轮次得封存现场,换台机器接着跑。 dispatch(派子 agent):模型刚派发出一个异步子任务。这时候当前轮应该干净地结束——否则模型会原地空转等孩子,我们在一次审计里真实抓到过一个模型 busy-wait 时连续跑了 38 次 echo、14 次date,纯烧 token。await(等子 agent 回答):反过来,子 agent 运行中向父 agent 提问、等待答复,它自己这一轮也该干净结束,挂起等通知。
注意这四种其实分两类:steer 和 drain 是"挂起"——现场保留,之后重跑或换地方续跑;dispatch 和 await 是"结束"——这一轮到此为止,不续了。语义不同,但有一个共同点:它们都必须等同一个时机才能动手。
直觉解法,一个接一个地翻车
解法一:收到信号立刻停。 上面说了,停在工具批次中间 = 会话砖化。pass。
解法二:停的时候给没回来的调用补一条假 response。 我们确实有这样一个修复中间件——请求发出前,给历史里已经存在的悬空调用补一条合成的 response,把砖化的会话救回来。但它的定位是补救历史遗留,不是常规切法。让"先随便切、再缝补"成为主流程,等于主动往历史里塞模型从没见过的假数据,而且它改变不了"切面本身是脏的"这个事实。能一开始就切在整齐的地方,为什么要先切碎再缝?
解法三:看到这条事件里有 response 就停。 接近了,但还不够。模型经常是并行发出一批调用的,而结果是分多条事件陆续回来的:回来 1/3 时停,剩 2 个悬空;回来 2/3 时停,剩 1 个悬空。单看每一条事件都"有 response",但没有一条是安全的切点。
真正的安全点只有一个:当前这批调用全部收口的那个瞬间。要找到它,光看单条事件不够,得跨事件记账。
我们的解法:工具调用余额
算法:每轮运行维护一个计数器,事件里每出现一个 function call 加一,每出现一个 function response 减一;计数器从大于零跳回零的那个瞬间,就是唯一安全的切点。
伪代码如下(真实代码就这么短):
// 单条终态事件对余额的贡献:调用 +1,响应 -1。// 流式增量和纯文本事件不算数,返回 0。funcdelta(event)int {if 是流式增量 { return0 } d := 0for part in event.parts {if part 是 function call { d++ }if part 是 function response { d-- } }return d}// 余额的含义:这批工具调用里还有几个在等结果。// 它恰好在一批工具全部收工时回到 0 —— 唯一安全的切点。funcobserve(event)bool { d := delta(event)if d == 0 { returnfalse } wasOpen := balance > 0 balance += dreturn wasOpen && balance <= 0// "大于零跳回零":一批刚刚收口}// 事件循环:每条事件只记一次账;只在切点上,才按优先级探头看中断信号for event in run {if !observe(event) { continue }switch {case steer(): 挂起,下一轮跑插话case drain(): 挂起,换台机器续跑case dispatched: 结束本轮,等子 agent 的通知case awaiting: 结束本轮,等父 agent 的答复 }}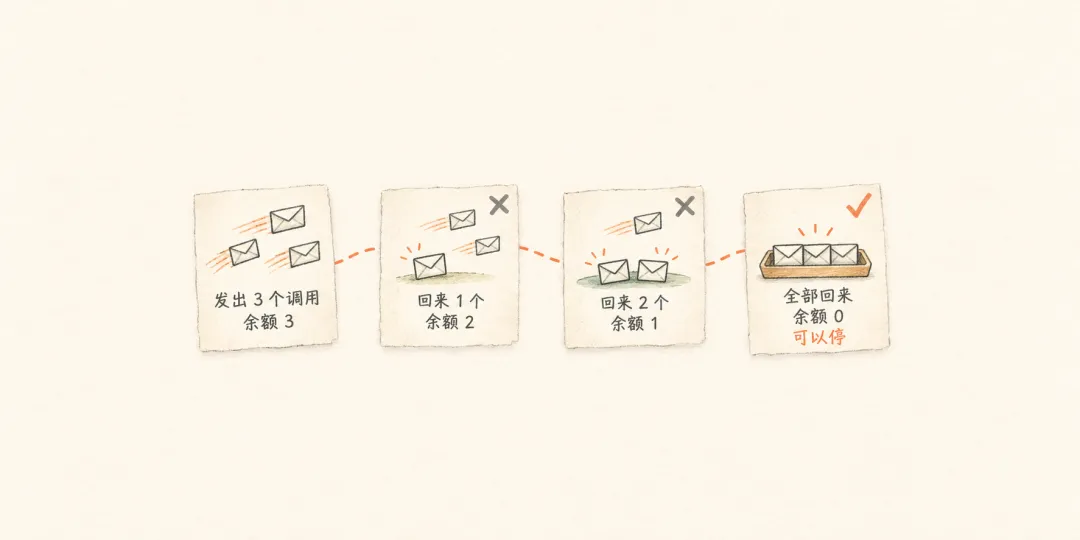
一批三个并行调用的完整生命周期:余额归零之前,任何时刻切下去都会留下悬空调用。
围绕这个算法有几个设计细节。
信号只在跳变点探测。 插话信号藏在 Redis 队列里,每来一条流式事件就去查一次太浪费。余额算法天然给了答案:只在余额跳回零的那一刻去探一次信号,探测频率从"每条流式增量一次"降到"每批工具一次"。
一本账,四个出口。 steer、drain、dispatch、await 四种中断共用同一个余额:每条事件只记一次账;切点到了,再按固定顺序依次询问各自的信号,第一个命中的说了算,排在后面的不再探测。这个顺序就是优先级——插话先于下线,挂起先于结束——写成一个显式的 switch,谁读代码都一眼看得见。(其实还有一种暂停负责长任务工具,但它用自己的挂起台账,不走余额算法,这里不展开。)
不是所有排队消息都有资格插话。 steer 信号不是"队列里有东西就停"。actor 侧探队列时会过一张策略表:消息来源是什么、带不带显式的插话标记,只有真有资格的消息(比如用户补充的信息)才算数。子 agent 的报告、系统的通知,都不会把你的分析拦腰切断。
空 final text 事故:被切的轮和"跑完没产出"长得一模一样
切点解决了,还有个更隐蔽的坑在记账上等着我们。这是 2026 年的一次真实事故。
想一下:一轮被 steer 切掉的运行,从外部看是什么样?——没有最终回复。一轮正常跑完但模型啥也没产出(空 final text)的运行,从外部看是什么样?——也是没有最终回复。两者在结果面上长得一模一样。
而"跑完没产出"在我们系统里是个严肃信号,牵动着一整套下游记账:成本核算、告警、"无最终回复"诊断、还有一套自动补跑的补救阶梯。于是事故发生了:大量被用户主动插话切断的轮次,被当成"真实完成了但没产出"混进了所有这些账本——成本算错了,诊断报警刷了一堆,补救阶梯还试图给这些轮次"补跑",把一个用户明明已经打断的分析又跑了一遍。
修法是显式记账:被切这件事必须在发生的那一刻就盖章,不能让下游靠"看结果面"去猜。实现上是两个记录器,一个在 runtime 侧(一轮运行共享的标记位,被切的瞬间原子地置上),一个在 actor 侧(运行返回后读回这份诊断)。为什么是两个?因为 runner 和 actor 之间隔着一层接口边界,章要盖在边界两侧各自能读到的地方。
章盖好了,下游四个账本各自处置:
补救阶梯跳过:被切的轮不是"没产出",是主动停的,不补跑; "无最终回复"诊断不生成:同上,这不是故障; 自动化轮次账本不写:这轮不算一次真实的自动化产出; durable settle 照写,但打上标记:结束事实落库时带上 reason=steered,并且故意留空最终事件 ID——让它永远不可能被当成"自动化已完成"的证据。
第四点还有个反转插曲。我们曾经想当然地认为"被切的轮连 settle 都不该写",顺手让它也让位了。结果 2026 年出了个事故:被切的轮次占着 IM 里的进度卡片 36 个小时不释放——用户界面上一个分析永远显示"进行中"。最后的修法就是现在这个样子:settle 必须写,但带标记、留空证据字段。**"让位"不是越少写越好,而是每一笔账都要换一种写法如实记。**
取舍与边界
这套机制不是零成本的。
插话的最坏延迟是一整个工具批次。 用户点了插话,agent 不会立刻停,要等当前这批调用全部回来。如果批次里有个慢工具(比如一条要跑十秒的沙箱命令),"停止响应"就是会慢这几秒。这是拿响应速度换会话正确性,我们认为值——没人想要一个"秒停但之后永远 400"的 agent。
余额算法的前提是事件流本身规范。 它防的是"从现在起别再切出新的残缺",治不了历史里已经存在的悬空。那些由更老的 bug 留下的烂账,靠前面说的修复中间件在请求前兜底缝合。两层各管各的:算法保证不产生新伤员,缝合负责救旧伤员。
到这里,"停止"这个主题就完整了:第二篇的墓碑管"还没开始",这篇的余额管"跑到一半"。下一篇换个方向,聊聊 multi-agent 里少有人写的细节:子 agent 扇出之后,父子之间的通信有哪些坑——比如子 agent 中途向父 agent 提问,父 agent 怎么才能数清自己还有几个孩子在跑。
这是 "Flashduty AI SRE( https://www.flashduty.com )技术揭秘" 系列的第 3 篇。我们在做一个专注 SRE 领域、帮你做故障根因分析的 AI Agent 产品,本系列会持续分享我们在 agent 工程上的真实设计、踩过的坑和做过的取舍。