ARTICLE · 1160552
AI工具用多了之后我才明白:切换Agent重复交代背景,才是最浪费时间的地方
第一时间获取精彩技术分享
你有没有过这种场景?
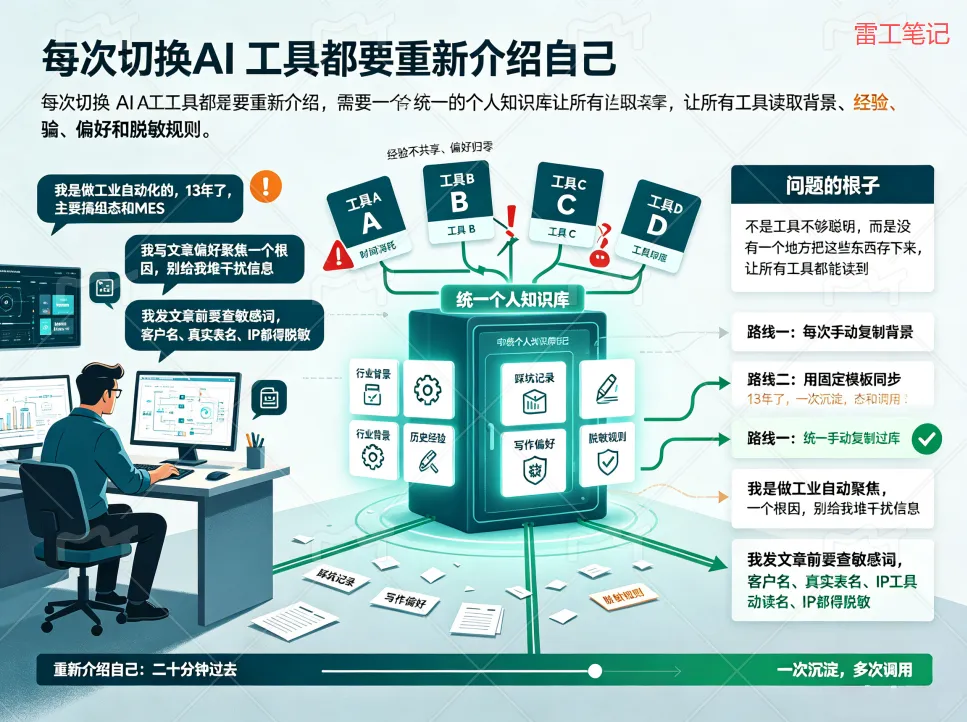
换了一个AI工具,第一件事就是从头介绍自己。
"我是做工业自动化的,13年了,主要搞组态和MES。"
"我写文章偏好聚焦一个根因,别给我堆干扰信息。"
"我发文章前要查敏感词,客户名、真实表名、IP都得脱敏。"
说完这些,大概二十分钟过去了。然后你开始提第一个真正的需求,它又没听懂,你再说一遍。
我试过四五个AI工具。每次切换,都要重新交代一遍背景。更烦的是,前一个工具里攒的那些经验、踩过的坑、你的偏好,新工具一概不知道——等于从零开始。
折腾了一晚上,我琢磨明白一件事:问题的根子不是工具不够聪明,而是没有一个地方把这些东西存下来,让所有工具都能读到。
今天把我想到的三条路说清楚,第三条是我一度兴奋、后来否掉的那条。
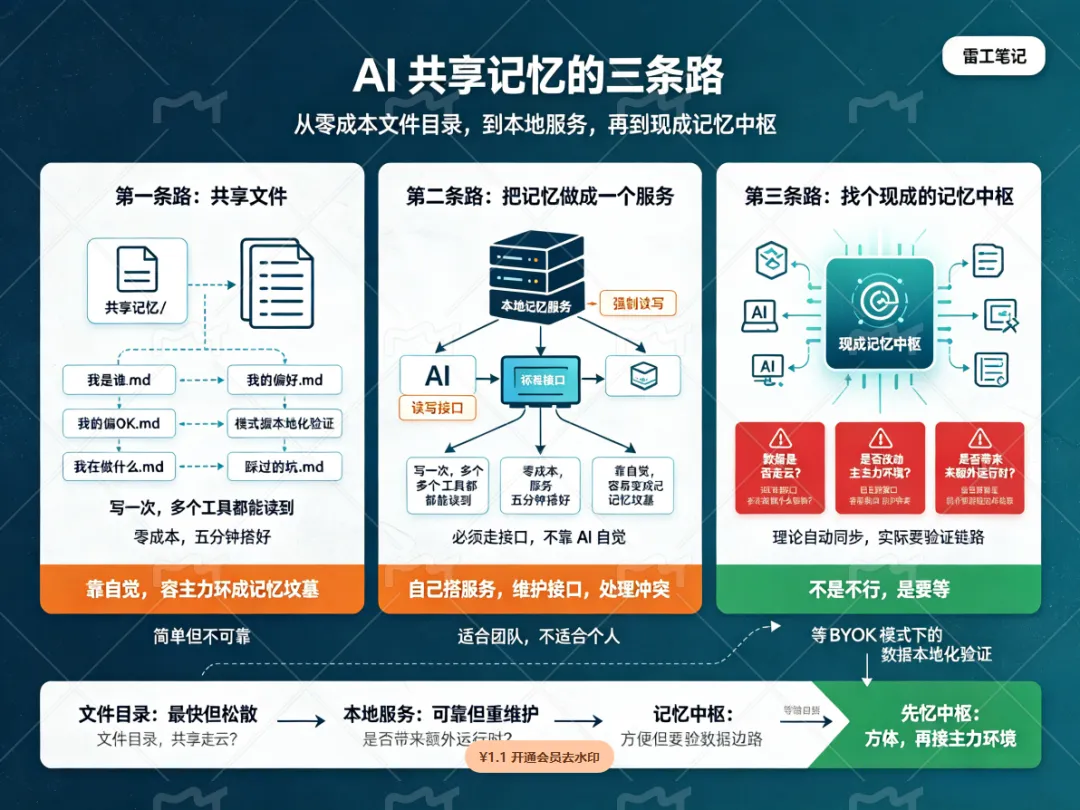
一、第一条路:共享文件,零成本但靠自觉
最简单:建一个目录,放几个文本文件。
共享记忆/我是谁.md我的偏好.md我在做什么.md踩过的坑.md
然后在每个项目的根目录放一个约定文件,告诉所有AI:"干活前先读这几个文件。"
这个约定的妙处在于,现在主流的AI工具认的是同一个文件。你写一次,四五个工具都能读到。
但它有个硬伤:靠自觉。
AI读完可能忘了写回,也可能写了个不规范的格式。你没法强制它。用一段时间后,那个目录就变成了一座坟——只有我写进去,没有工具补充。
优点是零成本,五分钟就能搭好。缺点是你会慢慢不信它。
二、第二条路:把记忆做成一个服务
进阶一点的做法:把记忆封装成一个常驻的本地服务,所有AI工具通过标准接口读写。
好处是读写变成强制动作,不靠AI自觉——它想记住什么,必须走这个接口。
但这条路有自己的问题:得自己搭服务,得维护接口,得处理多个AI同时写入的冲突。对一个只想省掉"重复交代背景"的人来说,投入产出比不划算。
这条路适合团队,不适合个人。
三、第三条路:找个现成的"记忆中枢"
我最后花了一晚上研究的是这个方向:市面上已经有现成的开源工具,专门做"给所有AI工具提供一份共享记忆"。
装上它,AI工具接入同一个记忆库,理论上一切自动解决。
我一度很兴奋,但三个问题让我停下来了。
第一个:数据到底走不走云。
这类工具说自己是"本地优先",但同时又要你注册账号领免费额度。两件事放在一起,说明"理解、整理、结构化"这些步骤大概率要走大模型API。用你自己的key,还是它的免费额度?用免费额度,你的对话内容就过了别人的推理层。
我发文章都要查敏感词,这个事不能含糊。
第二个:它会改你的主力环境。
接入这类工具,通常要给现有AI装钩子。钩子一装,你的会话流程就被改写了。万一出问题,你还得判断是工具的问题还是钩子的问题。
第三个:它不只是记忆,还带一整套运行时。
你只想借记忆层,它把整个运行时一起塞给你。
结论:不是不行,是要等。等我把链路验证清楚——特别是BYOK模式下数据是否真的100%本地——再决定要不要接。
四、三条路的真实对比
三条路都指向同一个结论:真正要解决的是"记忆归属",不是"哪个工具更好"。
五、我在做的一个调整
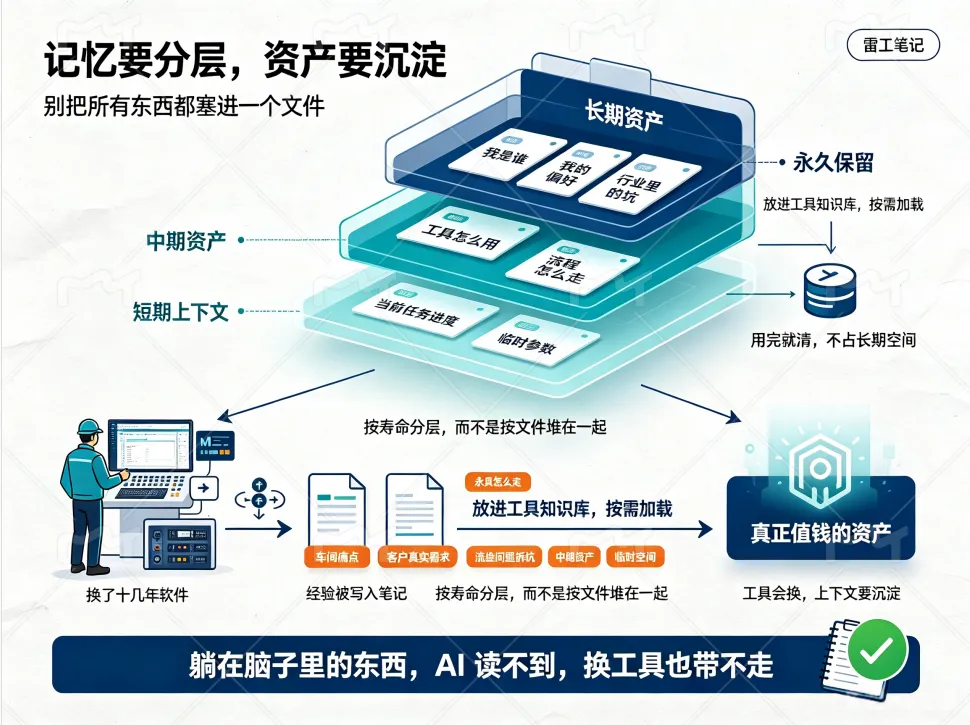
想明白这件事之后,我先做了一件小事:把记忆分层。
以前我把所有东西塞进一个文件——路径、数据、经验、偏好全混在一起。塞到快满了才发现,这根本不是一个文件能装的东西。
现在拆开:
长期资产:我是谁、我的偏好、行业里的坑 → 永久保留 中期资产:某个工具怎么用、某个流程怎么走 → 放进工具自己的知识库里,按需加载 短期上下文:当前任务做到哪 → 用完就清,不占长期空间
一句话:不要把所有东西都塞进一个地方,按寿命分层。
这件事不需要买任何工具,改个习惯就行。
写在最后
我说个实在话。
工控这行,我们换了十几年的软件。从西门子到组态王,从WinCC到国产的上位机,现在又从组态跳到MES平台。每次换工具都焦虑:这个得学吗?不学会不会被淘汰?
但我越来越觉得,焦虑的方向错了。
真正值钱的东西,从来不是你用了哪个软件。而是这些年攒下来的:你知道车间里哪些环节最痛,你知道客户真正在意的是什么,你知道怎么把一件复杂的事拆清楚。
这些东西,换个AI工具、换个平台,一样用得上。
但前提是——你得把它存下来。
躺在你脑子里的东西,AI读不到,换工具也带不走。写进文件、写进笔记、写成一套可复用的东西,它才是你的资产。
工具会换,上下文要沉淀。手可以换,眼睛不能瞎。
互动
你在几个AI工具之间切换过吗?换了之后第一件事是在干嘛?评论区聊聊。