ARTICLE · 1160549
工具都给全了,排障 AI 为什么还是读不懂?MCP设计三原则之给准
工具都给全了,排障 AI 为什么还是读不懂?MCP设计三原则之给准
工具备齐以后,我们很快遇到第二类卡点:AI 取到了数据,但读不明白。 日志一查几百行,半结构化的文本混在一起;监控接口返回 6 层嵌套的 JSON;一条链路是几十个扁平的 span。 人看都头疼,AI 也一样,而且每多一个字都要花 token。 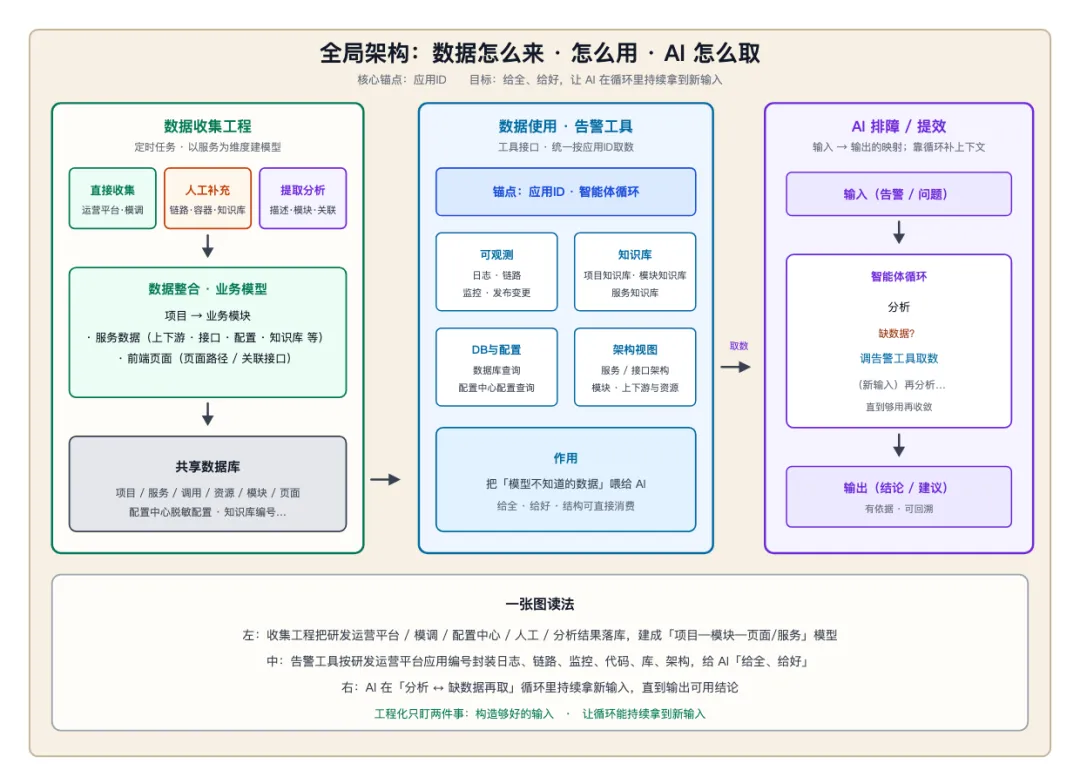
给准就是解决这个问题。它有三条子标准: 下面四个例子,都是照着这三条改出来的。 原始日志的问题是一坨半结构化文本。 Pod 名、IP、上下文信息和正文混在一起,每一行都重复一遍。token 很贵,AI 还读不明白。 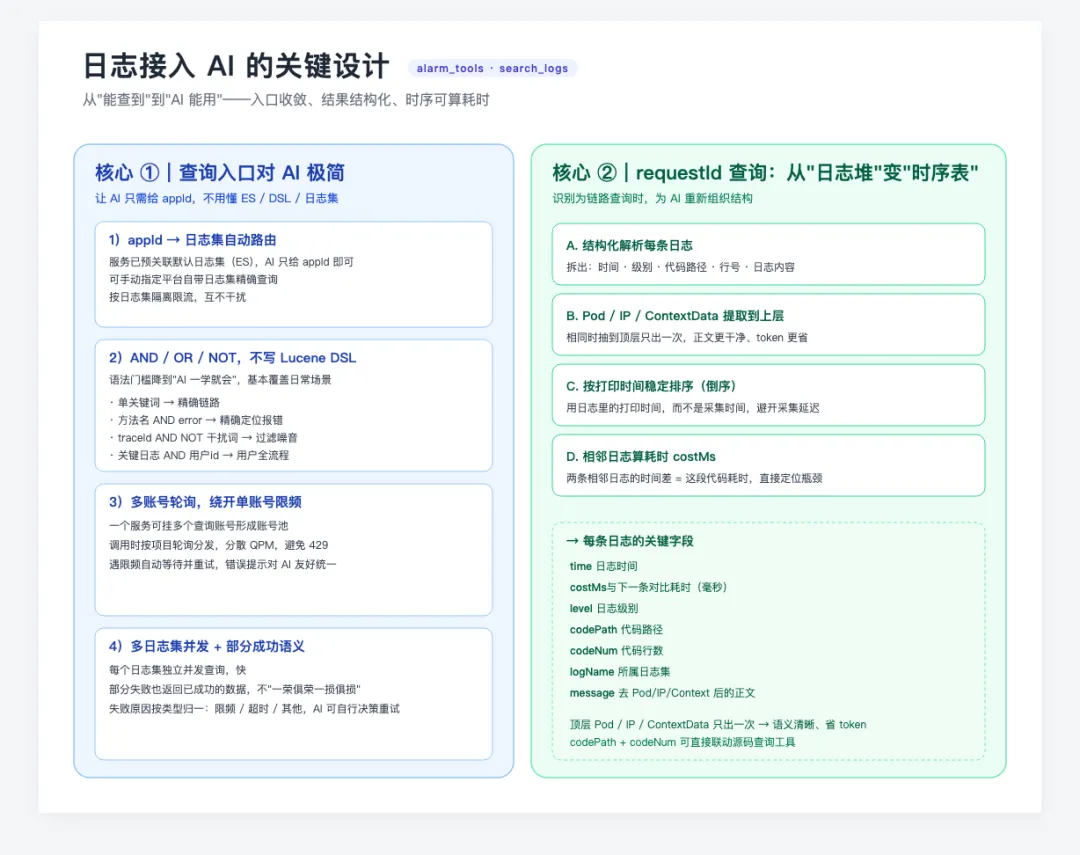
search_logs 返回之前,做了四件事: 拿 costMs 来说,AI 看到某两条日志之间隔了 900 毫秒,不用自己去减时间戳,就知道瓶颈在这一段。 另外,查询入口也简化了。AI 只要给服务 ID,不用懂日志集,也不用写复杂的查询语法,用 AND、OR、NOT 就能过滤。 原始的监控查询接口,16 个入参,返回 50 多个字段、6 层嵌套,一次只能拿一个指标的一段时间。 这是一个给人画图表用的接口。它很灵活,但怎么组合、怎么对比,全丢给了调用方。 AI 要看一个服务的健康度,得调好多次再自己合并。 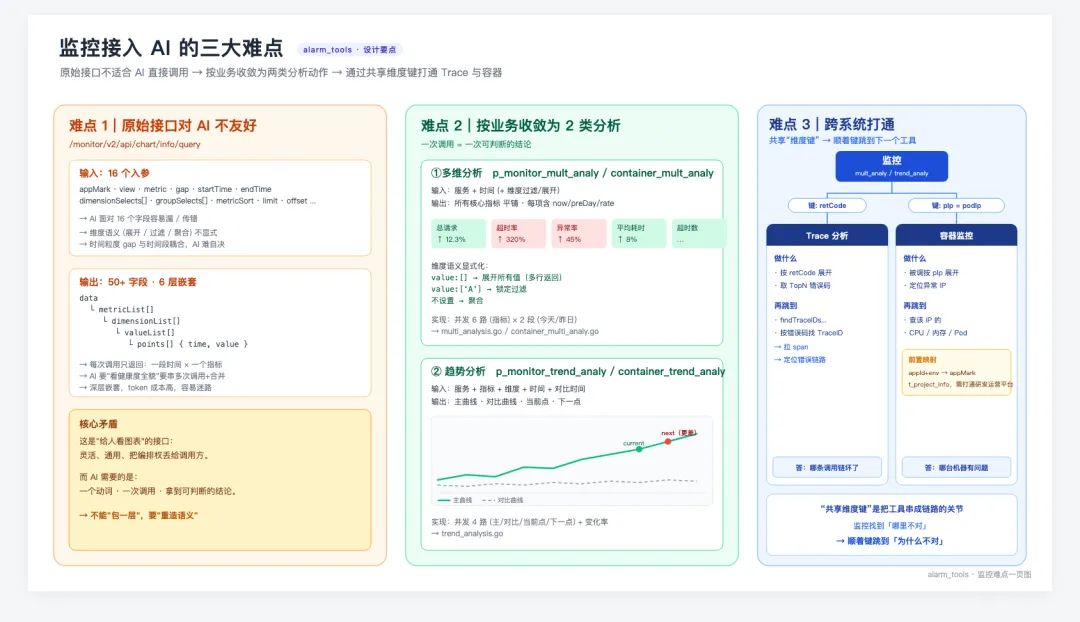
AI 要的不是图表原料。它要的是一个动作、一次调用、一个能判断的结论。 所以我们没有简单包一层,而是按排障的用法重新设计: 还有一层:监控返回的错误码、被调 IP,正好是下一个工具的入参。 错误码可以拿去找链路,IP 可以拿去查容器监控。 监控说清楚“哪里不对”,顺着这些字段就能跳到“为什么不对”。 原始的一条链路,是一个扁平的数组。 字段是“键、类型、值”三元组,耗时单位是纳秒,网关节点和业务节点平铺在一起,请求和响应藏在事件里。 5 个 span 摆在那里,AI 得自己按父子 ID 拼成树,才知道谁调了谁。 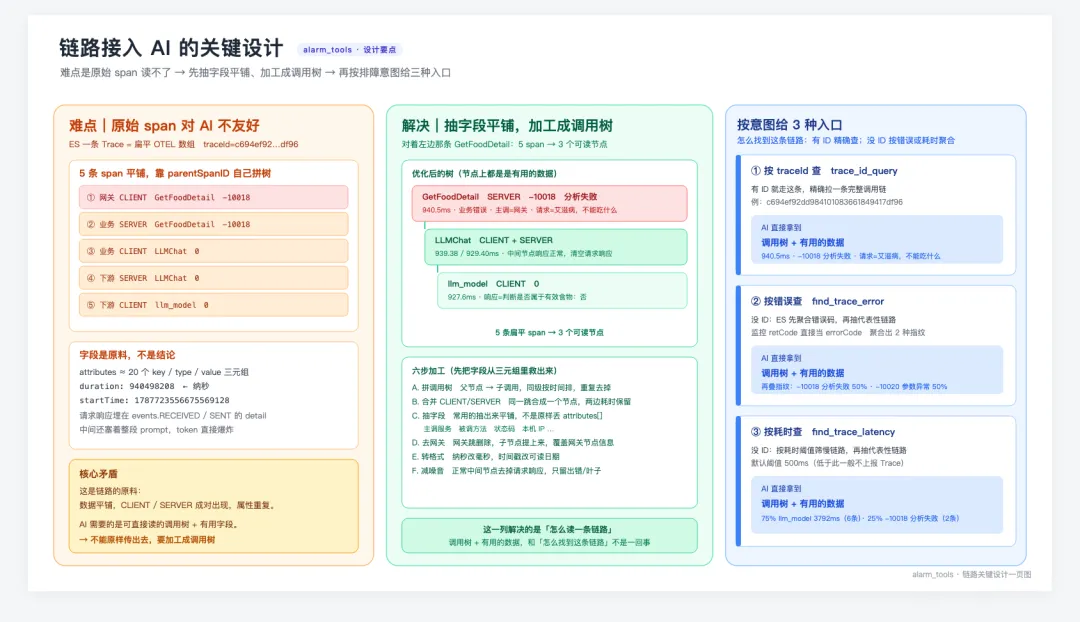
我们先把一条链路加工成调用树: 图中间那个例子,5 个扁平 span 加工完只剩 3 个节点,哪一跳报错、哪一跳慢,一眼就能看出来。 然后按排障的意图给三个入口: 排障时 AI 经常要先搞清楚:这个服务是干什么的?谁在调它?它调了谁?用了哪些资源?改了它会影响哪些前端页面? 这些答案分散在调用监控、云资源、知识库、配置中心、前端代码五个地方。 让 AI 自己一个个查再拼起来,token 爆炸,还容易漏。 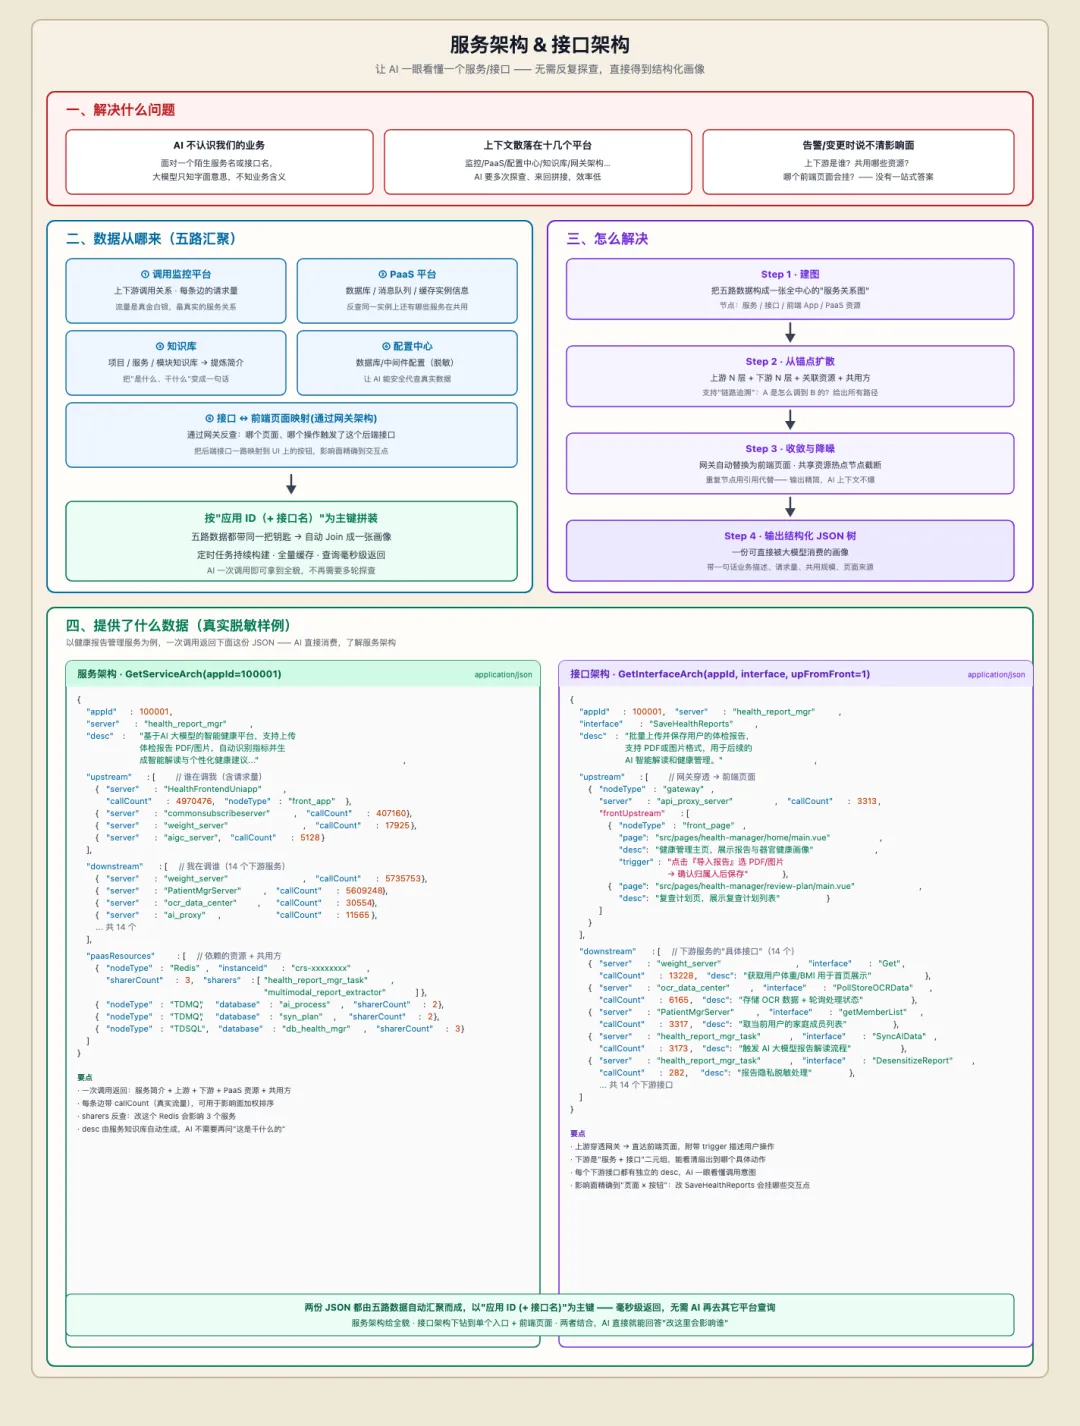
服务架构 和 接口架构 做的是两件事:数据侧提前汇总,输出侧整理成结构。 AI 拿到这份 JSON,就知道这个服务在整个业务里处在什么位置。 四个例子,做的其实是同一件事:把人自己会做的整理和计算,提前在服务端做掉。 人看日志会下意识地跳过重复的 Pod 名,看链路会在脑子里拼出调用树,看监控会自己算一下比昨天涨了多少。 这些动作,人做起来不觉得费劲,AI 做起来既费 token 又容易错。 下一篇讲最后一条原则,给方便:AI 知道该查什么,怎么让它顺利取回来。
排障智能体设计系列 · 第 3 篇 上一篇讲了做工具的三条原则:给全、给准、给方便,并展开了给全。这一篇讲给准,还是架构图中间那一段。
给准的 3 条标准
无噪音:无关的字段不返回,冗余的结构不返回。 语义显式:含义不要藏在参数组合里,用命名和枚举讲清楚。 返回结论而不是原料:能在服务端整理好的、算好的,直接给结果,别让 AI 自己算。
日志:几百行文本变一张时序表
结构化解析,拆出时间、级别、代码路径、行号、正文。拿到的是字段,不是字符串,可以直接判断。 Pod、IP、上下文抽到顶层,只出现一次。正文更短,省 token,语义更清楚。 按日志打印时间排序,不按采集时间。避开采集延迟造成的乱序。 相邻两条日志算出耗时 costMs。哪段代码慢,直接算好给 AI。
不是把日志传给 AI,而是按项目的规则,把日志加工成一张 AI 能直接判断的时序表。
监控:16 个入参变 1 次调用
多维分析:一次拿齐 6 个核心指标(请求量、超时率、异常率、平均耗时等),每个指标都带今天、昨天和变化率,平铺返回,不嵌套。 趋势分析:主曲线和对比曲线一起给,变化率算好。 维度语义写明白:value: [] 表示展开所有值,value: ['A'] 表示只看 A,不设置就是聚合。 指标用枚举,每个值都写清含义和公式。比如 8 是失败率,等于异常率加超时率,AI 不用自己拼公式。
链路:5 个 span 压成 3 个节点
按父子关系拼成树,同级按时间排,重复的去掉 同一次调用的客户端 span 和服务端 span 合成一个节点 常用字段从三元组里抽出来平铺 网关节点去掉,耗时换成毫秒 只保留出错节点和叶子节点的请求响应
有 traceId,精确查这一条 没有 traceId,按错误码先聚合,告诉 AI 哪种错最多、落在哪个节点,再抽一条代表性的链路 按耗时查,告诉 AI 慢请求里有多少比例卡在哪个下游
AI 拿到的不是一堆 span,是一棵调用树加上有用的数据:错在哪个节点,慢在哪一跳。
架构:5 个平台拼成 1 张画像
五路数据以服务 ID 为主键,离线提前关联好。一次调用拿到全貌,不用跨平台拼。 每条上下游边都带真实调用量,按调用量排序。影响面大小直接看,不用自己算排名。 共享资源反查,直接列出“这个 Redis 还有谁在用”。改动的影响面由服务端算好。 遇到网关自动展开到前端页面和触发按钮。影响面精确到“哪个页面的哪个按钮”。 每个服务、每个接口都带一句话描述。AI 不用再问“这是干什么的”。 热点节点截断,重复节点用引用代替。输出不会爆,一次读得完。
1 句话,带走给准
给 AI 的数据,返回结论,不要返回原料。