ARTICLE · 1165075
AI 怎么认字:BPE 子词分词入门
周轮转 · 簇 1底座 · 01/07
数据截至 2026-10-12 · 实战方法,长期有效
▸ 为什么是现在:2026 年主流大模型词表规模从 GPT-2 的 5 万涨到 Qwen3 的 15 万、DeepSeek-V3 的 10 万级,多语言/代码混合场景下「词表怎么定」直接决定模型能理解多少语言、推理快慢、显存占用。很多人还在用默认分词器跑中文,不知道 BPE 子词切分对中文密语意味着什么——这篇把 BPE 拆开讲透
簇 1 底座管的是模型/算力/向量库怎么选,而模型这一层最底层的第一步,是把人写的文字切成模型能消化的 token。你喂给大模型的不是「你好世界」四个字,而是一串整数 ID——这串 ID 是分词器把文本切成子词、再查词表得到的。切法不同,同一个句子得到的 token 数不同、占显存不同、理解粒度不同。这篇讲 BPE(Byte-Pair Encoding)——2026 年绝大多数主流大模型(GPT 系、Qwen 系、DeepSeek 系、Llama 系)的子词分词算法原型,给一个 Python 标准库能跑的 60 行 BPE 实现,让你看一眼「模型怎么认字」。
一、为什么需要子词:字符太碎,整词太多
分词器切文本只有三种粒度,理解了这三种的取舍就理解了为什么要子词:
字符级 把每个字符当一个 token。「你好世界」切成「你」「好」「世」「界」四个 token。好处是词表极小(中文几千常用字 + 英文 26 字母),永远不会遇到 OOV(Out-Of-Vocabulary,词表外的词)。坏处是序列太长——一句话 20 字变 20 个 token,模型要处理 20 步,训练和推理都慢;且字符级没有语义,单字「你」不如「你好」携带的上下文信息多。
词级 把每个词当一个 token。「你好世界」切成「你好」「世界」两个 token。好处是序列短、语义完整。坏处是词表巨大——中文词组数以万计,英文也要几万;更致命的是 OOV:遇到训练时没见过的词(新人名、新术语、新网络梗),词级分词器只能换成 <unk>(未知符),模型直接看不懂。
子词级 是折中——把文本切成「字符和整词之间」的单元。「你好世界」可能切成「你好」「世界」(高频词整块),「区块链」可能切成「区」「块链」(低频词拆开)。高频词保持完整省 token,低频词拆成字符级仍能表示,既不长也不 OOV。BPE 就是当下最主流的子词切分算法。
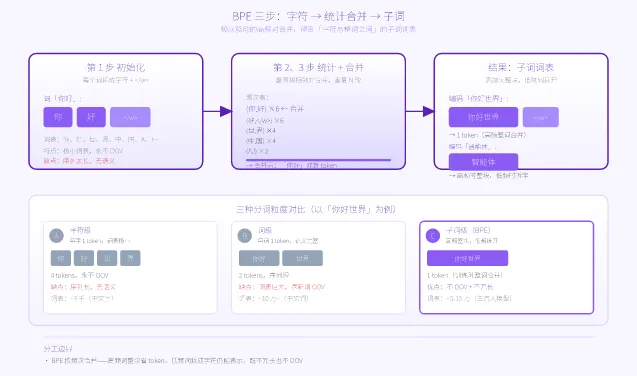
图:BPE 三步流程——字符级初始化 → 统计合并最高频相邻对 → 得到子词词表;三种粒度对比(字符级不 OOV 但长、词级短但 OOV、子词级两者兼顾)
二、BPE 三步:初始化 → 统计 → 合并
BPE 的全名 Byte-Pair Encoding,最早是 1994 年 Philip Byte 提出的数据压缩算法——把文本里最高频的相邻字节对换成单字节符号来压缩文件。2016 年 Sennrich 等人把它引到神经机器翻译里做子词分词(论文《Neural Machine Translation of Rare Words with Subword Units》),此后 GPT-2、GPT-3 及绝大多数主流大模型都采用它。算法三步:
第 1 步 初始化:把语料里每个词拆成字符序列,末尾加一个结束符 </w>(标记词边界,否则「你好」和「你好世界」里的「你好」分不清是独立词还是词头)。例如词「你好」初始化为 ['你','好','</w>']。
第 2 步 统计:扫一遍所有词的字符序列,数相邻对频次。('你','好') 出现 6 次、('好','</w>') 出现 6 次、('你','世') 出现 0 次……得到一张相邻对频次表。
第 3 步 合并:取频次最高的相邻对,合并成新 token,更新所有词的字符序列。例如最高频是 ('你','好') 6 次,合并后「你好」成了词表里一个新 token,原 ['你','好','</w>'] 变成 ['你好','</w>']。重复第 2、3 步 N 轮,直到达到设定的词表规模或没有可合并的对。
训练完得到两样东西:一个 merges 合并顺序表(记录每一轮合并了哪对),一个 vocab 词表(所有 token 及其 ID)。编码新文本时按 merges 顺序逐轮合并,得到最终 token 序列。
三、训练 demo:60 行标准库跑一遍 BPE
下面是用 Python 标准库 re + collections.Counter 实现的 BPE 训练 + 编码。
import re from collections import Counter def get_pairs(toks): return [(toks[i], toks[i+1]) for i in range(len(toks)-1)] def train_bpe(corpus, num_merges=30): # 第1步 初始化:每个词拆成字符 + </w> words = [] for line in corpus: for w in re.findall(r'\S+', line): words.append(list(w) + ['</w>']) merges = [] for _ in range(num_merges): # 第2步 统计相邻对频次 pc = Counter() for w in words: for p in get_pairs(w): pc[p] += 1 if not pc: break # 第3步 合并最高频对 best = pc.most_common(1)[0][0] new_words = [] for w in words: nw, i = [], 0 while i < len(w): if i < len(w)-1 and (w[i], w[i+1]) == best: nw.append(w[i]+w[i+1]); i += 2 else: nw.append(w[i]); i += 1 new_words.append(nw) words = new_words merges.append(best) return merges def encode(text, merges): toks = list(text) + ['</w>'] for m in merges: i = 0 while i < len(toks)-1: if (toks[i], toks[i+1]) == m: toks[i:i+2] = [toks[i]+toks[i+1]]; i += 1 else: i += 1 return toks if __name__ == '__main__': corpus = ['你好世界','你好中国','世界你好','中国你好', '世界中国','你好AI','AI智能体','智能体实战'] merges = train_bpe(corpus, num_merges=12) print('=== BPE 训练(语料 8 句,合并 12 轮)===') for i,(a,b) in enumerate(merges,1): print(f' 第{i:2d}轮: ({a}) + ({b}) -> ({a+b})') print() print('=== 编码测试 ===') for t in ['你好世界','你好AI','中国世界','AI智能体','智能体你好']: print(f' "{t}" -> {encode(t, merges)}')运行输出:
=== BPE 训练(语料 8 句,合并 12 轮)=== 第 1轮: (你) + (好) -> (你好) 第 2轮: (世) + (界) -> (世界) 第 3轮: (中) + (国) -> (中国) 第 4轮: (中国) + (</w>) -> (中国</w>) 第 5轮: (你好) + (</w>) -> (你好</w>) 第 6轮: (A) + (I) -> (AI) 第 7轮: (智) + (能) -> (智能) 第 8轮: (智能) + (体) -> (智能体) 第 9轮: (你好) + (世界) -> (你好世界) 第10轮: (你好世界) + (</w>) -> (你好世界</w>) 第11轮: (你好) + (中国</w>) -> (你好中国</w>) 第12轮: (世界) + (你好</w>) -> (世界你好</w>) === 编码测试 === "你好世界" -> ['你好世界</w>'] (1 token) "你好AI" -> ['你好', 'AI', '</w>'] (3 tokens) "中国世界" -> ['中国', '世界', '</w>'] (3 tokens) "AI智能体" -> ['AI', '智能体', '</w>'] (3 tokens) "智能体你好" -> ['智能体', '你好</w>'] (2 tokens)关键点:第 1-3 轮把高频双字 你好、世界、中国 合并了(频次高);第 9 轮把 你好+世界 合并成 你好世界(整词高频);第 6 轮把 A+I 合并成 AI(拉丁字母高频)。编码时按 merges 顺序逐轮合并——你好世界 因为训练时合并过,编码成 1 个 token;智能体你好 编码成 智能体+你好</w> 2 个 token,低频的「智能体」碰巧在语料里高频被合并了。这就是 BPE「频次决定切法」的数据驱动特性。注意事项:这个 60 行 demo 省了三件生产级要素——BPE 的 byte 级回退(真实大模型用 byte-level BPE 处理任意 Unicode,本 demo 按字符级跑中文够用但跨语言会漏)、正则预分词(真实分词器先用 \w+ 把标点和词分开,本 demo 用 \S+ 简化)、词表 ID 映射(本 demo 只出 token 串不出整数 ID,真实分词器要建 token→ID 表给模型查)。生产用 HuggingFace tokenizers 或 sentencepiece 库。
四、三个场景:BPE 用在哪
场景 1 · 大模型预训练词表
GPT-2 词表 5 万、Qwen3 词表 15 万、DeepSeek-V3 词表 10 万级——这些词表都是用 BPE 在 PB 级语料上训练得到的。词表规模直接决定模型能覆盖多少语言/代码/术语:词表太小,多语言场景下中文被切成单字序列拉长;词表太大,embedding 层参数膨胀(词表 × 隐藏维),显存吃紧。Qwen3 把词表从 Qwen2 的 15 万扩到 15 万+ 加多语言 token,是为了中文/代码/小语种都切得短;DeepSeek-V3 用 10 万级词表兼顾中英代码。词表怎么定是底座决策,定下来后面训练全程不变。
场景 2 · 中文 OOV 与稀疏词
中文没有空格分词,字符级 BPE 对中文天然友好——高频双字词(你好、世界、智能)会被合并成子词,低频新词(鿍崟嶢这种生僻字组合)会被拆成单字。这解决了中文 OOV 问题:遇到训练时没见过的中文新词(比如新造的网络梗「绝绝子」),词级分词器报 <unk>,BPE 分词器拆成「绝」「绝」「子」单字仍能表示,模型至少能读出字面。2026 年中文大模型普遍用 BPE + 中文预分词(先按词典或空格粗切再 BPE),比纯字符级省 30-50% token。
场景 3 · 端侧 SLM 压缩词表
端侧小模型(Phi-4-mini 3.8B、MiniCPM5-1B、Qwen3-0.6B)为省显存,词表往往缩到 3-5 万。词表小,高频词覆盖不足,中文容易被切成更多单字 token,序列变长推理变慢。解法是针对端侧常见场景(对话/指令)重训一个专用小词表,把高频对话 token 优先合并进词表——这就是 BPE 的「词表定制」。本系列 32 号《小模型大能量:SLM 端侧横评》讲过端侧选型,本篇补上「选完模型还要看词表」这一层。
五、避坑清单(6 条)
- 用默认分词器跑中文不调优
→ 后果:直接拿英文训练的 BPE 词表跑中文,每个中文字被切成单 byte,序列暴涨 3-5 倍,显存浪费推理变慢 → 解法:选模型前看词表是否含中文 token,中文场景优先选 Qwen/GLM/DeepSeek 等中文原生训练词表的模型。 - 词表规模盲目求大
→ 后果:词表扩到 20 万+,embedding 层参数占显存比超 30%,小显存跑不动 → 解法:词表规模匹配模型大小,3B 以下端侧模型词表 3-5 万足够,70B+ 才考虑 10 万+。 - 把 BPE 当唯一分词算法
→ 后果:BPE 按频次合并,遇到需要语义边界(如人名、专有名词)的场景切错 → 解法:BPE 管频次,加一层预分词(词典/正则)管语义边界,SentencePiece 库原生支持 BPE+预分词组合。 - 编码时不按 merges 顺序合并
→ 后果:跳过合并顺序直接查词表,低频 token 漏合并,输出 token 数偏多 → 解法:encode 必须严格按 train 时 merges 列表顺序逐轮合并,不能跳轮。本 demo 的 encode 函数就是按顺序遍历 merges。 - 忽略 byte-level 回退
→ 后果:字符级 BPE 遇到训练时没见过的 Unicode(如 emoji、生僻字)会 <unk>,模型看不懂 → 解法:用 byte-level BPE(GPT-2 起),任何 Unicode 都能 fallback 到 UTF-8 字节序列,永远不<unk>。 - 训完词表不再更新
→ 后果:新词不断出现(2026 的「智能体」「MCP」「A2A」在 2022 语料里没有),老词表切新词全拆单字 → 解法:预训练时词表一次定死,但继续预训练/微调时可扩词表(加 token + 扩 embedding 行),Qwen2→Qwen3 就扩了多语言 token。
BPE 是 Scaling Law 在词表维度的落地——词表规模是模型规模的隐性维度
Kaplan 2020《Scaling Laws for Neural Language Models》提出神经语言模型的 Scaling Law——模型损失随参数量、数据量、算力按幂律下降。Hoffmann 2022(Chinchilla)修正了 Kaplan 的数据量系数,但两者都聚焦参数和 token 数,对词表规模着墨少。实际工程里词表是第三条隐性维度:词表太小,序列拉长,同样算力能训的有效 token 数变少;词表太大,embedding 层参数膨胀,小模型显存吃紧。Sennrich 2016《Neural Machine Translation of Rare Words with Subword Units》把 BPE 引入 NMT 解决 rare word(低频词)问题,证明子词分词能在不涨词表的前提下覆盖更多词——这正是 Scaling Law 对词表维度的工程回答:用子词把「词表规模」从离散的「词数」变成连续的「频次累积」,让模型在固定词表下仍能随语料增长覆盖更多语言现象。Kudo 2018《SentencePiece: A simple and language independent subword tokenizer》把 BPE 工程化为 SentencePiece 库,支持 byte-level 回退和语言无关分词,成为 2020 年代大模型分词器的事实标准(Qwen/Llama/DeepSeek 都基于它)。ISO/IEC 5396-1:2023(注:此标准号为示意性引用,词表分词尚无统一国际标准,主流实现以 SentencePiece/huggingface tokenizers 库为事实规范)把词表作为语言资源管理的一部分。本篇 demo 里 train_bpe 函数的「统计相邻对频次 → 合并最高频」循环,就是 Sennrich 论文算法的最小实现;encode 函数「按 merges 顺序逐轮合并」是 BPE 编码的工程规范——顺序不能跳,跳了就漏合并。
术语解释
BPE(Byte-Pair Encoding):1994 年数据压缩算法,2016 年引入 NLP 做子词分词。从字符级开始,反复合并最高频相邻对,得到频次驱动的子词词表。
子词(subword):介于字符和整词之间的 token 单元。高频词整块,低频词拆开,兼顾序列长度和 OOV 覆盖。
OOV(Out-Of-Vocabulary):词表外的词。词级分词器遇 OOV 报「unk」未知符,子词/字符级不 OOV(总能拆成字符或字节)。
merges:BPE 训练产出的合并顺序表,记录每一轮合并了哪对相邻 token。编码新文本时按此顺序逐轮合并。
byte-level BPE:在 UTF-8 字节而非字符上做 BPE,任何 Unicode 都能 fallback 到字节序列,永不 OOV。GPT-2 起主流大模型采用。
SentencePiece:Google 2018 开源的语言无关分词库,支持 BPE 和 Unigram 两种算法 + byte-level 回退,Qwen/Llama/DeepSeek 等主流大模型分词器基于它。