ARTICLE · 1165689
Docling 实战:把 PDF 和扫描表格变成 AI 可用资料,从安装到核验
把一份费用制度交给 AI,问“酒店住两晚,每晚 580 元,能报多少”,它很快就能给出一个数字。但如果表格里的“500 元/晚”与旁边的“事前审批后 650 元/晚”混在一起,答案越流畅,反而越难看出错误。
这次介绍的 Docling,解决的是资料进入模型之前的整理工作:从 PDF、扫描件和 Office 文档里提取文字、表格与结构,再导出便于阅读的 Markdown 和便于程序处理的 JSON。
本文用一份两页差旅政策讲清它的用途、优缺点、安装步骤和验收方法。目标很具体:让你能找到金额来自哪一条规则,而不只是得到一段摘要。
一、Docling 到底能做什么,谁值得用
Docling 是由 IBM Research 团队发起、现由开源社区维护的文档处理项目。它的标准 PDF 流程会处理版面、阅读顺序、表格结构,并可通过 OCR 识别扫描页;结果统一放进 DoclingDocument,便于继续转换和接入应用。
截至 10 月 5 日,仓库约 6.84 万 Stars,本教程参考版本为 2.133.0。热度说明有很多人在关注,不能拿来当识别准确率。
最适合的三个场景:
- 企业制度问答。
把费用、采购、用印制度转成可检索资料,回答时附相关条款,让员工能回看依据。 - 研究与经营分析。
从报告和产品手册整理正文、表格与章节,再交给分析程序。金额、单位、期间和注释要一起保留。 - Agent 资料入口。
让智能体读取转换后的文档结构,按问题找片段,再调用后续工具;减少直接拿一整本 PDF 猜答案的情况。
它提供的是文档转换能力。要做一个能登录、上传、检索和聊天的知识库,还需要索引、模型、页面、权限与原文件存储等组件。
二、优点很实在,限制也要先知道
第一个优点,是结构可以继续利用。 除了纯文字,它能表达表格、标题、正文层级,以及可获得的页码和位置。Markdown 适合读,JSON 适合保留结构、做后续处理;二者可以同时保存。
第二个优点,是有本地处理路线。 官方支持 macOS、Windows 和 Linux。模型可预先下载,本地流程不必把文档交给云端推理服务;如主动接入远程 OCR 或模型,数据流向就会变化。
第三个优点,是适合接入现有 AI 应用。 官方提供与 LangChain、LlamaIndex 等工具的集成入口;团队可以先验证一个文件,再逐步加入切片、检索和问答。
限制同样具体:首次安装和模型准备有成本;扫描模糊、复杂合并单元格、跨页表格和阅读顺序都可能出错。中文扫描件还要选合适的 OCR 语言。生成了一个 Markdown 文件,不代表里面的金额和条件已经正确。
Docling 代码采用 MIT 许可,所用模型另看各自许可。开源代码免许可费,也仍有计算资源、存储和维护成本。
三、需要本地安装吗?分清“看教程”和“运行工具”
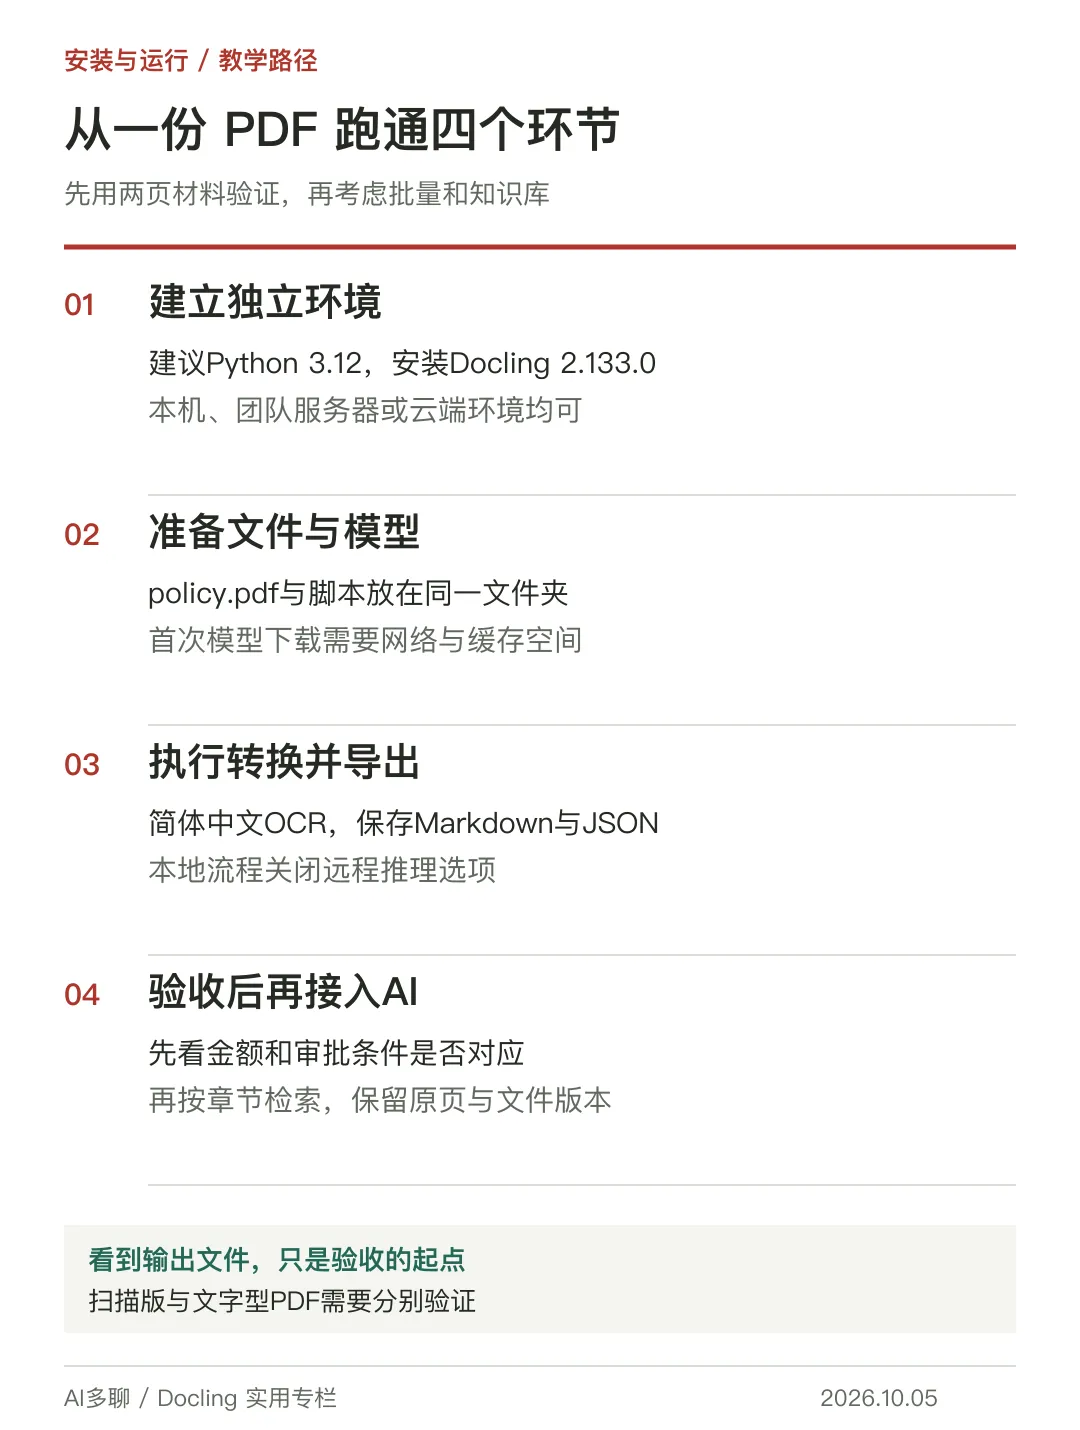
阅读文章和查看示例不用安装。亲自转换文档,需要在执行环境里安装 Docling。 可以用自己的电脑,也可以用团队服务器或云端 Python 环境;本地安装不是唯一选择,运行环境中的依赖则不可省略。
个人试用无需先搭服务器、数据库或聊天页面。先在一个独立文件夹里跑通两页 PDF,成本和问题都更容易看清。
官方要求 Python 3.10 或更高。下面建议用 Python 3.12,分别给出 macOS/Linux 与 Windows 命令。旧款 Intel Mac 的 PyTorch 安装存在版本兼容问题,应先看文末官方安装页的对应说明。
macOS/Linux,在终端创建并激活独立环境:
终端 · macOS / Linux
mkdir docling-demo
cd docling-demo
python3.12 -m venv .venv
source .venv/bin/activate
python -m pip install "docling==2.133.0"
Windows,在 PowerShell 执行以下命令;直接使用环境里的 Python,可避免激活脚本的设置差异:
终端 · Windows PowerShell
mkdir docling-demo
cd docling-demo
py -3.12 -m venv .venv
.\.venv\Scripts\python.exe -m pip install "docling==2.133.0"
如果提示找不到 python3.12 或 py,先安装对应 Python 版本,再重试。此处固定 Docling 版本,便于与教程对照;正式复现还应保存完整依赖清单和模型版本。
四、先准备一道能人工验算的题
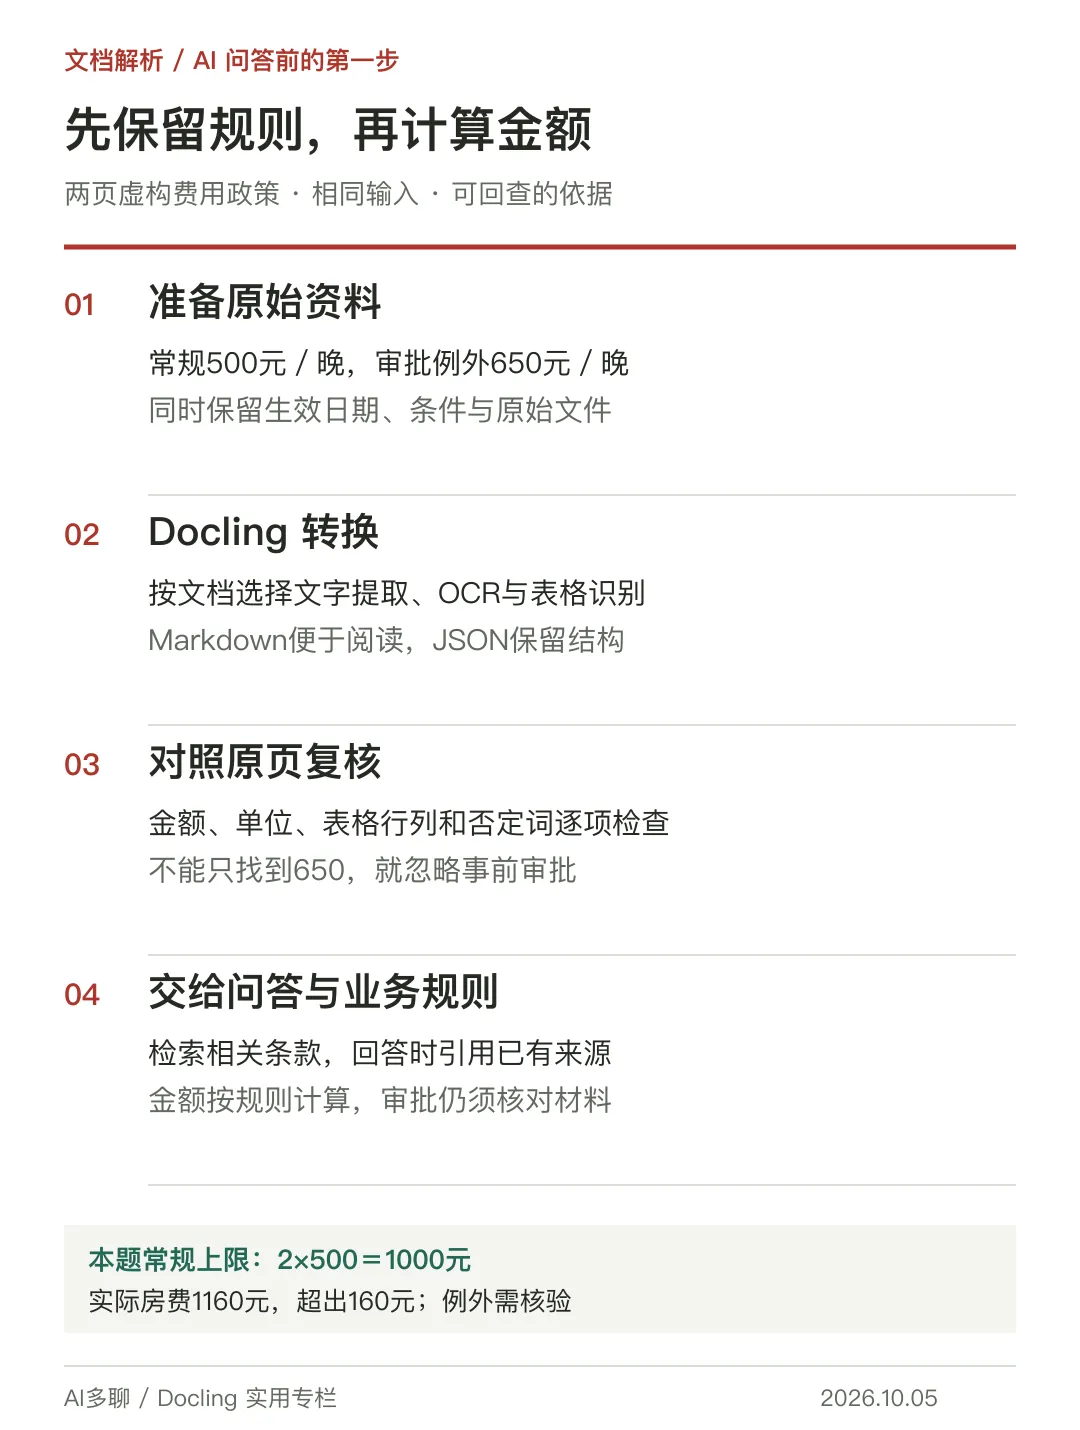
本例的 policy.pdf 是虚构教学文件,不是任何企业的真实制度。两页内容包括:常规住宿上限 500 元/晚;符合事前审批的会展城市可按 650 元/晚;房费含早餐时不另报早餐;制度自 2026 年 10 月 1 日生效。
你也可以在 Word 或 WPS 中自制同题文件:第一页写标题“虚构差旅政策”,用两列表格列出“常规住宿/500 元每晚”和“符合事前审批的会展城市/650 元每晚”,再写入早餐规则与生效日期;插入分页符,第二页写“两晚、每晚 580 元、未提供事前审批”的问题。通过“导出为 PDF”保存为 policy.pdf,放在下文脚本旁,即可作为文字型测试文件。扫描识别需另备扫描版,不能用文字型结果代替。
问题是:住宿两晚,每晚 580 元,未提供事前审批,按常规标准能计入多少住宿费?
先写下人工答案:实际支出 2×580=1,160 元,常规上限 2×500=1,000 元,超出部分 160 元。即使城市正在办会展,也不能自动按 650 元标准处理;必须核对有效审批及适用范围。
用这种简单但带例外条件的文件开始,比一上来导入数百页报告更容易定位问题。文字型 PDF 可以先检查文字抽取;扫描版应单独加入验收,不能把文字型结果当作 OCR 效果。
五、从一次转换开始,再保留完整结构
将 policy.pdf 放在当前文件夹。macOS/Linux 激活环境后,先运行官方最小入口:
终端 · macOS / Linux
docling policy.pdf
Windows 使用同一环境里的命令:
终端 · Windows PowerShell
.\.venv\Scripts\docling.exe policy.pdf
该入口默认生成 Markdown。首次执行可能自动下载所需模型;如果日志停留在模型下载阶段,应先检查网络、缓存与可用磁盘,不要把它误判成文件没有内容。
需要同时保留 Markdown、JSON 并明确中文 OCR 时,可以新建纯文本文件 convert_policy.py,保存下面的代码。文件与 policy.pdf 放在同一目录,编码使用 UTF-8。
Python
import json
from pathlib import Path
from docling.datamodel.base_models import InputFormat
from docling.datamodel.pipeline_options import (
PdfPipelineOptions, RapidOcrOptions,
)
from docling.document_converter import (
DocumentConverter, PdfFormatOption,
)
base = Path(__file__).resolve().parent
options = PdfPipelineOptions(
do_ocr=True,
do_table_structure=True,
enable_remote_services=False,
ocr_options=RapidOcrOptions(lang=["iso:zh-Hans"]),
)
converter = DocumentConverter(format_options={
InputFormat.PDF: PdfFormatOption(pipeline_options=options)
})
result = converter.convert(base / "policy.pdf")
if result.status.value != "success":
raise RuntimeError(f"转换未完整成功:{result.status}")
out = base / "result"
out.mkdir(exist_ok=True)
doc = result.document
(out / "policy.md").write_text(
doc.export_to_markdown(), encoding="utf-8"
)
(out / "policy.json").write_text(
json.dumps(doc.export_to_dict(), ensure_ascii=False, indent=2),
encoding="utf-8",
)
print("转换完成,请对照原PDF检查result目录")
在 macOS/Linux 已激活的环境里运行:
终端 · macOS / Linux
python convert_policy.py
Windows 则运行:
终端 · Windows PowerShell
.\.venv\Scripts\python.exe convert_policy.py
这里指定简体中文 OCR,关闭远程推理选项,保留表格识别。模型下载与“上传文档给远程服务”是两件事;完全离线的环境需先按官方指引准备模型和依赖,再做断网验证。
公众号中的代码用于阅读;复制 Python 时要检查缩进是否仍为普通空格,避免富文本中的特殊空格导致运行报错。
六、打开结果后,先看这四处
金额与单位。 500、650、580 是否完整?“元/晚”有没有变成“元/次”?金额对了、单位错了,计算仍然会错。
表格与条件。 650 是否仍然对应会展城市及事前审批?“不另报早餐”中的“不”是否保留?不要只搜索数字就判定通过。
日期与来源。 生效日期是否仍在?JSON 中可用的 prov 等来源信息,能否带你回到正确页?不同输入和转换路径可保留的来源不同,不能假设每个 Markdown 段落天然带页码。
计算与结论。 在没有审批材料的本题中,常规上限应为 1,000 元、超出 160 元。费用上限计算通过,也不代表发票、审批、付款等全部业务检查通过。
若 Markdown 里表格错列,先回原页确认,再调整解析路径或修正结构;不要让模型补写成“看起来合理”的制度。
七、怎样把它交给 AI 使用
单个小文件,最省事的办法是先人工核对转换结果,将相关条款连同文件名、原页位置一起交给所用的问答工具。无需为了两页制度立即搭向量库。
资料逐渐变多时,再把流程扩展为:按章节整理片段 → 保存文件版本与页码 → 建立检索索引 → 取回相关条款 → 回答并列出依据。 表格与相邻的例外条件应尽量放在一起,防止切片把它们拆散。
可以保存这段提问模板:
只依据我提供的制度片段回答。先列适用条款、金额、单位、生效日期和例外条件,再计算两晚住宿的常规上限。若没有符合要求的事前审批,不得推定适用650元标准。说明缺失的材料,并引用输入中已有的文件名和原页位置;没有页码就写“待回查”,不要编造。最后将“金额上限计算”和“是否通过报销审批”分开说明。
这段提示词的价值是约束回答过程。它不能修复解析时已经丢失的原文,也不能代替业务核验。
八、还有哪些替代,应该先选谁
同一期横评比较了 Docling、MinerU、MarkItDown,统一考察扫描/表格路径、本地部署、结构追溯、应用集成与代码许可条件。
在这个“费用政策进入可追溯知识库”的任务里,Docling 的文档选型得分为 4.80/5,所以主文先展开它。这个分数评价官方资料支持的实施路径,不是准确率或速度实测。
如果主要处理复杂 PDF 和长文档连续阅读,可以重点试 MinerU;如果只是把文字型 PDF、Office 文件批量转成 Markdown,MarkItDown 是值得先跑的基线。它们的安装方式、许可条件与扫描件处理路径不同,第三篇逐一展开。
先把两页文件里的“500 元常规标准”和“650 元例外条件”分清,再谈批量入库。让答案有出处、让错误能被发现,就是这次动手最值得保留的成果。
来源与验证范围
核验日:2026-10-05。安装与接口依据 Docling 2.133.0 官方资料,示例代码已做语法检查。教学 PDF 已逐页检查;本次尚未完成从 PDF 到导出文件的端到端运行,不报告扫描识别准确率、耗时或生产部署效果。文中的 1,000 元与 160 元来自规则的人工验算,不是解析器输出的实测结果。
- Docling v2.133.0:项目、格式支持、安装与许可
- 官方安装说明:平台、依赖与 OCR 选项
- DoclingDocument:结构与来源信息
- 模型下载、离线使用与远程服务选项
- 2.133.0 中文 OCR 与流水线参数
可复制的资料链接
https://github.com/docling-project/docling/tree/v2.133.0
https://docling-project.github.io/docling/getting_started/installation/
https://github.com/docling-project/docling/blob/v2.133.0/docs/concepts/docling_document.md
https://github.com/docling-project/docling/blob/v2.133.0/docs/usage/advanced_options.md
https://github.com/docling-project/docling/blob/v2.133.0/docling/datamodel/pipeline_options.py