ARTICLE · 1173005
科研人的"救命"翻译工作流,3分钟把PDF变成中文笔记
凌晨一点,你盯着屏幕上第47篇Global Change Biology的PDF,光标在"niche differentiation"和"trophic cascade"之间徘徊——这些术语认识,但连起来到底在说什么?
这不是你一个人的困境。做生态研究的,谁没被外文文献折磨过?组会要汇报、综述要引用、基金要写研究现状,可PubMed一搜就是几百篇英文,还全是图表密集的长文。复制粘贴到翻译软件?格式全乱。硬啃原文?一篇读下来大半天没了。
今天分享一套我们课题组实测有效的AI辅助文献翻译工作流,能把带复杂图表的英文生态学PDF,3分钟内转换成保留原图、术语精准、可直接编辑的中文 Markdown文档。关键是——免费,且专门针对学术场景优化。
一、为什么生态学文献特别难"啃"?
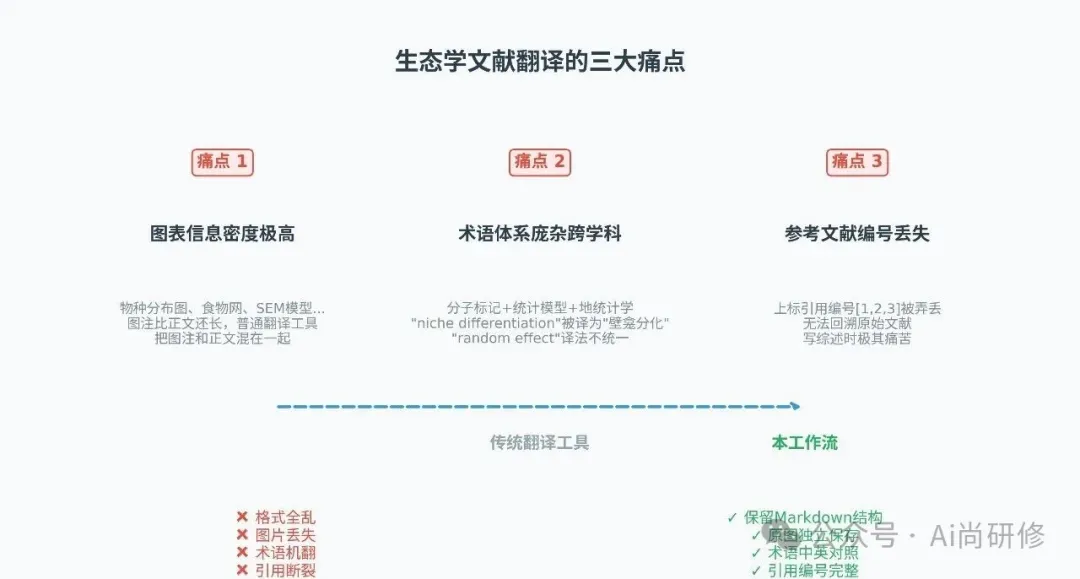
在介绍工具前,先聊聊我们领域的"特殊国情"。这也是我推荐这套工作流的原因——它恰好解决了生态学文献的三个顽疾:
痛点1:图表信息密度极高,图注比正文还长
生态学论文动辄七八个图版:物种分布地图、食物网示意图、SEM结构方程模型路径图、样地布设图……图注(Figure Caption)常常占据半页篇幅。普通翻译工具把图注和正文混在一起,读起来毫无头绪,图片还全部丢失。
痛点2:术语体系庞杂,跨学科到"离谱"
一篇群落生态学文章,可能同时涉及分子标记(如 ddRAD-seq)、统计学模型(如 Bayesian hierarchical model)、地统计学(如 spatial autocorrelation)。术语翻译必须精准——"random effect"译成"随机效应"还是"随机因子",直接影响你对方法的理解;而"niche differentiation"如果被译成"壁龛分化"这种机械直译,根本不知所云(正确译法应为"生态位分化")。
痛点3:参考文献编号不能乱
写综述时,经常需要回溯原文的参考文献列表。很多翻译工具把上标引用编号弄丢,导致你无法对应到原始文献,后续引用极其痛苦。
基于这些痛点,我对翻译工具的要求很明确:保留结构、保留图表、术语可定制、输出格式便于二次编辑。
二、工具准备:给 WorkBuddy 装上"学术翻译"技能
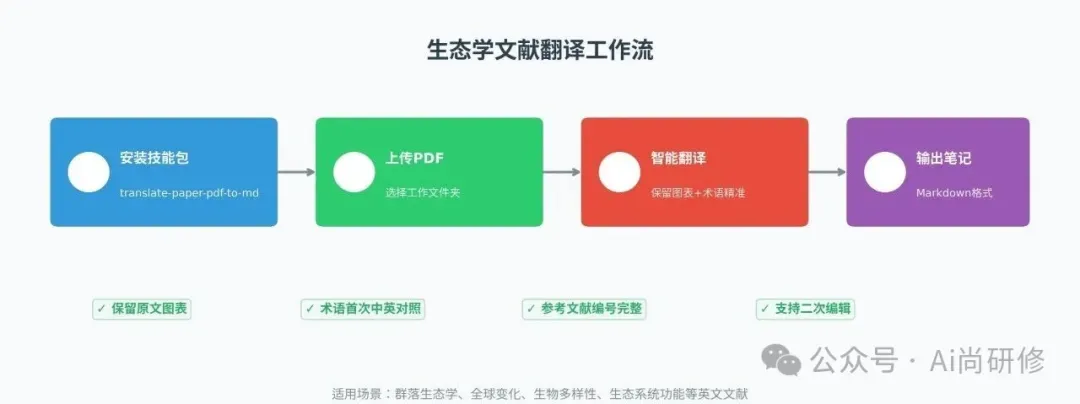
这套工作流的核心是WorkBuddy——腾讯出品的一款 AI 工作台(可以理解为"AI时代的Office")。它的强大之处在于支持Skills(技能包)机制,就像给微信装小程序一样,可以给 AI 安装各种专业能力。
我们需要安装的技能包叫translate-paper-pdf-to-md,这是一个开源的学术翻译Skill,专门将英文学术PDF转换为高质量的中文Markdown文档,同时保留论文结构、图片、表格、公式和参考文献。
安装步骤:
打开WorkBuddy,在对话框中输入以下指令:
请为我安装translate-paper-pdf-to-md skill,github链接:https://github.com/LiuMengxuan04/translate-paper-pdf-to-md
安装完成后,系统可能会提示缺少两个图像处理依赖:Poppler和ImageMagick。这两个工具的作用是增强图表裁剪和页面渲染能力。根据实测,不安装也能完成基础翻译,但如果你经常处理带复杂图版的生态学文献(比如Journal of Ecology、Ecography上的文章),建议装上。
安装指令很简单:
把 Poppler + ImageMagick 也装上
整个过程大约6分钟,WorkBuddy会自动处理Windows环境下的路径配置,甚至能顺手修复上游脚本中的几个兼容性 Bug。
三、实战演示:3分钟翻译一篇森林生态学文献
理论说再多,不如实际操作一遍。这里我用一篇森林生物多样性领域的文献作为示例——这类文章通常包含复杂的实验设计图和多元统计分析,最能检验翻译工具的实力。
Step 1:准备工作空间
在WorkBuddy中新建任务,选择"打开本地文件夹"作为工作空间。建议把待翻译的PDF单独放在一个文件夹里,方便管理输出文件。
Step 2:发起翻译指令
输入指令:
使用 translate-paper-pdf-to-md 技能将 [你的文献名].pdf 翻译成中文 markdown 文件
Step 3:设置翻译偏好(关键步骤)
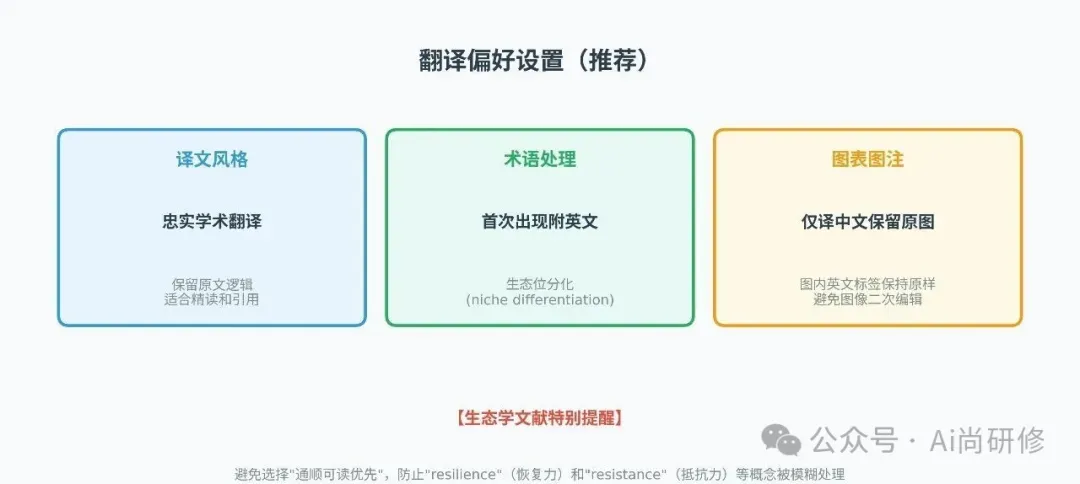
这是我最欣赏的设计——翻译前,系统会让你确认三个关键选项。针对生态学文献,我的推荐设置如下:
特别提醒: 对于生态学文献,强烈建议选择"忠实学术翻译"而非"通顺可读优先"。因为生态学很多概念有严格的定义边界,比如"resilience"(恢复力/韧性)和"resistance"(抵抗力),如果为了流畅而模糊处理,很容易误读原意,影响后续实验设计。
Step 4:查看结果
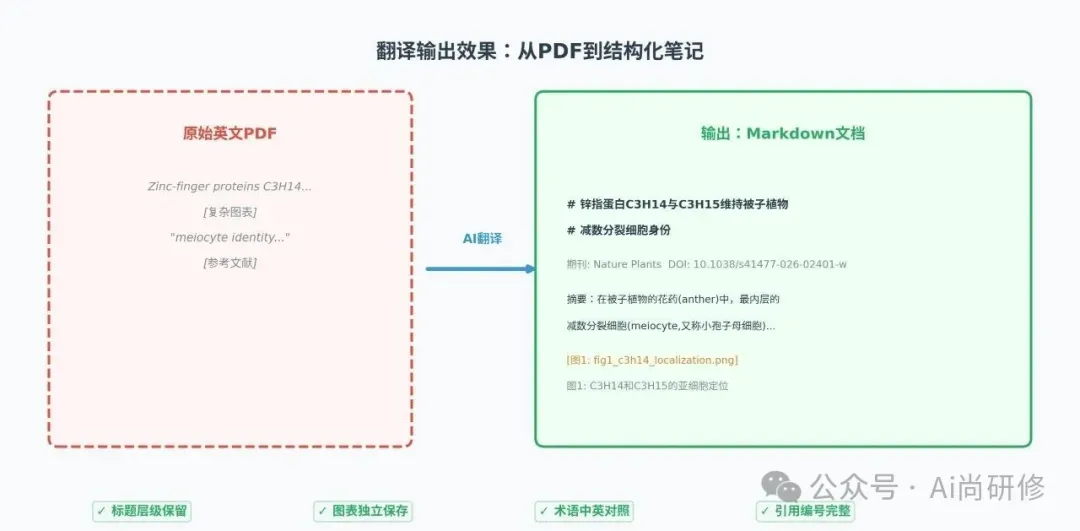
翻译完成后,你会得到一个.md 文件和一个配图文件夹。打开Markdown文件,效果如下:
结构完整:标题、作者、单位、摘要、引言、方法、结果、讨论,层级分明,保留了原文的章节编号
图表分离:所有图片被提取到独立文件夹,正文通过相对路径引用,高清原图随时可查看
术语规范:专业词汇首次出现时以"中文(English)"格式标注,如"群落组装(community assembly)"
引用保留:上标引用编号完整保留,方便回溯参考文献
四、进阶技巧:让翻译结果更"生态学"
虽然技能包本身已经针对学术文献优化,但针对生态学的特殊需求,我总结了三个实用技巧:
1. 自定义术语表,避免"机翻味"
如果你研究的是特定类群(比如传粉昆虫、土壤微生物、浮游植物),可以在翻译前补充说明:
请注意:本文中的 "pollinator" 请译为"传粉者"而非"授粉媒介";"soil microbiome" 译为"土壤微生物组";"phytoplankton" 译为"浮游植物"而非"藻类"。
这样能确保全文术语统一,符合领域习惯。
2. 分段翻译长文献,避免"内存爆炸"
对于30页以上的长综述(比如 Annual Review of Ecology, Evolution, and Systematics 上的文章),建议按章节拆分 PDF 后分批翻译。这样既能控制单次处理时间,也便于分主题整理笔记。
3. 对接文献管理工具,构建个人知识库
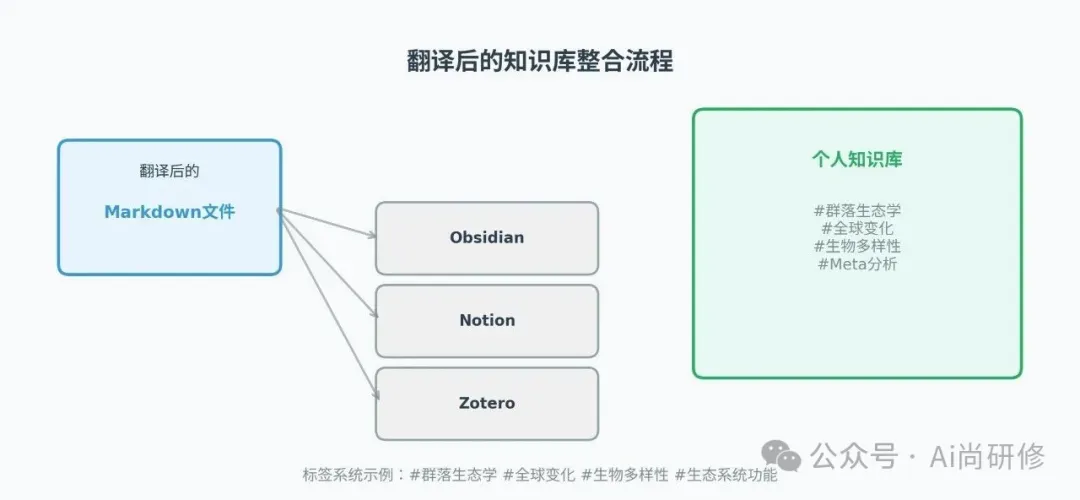
翻译好的Markdown文件可以直接导入Obsidian、Notion或Zotero的笔记系统。我习惯在Obsidian里建立一个"文献翻译"库,配合标签系统(#群落生态学#全球变化#Meta分析),后期写综述时检索效率极高。
五、局限性与注意事项(必看)
任何工具都不是万能的。根据我的使用体验,这套工作流在以下场景需要人工介入:
1. 极复杂的统计公式生态学中常见的贝叶斯层级模型公式、矩阵运算,AI翻译时可能会丢失LaTeX格式。建议对照原文检查方法部分的公式。
2. 领域极新的概念比如2024-2025年才出现的新理论框架,AI可能因训练数据滞后而翻译不准。遇到这类情况,务必回到原文确认。
3. 版权与合规提醒翻译后的文档仅供个人学习和研究使用。如果需要在论文或报告中大段引用翻译内容,建议标注"由AI辅助翻译,经人工校对",并核对原文。此外,该Skill为开源项目(GitHub 可查),建议定期检查更新以获得更好的翻译质量。
结语:把精力留给野外,而不是字典
对生态学研究者来说,文献阅读不是目的,而是产生科学问题、设计实验、撰写论文的手段。一套好的翻译工作流,应该像一台精准的离心机——把外文文献中的"上清液"(核心信息)快速分离出来,让你把更多精力留给思考和创新,而不是耗在逐句查词典上。
这套基于WorkBuddy和translate-paper-pdf-to-md的流程,目前已成为我课题组文献研讨会的标配工具。希望它也能帮你从"读不完"的焦虑中解脱出来,把更多时间留给野外调查和数据分析——那才是生态学家真正该待的地方。
工具获取方式:
WorkBuddy官网下载(腾讯出品,支持Windows/Mac)
GitHub技能包地址:https://github.com/LiuMengxuan04/translate-paper-pdf-to-md
(注:本文所述工具仅为个人使用体验分享,不构成任何商业推荐。翻译结果请结合原文核对使用。)
版权声明