ARTICLE · 1175122
EMNLP 2026 | 多模态文档解析盲区曝光!中大、南洋理工等提出ProSA
同一批文档,受到的干扰面积接近,后面的问答结果却相差不少。
在一组基于 MinerU 的实验中,普通擦除平均覆盖页面的约 0.10%,问答准确率下降 0.4 个百分点;结构性干扰平均覆盖约 0.11%,降幅却达到 7.3 个百分点。两组测试使用相同的问题和回答模型。
干扰面积相近,为什么后果差这么多?
中山大学、混沌摆实验室(Chaotic Pendulum Lab,混沌摆科技)、南洋理工大学的研究人员提出了 ProSA 文档解析评测框架,对比干扰前后的解析结果,定位受损内容,再检查对检索和问答的影响。相关论文获 EMNLP 2026 录取。
论文标题:
How Do Document Parsers Break? Auditing Structural Vulnerability in Document Intelligence
论文地址:
https://arxiv.org/abs/2605.19309
项目地址:
https://github.com/ef1026/ProSA
一行文字消失,段落却还连在一起
文档解析器要把页面转换成可供后续程序使用的内容块,包括文字、表格等,并记录它们的位置。这个过程一旦漏掉内容,后面的检索和问答就可能失去依据。
论文给出了一个直观对比。左侧干扰覆盖页面约 19.9%,虽然一些文字被破坏,主要段落结构仍然保留。右侧干扰仅占约 0.63%,却让解析器跳过一行,把前后不相邻的文字接了起来。
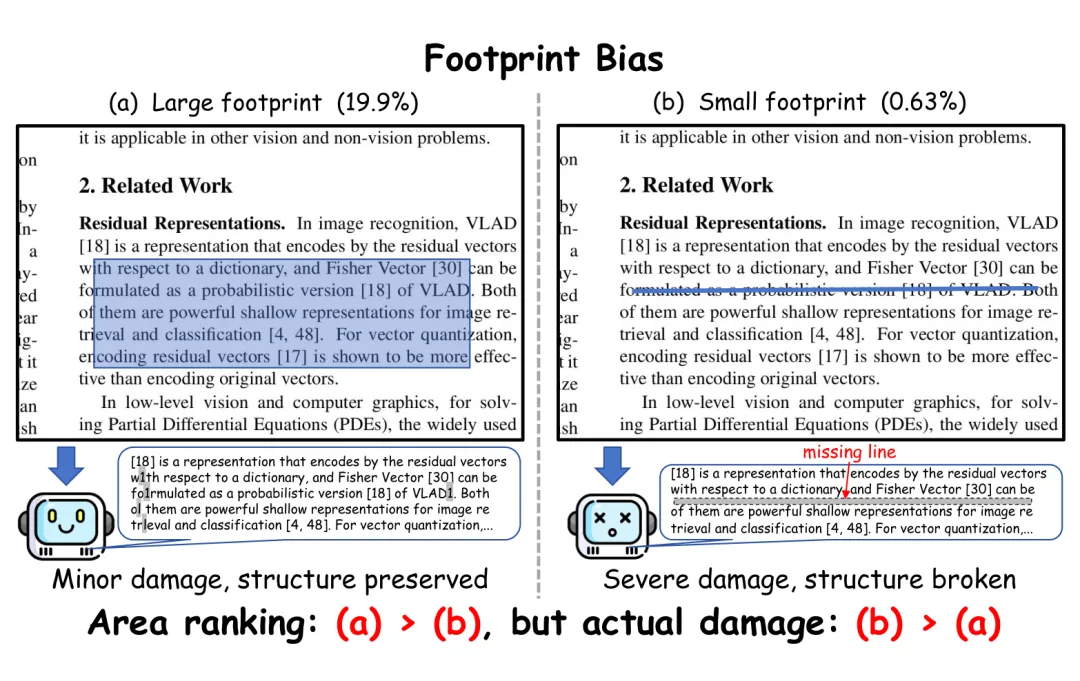
〓 大面积擦除与细小结性干扰的解析结果。右侧出现漏行。原论文 Figure 1。
如果只用受干扰面积衡量破坏程度,这两个结果就可能被排反。论文将这种倾向称为 Footprint Bias,面积偏见。
面积描述了页面上有多少像素受到影响。要判断解析结果丢了什么,还得回到具体的内容块。
ProSA 怎样找到受损内容
ProSA 把检查分成施加干扰和比较输出两部分。
前一部分规定干扰的形状、位置和覆盖方式,再由随机、规则或模型引导的策略选择具体干扰。不同策略共用同一套可选范围,研究者因而可以比较选择位置的方式会造成怎样的差异。
后一部分让同一解析器分别处理原始页面和受干扰页面,再逐个查找原始内容块在新结果中的对应项。
位置和文字,要一起检查。
一个文本框还在原来的位置,并不能说明里面的文字也被保留。ProSA 同时检查框的位置重叠程度和文本相似度。内容块消失,或者附近虽然还有一个框、原有文字却严重丢失,都会被计入 块级结构损失率 B-SLR。
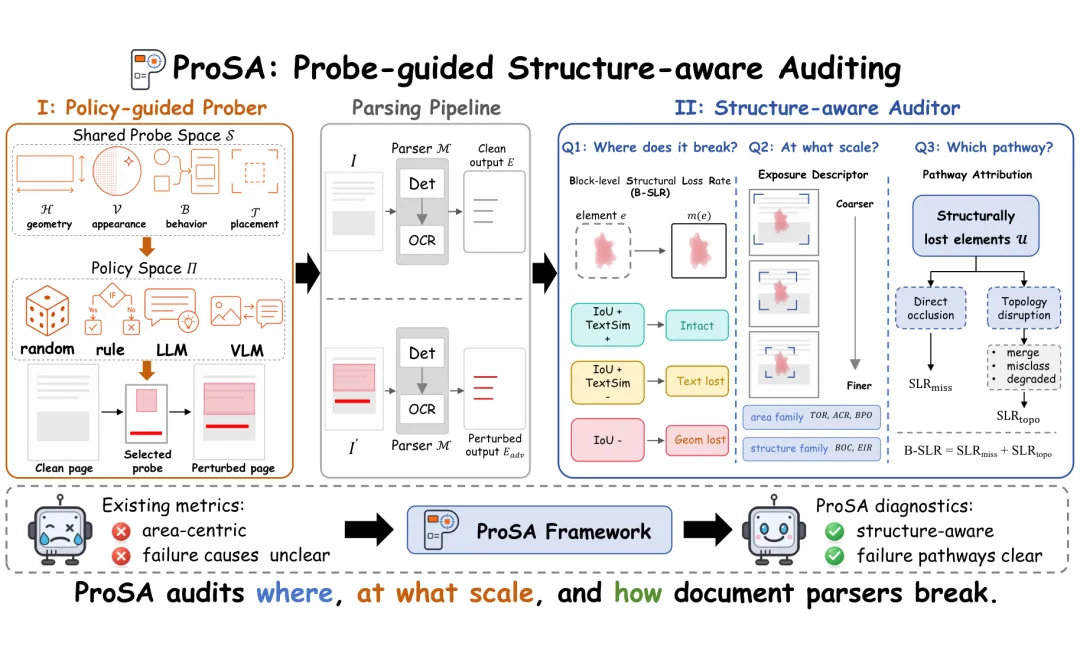
〓ProSA 在同一解析器上比较干扰前后的输出,并结合内容块的位置、文本和受遮挡情况分析损失。原论文 Figure 2。
框架还区分两类情况。一类内容被干扰直接大幅遮住,另一类没有受到大幅遮挡,却发生了结构损失。对后一类,系统继续检查内容块合并、类别改变或文字退化等表现。
这些判断来自解析输出。计算 B-SLR 无需访问解析器内部,也不需要给每个内容块新增人工标注。原始解析结果就是这次对照测试的参照。
解析丢掉的内容,怎样影响答案
团队从 349 页文档中构建了 975 个抽取式问答对。每个标准答案都能在 MinerU 和 PP-StructureV3 的无干扰解析文本中找到。随后固定问题与回答设置,只更换受不同干扰影响的解析文本。
这组测试要求模型从给定文本中提取答案,检验解析后是否仍有足够依据作答。
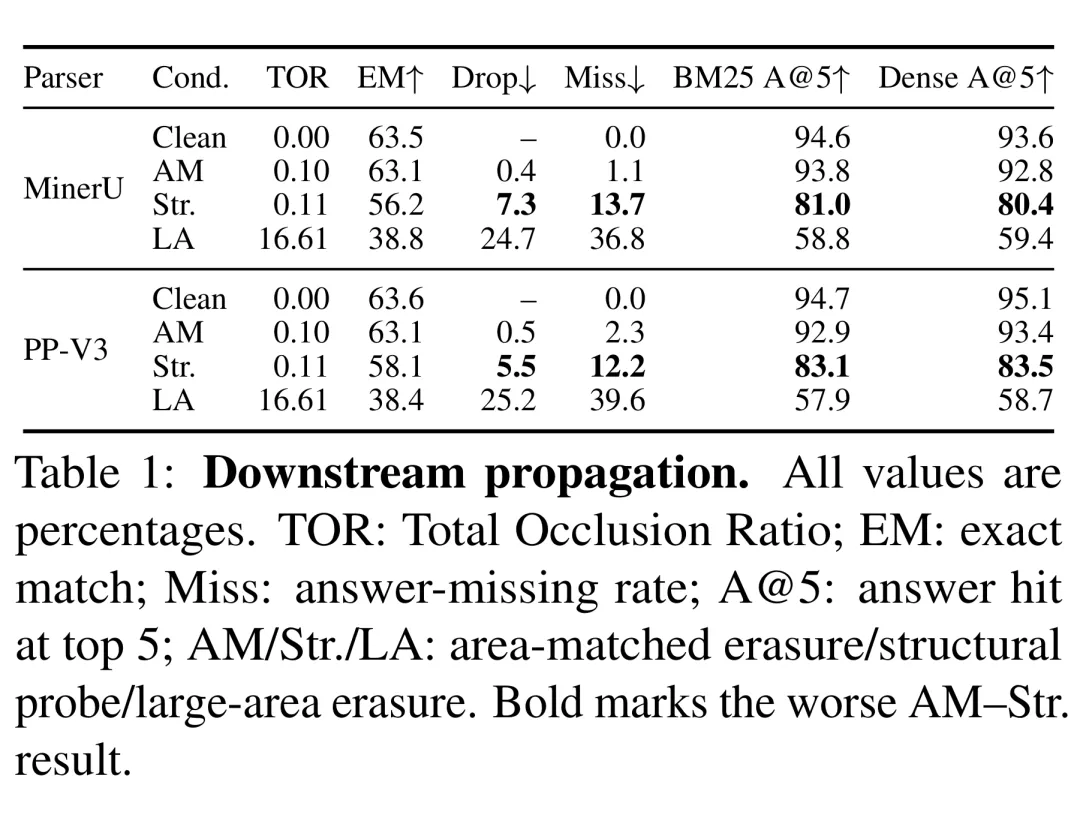
〓 原论文 Table 1。AM 为普通擦除,Str. 为结构性干扰,LA 为大面积擦除。EM 为答案完全匹配率;Drop 为相对无干扰条件的下降,单位为百分点;Miss 为标准答案在解析文本中缺失的比例。
开头的差异也出现在 PP-StructureV3 上。普通擦除使问答准确率下降 0.5 个百分点,面积接近的结构性干扰则使其下降 5.5 个百分点。
在两套系统中,结构性干扰还让约 12% 至 14% 的问题,其标准答案从解析文本中消失。更换另外两种回答模型后,结构性干扰与普通擦除之间的问答表现差距仍然存在。
检索也受到影响。团队只在每个问题所属页面内检索,分别使用 BM25 和稠密检索。普通擦除条件下,前五条结果的答案命中率都超过 92%;换成结构性干扰后,降至约 80% 至 84%。
在这些受控条件下,细小干扰确实会造成后续任务损失。这里测试的是文档内的证据保留和使用,并未覆盖开放式问答或多步推理。
新指标比面积更能反映解析变化吗?
团队又在 PubLayNet 和 DocLayNet 的 1,000 页文档上,用两套解析器分别测试 29 种固定干扰配置,比较 B-SLR、受干扰面积与字符错误率的关系。
这里的字符错误率以无干扰解析文本为参照,衡量识别结果受干扰后发生了多大变化。
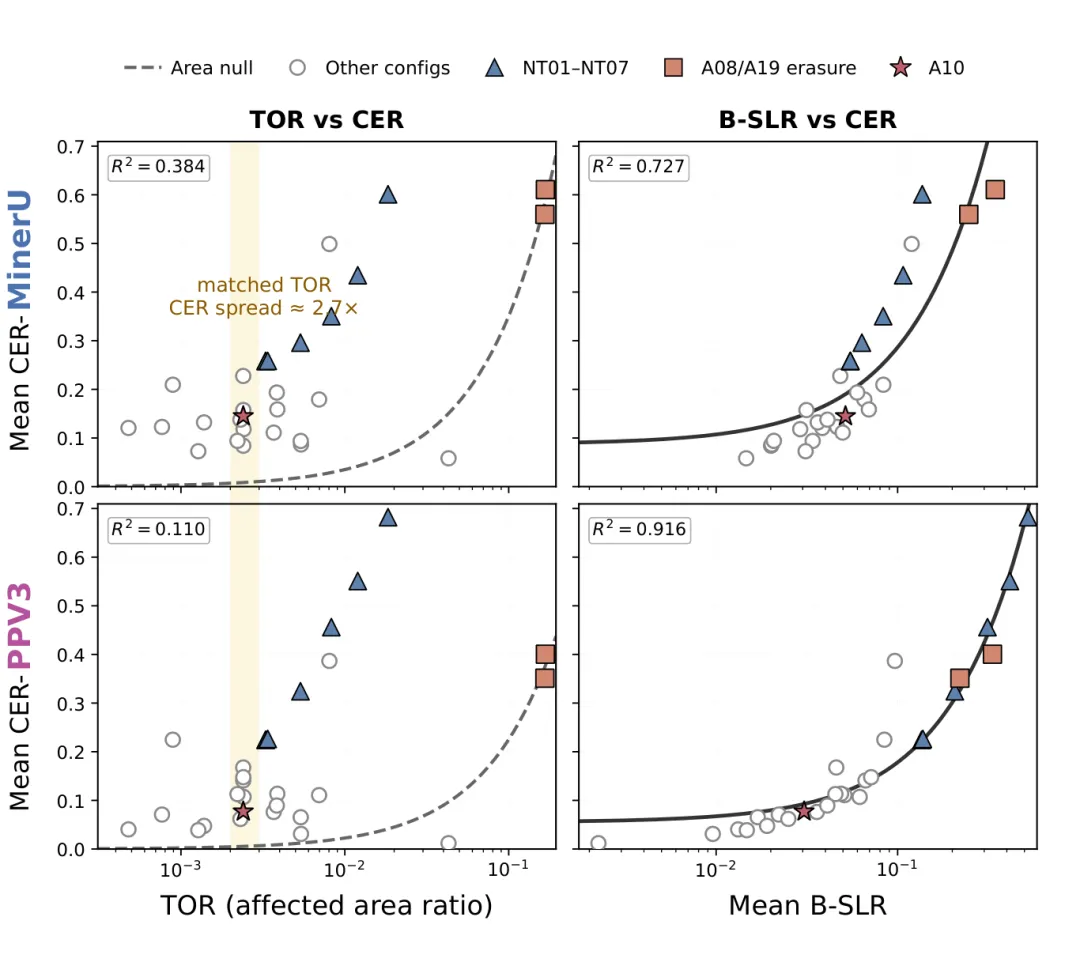
〓 每个点是一种干扰配置在 1,000 页上的平均结果。B-SLR 与字符错误率的拟合关系,比面积指标更强。原论文 Figure 3。
MinerU 上,面积指标对应的拟合 R² 为 0.384,B-SLR 为 0.727;PP-StructureV3 上,两者分别为 0.110 和 0.916。R² 衡量拟合关系,不能当作解析准确率。
团队还调整了匹配阈值,并补充噪声、模糊、JPEG 压缩和亮度变化测试。B-SLR 与字符错误率的关联仍然保持,说明这一关系并不限于最初的干扰配置。
只能复核 10% 的页面,先检查哪些?
这类诊断还可以用于安排复核顺序。
论文在 349 页中,按不同指标各选出 35 页,将所选页面的受干扰解析结果替换成已保存的无干扰结果,其余页面不变。这个模拟用来检查,指标是否选中了对后续任务影响较大的页面。
按 B-SLR 选页后,PP-StructureV3 的问答结果补回了原有准确率降幅的 64.8%,随机选页为 10.3%;MinerU 上对应为 35.2% 和 10.4%。
这是替换已知无干扰结果的模拟,尚未完成实际修复。真正处理这些页面,仍需要复核、重新识别或调用备用解析器。
ProSA 也有明确的适用条件。解析器需要提供内容块的位置、类别和文本;如果只有一段不带位置的纯文本,就需要额外适配。原始解析中已经存在、或干扰前后共有的错误,也可能无法通过这组比较发现。
让复核有具体的起点
ProSA 把页面上的干扰、解析丢失的内容与后续任务表现放在同一组测试中检查。研究者可以据此找到需要复核的页面和内容块,在调整解析流程后重跑测试,观察原来的问题是否改善。
这项工作由中山大学、混沌摆实验室、南洋理工大学的研究人员共同完成。代码已公开,提供了可复用的审计方法。将它用于其他解析系统时,需要满足相同的输出条件,并在目标文档上检验诊断是否有效。
更多阅读