ARTICLE · 1179743
炸了!AI用自然语言就能操作FPGA工具链,时序收敛从3天变3小时
7 个真实战场。把这些战场摆一起你会发现——FPGA 从来不是用来和 GPU 拼"峰值算力"的,它是用来干"GPU 干不好、不划算、来不及"的那些活的。
工程师实话:别慌,但也别装看不见 它取代不了你,但"会用 AI 的你"会取代"不会用的你"。AI 现在能干的是 L1(Copilot 写代码/修语法)和 L2(单链路闭环,如 TimelyHLS 跑 HLS 调优),L3(跨前端后端自主 Agent)才刚在 2026-2027 试点,L4(全自动到 GDSII)业内共识 10 年内不现实——因为芯片要担责,物理约束和全局 PPA 权衡机器拍不了板。 所以最舒服的姿势是:把"读报告、查文档、试约束"这些重复苦力交给 Agent,自己腾出手做架构决策和最终 review。你的价值从"能写 Tcl"升级成"能判断 Agent 改得对不对"。 |
作为常年跟 FPGA 和 EDA 工具链死磕的底层码农,我的第一反应是:先把"自然语言操作工具链""时序收敛3天变3小时"两件事拆开看。结果一查——这次标题党成分有,但底下压着一个 2026 年真得不能再真的行业地震,而且"AI 当 FPGA 工具链操作员"这件事本身就够工程师后背发凉了。
一、先别急眼:两个词,逐一补全定语
① "AI 用自然语言操作 FPGA 工具链"是真的,而且有产品落地了。莱迪思 2026-09 发布的 Lattice Prompt、AMD 的 AMD Ross、以及学术界的 TimelyHLS,都是用大语言模型 + Agent 直接编排 Radiant / Vivado / Vitis HLS:你说人话,它去建工程、综合、布局布线、读时序报告。 ② "时序收敛 3 天变 3 小时"基本站得住,但锚点是 4 小时。Lattice 官方给的真实案例:一个量子纠错解码器(Relay-BP)原本在 Avant 上差 5ns 达不到 200MHz,Lattice Prompt 4 小时找出根因、改约束、跑通;标题写成"3小时"是取整营销,量级没错。 ③ 要打引号的诚实点:这不是"AI 自己设计芯片"。它本质是个会调用工具的 copilot/agent——读报告、给建议、自动改约束和 RTL,最后还得工程师签字确认。把"AI 取代工程师"当卖点,属于过度发挥。 |
结论先放这:标题把"真实落地的 AI Agent 工具链 + 4 小时时序收敛案例"放大成了'3天变3小时'。拆开看,每一块都有真东西,只是别被'AI 取代你'这种话术带节奏。
二、这事不是 PPT:三个真实玩家已经下场
我把能查到的、有实锤的拎出来,你发稿别瞎编:
- Lattice Prompt(莱迪思,2026-09)。
基于自然语言,通过开放 MCP 协议编排 Lattice Radiant,覆盖仿真/综合/map/PAR/时序分析/bitstream 全流程。每个回答都 grounding 在莱迪思官方文档库里,不乱编 API。免费下载,配最新 Radiant。 - AMD Ross(AMD)。
智能体助手,跨 Vivado / Vitis HLS / Vitis AI / ChipScope 自动化硬件-软件协同。时序收敛这块它会自动分类违例路径、识别布线拥塞、建议 floorplan 和约束调整,还支持离线/air-gapped 部署(军工航天爱这个)。 - TimelyHLS(学术界,2025-07 论文)。
LLM + RAG 驱动的 FPGA HLS 优化框架,把 Vitis HLS 的综合日志、仿真结果、时序报告喂回模型做闭环迭代。结果:手工调优减少 70%,最高 4× 延迟加速、明显省资源。
国内也没闲着:合见工软 UDA 2.0 已经喊到 L4(自主设计 Agent 工作流),InsCode 快马 AI 专门适配国产 FPGA(紫光同创、安路)。所以"自然语言操作工具链"是2026 年全行业共识级趋势,不是某家自嗨。
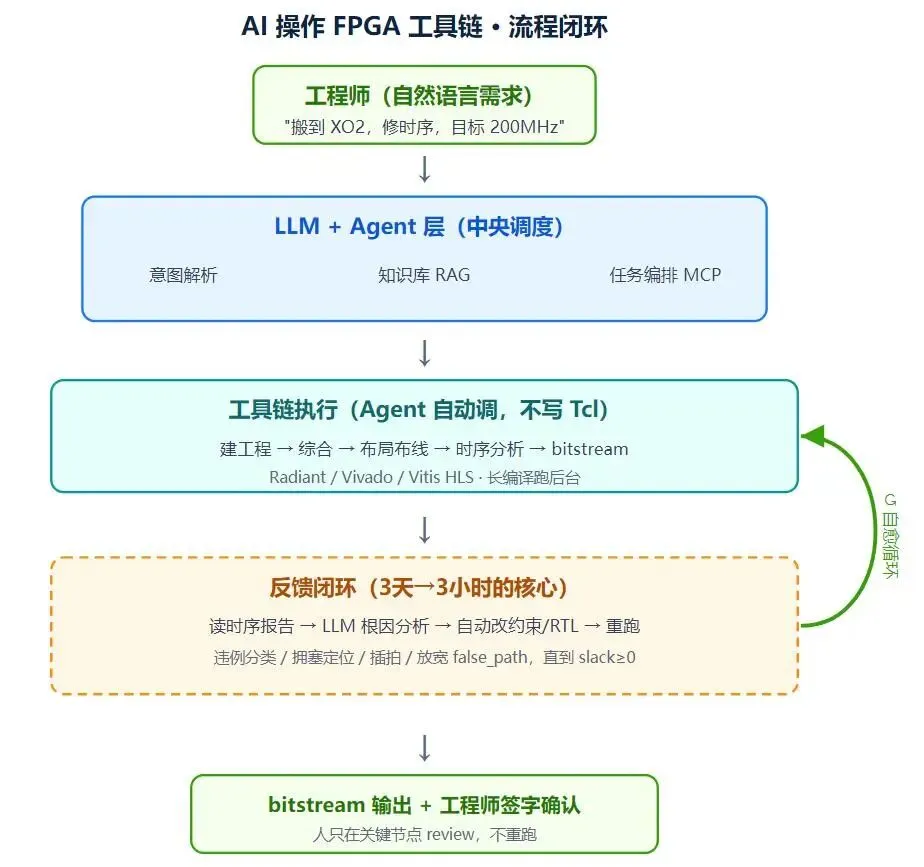
系统框图:自然语言驱动的 FPGA 设计闭环(AI 蹲在哪个坑) ① 意图输入
② 工具链执行(Agent 自动调,不用人写 Tcl)
③ 反馈闭环(这是"3天→3小时"的核心)
↺ 闭环自愈,人只在关键节点签字 |
看清楚没:AI 蹲在"意图→工具→反馈"那个闭环的中央调度位,它不重新发明 EDA,而是把工程师最烦的"读报告、查文档、改约束、重跑"循环自动化了。真正干活的还是 Radiant/Vivado。
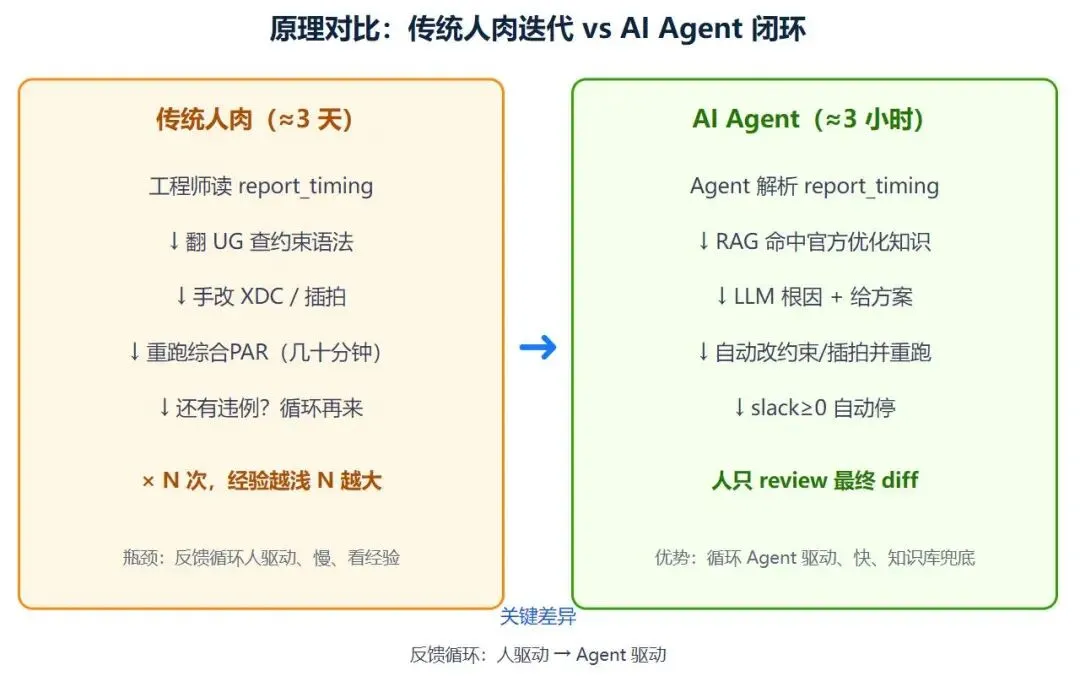
原理图:传统"人肉迭代" vs AI Agent"闭环自愈"
关键差异:反馈循环从"人驱动、慢、看经验"变成"Agent 驱动、快、知识库兜底" |
三、3天→3小时,到底靠什么省下来的
时序收敛这活儿,传统上 80% 的时间花在"读报告 → 查文档 → 试约束 → 重跑"的循环上,而且高度依赖老手的直觉。AI 省的就是这块:
- ① 报告秒级读透。
一份几百页的 timing report,Agent 直接抽违例路径、分类 setup/hold、定位拥塞区,人要看半小时。 - ② 约束不再人肉写。
跨时钟域、false_path、multicycle、IO delay——AI 根据设计自动产出 XDC/SDC,语法还不会错(见下方代码2)。 - ③ 改 RTL 有章法。
关键路径太长?自动插流水线寄存器、拆组合链、做数组分区(见下方代码3)。 - ④ 长编译后台跑。
Lattice Prompt 把综合/PAR 丢到后台或远程 farm,工程师不等工具,连续性不断。
真实战绩对比(来自公开案例) 注:这些是厂商/论文公布的"早期用户"个案,不是行业平均;新手收益最大,老手是"提速"而非"替代"。 |
四、三段核心代码:看清 AI 到底动你哪块
光说概念没意思,上代码。下面三段对应"自然语言操作工具链"的三个真实动作,注释里标了 AI 自动生成的部分。
① Python:用自然语言驱动工具链(MCP 客户端示例)
# natural_language_fpga.py —— 自然语言 -> 工具链调用(MCP 客户端)import asyncio from mcp import ClientSession from mcp.client.stdio import stdio_client # Lattice Prompt / AMD Ross 都通过开放 MCP 暴露工具async defask_fpga_agent(instruction: str): async with stdio_client("lattice-prompt --mcp") as (r, w): async with ClientSession(r, w) as s: await s.initialize() # 一句话需求 -> Agent 自动调 Radiant:建工程/综合/PARres = await s.call_tool("run_design_flow", { "spec": instruction, "device": "LCMXO2-4000HC", "clock_target_mhz": 200}) # 闭环:读时序报告,违例就让 Agent 自愈if res.slack < 0: fix = await s.call_tool("fix_timing", {"violation_ns": -res.slack}) return fix.bitstream return res.bitstream# 工程师只写意图,不写 Tcl bit = asyncio.run(ask_fpga_agent( "把 UART 接收逻辑搬到 XO2,修定时序违例,目标 200MHz")) |
② Tcl:AI 自动生成的时序约束(XDC 示例)
# timing.xdc —— 传统人肉写几十行,现在 Agent 读完报告自动产出# 1) 时钟约束(Agent 从 report_clock 推断周期) create_clock -name clk -period 5.000 -waveform {02.5} [get_ports clk_i]# 2) 跨时钟域(Agent 识别 CDC 自动加异步组) set_clock_groups -asynchronous \ -group [get_clocks {clk}] -group [get_clocks {uart_clk}]# 3) 假路径(Agent 分析后放宽非关键路径) set_false_path -through [get_pins fifo/rptr_reg*]# 4) 多周期(Agent 识别握手协议后添加)set_multicycle_path2 -setup \ -from [get_pins fsm/state_reg*] -to [get_pins crc/dout_reg*]# 5) IO 延迟(Agent 结合外部时序自动算) set_input_delay -clock clk 2.1 [get_ports data_i*] set_output_delay -clock clk 1.8 [get_ports data_o*] |
③ Verilog:AI 给关键路径插拍解决 setup 违例
// mac_pipe.v —— AI 识别 5ns 违例后,把组合长链拆成两级流水// 原版:a+b+c+d 一拍算完 -> 关键路径 3 个加法器 -> 违例 module mac_pipe ( inputwire clk, inputwire [15:0] a, b, c, d, outputreg [31:0] result ); reg [31:0] sum_ab, sum_cd; // 第一拍:拆成两个并行加法 always @(posedge clk) begin sum_ab <= a + b; // 路径1:仅 16bit 加法 sum_cd <= c + d; // 路径2:并行,互不拖累 result <= sum_ab + sum_cd; // 第二拍:两段结果再相加 end// 关键路径:3 个加法器 -> 2 个, setup slack 转正endmodule |
结语
"AI 用自然语言操作 FPGA 工具链"不是吹的,莱迪思、AMD、学术界都下场了,真实案例把时序收敛从几天压到几小时。但记住:它革的是"重复苦力"的命,不是"工程师判断"的命。工具越强,会驾驭工具的人越值钱。
最后留个问题给你们:你们团队现在时序收敛平均要几天?如果丢给 AI Agent,你猜能压到几小时?评论区聊聊,我看哪个数字最离谱。
参考资料(可点开核对) · AMD Ross 智能体助手发布报道(Automation International) · TimelyHLS: LLM-Based FPGA HLS Optimization(Mashnoor et al., 2025-07) · 合见工软 UDA 2.0 / InsCode 快马 AI 国产进展报道 |