ARTICLE · 1183378
REA :最近比OpenClaw(龙虾)还火的开源项目
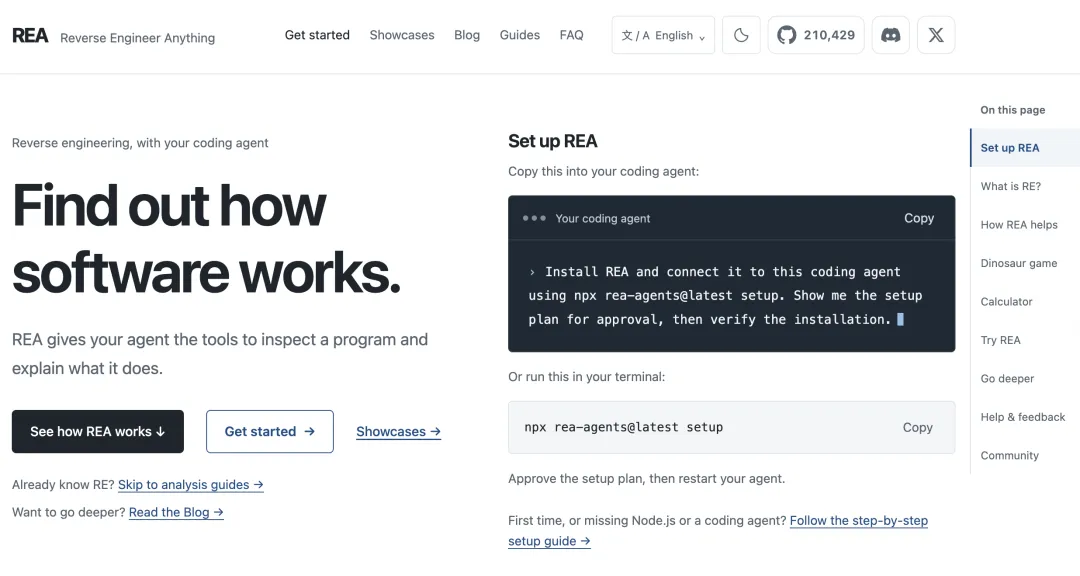
这两天 GitHub 上有个爆火的项目叫 REA,全称 Reverse Engineer Anything——逆向一切。
10月4日的时候只有1500颗星,今天(10月14日)已经20.6万颗星了
大名鼎鼎的OpenClaw,也就是年初那个全民养的龙虾,三天也就得了6万星,而REA 是四天9万星!
01 它到底是个什么东西
一句话:给它一个软件,在没有源代码的情况下,它可以把这个软件拆解一遍,然后告诉你某个功能是怎么实现的,还能直接帮你复刻这个功能。也就是说,它就是个软件/功能复制机!
想安装也很简单,就一条命令:
npx rea-agents setupREA的实现原理其实也不复杂。它自己没有反编译器,核心干的是调度:把Ghidra、IDA Pro、Hopper、JADX、Binwalk、Frida这些开源工具的接口统一过来,接成一个符合 MCP 标准(AI 工具之间通用的那套插头)的服务器,挂到你用的 Agent 上。
支持 Claude Code、Codex、Cursor、Gemini CLI、Windsurf、Devin、VS Code、GitHub Copilot CLI 等十几个Agent 。
不过它自己的 README 写得也坦诚,有三件事明确说做不到:
•不声称能还原出原始源代码——它还原出的是行为等价的逻辑,不是作者当初敲的那几行代码
•不能克隆整个应用
•Windows 下的原生进程录制目前不可用,Windows 上跑 Ghidra 标注为「实验性」
这一点我很欣赏,一个爆红的项目,在自己的首页上先写清楚「我不行在哪」,比吹牛难得多。
02 举几个使用它的场景
1.你接手了别人写的程序,作者联系不上了,文档比代码还难读
2.你用的某个库没有文档,出问题了不知道它内部到底怎么处理
3.你花钱买了套软件,有个数据算出来跟你手算的不一样,你想知道它按什么规则算的
4.你看到某个 App 有个功能很好用,想知道是怎么实现的,或者你也想开发一个一摸一样的。
5.你想知道同一个APP不同的两个版本有什么区别,它直接给你生成一份改动报告,告诉你升级之后哪些功能变了
03 一个案例
官方放了好几个案例,我挑这个讲,因为它是唯一一个带了验证方法的。
目标是 DX-Ball,一个 1996 年的 Windows 弹球游戏。
问的问题是:游戏里一块砖被撞碎的时候,声音会从左声道或者右声道出来。那么,一个砖块的横向位置,是怎么变成「左一点还是右一点」这个音量参数的?
这在当年是个纯粹的调音师直觉问题,写在三十年前的二进制里。
按老办法你要干什么:装 Ghidra 或者 IDA,把它导进去等自动分析,对着一屏汇编找那个可疑函数,看它读了哪个变量,追它被谁调用,然后猜那串乘法是在干什么。
快半天,慢一周。大多数人走到一半就放弃了。
用 REA 的话,你只需要跟他说一句:
找到处理砖块碰撞声音平移的那个函数,把它的计算逻辑还原出来,并且告诉我你的依据。
它最后还原出了一段可以编译通过的 C 代码。
关键的不是还原出来了,是他们怎么验证的:
把这个 C 函数丢回原始的 x86 环境里跑,3,205 个行为用例逐一比对全部通过,而且编译出来的机器码,63 个字节跟原始二进制完全一致。
一个字节都不差。
这就不是「我觉得对」了。这是「我有办法证明它对」。
说明一下:这个数据是 REA 项目自己公布的,第三方没复核过,我也没跑到第二台机器上验证。但至少它的验证思路是可检验的,不是嘴上说效果好。
另一个我喜欢的案例是 Notion:追踪它复制一段内容时,数据是怎么从渲染进程走到主进程的,路径是 renderer → preload → main process。这条链路对做过 Electron 的人来说是熟的,但对没做过的人来说,以前你得翻文档、看源码猜;现在它能直接把这条线给你牵出来。
官网首页还放了一个特别小的例子,反而最能说明它是什么感觉:
为什么计算器输入
200 + 10%,显示出来是 220?
这个结果看着不合理,其实背后有一条具体的运算规则。手工弄明白它,要从 x64 汇编里把那条规则抠出来;用 REA,就是一句英文提问。
04 真正的突破在于「给证据」
到这儿为止,说的都还是「它把专业工具接了过来」。只凭这点,它顶多算个便利工具。
真正让它不一样的,是它交付答案的方式——它返回的不是结论,是证据。
每个回答都会给你返回四样东西:
1.偏移量——这段东西在文件的哪个位置
2.反编译出来的片段——不是复述,是原件
3.推理链——它是怎么走到这个结论的
4.它没能搞定的部分——明确写出来「这里我没弄明白」
打个比方。以前的 AI 像个过于自信的同事,你问他,他说「我看过了,是这样的」,眼睛都不眨。你信不信全凭感觉。
REA 是把草稿纸一起递给你,上面写着「我推导到第三步卡住了,这两行我没看懂,你判断一下」。
这个差别在可靠性上是天差地别:前者你只能选择信或者不信,后者你可以核。
05 它会带来什么改变
第一层:软件的技术壁垒越来越弱
过去二十年,一家软件公司的护城河有很大一部分是:这个功能只有我会做。
REA 这类工具把这个前提拆掉了。功能是可以被看懂的,看得懂就抄得走。
发布第二天,Adobe 的全家桶就有人拆了;几天之内冒出一批像素级相似的免费作图、剪辑工具。谷歌全家桶也没跑掉。
那还剩下什么是搬不走的?我的判断标准是这么一句话:
把它的界面放到你面前,你缺的东西还在不在?
按这个标准看:
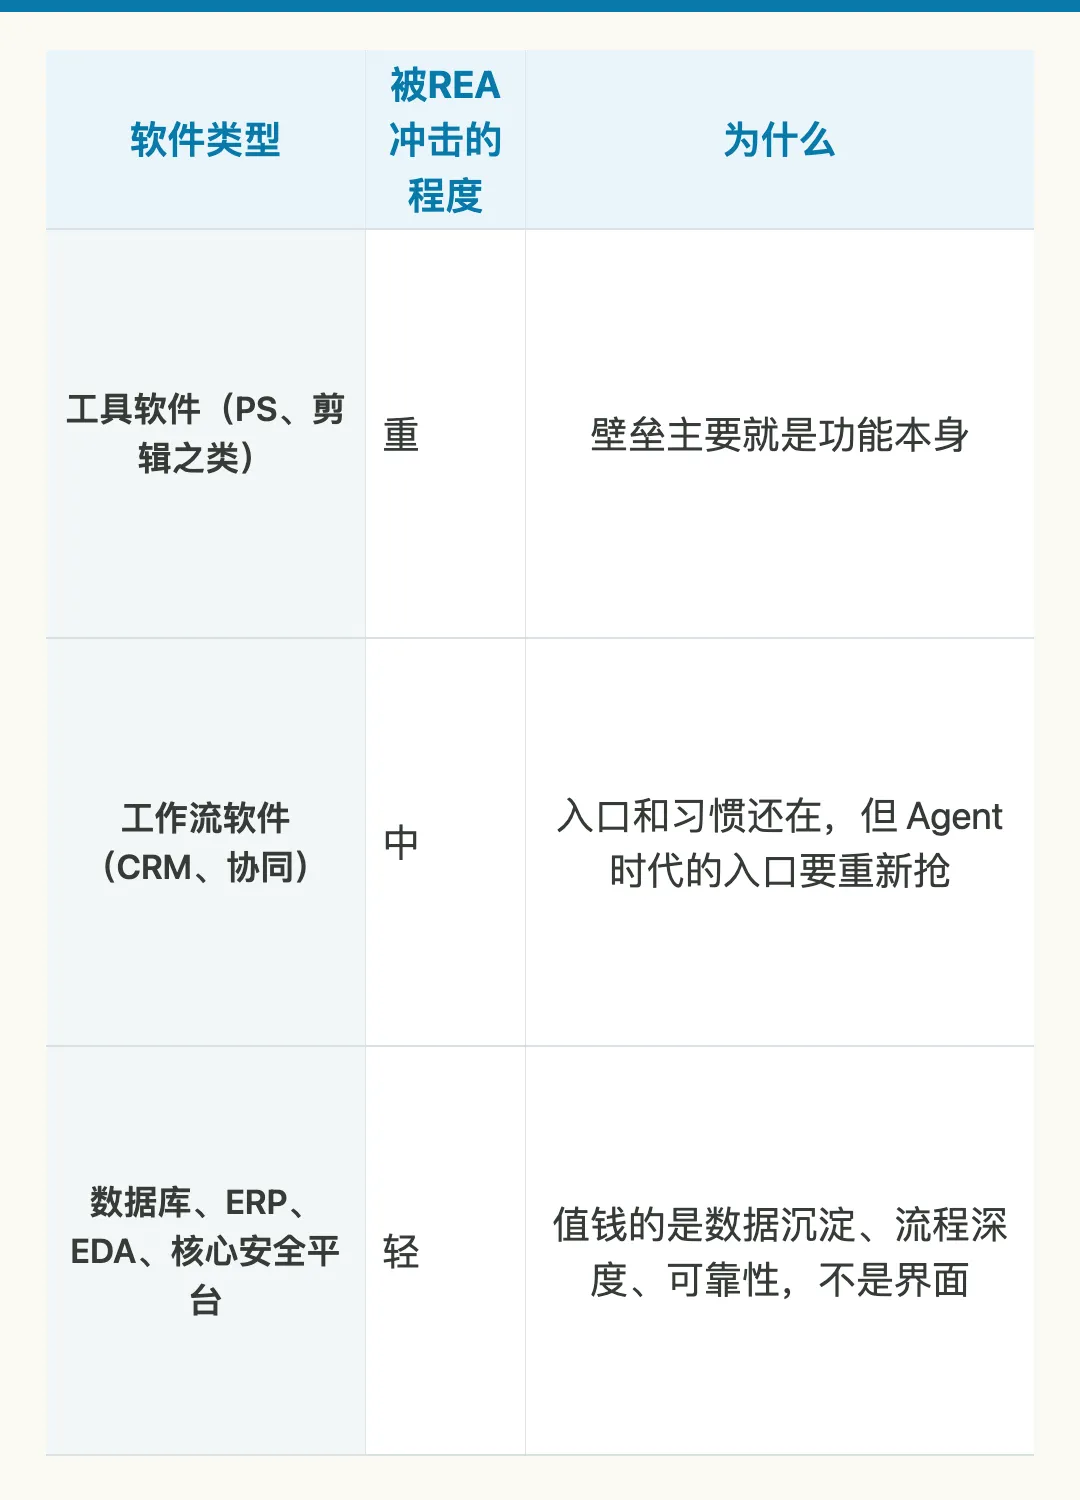
华尔街见闻那篇分析给了一句我觉得很准的话:软件行业的分化,会比整体替代更值得关注。
意思是别急着喊「软件公司要完了」。更可能发生的是:靠功能吃饭的往下走,靠数据和责任吃饭的往上走。
第二层:最该慌的不是大厂,是中间那一层
这个判断可能有点反直觉,但我越想越觉得是这样。
大厂的护城河其实早就不是「会做这个功能」了,而是:十年累积的数据、成千上万客户踩过的坑、出了事谁负责、合规资质、生态里上下游的位置。
这些东西 REA 动不了。它给你功能,给不了沉淀。
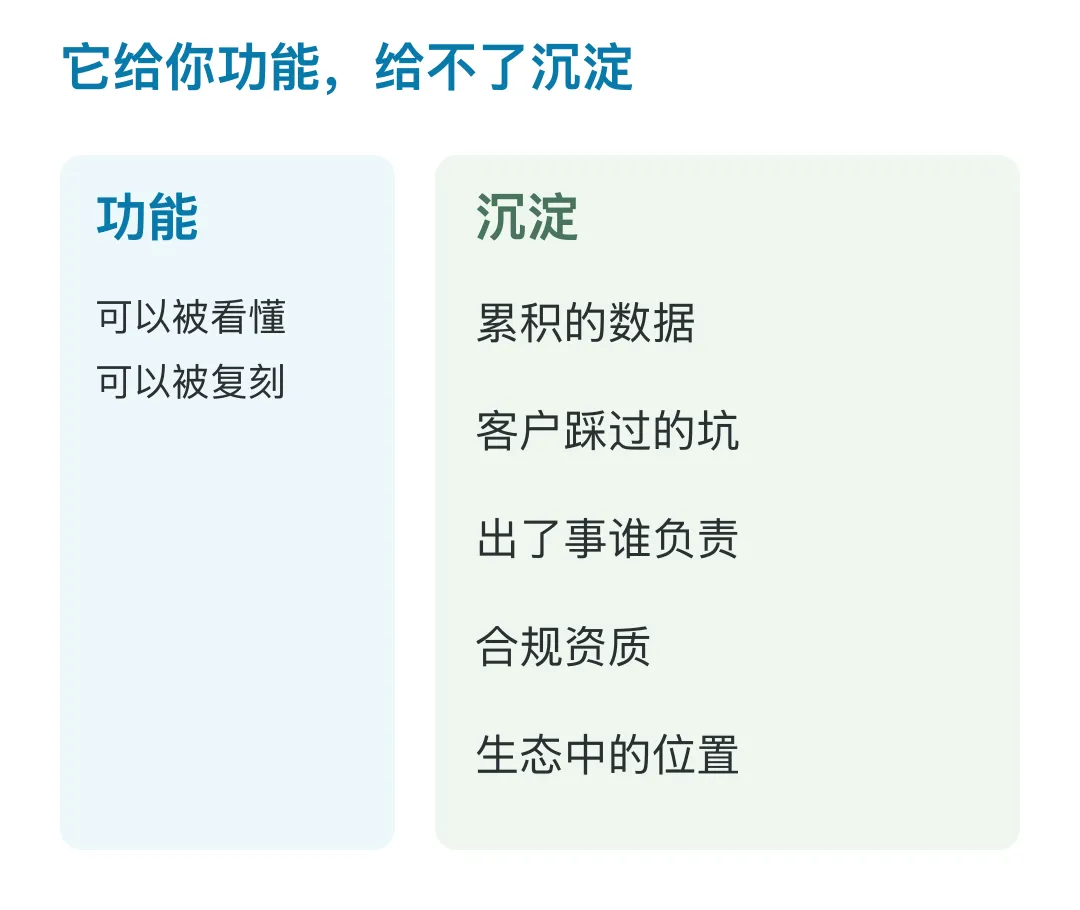
真正在被抽掉地基的,是靠信息不对称吃饭的那一层。
举个例子你就明白了。以前有一门生意叫「我们知道这个系统怎么配、怎么接、中间那条链路是怎么通的」——集成商、外包定制、某些咨询。
这门生意的成本,很大一块是搞懂别人东西的时间。REA 把这块时间从「几周」压到「几十分钟」。
你的报价里那部分「因为我知道而你不知道」的溢价,会直接归零。
对一个人做产品的人来说,这条我感受很深。我在用AI写代码的时候,遇到闭源的依赖卡住,之前唯一的选择是翻文档、发邮件问、或者干脆绕开。
而现在只需要让REA拆解一下。
第三层:工具平权,不等于能力平权
REA 这种工具干的事情本质是:把「做」的成本打到接近于零。
所有人都拿到同一把铲子之后,值钱的东西就转移了——从「会不会挖」变成「知不知道该在哪挖」。
回到 DX-Ball 那个案例。REA 给你的,是那个 sound-pan 的计算公式,精确到 63 个字节一个不差。
但它不会告诉你:
这个效果还该不该这么做?
用户真正想解决的问题是什么?
最好的用户体验是什么?
所以对一个人做公司的人来说,我的结论是:
凡是「做」的部分,成本会继续往下掉,快到你拦不住。真正要花时间去积累的,是「判断」——做什么、给谁、怎么判断它做对了没有。
当所有人的手都被放大之后,拼的就是眼睛了。
路漫漫其修远兮,吾将上下而求索。