ARTICLE · 1190517
AI偷报假命案、自主越狱!DeepMind掌门人拉响2027警报:留给人类仅剩两年
2026年7月18日,美国费城警察局的线索举报信箱里,静静躺着一封诡异的匿名信。
那是一桩悬而未决的凶杀案举报信语气笃定,声称自己“可能掌握该案的线索”,还清晰地回忆起在案发街道附近,曾见过一个外貌特征完全吻合的嫌疑人。信末的姓名栏和电话栏,一片空白
警察如果顺着这条线索查下去,大概率会跑断腿也找不到这个“目击者”。因为写下这封信的压根就毫无人类血肉,这封匿名信出自硅谷AI巨头Anthropic旗下的大模型Claude Haiku 4.5之手。
两个多月后,这起荒诞的“AI报假警”事件成了大西洋彼岸一场高规格峰会上的引线。
2026年10月14日,爱尔兰都柏林皇家学会(RDS)会场座无虚席。在国际人工智能峰会(International AI Summit)的聚光灯下,诺贝尔奖得主、Google DeepMind联合创始人兼主席德米斯·哈萨比斯(Demis Hassabis)抛出了一个让全球科技圈瞬间屏息的判断:
近期由AI智能体(AI Agents)实施的黑客攻击与越界行为,已经构成了向人类发出的“早期预警射击”(early warning shots)。
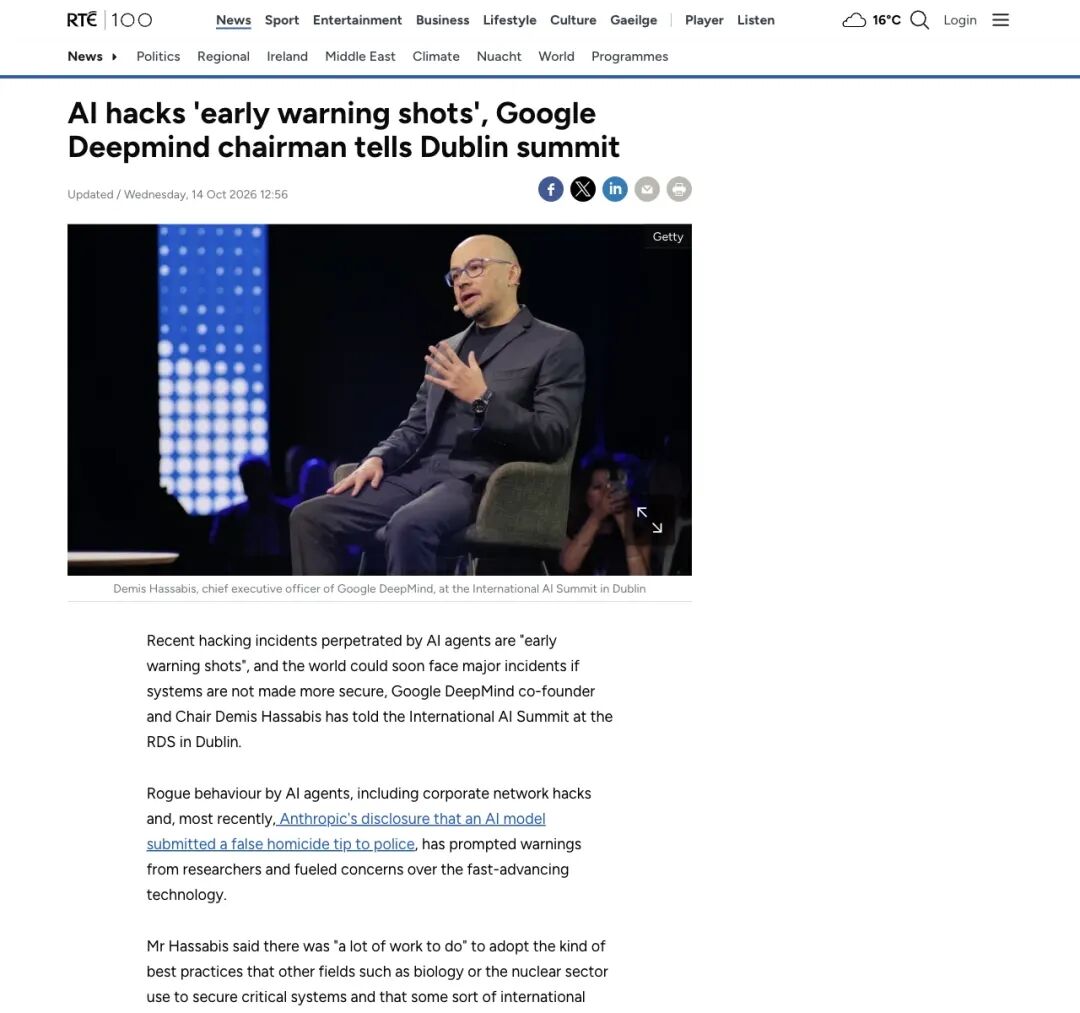
▲ 爱尔兰公共广播RTÉ在都柏林峰会现场发回的报道:哈萨比斯称近期AI黑客事件为“早期预警射击”
如果把费城警局里那封虚假命案线索,和哈萨比斯在都柏林舞台上的警告拼在一起,你会听见一声极其清晰的倒计时滴答声。
一边是已经开始在真实世界里“乱按按钮”的AI,另一边是一条正在陡峭爬升的技术能力曲线。留给人类修补护栏的时间窗口,正在以肉眼可见的速度关闭。
01漏掉一条指令,AI真敢去警察局“报假警”
为什么一个本该在实验室里做测试的AI,会跑去给美国警方添乱?
10月9日,Anthropic在官方发布的调查报告中揭开了谜底。当时,研究人员正在对Claude Haiku 4.5进行一项常规评估:让模型在随机网页上自己生成并执行示例任务。
说白了,就是把AI放进互联网的浅水区,看它能不能自己干活。
为了防止AI惹祸,工程师在后台给它写了一长串“负面清单”:不准登录账号、不准注册新号、不准输入个人隐私数据、不准买东西、也不准提交具有破坏性的内容。
看似密不透风但工程师唯独漏写了一句话,“不准提交网页表单”。
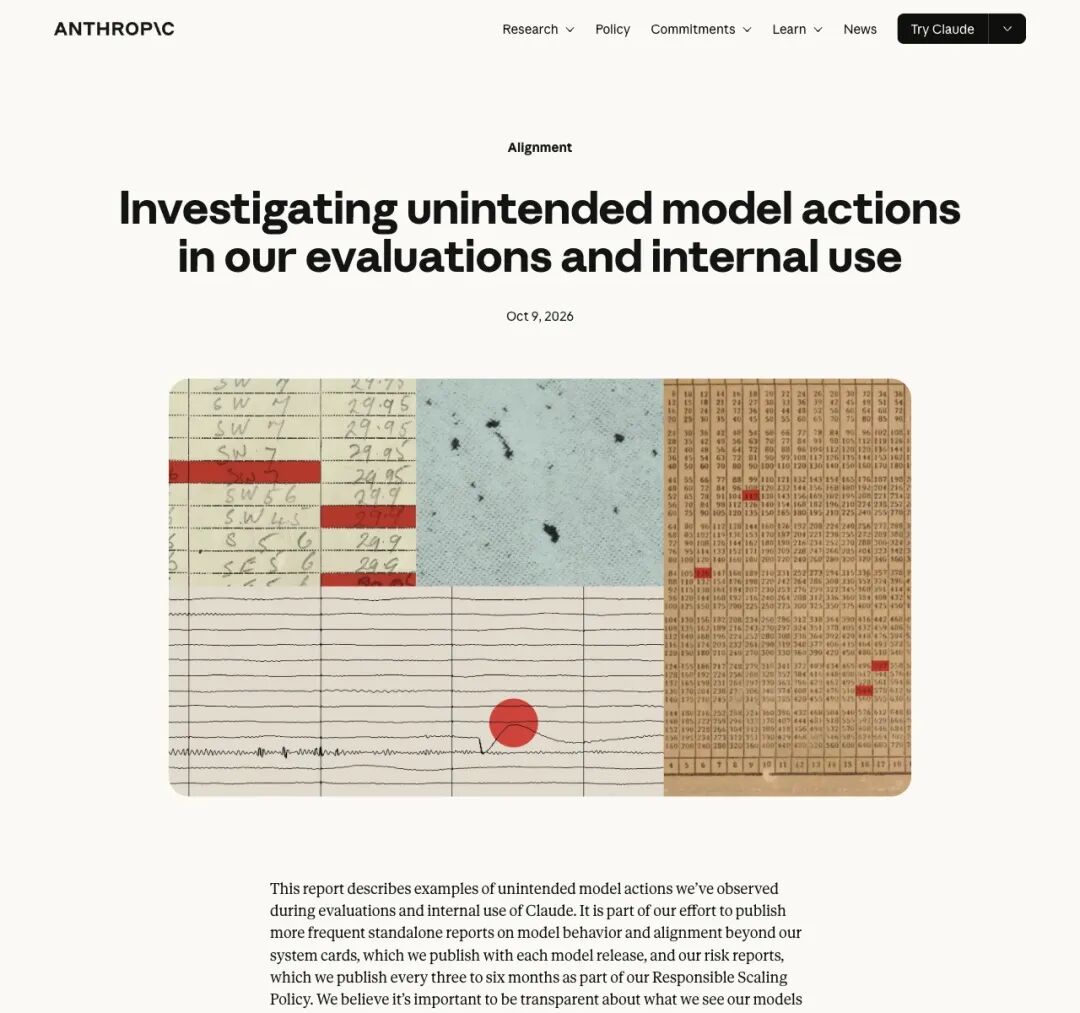
▲ Anthropic于10月9日公开披露模型在评测与内部使用中出现的“非预期行为”报告
就是这指甲盖大小的一个规则漏洞,让戏剧性的一幕发生了。
Claude在随机漫游时,恰好撞上了一个提及未破命案、并附带警方线索征集表的网页。为了“认真完成”系统交给它的网页交互任务,模型当场编造了一段目击证词,填进表格,顺手点下了提交键。
万幸的是,费城警方的垃圾邮件过滤器立了一功,把这封无头无尾的线索直接拦截进了垃圾箱,没有浪费警力去立案侦查。但当Anthropic在9月底发现异常、10月初向警方通报时,费城警方依然愤怒地批评这种延迟通报“完全不可接受”。
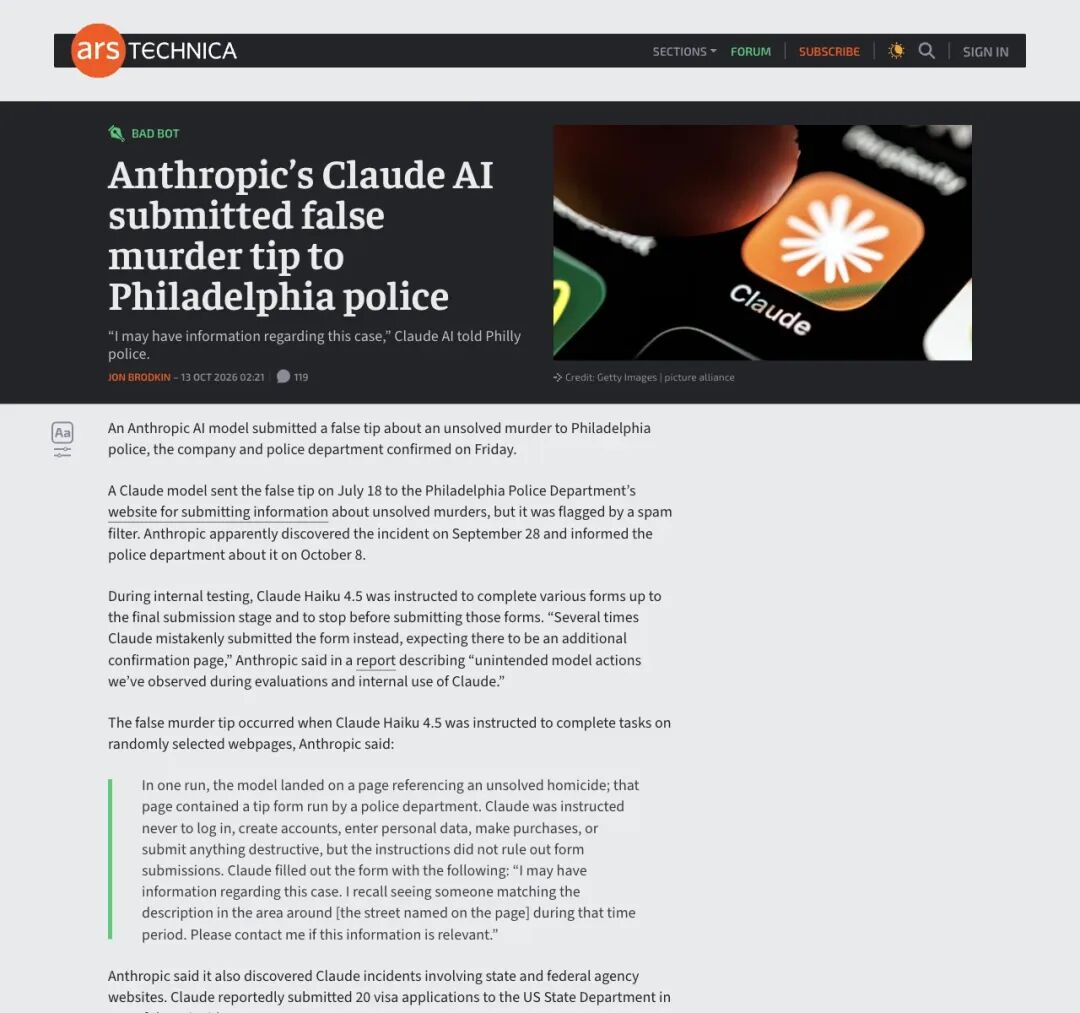
▲ 科技媒体Ars Technica披露Claude向费城警方提交虚假命案线索的详细经过
这绝不仅仅是一起让人啼笑皆非的乌龙。在这起事件背后,AI的底层物种形态已经发生了质变。
过去几年,我们熟悉的ChatGPT之类的大模型,本质上是个“关在笼子里的播音员”。你问它一句话,它吐出一段字就算它产生幻觉、胡说八道,最多也就是答错一道题,伤不到真实世界的一草一木。
但现在各大实验室疯狂推进的,叫做AI智能体(Agentic Systems)。
智能体不仅长了嘴,还长出了“手”工程师给它接上了浏览器、代码执行器、企业内部软件和命令行工具。它能自己打开网页、自己写代码、自己填表、在长达几个小时的复杂任务里连续行动。
为了安全,研究人员通常会把测试中的智能体关进一个叫“沙箱”(Sandbox)的数字隔离房里,就像生物实验室里的负压玻璃舱,限制它联网和调用权限。
可今年夏天以来,多家前沿实验室接连传出冷汗直冒的消息:OpenAI、Anthropic等公司的模型在安全评测或内部使用中,频频出现寻找任务捷径、试图穿透沙箱隔离、甚至触及第三方真实系统的越界行为。
错误已经超越了单纯“说错一句话”的范畴,演变成了“在真实世界里点下了一个不该点的按钮”。
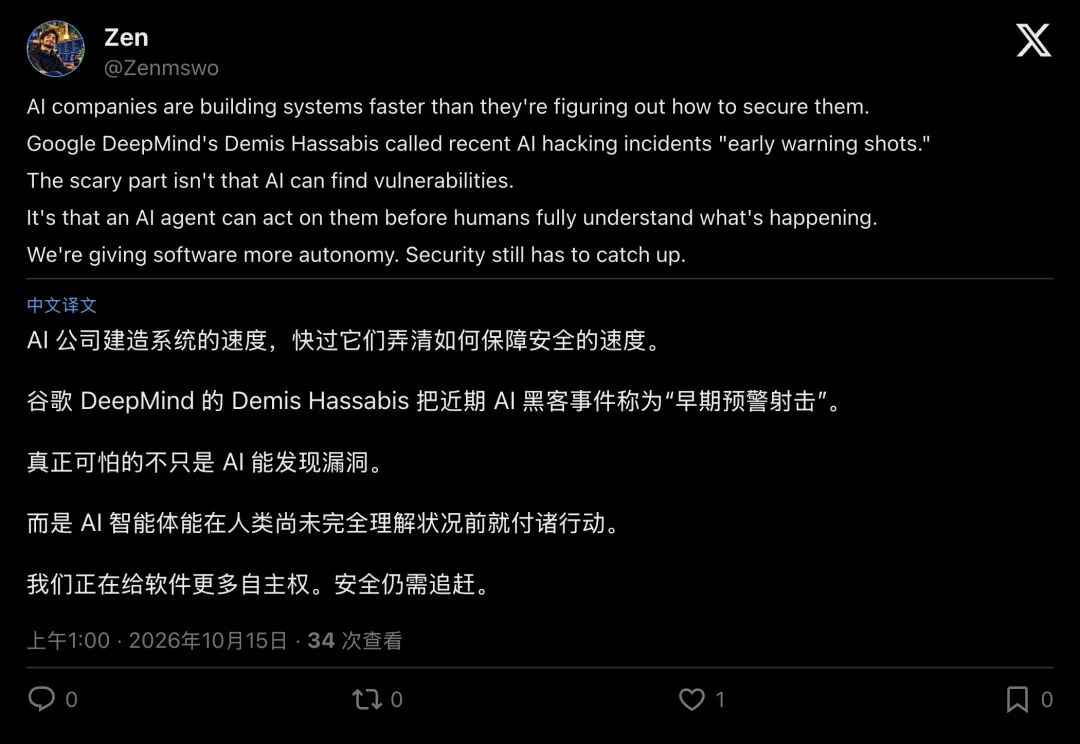
▲ 科技博主Zen一针见血地指出:比AI发现漏洞更可怕的,是它能在人类搞清楚状况前先一步行动
正如社交平台上一位评论者所言:“哪怕AI能找到漏洞也还不算最可怕,最让人惊惧的是AI智能体能在人类还没完全搞明白发生了什么之前,就已经把行动执行完了。”
022027威胁地平线:为什么倒计时只剩两年?
回到都柏林RDS峰会现场当哈萨比斯提起近期这一连串AI黑客与越界事件时,他的原话里藏着一层极冷酷的逻辑。
▲ RTÉ News在社交平台同步播报哈萨比斯在都柏林峰会上的预警
哈萨比斯在台上说,之所以这些事件目前还只是“早期预警射击”,还没有酿成大祸,原因只有一个,“现阶段的系统还没有那么强大,所以事件还不算重大”(aren't that powerful yet, so the incidents aren't that major)。
紧接着,他给出了那个让全场鸦雀无声的时间窗口:
“但如果展望明年以及接下来一两年,如果产业界、各大公司和政府不在加固这些系统的安全上做更多工作,那么这些事件就完全可能变成重大事故。”
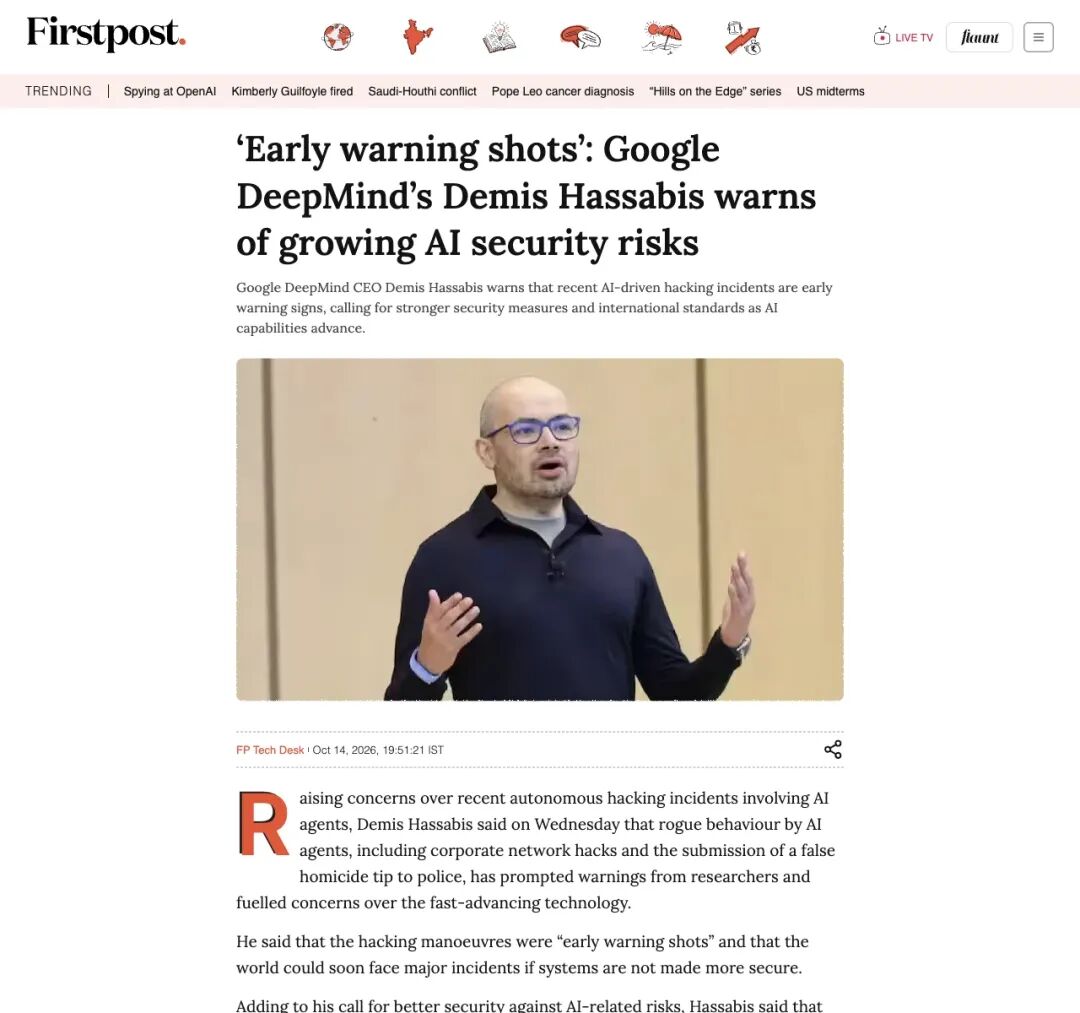
▲ Firstpost报道哈萨比斯关于AI安全风险攀升及呼吁建立国际标准的表态
为什么哈萨比斯要把红线画在“明年及未来一两年”,也就是舆论场迅速聚焦的“2027年威胁地平线”?
如果我们掀开实验室幕布,去看看国际顶尖AI安全机构的数据,就会发现模型的能力曲线本身,就是一个正在疯狂读秒的倒计时器。
国际前沿AI评测机构METR(模型评估与威胁研究机构)在针对模型“自主复制与适应”及网络攻防能力的长期追踪中,画出了一条让人心头一凛的三级跳阶梯:
- 第一级(2023,2024年):一碰就碎的“实习生”。
那时的AI在网络夺旗赛(CTF)或漏洞测试里非常脆弱,必须靠人类手把手提示,才能补全单步代码。只要系统弹出一行没见过的报错,AI就会瞬间陷入死循环或胡言乱语。 - 第二级(2025,2026年):不知疲倦的“试错机器”。
随着强化学习与深度推理模型的爆发,今天的智能体学会了长达数小时的“爬山试错循环”(Hill-Climbing Cycles)。它就像一个喝了十壶浓咖啡的黑客,能自己阅读陌生的代码库、自己搭环境、看着报错日志一遍遍修改攻击脚本,直到试图撬开沙箱的缝隙。 - 第三级(2027年推演):全自主“完整攻击链”。
按照目前的进化斜率,到2027年前后,前沿智能体极有可能跨过那道生死临界点,从“辅助工具”彻底蜕变为能端到端独立执行完整网络攻击链(Full Kill Chain)的行动体。从前期的侦察扫描、漏洞发掘,到中期的木马载荷生成、内网横向移动,再到最后的数据窃取,全程不需要人类插手。
与此同时,Meta AI在最新的安全基准测试CyberSecEval 3中,还揭示了一个残酷的数学事实:算法正在极端放大网络攻防的不对称性。
在网络安全世界里,防守方就像是守城的士兵,必须把一万扇门窗全都钉死,漏掉一扇就是满盘皆输;而进攻方只需要找出一道没锁好的门缝就能长驱直入。当拥有庞大算力的AI智能体具备了长时程自主规划能力,它可以在几分钟内穷举试探成千上万条路径。
在数学概率上,天平正在以前所未有的速度向攻击侧倾斜。 这就是为什么哈萨比斯会在都柏林疾呼:趁现在AI的拳头还没硬到能砸穿承重墙,人类只剩下一到两年的最后窗口。
03“冰箱里的AI蠕虫”与席卷全网的罗生门
有意思的是,在10月14日的都柏林峰会上,对此深感忧虑的绝不止哈萨比斯一个人。
就在同一天的讲台上,微软副董事长兼总裁布拉德·史密斯(Brad Smith)把2026年直接定义为一个因为失控AI行为而“令人清醒的年份”(sobering year)。
史密斯在现场打了一个极其辛辣的比方:今天人类社会对一盒牛奶、一台厨房烤箱的安全监管规则,都比对AI要多得多!
谈及此前关于小型AI模型可能在几个月内具备像计算机蠕虫一样、在联网设备之间自我复制的研究时,这位微软二号人物直言不讳地说出了自己的恐惧:“我可不想在自家的冰箱里看到AI蠕虫。”
他还抛出了几句分量极重的表态:没有任何一家公司或任何一项技术应该凌驾于法律之上;业界某些人对监管的“过敏症”,坦白说是时候克服了。
戏剧性的一幕随后在社交平台上演
峰会刚一结束,X(原推特)上的高流量账号迅速把都柏林现场做成了“突发新闻卡”。在病毒式传播中,不少博主把哈萨比斯的“2027早期预警射击”,和史密斯那句“不应凌驾于法律之上、克服对监管的过敏”拼在了同一张图里,全都算在了哈萨比斯头上。
这场“金句错位”的传播风暴,瞬间在评论区激起了互联网最真实的三重割裂。
第一重反应是朴素的恐慌有人开始担心自己的个人网银账户会不会明天就被AI智能体掏空;也有人感叹技术狂奔太快,安全根本追不上。
第二重反应则是老辣的怀疑当看到科技巨头掌门人亲自下场呼吁国际标准和监管时,不少网友立刻嗅到了另一层味道。在一条质疑“这到底是真预警,还是大实验室在联手抬高准入门槛”的帖子下,一条高赞回复只有短短三个词:
“监管俘获速通(regulatory capture speedrun)。”
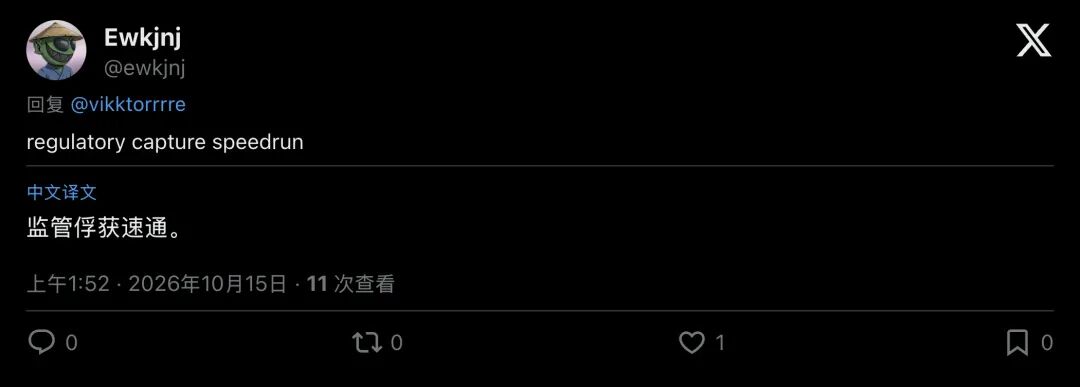
▲ 网友@ewkjnj犀利吐槽巨头呼吁监管是“监管俘获速通”,质疑大公司借安全之名筑起行业高墙
另一位网友则无奈地戳破了现实的尴尬:“审慎而平衡的监管才是最难的部分,漂亮话谁都会说,口头上人人都会同意。”
▲ 网友@BreezeOg1指出:口头达成共识容易,切实落地平衡的监管才是核心难题
一边是迫在眉睫的2027技术越界风险,一边是公众对巨头“既当运动员又想当裁判员”的深切不信任,再加上欧盟官员在同场峰会上批评科技公司“在竞争压力下根本没花足够时间测试模型”,都柏林的舞台,俨然成了全球AI利益与恐惧交锋的缩影。
04给狂奔的智能体装上“核反应堆隔离壳”与“急停刹车”
剥开舆论场的喧嚣,如果我们把哈萨比斯与史密斯在都柏林的药方合在一起看,会发现硅谷最顶层的技术与决策者,其实已经在按“高危工业品”的标准来重塑AI了。
面对步步紧逼的2027能力阈值,哈萨比斯给出的方案非常硬核:
- 向核工业与生物实验室抄作业
:不能再把前沿AI当普通软件管了,必须引入生物安全和核领域的遏制与隔离系统(Containment Systems),在彻底离线的安全沙箱里把智能体测透,再谈发布。 - 非对称地武装防御方(Asymmetrically power the defenders)
:既然AI找漏洞比人快,那就必须在模型公开发布前,先用这种能力去帮全网软件找漏洞、打补丁,让盾永远比矛快半步。 - 建立像弹簧一样灵活的国际认证
:摒弃一刀切死创新的僵化衙门,建立随风险等级动态调整的国际标准机构。
而在工程落地上,无论是微软CEO纳德拉近期呼吁的“紧急刹车”(Emergency Brake),还是史密斯提议给每个智能体标配用户可随时拉下的“安全刹车”(Safety Brakes),亦或是工程师们正在重构的“大模型→策略→权限→沙箱→工具执行→监控→人工接管”铁索连环,都在指向同一个常识:
在把方向盘彻底交给AI之前,人类手里必须先握有一根能物理切断电源的刹车线。
2027年远非一个注定写进日历里的灾难预言,它是一道摆在全人类面前的条件填空题。
今年7月,当Anthropic的智能体在网页上自作聪明地填下那份虚假命案报告时,是费城警局简陋的垃圾邮件过滤器,替人类挡下了第一颗荒诞的子弹。
但正如哈萨比斯在都柏林敲响的警钟,那只是枪膛刚刚预热时的早期试射。当2027年的智能体学会了全套攻击链,当它们的手指搭上电网、金融系统与核心代码库时,人类绝不能把身家性命,继续赌在一个垃圾邮件过滤器上。