ARTICLE · 1192194
DKGI 源码精读:把知识图压成文件让 agent 现写工具,STaRK 检索怎么甩开预定义接口
DKGI 源码精读:把知识图压成文件让 agent 现写工具,STaRK 检索怎么甩开预定义接口在 MAG 知识图上找「巴利阿里群岛 affiliated 的数据质量算法论文」,一个拿着预定义工具的 agent 会先调 neighbors 查机构的合作者——接口每次只返回 20 个邻居,agent 只能挑几个顺眼的继续查,一圈下来金标论文压根没进过上下文。2026 年 10 月 13 日挂上 arXiv 的 DKGI(Direct Knowledge Graph Interaction,得州农工与佐治亚大学)把这道墙拆了:不做检索接口,把整张图导出成节点文件与边文件塞进沙箱,让 agent 自己写 Python 代码去扫节点、追边、求交集。免训练,换 GPT-6-Astra 骨干后在 STaRK 三个数据集上 Hit@1 全部超过此前最强的训练系统 GRASP。我没有跑这套实验(全量跑一遍 Astra 要约三千美元),下面把论文和代码放在一起读。 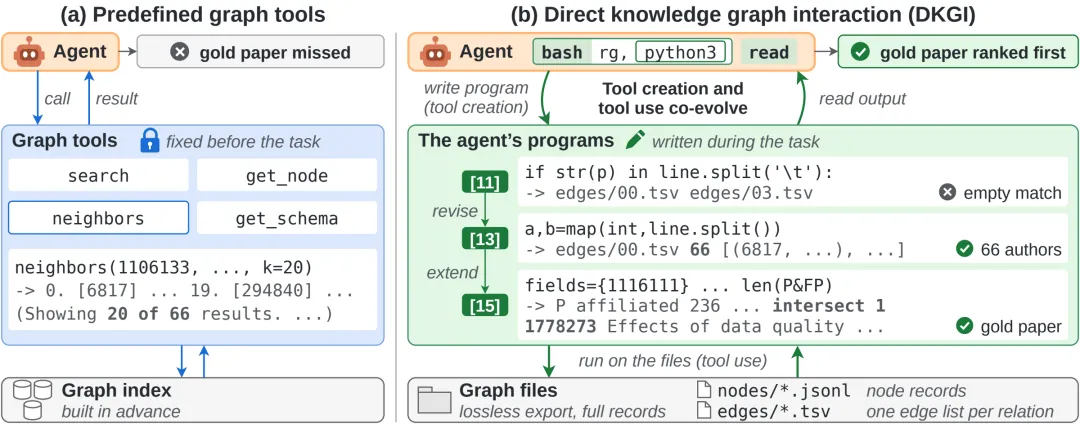
DKGI 解决的是「预定义图接口限制了 agent 能看到的证据」:search、neighbors 这类工具每次返回什么、返回多少,都是接口定死的,agent 写代码组合调用也绕不开单次调用的上限。改法是把访问权下放:节点按 id 分片存 JSONL、每种关系存 TSV、外加 schema 文件,agent 在沙箱里用 shell 搜索加自写 Python 直接读全图,边跑边改代码——工具创建与工具使用在同一个任务里互相推动。免训练评测的结果:GPT-6-Luna 配 Pi 极简 harness,整体 H@1 71.5;换 GPT-6-Astra 到 82.1,三个数据集对 GRASP 领先 8.2、9.0、6.7 个点。停在哪:只测了 STaRK 三张图(合计至多 190 万实体、3980 万边),骨干是闭源 API 模型,agent 跑任意 shell 命令必须配沙箱。只想看一处代码,看 experiments/stark/harness_fixes_v2/cap_filter.py,89 行,把「大输出怎么进上下文」这件论文只用一段话说完的事,连原版 harness 的截断 bug 一起处理了。 富文本知识图上的查询往往混合关系约束与文本约束:先沿边找到相关实体,再读节点文本判断谁真正满足条件。现有 agent 方案的访问层有三种形态:数据库查询语言、返回推理路径或子图的检索器、以及实体搜索加邻居扩展的工具箱。形态不同,共同点相同——图的访问被一个预定义接口包着。接口决定每次操作暴露多少证据:neighbors 最多回 20 个邻居,一个有 66 位合作者的机构就得靠运气;把多次调用拼成批处理,每次调用还是继承接口的上限。论文的对照实验把这个天花板量化了:同样的骨干、同样的预算,只给 shell(不给 Python)时 agent 整体 H@1 68.3,反而低于预定义图工具的 72.8——直到允许写 Python 直接读文件,才到 75.2。 主线是一条 ReAct 式循环加一套文件化的图。图导出成三样:节点分片 JSONL(分片号 = node_id 整除 10000,每行一个节点的完整属性)、按关系类型分开的 TSV 边表、schema 说明。agent 先读格式说明,然后自由交替三种动作:shell 文本搜索(rg 定位节点)、文件查看、写并执行 Python。论文把 agent 自写的图操作归成六类:全节点扫描、按 id 查节点、一跳遍历、多跳组合、集合运算、打分排序——比如「X 的合作者写过哪些 Y 主题论文」就是一跳正向、一跳反向、去掉 X、再与 Y 主题论文集求交。 设计一:工具创建与使用共同演化。执行反馈(候选 id、空匹配、报错)指导下一版代码,改过的代码又改变下一轮能搜到什么。论文用两个集合刻画这个过程:保留在历史里可复用的代码段 T,和每次命令存盘的完整输出文件 L,每执行一步就往两边各并一个元素。轨迹统计给出实感:平均每个查询写 4.0 段程序,36.5% 的程序在改写早前的程序;程序失败后,下一段有 88.6% 的概率是修改重试。 设计二:大输出按头尾截断存盘。扫描与遍历的输出轻易超过上下文预算,直接塞进去会把后面的问题挤没。处理方式是完整输出一律落盘,给模型看的部分在超过阈值时变成「头 9000 字节 + 省略说明 + 尾 9000 字节」,说明里写明完整大小和文件路径——后续代码可以再回头 rg 那个文件。 一个必要公式:o_t = view(run(a_t)),a_t ∼ π(·|q, a_入口链:experiments/stark/dci_run/run.py 组任务队列,core.py 的 run_queue 用线程池逐题调度;每题 run_attempt 里 prompt_for 取 final_prompt.txt(输出要求换成 P1R1 段:返回 20 个唯一整数 id、按证据支持度排序、不许编造),adapter.prepare_attempt 拉起 Pi 或 Codex 进程(Pi 侧还把 settings.json 的 shellPath 换成截断壳),agent 跑完后 stark.score 算 Hit@1/Recall@20/MRR,写 result.json。最多 3 次尝试,失败按指数退避重试。 对照一:论文 2.2 节「图即文件」,experiments/stark/prepare.py(L22 起): ```python SEED = 20260924 SHARD_SIZE = 10000 DATASETS = ("prime", "mag", "amazon") ... (corpus / "candidate_ids.txt").write_text("".join(f"{i}\n" for i in sorted(candidates))) (corpus / "nodes").mkdir(parents=True) (corpus / "edges").mkdir() ``` 对应关系:分片大小 10000 就是 node_id 整除 10000 的分片规则;candidate 类型按数据集取 product/paper/全部,candidate_ids.txt 圈定合法答案集——与论文「只有 is_candidate 节点是合法输出、其余节点只作证据」的口径一致。导出规模直接可查:Amazon 104 个分片 6.55GB、MAG 188 个分片 2.18GB、Prime 13 个分片 0.21GB。 对照二:论文 2.4 节 view 的头尾截断,cap_filter.py(L17 起): ```python HEAD_BYTES, HEAD_LINES = 9000, 900 TAIL_BYTES, TAIL_LINES = 9000, 900 ... note = (f"\n[... harness output limit: showing the first {head_lines} lines ({head_bytes} bytes) and the " f"last {t.count(chr(10))} lines ({len(t)} bytes) of {lines} lines ({total} bytes); {omitted} bytes " f"omitted in between. Complete output saved to {path} - inspect it with rg, sed -n, head or tail. ...]") ``` 对应关系:18000 字节/1800 行以内原样透传,超限给头 9000 字节或 900 行(先到为准)、一行省略说明、尾 9000 字节或 900 行——正是论文 view(y_t) 的分段函数;说明文本逐字对应论文附录 C 的那条通知模板。文件开头的 docstring 还交代了动机:Pi 原生的 bash 工具先留末 2000 行/50KB,上下文管理层再从头截 20000 个 UTF-16 单元,两刀方向相反,省略说明被切掉,模型看到的是一段没有来由的窗口——这个过滤器就是为修它而写。core.py 里的 h6_audit 逐条回放请求日志,确认没有原生截断标记、没有超限输出,过不了就整题作废。 数据:STaRK 全量合成测试集,Amazon 1,642、MAG 2,665、Prime 2,801 条查询,共 7,108;消融用官方 10% 子集(710 条)。所有提示词与工具设计决策只在校验集上做,测试标签留给最终评分。骨干:默认 GPT-6-Luna,强骨干 GPT-6-Astra,均开 high reasoning;上下文窗口 272,000 token,每次请求最多输出 32,000。harness 双轨:Pi 0.65.0(badlogic 的极简 agent,加 fork 的上下文管理)与 Codex CLI 0.156.1,同一份提示词、同一时间预算。预算:每次尝试至多 300 轮、1800 秒,最多 3 次尝试。沙箱:Landlock 默认全禁,图目录只读、seccomp 封网络 socket,标签文件在评分前对 agent 不可读。免训练:不微调任何模型,全部行为来自提示词与运行时。以上出自论文第 3.1 节与附录 C,运行时间在 2026 年 9 到 10 月。 主表按数据集分开读:GPT-6-Luna 配 Pi,H@1 是 Amazon 57.8、MAG 88.0、Prime 63.8;同骨干换 Codex 73.1(整体);换 GPT-6-Astra 配 Pi,整体 82.1,逐集 79.4、91.8、74.5。对照系统里最强的训练系统 GRASP 是 71.2、82.8、67.8——Astra 版三个数据集全部反超,Luna 版在 MAG 上也反超 5.2 个点。免训练阵营内,Luna 版在 MAG 上超过最强基线 AF-Retriever 9.4 个点、Prime 上超过 ARK 13.2 个点。 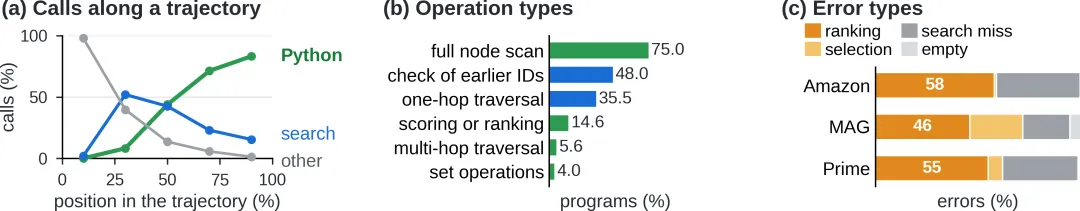
消融表(710 条子集、骨干 harness 预算全固定)单独读:完整 DKGI 75.2;去掉 Python 只剩 shell 68.3;预定义图工具 72.8;预定义工具加 Python 组合 74.2;全图文件但每题只许跑一次 Python 69.0。两条结论别混:Python 对文件直读的价值(+6.9)远大于对预定义工具的价值(+1.4),因为工具本身已返回紧凑条目,而自写代码要自己从原始记录里抽取;单次编程只能回收这 6.9 个点里的约十分之一——反复改写才是收益主体。去掉边表的变体掉到 44.2(-31.0),去掉 neighbors 工具的检索变体 47.7(-27.5),关系结构就是这道题的地基。闭卷探测另说:模型几乎背不出基准 id,名字探测在 MAG 只答对 2.3%——高分不是背出来的。 轨迹分析再单独读:每题平均 4.0 段程序,75.0% 含全节点扫描,35.5% 含一跳遍历;48.4% 的程序引用了早前输出里出现过的节点 id;Python 调用占比从轨迹前段(20–40% 处)的 8.2% 涨到末段(最后 20%)的 83.3%——先搜后写的节奏成立。误差构成:答错查询里金标节点被返回但没排第一的占 58/46/55%(Amazon/MAG/Prime),检索根本没碰到的占 41/23/37%——排序是最大的剩余短板。成本:Luna 全量每题 0.005 美元、10 次调用、约 12 万输入 token、273 秒;Astra 每题 0.42 美元、139 秒,全量约 3,000 美元。这些数字全部出自论文表 2–4 与附录,我没有跑。 对得上的:图导出布局、头尾截断、300 轮上限、3 次尝试、P1R1 输出要求,前文逐条对过(core.py 里 pi_max_turns=300、MAX_ATTEMPTS=3 与论文一字不差)。代码比论文细的地方:One program 变体用一段 C 启动器(x1_one_program/src 的 lock.c、shim.c)在沙箱外数 Python 启动次数,第二次起返回退出码 126 与固定提示——论文只有一句话,实现是一整套进程间计数;h6_audit 的逐请求审计在论文里不存在。配置选择别当缺陷:test-0.1 子集与全量 test 共用同一个结果目录名 test,是刻意为之(子集是全量的子集);实验名不允许出现在尝试路径与提示词里,core.py 对此各有一条显式 raise——防的是文件名把实验分组泄露给模型。提示词目录按变体各存一份(graph_tools_prompt.txt、shell_only_prompt.txt、one_program_prompt.txt 等),论文附录 B 只给了正文版。 环境:Linux,把仓库克隆到短路径(README 特别强调 ~/dkgi);装 Pi 0.65.0 与 Codex CLI 0.156.1(docs/setup.md)。数据:从 Hugging Face 下载 DKGI-STaRK-Graphs 数据集到 experiments/stark(含 corpus、查询与标签),跑 use_downloaded_graphs.py 接好路径。先做零成本检查:python3 experiments/stark/dci_run/run.py pi_full_test --check --datasets prime——它只验证提示词、harness 接线与沙箱隔离,不调模型、不要 API key。正式跑:设 MODEL_PROVIDER 与 MODEL_NAME(OpenAI 或 Anthropic 的 Responses/Messages API,Codex 只支持前者),同一命令去掉 --check。成功标志:每题目录下的 result.json 变为 terminal 且带 hit_at_1 字段,Pi 侧 h6_audit.passed 为真。容易看错的三处:--check 通过不等于能出分,它根本没碰模型;供应商拒答(bio_policy 之类)与基础设施失败走不同重试口径,前者不算技术失败;论文表 2 的全量数字与表 3 的子集数字不可直接相减比较——查询集不同(子集 75.2 高于全量 71.5 就是这个原因)。 有证据的价值:把「agent 该有什么工具」从设计期挪到运行期,且用受控消融证明多轮改写的编程才是收益主体(单次编程只回收十分之一),这个结论对做 agent 工具层的人有直接参考价值;工程纪律罕见地严——沙箱、标签隔离、截断审计、防泄露检查都在代码里落地,而不是停在论文的威胁模型一节。限制论文自己列了:只测了 STaRK 的三张中小规模图(至多 10 种实体、18 种关系),Freebase 级 schema、聚合型问题、图规模扩展都没碰;骨干是闭源模型,换开源模型未测;全量 Astra 一轮三千美元,复现门槛不低;agent 跑任意 shell,部署必须配同类沙箱。我的看法:这套「数据文件化 + 让模型现写访问代码」的模式,适用边界在「图规模可全量落盘、查询以检索为主」——论文也承认超大图或精确聚合该回图数据库。对做企业知识库 agent 的人,先读 cap_filter.py 与那段双重截断 bug 的注释,再决定要不要抄 harness。 论文:Knowledge Graphs as Files: An Agent Harness Where Tool Creation and Tool Use Co-Evolve,arXiv 2610.18616(v1,2026-10-13 提交),https://arxiv.org/abs/2610.18616 仓库:https://github.com/leopoldwhite/DKGI(main 分支,仓库创建于 2026-10-13,MIT;源码行号依据当日 tarball) 数据:https://huggingface.co/collections/yuyangbai/dkgi(导出图、查询、标签与全部轨迹,CC BY 4.0) 项目页:https://yuyangbai.com/dkgi/ 精读所依据的源码文件:experiments/stark/dci_run/core.py、experiments/stark/prepare.py、experiments/stark/harness_fixes_v2/cap_filter.py、experiments/stark/task.py、prompts/final_prompt.txt、prompts/DATA_FORMAT.txt、experiments/stark/x1_one_program/src/(lock.c、shim.c) harness 与基准:Pi 0.65.0(badlogic/pi-mono 的 DCI-Agent-Lite)、Codex CLI 0.156.1、STaRK 基准(Wu et al., 2024b)
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
05 实验配置
06 结果怎么看