ARTICLE · 1192189
超越共识,寻求AI的下一条增长曲线 | 春华Pivot
超越共识,寻求AI的下一条增长曲线 | 春华Pivot
过去几年,AI世界有一条近乎牢不可破的信念:更大的模型、更多的参数、更强的GPU、更庞大的集群,意味着更强的智能。这条路径仍在发挥作用,也远未走到尽头。 但技术史反复证明,一项技术能否真正释放巨大的经济价值,不仅在于它能够达到多高的水平,也在于有多少人能够用得起、用得好。 从大型计算机到个人电脑,从昂贵的通信服务到无处不在的移动互联网,技术的普及往往催生出比最初用途更加广阔的市场。 AI是否也正在接近这样的转折点? 在春华资本2026全球投资者大会的一场闭门研讨中,共绩科技付智、行云集成电路季宇、面壁智能李大海和苏度科技张校珩,从算力调度、芯片、模型和具身智能四个不同位置,讨论了同一个问题:除了继续突破智能的上限,能否通过提高智能密度、降低使用成本、提升部署效率,让AI成为更加普遍、可靠和易于获得的生产力? 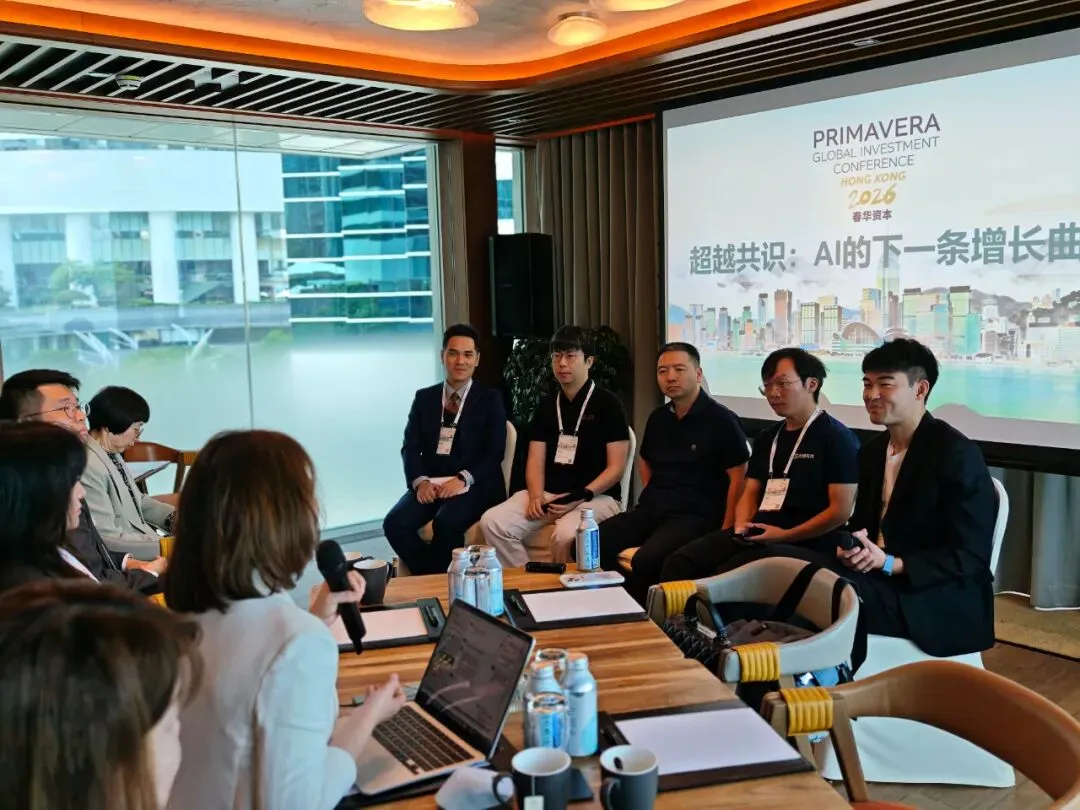
主持人、春华人工智能投资负责人李光裕在开场时提出,当AI已经成为创业和投资领域的巨大共识,市场既怕错过,也担心泡沫。面对快速变化的技术,更需要回到第一性原理:AI究竟创造什么价值,又在解决什么需求。 从“大型机”到“个人电脑” 季宇用了一个颇具历史感的比喻:今天支撑大模型的计算系统,很像上世纪80年代的大型计算机——技术先进、性能强大,但价格昂贵。后来真正改变计算机产业的,不只是大型机继续变强,而是个人电脑和廉价的x86服务器出现,让计算能力进入千家万户。 今天行业仍在追求更强的GPU和更大的超节点。但季宇认为,如果性能提高十倍、成本也提高两倍,性价比固然提高了,但对原本买不起的人来说,门槛仍然更高。他更关心的是:“我做同样的事情,能不能把成本大幅度地降下来,把门槛大幅度地降下来?” 付智从算力供给端看到了类似的可能。未来AI需求会分层,并不是所有任务都需要最强模型和万卡集群。大量小型机房、闲置服务器乃至个人设备,也可能被组织成算力网络。改变的不只是价格,也可能是算力的组织方式。 李大海关注的则是另一种“变小”。面壁提出“密度定律”,核心是让同样参数规模承载越来越强的能力。Scaling Law仍然在推动智能上限,但能力密度提升后,过去需要更大模型完成的任务,有机会进入资源更有限的终端。端侧也不是云端模型的简单缩小版:云端追求高并发下的效率,终端则面对响应速度、内存和功耗等不同约束,需要重新设计模型架构。 季宇把几个环节串到了一起:模型结构提高“智力密度”,调度提高算力利用率,芯片则降低硬件门槛。只有这些效率提升叠加起来,Token成本才可能真正大幅下降。 如果说过去几年的竞争主要围绕“谁能创造更强的智能”,下一阶段可能增加一个新的维度:谁能让智能变得足够便宜,从而让更多人真正用起来。 便宜还不够 但成本下降,只解决了第一步。 分散算力天然便宜,却也天然不稳定。个人电脑可能随时重新被主人使用,机房的闲置资源也可能突然被收回。付智把这种供给比作光伏发电:“一朵云过来,这个电就没有了。”而客户不会因为使用的是闲置资源,就接受随时中断的AI服务。 因此,共绩真正需要解决的,并不是简单找到便宜的GPU,而是如何把不稳定的资源变成稳定的服务。平台需要预测节点可用性,匹配不同可靠程度的资源和任务,同时处理操作系统、驱动、部署环境、数据安全和业务隔离。付智把“如何保障稳定”视为最难复制的能力之一。 进入物理世界后,这个问题更加明显。张校珩谈到苏度的路径时强调,真实机器人数据与仿真需要结合:以真实数据为锚点,用仿真扩充,再回到真实环境校正;同时通过可以跨任务迁移的“技能模型”复用已有能力。 工业客户还有一个现实约束:核心工艺数据往往不能交给机器人公司。张校珩称之为“real-to-real gap”。苏度因此希望让客户保留自己的工艺数据,通过部署工具调用可以泛化的技能。客户是否愿意持续使用,比做出一次Demo更重要;如果产品停留在Demo阶段,就无法形成持续的数据回流。 把能力做出来是一回事,把偶然出现的能力变成便宜、可靠、可以反复交付的产品,是另一回事。 真正的Scaling,是复制能力 当成本继续下降之后,会发生什么?付智把今天使用AI与十几年前使用手机流量作比较。当年几十兆流量都要精打细算,今天几百GB已习以为常。Token也可能经历类似的过程:价格足够低之后,人们使用智能的方式本身会改变。 因此,降成本的意义并不只是让今天的AI应用更便宜。付智认为,目前很多应用仍停留在给既有工作提效;更值得关注的是,当基础设施极大丰富、Token足够便宜、模型更强之后,会不会出现今天尚未充分显现的新需求。个人电脑最初也像一台更好的打字机,后来却催生了PC互联网和移动互联网。 季宇则从产业结构看到了另一层变化:一个成熟的计算产业,底层基础设施应该足够便宜、稳定,上层则生长出数量庞大、价值更高的应用。他虽然是一家芯片公司的创始人,却明确表示,并不希望芯片永远拿走产业中过多的收益。底层足够普惠,新的生态才有可能真正形成。 讨论尾声,李光裕请四位嘉宾各给出一个判断“规模化”的指标。季宇看芯片能否形成规模量并落地;李大海看模型装机量;付智看分散算力供给节点的数量;张校珩则看模型从一个任务迁移到下一个任务时,成本能否持续下降。 真正的Scaling,并不只是把同一件事情做一千次,而是第一次建立起来的能力,能不能让第二次变得更容易、更便宜。 分散算力网络如此,模型进入不同终端如此,机器人从一个任务走向另一个任务也是如此。 下一条增长曲线 过去几年,AI最令人瞩目的进步来自一条不断向上的曲线:模型越来越大,算力越来越强,智能边界不断被突破。这条曲线远未结束。 但在它之外,另一条曲线正在变得越来越重要:获得同样智能所需要付出的成本,能下降多快。 当分散算力可以被组织成可靠服务,当芯片开始考虑的不只是峰值性能而是使用门槛,当模型以更高的能力密度进入更小的设备,当机器人学习下一个任务的成本越来越低,AI才可能从少数企业能够负担的昂贵能力,变成广泛可用的基础设施。 而当基础设施真正普及,今天尚不存在的需求和应用才有机会出现。 AI的下一条增长曲线,不只是继续向上突破智能的上限,也是不断向下降低智能的门槛。