ARTICLE · 1200892
H-JEPA 源码精读:每层一个潜空间的分层世界模型,长程视觉规划怎么从 18% 提到 73.3%
H-JEPA 源码精读:每层一个潜空间的分层世界模型,长程视觉规划怎么从 18% 提到 73.3%Visual AntMaze 迷宫里,一只四足蚂蚁要从起点走到三个网格格之外的终点,中间隔着一堵墙。把 64×64 的俯视图交给单层 JEPA 世界模型去做梯度规划,成功率只有 18.0%;把同类模型摞成三层、让每层在自己的潜空间里预测更长远的未来,成功率冲到 73.3%,规划算力反而更省。这就是 2026 年 10 月 5 日挂上 arXiv 的 H-JEPA——LeCun 任董事长的世界模型创业公司 AMI Labs 的第一个公开研究工作,与 NYU、INRIA Paris、Brown 合作完成;10 月上旬代码与预训练权重同步开源,36氪在 10 月 10 日、量子位在 10 月 11 日先后报道。我没有跑训练,下面把论文和代码放在一起读。 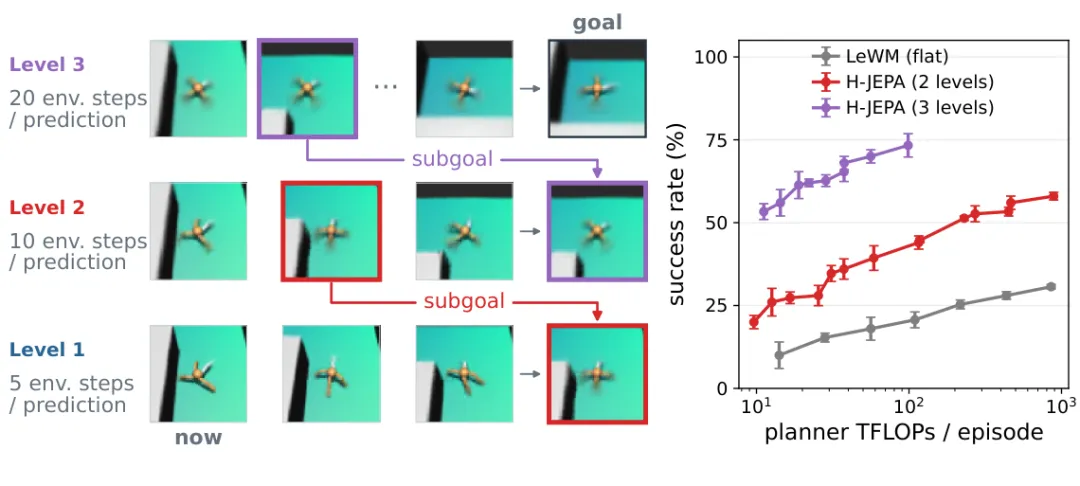
H-JEPA 解决的是「单一潜空间的 JEPA 世界模型做不好长程规划」。两个限制摆在那:一是长程预测要滚动很多细粒度步,误差复合、动作搜索空间膨胀;二是一个共享潜空间既要支撑低层动态建模,又要拿来做目标匹配,而目标往往比状态更抽象——要到达的是一个位置,不是一整套腿姿态。改法是摞 L 层动作条件 JEPA:每层有自己的观测编码器、动作编码器和因果 transformer 预测器,第 ℓ 层把下层潜状态按步长下采样,在自己学出的潜空间里做一步预测;训练端到端,上层损失的梯度穿过下层编码器。规划自顶向下:顶层优化宏动作让预测的最后一个潜状态贴近目标,上层预测出的潜状态直接当下层的子目标。停在什么条件:四个仿真环境里 Push-T 是反例,三层模型掉到 17.3%——短 episode 让三层模型每轮只吃到单层 58% 的训练转移;真实机器人视频 DROID 必须补一个逆动力学损失,否则表征直接塌缩、保真度为零。只想看一处代码,看 h_jepa/hierarchical_solver.py 的 solve(),自顶向下的循环、子目标传递、目标锚定全在这一个函数里。 JEPA 路线的世界模型不重建像素,只在潜空间里预测未来状态,配上动作条件就能从离线数据学动力学、零样本规划,LeWM 已经做到从像素端到端训练单个 JEPA 世界模型。但单层模型预测和规划共用一个潜空间、一个时间尺度,长程任务暴露两个短板。其一,预测步数一多误差复合,候选动作序列的搜索空间指数膨胀。其二,目标匹配的代价在过「细」的潜空间里算不准:蚂蚁的腿姿态维度对迷宫任务是噪声,却和位置一起挤在同一个潜向量里,梯度规划器离目标远时几乎分不清哪条路更近——论文图 7 把一层潜空间的距离场画出来,走廊里近乎常数,而上层潜空间的代价沿走廊平滑爬升。论文还给了个干净的对照(表 1):同一个一层世界模型、同一套规划器,只把目标代价换到更抽象的上层潜空间里算,AntMaze 成功率就从 23.3% 升到 31.3%;完整分层规划再叠上去,两层 39.3%、三层 73.3%。问题于是从「要不要分层」变成「每层各管什么」。 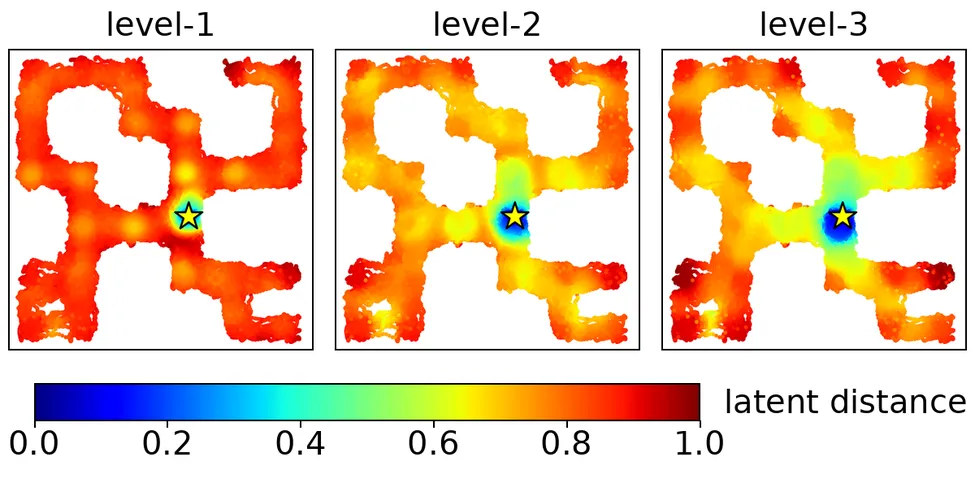
主线是时间分层乘上表征分层。第一层编码器 E(1) 把每帧观测压成潜状态——AntMaze 上是 ViT-Tiny 的 CLS 嵌入拼一段本体感觉嵌入——动作块压成动作嵌入;第 ℓ>1 层的编码器 E(ℓ) 吃下层潜状态窗口,动作编码器把 stride 个下层动作嵌入聚合成一个宏动作。论文全部实验用 stride=2、window=1:每往上一层,一步预测覆盖的环境步数翻倍。每层损失是 teacher-forced 一步预测的 MSE(式 2)加 SIGReg 正则(式 3),各层求和端到端训练。 设计一:每层一个自己的潜空间。上层编码器不与下层共享,这是与 HWM(同一潜空间、多时间尺度)的分界线。同深度对照里,AntMaze 三层 H-JEPA 的成功率接近三层 HWM 的两倍。 设计二:自顶向下规划、上层预测当下层子目标。顶层把宏动作序列优化到「预测的最后一个潜状态≈目标潜状态」;下层的 rollout 再编码进上层潜空间去对齐子目标,直到第一层吐出原始动作。 一个必要公式(论文式 6,下层规划目标):C = ‖z̃_K − ẑ*_K‖² + β·Σᵢ‖z̃_i − ẑ*_i‖²。三个量:z̃ 是下层预测的潜状态序列经上层编码器 E(ℓ+1) 编码后的结果,时间上按上层步长对齐;ẑ* 是上层解出的子目标潜状态序列;β 给中间子目标加权,终端子目标权重为 1。闭环规划只匹配第一个子目标(K=1),每执行一段动作重新规划。 入口链:训练从 h_jepa/main_hjepa.py 按 hydra 配置(config/train/ant_hjepa_l3.yaml)拉 HDF5 数据,进 hjepa_utils.py 的 hjepa_forward,先由 models/hjepa.py 的 HJEPA.encode_hierarchical 把一条长 level-1 流逐层编码,再逐层算损失;评估从 h_jepa/eval.py 进 planning_eval.py,构建 hierarchical_solver.HierarchicalSolver,每层包一个 stable_worldmodel/solver/gd.py 的 GradientSolver。 对照一:论文式(1)的窗口采样 ↔ h_jepa/models/jepa.py 的 _chunk_temporal_info 与 _state_windows: ```python starts = torch.arange(0, seq_len - window_size + 1, stride, device=ref.device) ... def _state_windows(self, x, starts, window_size): if window_size == 1: return x.index_select(1, starts) ``` 对应关系:temporal_stride 就是式(1)的 sℓ,temporal_window_size 是 wℓ;window_size=1 时退化为纯下采样 index_select,正对应论文「所有实验 wℓ=1、上层状态编码器逐点作用」。动作那边 _action_windows 的块起点是 starts + state_window_size − 1、块长取 stride——对应论文「动作编码器聚合 sℓ 个下层动作嵌入、与状态窗口末端对齐」。 对照二:论文式(3)的 SIGReg ↔ h_jepa/loss.py: ```python class SIGReg(torch.nn.Module): def __init__(self, knots=17, num_proj=1024): t = torch.linspace(0, 3, knots, dtype=torch.float32) window = torch.exp(-t.square() / 2.0) def forward(self, proj): A = torch.randn(proj.size(-1), self.num_proj, device=proj.device) A = A.div_(A.norm(p=2, dim=0)) x_t = (proj @ A).unsqueeze(-1) * self.t cos, sin = x_t.cos().mean(-3), x_t.sin().mean(-3) err = (cos - self.phi).square() + sin.square() ``` 对应关系:SIGReg 要让批内嵌入分布逼近各向同性高斯,高维特征函数没法直接算,于是随机采 1024 个单位方向把嵌入投到一维——「sketched」的来历——再在一维上用 cos/sin 均值对高斯窗 φ 的误差做 knots=17 的数值积分。论文附录写明 M=1024 个随机投影、无 stop-gradient、无动量目标、无预训练权重,代码里都能对上;AntMaze 配置里三层 sigreg weight 都是 0.09,对应论文「同一环境内各层共用系数」。 对照三:论文式(4)–(6)与附录 E 的规划细节 ↔ hierarchical_solver.py 的 solve(): ```python for level in range(len(self.level_models), 0, -1): ... num_subgoals = self._level_plan_config(level + 1).num_subgoals next_goal = subgoal_latents[:, first_pred_idx:first_pred_idx + num_subgoals].clone() ... if includes_last and upper_anchored: next_goal[:, -1] = goal_embeddings[f'embed_{level + 1}'].squeeze(1) ``` 对应关系:循环从最高层往下,正是式(4)到式(6)的执行顺序;上层解出的 predicted_embed_0 取前 num_subgoals 个当下层目标,config/eval/ant_l3.yaml 里 level2/level3 都是 num_subgoals: 1,即论文的闭环规划;最后一个子目标直接替换成真实目标嵌入,是附录 E 的 goal anchoring,防止上层规划的漂移一层层传下去。上层宏动作没有原生取值范围,gd.py 从 latent_action_queue(训练期留下的最近 4000 个宏动作)取均值方差初始化候选,每步裁剪到 2%–98% 分位(torch.quantile(queue, 0.02/0.98)),与附录 E 的表述逐句对得上。 数据:AntMaze 训练集是 explore 与 stitch 各 12,500 条 episode 的等量混合、约 1005 万转移;帧做 ImageNet 归一化、无增广;第一层一步跨 5 个环境步,中间动作拼成动作块(动作维 8)。模型:第一层 ViT-Tiny(64×64、patch 4)的 CLS 过一层 MLP 投影成 256 维像素嵌入,拼 128 维本体嵌入,潜维 384;第一层预测器 4 层 8 头、宽 192、FFN 1024。上层编码器是两层 MLP(隐 384),动作编码器用单层 transformer 把两个下层动作嵌入池化成 4 维宏动作;上层预测器 5 层 12 头、宽 224、FFN 1536。优化:AdamW、权重衰减 1e-3、1% 线性预热加余弦退火、梯度裁剪 1.0、bf16;第一层峰值学习率 5e-5、每个上层 1e-5——main_hjepa.py 的 _build_hjepa_optimizer_factory 按层开参数组,组名就叫 level1/level2/level3。批大小 128 个 clip,AntMaze 训 5 个 epoch,种子 42/43/44。最影响可比性的条件:各深度按 epoch 对齐训练,clip 变长使每轮样本数下降,不同深度的优化器步数并不对齐,论文明说;HWM 对照与 H-JEPA 同实现、同数据、同训练设置,只把上层编码器换成恒等映射。规划侧:每层 GradientSolver 至多 90 步 AdamW(学习率 0.06/0.1/0.1),候选数 100/100/400,每执行两个 level-1 动作块(10 环境步)重规划,评估预算 350 步、每环境 50 个固定任务。论文没单列训练用的 GPU 型号,配置里只写 devices: auto。 按图表分开说。图 6 底行(各环境 50 任务的深度对比,数字取自仓库 docs/RESULTS.md 对论文图的转录):AntMaze 上 LeWM 18.0±3.5、两层 39.3±3.7、三层 73.3±3.5、四层回落到 67.3±2.4,三层 HWM 只有 38.7±3.5;FourRoom 40.7±6.8 升到 96.0±1.1;Cube 32.0±6.1 升到 60.0±5.0;Push-T 反着走,40.0±2.3 到两层 45.3±1.3 后,三层 17.3±3.5、四层 0.7±0.7——论文归因于训练数据:三层每轮只吃到单层 58% 的转移(表 3),四层只剩 14%。图 6 上行的算力扫描显示,FourRoom、AntMaze、Cube 上每加一层(到三层)都把「成功率—规划 FLOPs」的 Pareto 前沿往左上推。表 1(只换代价空间,动力学与规划器不动):两层模型 native L1 代价 23.3±3.3%、L2 投影 31.3±2.7%;三层模型 native 16.7、L2 20.7、L3 22.0——抽象代价空间单独就有收益,完整分层规划再叠加时间分解的收益。图 4(探针):上层逐渐「忘掉」蚂蚁腿姿态与 FourRoom 干扰物位置这类快变量,保留全局位置这类慢变量。DROID(图 9,16 条真实机器人 pick-and-place 视频、5 fps 开环规划):不加逆动力学损失,模型塌缩、保真度为零——潜空间跨 episode 方差 DROID 75%、Cube 只有 28%,场景多样性把纯预测目标推向「记住背景、丢掉机器人」;加上 IDM 后,LeWM+IDM 33.57±1.52、HWM 35.65±2.22、两层 H-JEPA 38.42±0.94(Fréchet fidelity,0% 等于机械臂不动、100% 等于专家轨迹,离线路径指标不是闭环成功率)。这些数字我都没有复现,全部出自论文图表与仓库转录。 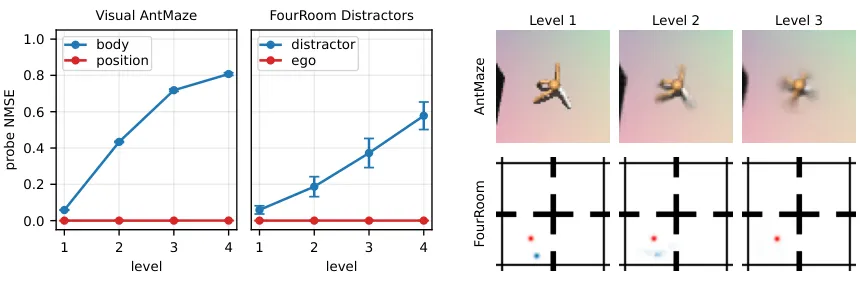
已对应:式(1)对 jepa.py 的分块采样;式(3)对 loss.py 的 SIGReg;式(6)与附录 E 对 hierarchical_solver.py 和 gd.py;「每层一个潜空间」在 models/hjepa.py 的 encode_hierarchical 里就是逐层串接,上层吃下层嵌入。实现补充:仓库默认开 sparse_level1_encode,四层模型只编码 25 帧里实际用到的约 12 帧,数值与稠密编码完全等价(仓库自带单测),这是训练提速的工程项,论文没展开;训练结束自动跑一轮规划评估(PlanningEvalCallback),对应 README 里「训练自动评估」的说法。配置选择不是缺陷:上层预测器比第一层更深更宽(5 层 12 头对 4 层 8 头),是逐环境调出的超参;FourRoom 的 SIGReg 系数 0.18、其余环境 0.09,同样是逐环境选择。一处容易误读:评估用的 config/eval/ant_l3.yaml 与训练用的 config/train/ant_hjepa_l3.yaml 同名前缀、不同目录,规划器候选数与学习率都在 eval 配置里,别去训练配置里找。 环境:conda 建 python 3.11 环境,pip install -e ".[train,env]" 挂 cu128 的 PyTorch 索引,export HJEPA_HOME 指向数据目录。最小样例:从 HuggingFace 的 jepa-world-models/h-jepa 下载 eval_trajs 与 ant 三层 checkpoint,进 h_jepa 目录跑 eval.py --config-name ant_l3 seed=42 policy=,产物在 checkpoint 旁的 eval_l3/metrics.yaml,看 success_rate 字段。想从头训:先备 AntMaze 数据集(HF 下载或 scripts/data/collect_datasets.sh 自采),再跑 main_hjepa.py --config-name ant_hjepa_l3 seed=42。成功标志:训练结束自动生成的 planning_eval/epoch_XXXX/metrics.yaml。容易看错的地方有两个:一是 AntMaze 自采数据与官方下载版分布一致但非逐字节相同,README 明说部分重置随机数没设种子;二是 HF 上模型与数据集是两个同名仓库,下载命令的 --repo-type 参数别漏。 有证据的部分:分层潜空间的收益在 AntMaze 上被拆得很干净——表 1 只换代价空间就涨点,完整分层把 18.0% 的基线抬到 73.3%,同深度 HWM 对照又把「多时间尺度但共享潜空间」的份额剥出来;代码、数据生成脚本、checkpoint 全开源,复现门槛主要在算力不在材料。限制也摆在那:Push-T 的三层崩塌说明配方对训练数据长度敏感;DROID 要靠 IDM 补丁对抗场景多样性带来的塌缩,Fréchet fidelity 只是离线代理指标,论文结论自己把「闭环上真机」列为下一步。LeCun 从 2022 年起反复讲的分层 JEPA 路线在这篇里拿到了第一份端到端的实验证据,但皮层时间尺度分层的类比是动机修辞,不是机制证明。推测部分:上层丢快变量的解释(预测误差梯度流过编码器、逼它只留自己能预测的成分)论文用的是「consistent with」的措辞,我读下来也认为这是最自洽的解释,但探针实验只证相关。AMI 至今没有产品,这套世界模型能不能撑住更杂的真实数据,要看他们的下一个公开工作。 论文:H-JEPA: End-to-End Learning of Hierarchical World Models for Visual Planning,arXiv 2610.06805,2026-10-05 提交,https://arxiv.org/abs/2610.06805 代码:https://github.com/kevinghst/H-JEPA(main 分支,2026-10-17 访问;AMI Labs 官方发布,官网 h-jepa.com 与 README 双向链接) 权重与数据:https://huggingface.co/jepa-world-models/h-jepa(模型与数据集各一个仓库) 要读的源码:h_jepa/loss.py、h_jepa/models/jepa.py、h_jepa/models/hjepa.py、h_jepa/hierarchical_solver.py、stable_worldmodel/solver/gd.py、h_jepa/config/train/ant_hjepa_l3.yaml、h_jepa/config/eval/ant_l3.yaml、docs/RESULTS.md 底座与依赖:LeWM(arXiv 2603.19312、github.com/lucas-maes/le-wm)、stable-worldmodel(github.com/galilai-group/stable-worldmodel)、SIGReg 出自 LeJEPA(论文引文 6) 媒体报道(选题线索,均回 arXiv 与 GitHub 原文核对):36氪 2026-10-10、量子位 2026-10-11
01 先看结论
02 问题背景
03 方法拆解
04 源码对照
05 实验配置
06 结果怎么看