ARTICLE · 1205850
ai-memory:给你的 AI 编程助手一份跨工具、跨机器的长期记忆
今天给大家推荐的项目是 ai-memory。它做的事情很朴素:给 AI 编程助手补上最缺的那块——长期记忆。
你在 Claude Code 里把一个功能做到一半,第二天换成 Codex 打开同一个目录,对方对昨天的事一无所知:项目怎么分层、哪条路试过行不通、还有哪个问题悬着,都要从头讲一遍。ai-memory 把这段记忆放在你自己的机器上,跟着你跨助手、跨项目、跨设备,而且默认不调用任何大模型。
❝项目名称: ai-memory主要语言: Rust(另含 Shell、TypeScript)Stars: 10.0kForks: 725项目链接: https://github.com/akitaonrails/ai-memory
每次换工具,都要把项目重讲一遍
现在的编程助手其实都有自己的记忆功能。Claude Code 会自己记笔记,Cursor 也能记住一些东西。但它们的限制一样:笔记存在一台机器上,只属于一个助手;你一换工具,或把活交给同事,笔记就掉出视野了。
长任务更麻烦。一个跑了三周的仓库,中间换过两个助手、重启过十几次会话,真正有价值的东西——改过哪些文件、为什么绕开某个方案、下一步要验证什么——全都散落在关掉的终端窗口里。
ai-memory 的回应是:把这些观察记到仓库自己身上,而不是某个工具的私有数据库里。
核心亮点
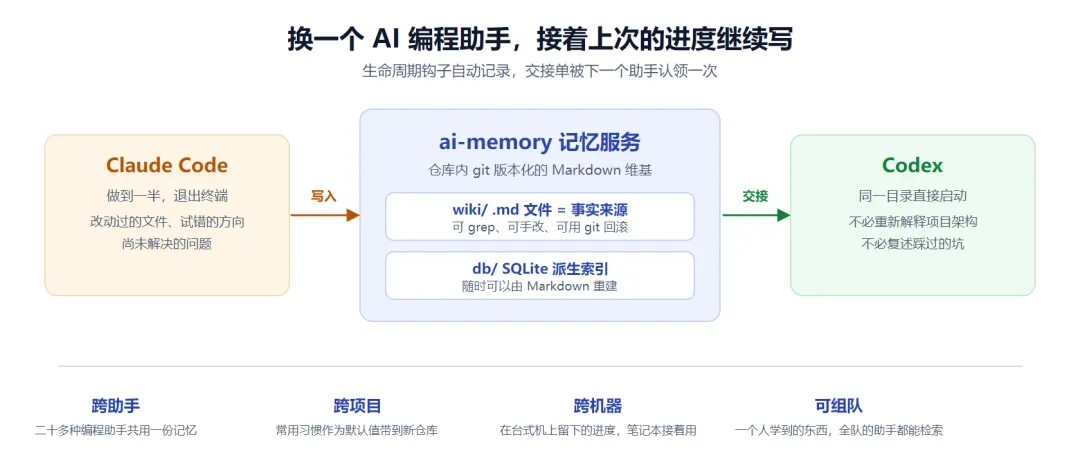
一份记忆,二十多种助手共用
ai-memory 通过生命周期钩子(助手在会话开始、调用工具、会话结束等时机自动触发的回调)和 MCP(Model Context Protocol,让助手调用外部工具的通用接口)接入。README 的支持矩阵里,Claude Code、Codex、Cursor、Gemini CLI、OpenCode、Grok、Kimi Code、GitHub Copilot CLI 等二十多种助手都是第一方集成,并由 CI 持续检查。
关键在于交接有协议:每张交接单有明确归属,而且只能被认领一次。你退出 Claude Code、在同一目录启动 Codex,后者拿到的是"上次停在哪、什么失败了、还剩什么没做",不需要你口头复述。
你的记忆是一份可以直接读的 Markdown
很多记忆工具把内容存成不透明的碎片,你只能通过它自己的界面看。ai-memory 反过来:事实来源是仓库里一个由 git 版本化的 Markdown 维基,都是普通的 .md 文件。你可以 grep 它、用 Obsidian 打开它、手动改它、用 rsync 搬走它。数据库只是从这些文件派生的索引,随时能重建。
默认零大模型调用
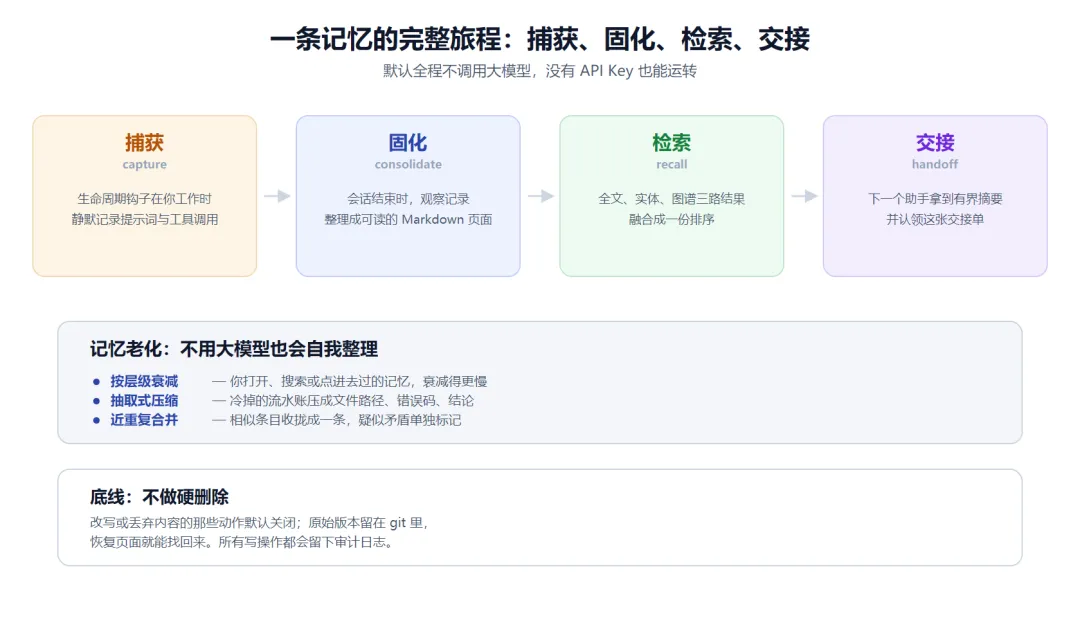
这是它最容易被忽略、但影响最大的一点。捕获、检索、交接这条主链路完全不依赖 API Key:助手工作时把清洗过的观察记录上报,会话结束时整理成页面,下一个会话注入一份有界摘要。没有 Key,全文检索照样能用。
用得更深时,它还能做记忆老化——按层级设置衰减曲线,你打开过、搜索到过的记忆衰减得更慢;冷掉的流水账压缩成保留价值的硬事实(文件路径、错误码、结论),近似条目合并,疑似矛盾单独标记。根据 README,这套机制同样是零 API 调用的。
只有想让它"做梦"——用大模型把整簇冷记忆重写成连贯页面——才需要配置模型。而这是默认关闭的开关,不是必经之路。
不做硬删除
改写或丢弃内容的机制默认关闭。原始版本留在 git 里,restore-page 可以找回来。所有写操作都有审计日志,清理类命令会明确告诉你"删除"删掉了什么。对一份记录你真实工作过程的资料来说,这比"更聪明的摘要"重要得多。
技术实现
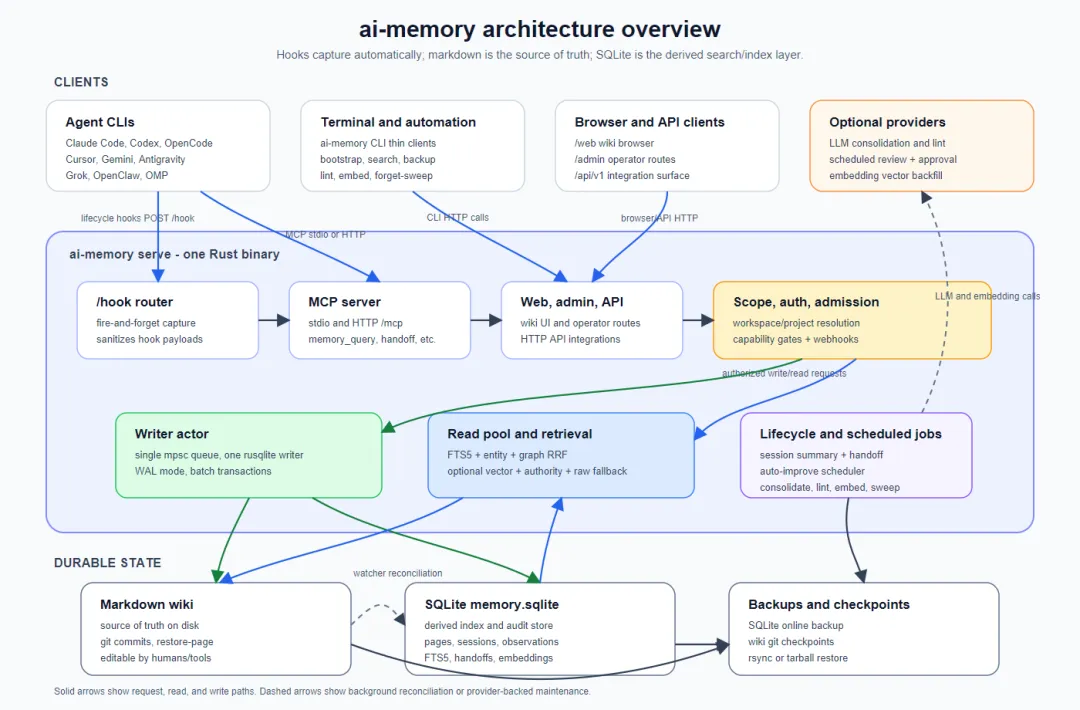
整个项目是一个 Rust 二进制,同时充当 MCP/HTTP 服务和数据目录的管理者。README 给出的架构是:
接入层:助手通过钩子把观察记录 POST 给服务端,或通过 MCP 的 stdio/HTTP 通道查询;命令行和浏览器界面走同一套接口。 写入路径:所有写入串行经过单写者的 SQLite actor(WAL 模式、批量事务),多会话并发时不写乱。 存储层: wiki/是 Markdown 事实来源,raw/存已清洗的转录片段,db/是 SQLite 索引(含 FTS5 全文、实体和向量)。检索:全文、实体、图谱三路结果用 RRF(Reciprocal Rank Fusion,倒数排名融合)合成一份排序;向量检索可选。
取舍很清楚:选 Rust 单二进制换来部署简单,不用起数据库、不用维护向量库;选 Markdown 做事实来源换来数据可读可迁移,代价是没有云端托管那种开箱即用。另外,原生 Windows 目前仍是实验性支持,官方推荐走 WSL2;部分助手(如 Claude Desktop、Zed、VS Code Copilot)只支持 MCP 子集,功能会受限。
安装不复杂,Linux 和 macOS 两条命令、无需 root:
从 Releases 下载安装脚本并执行,脚本会校验发布页的 SHA-256 校验和; 运行 ai-memory setup,它会创建数据目录和访问令牌、启动用户级服务,并把找到的助手逐一接入——接入前先列出计划让你确认。
值得试,如果你每天都在和助手打交道
ai-memory 最值钱的地方不是某个单点功能,而是它把"记忆"的三个边界同时推开了:跨助手、跨机器、跨人。它用一份你能直接读的 Markdown 做事实来源,用零大模型调用的默认配置把成本压到几乎为零,再用"不硬删、可恢复"守住底线。
它最适合两类人:一是同时用两三个编程助手、受够反复交代上下文的开发者;二是想把个人经验沉淀成全组可检索知识的小团队——多人认证、按人归属和审计日志都是内置的。
需要提醒的是,它记的是这个仓库,不是通用知识库;也不该被当成替代版本控制或代码评审的工具。这两个边界想清楚了,它才用得舒服。
项目地址:https://github.com/akitaonrails/ai-memory
资料来源
GitHub Trending:https://github.com/trending 项目仓库与 README:https://github.com/akitaonrails/ai-memory 官方架构文档:https://github.com/akitaonrails/ai-memory/blob/main/docs/ARCHITECTURE.md 官方安装文档:https://github.com/akitaonrails/ai-memory/blob/main/docs/install.md 支持矩阵与安全模型:https://github.com/akitaonrails/ai-memory/blob/main/docs/security.md 最新版本页:https://github.com/akitaonrails/ai-memory/releases/latest