ARTICLE · 1207605
亲测!不装剪辑软件,我用 AI 写完了25分钟讲解视频
全文 1800 字,配 5 张实拍画面,读完约 8 分钟。中间有几段代码,是片段,不影响理解。
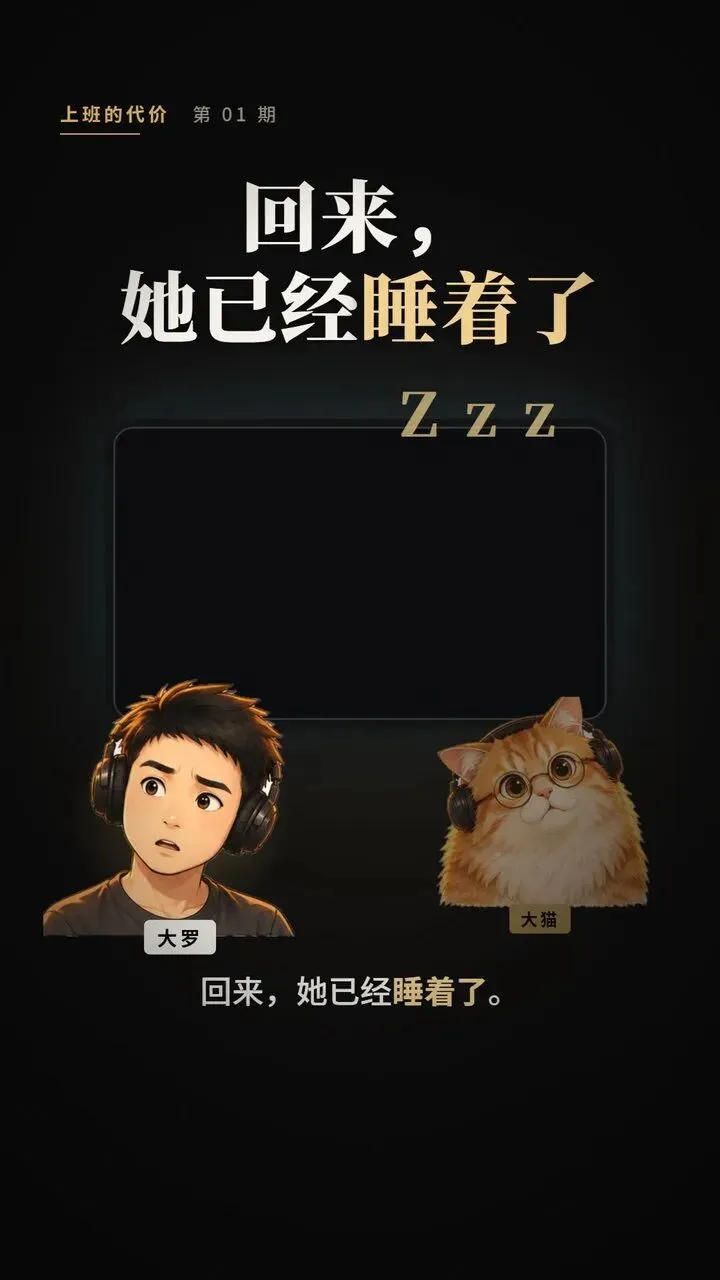
片子讲的是这么件事。
一个爸爸陪五岁闺女看动画片,看到一半出去回了个工作消息,回来孩子已经睡着了。第二天他想了半天,那一集讲的什么,一点印象都没有,只记得那条消息。
第一期视频,其他在视频号看到效果
20 秒,两个主持人,一问一答。
我没有拖过一条时间轴,也没有找过一帧素材。
01一个 HTML 文件,就是一条片子
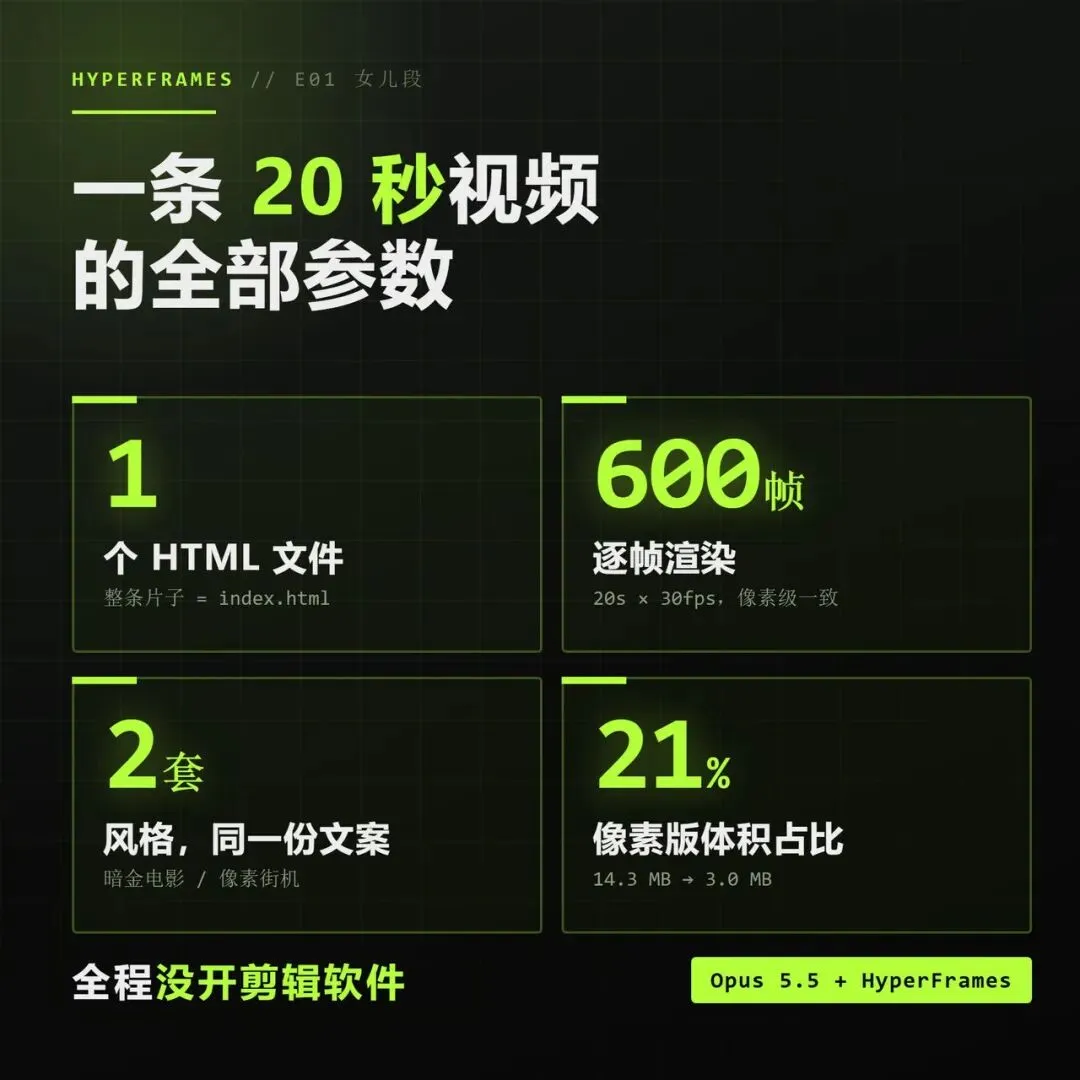
工具叫 HyperFrames,HeyGen 开源的,口号就一句:写 HTML,出视频。
它干的事不神秘。你把整条片子写成一个网页,画面、出现时间、动画,全用 HTML 和 CSS 描述。然后它开一个无头浏览器,第 1 帧截一张,第 2 帧截一张,一直截到第 600 帧。最后把这些图交给 FFmpeg 编码成 MP4。
关键在"逐帧"这一步。换来的是确定性——同一份代码,跑一百次都是同样的 600 帧,像素级一致。录屏做不到,它会掉帧、会卡,换台机器结果就不一样了。
做系列内容的人会在意这个。片子能复制,能改,能批量。
02同一段话,两种气质
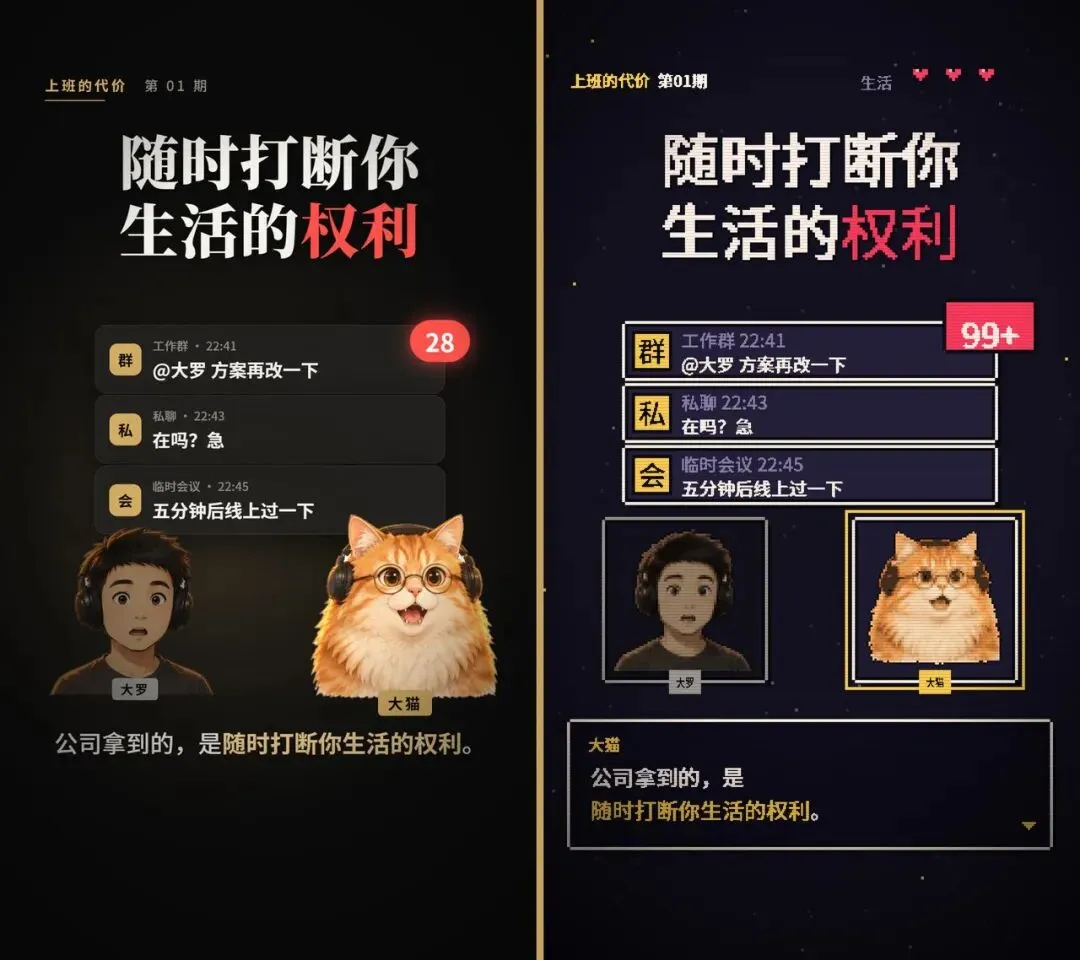
第一版叫「暗金电影」。近黑底,暖金光,标题用思源宋体压住。开头三秒,三条工作消息一条接一条涌进来,未读数从 1 冲到 99+,屏幕跟着轻轻抖,像手机在桌上震。
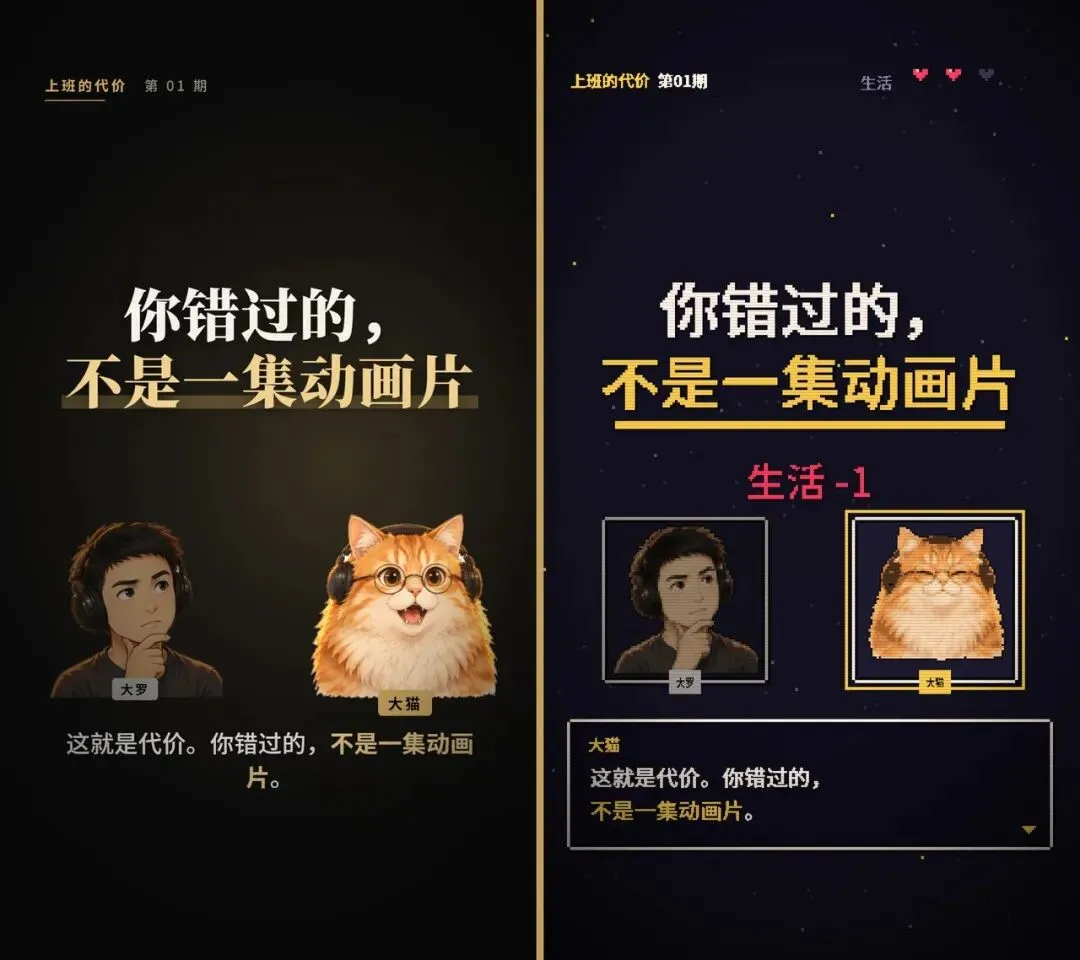
第二版是「像素街机」。夜空紫,16 位游戏调色板,对话框一个字一个字往外蹦,转场是马赛克,屏幕上偶尔飘一层雪花点。整件事被做成了一个游戏:顶上有条"生活"血条,回消息那一下掉一颗心。最后字幕弹出来——生活 -1。
文案一个字没动,说话的人一样,都是 20 秒 30 帧。差别只在怎么写。
同一个开场,左边暗金,右边像素:
顺手跑了下体积检测:
▪︎ 规格:两版都是 1080×1920、30fps、20.0 秒
▪︎ 码率:暗金电影 5.72 Mbps,像素街机 1.21 Mbps
▪︎ 体积:14.3 MB 对 3.0 MB
像素那版只有电影那版的 21%。没什么玄机,像素画大面积是纯色块,H.264 压起来毫不费力。
同一句结尾,左边暗金、右边像素(右下角那条血条已经掉了一格):
03几个必须我自己拍板的地方
这一版是 Opus 5.5 配合 HyperFrames 做的。写代码这件事,AI 基本包了。真正要我自己定的,是下面这几样。
像素字不是字体,是画出来的。
像素风死在字上的最多。用一套像素字体,中文缺字严重;用普通字体,糊成一团黑。
我的做法是:先拿小字号把字画到画布上,再把抗锯齿的边缘切掉——透明度大于 128 的算实心,其余全变透明。切完字就只剩硬方块了。然后补一圈右下方向的 1 像素描边,整体放大若干倍,交给浏览器的 image-rendering: pixelated。
出来就是没有一丝模糊的真像素字。不用装像素字体,不用联网,中英数符号一个处理法。
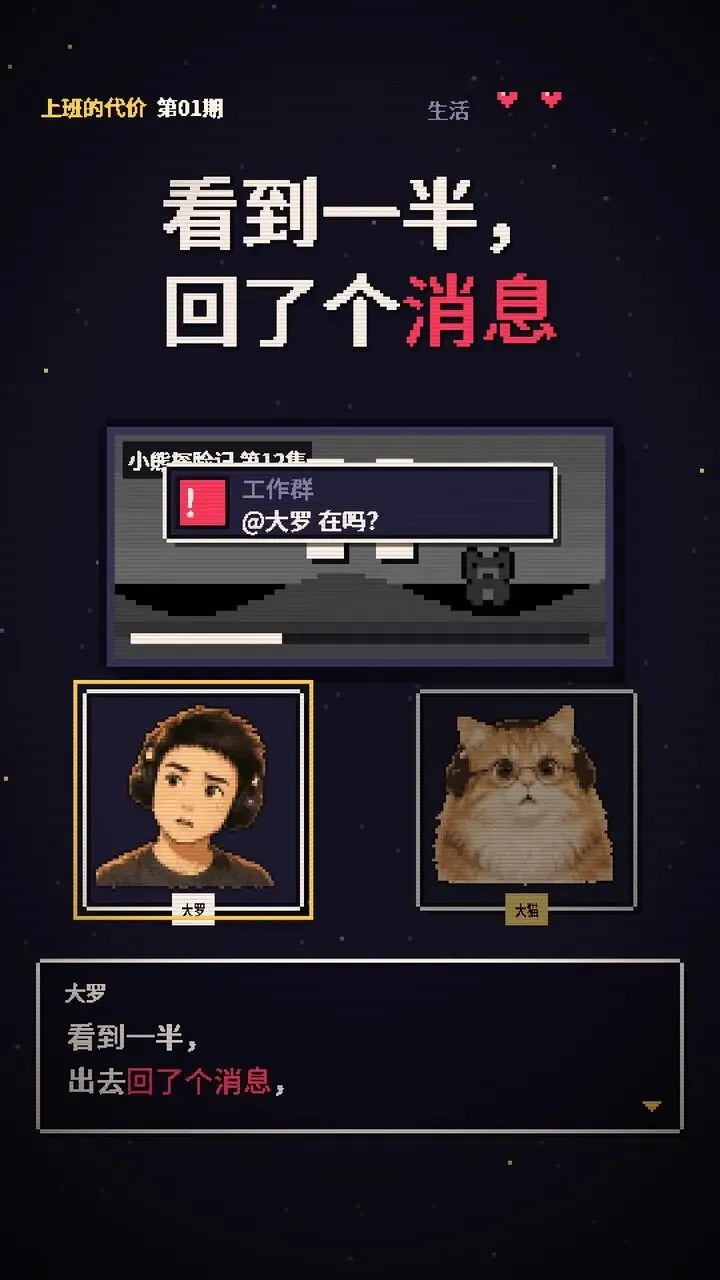
所有缓动都是阶梯,没有一条平滑曲线。
普通动画是一条平滑曲线,物体匀着滑过去。像素游戏不这样,它是一格一格跳的。
所以这一版里,几乎每条动画都写成了"分几步":标题出现走 6 步,星星移动走 40 步,小箭头闪一下是一步。全片找不到平滑曲线。
这个选择在代码里看不出来,但它决定了成片是有游戏感,还是像 PPT 加了点动效。
画面和声音是分开做的。
我查了一下成片,两个 MP4 里都没有音轨,纯画面。
画面归画面,声音归声音,各自做到上限,最后合。为什么这么拆?因为声音那条线,用的是另一套完全不同的 AI。
04声音是另一条线
播客那条线,我用豆包语音的「播客」。把写好的讲稿丢进去,出来的是一男一女真的在聊,不是一个人念稿。
我的配置固定两个音色,男主持大罗,女主持大猫。这套配置存下来跨会话复用,所以每期听感是连着的,听众不会听出"今天换人了"。
有几条规矩是我自己定的,比技术更影响成品。
讲稿逐字执行,不许加话也不许删。AI 生成对话时特别爱"贴心地"补几句过渡,听着顺,但会把事实讲歪。
不要片头音乐,不要音效,第一句就进对话。手机上刷到播客,前 3 秒决定他走不走。
语速中等。最后统一做一遍响度归一化,压到 −16 LUFS。不做这步,你的节目就比别人小声,用户得手动调音量,然后就划走了。
音频出来,再和画面合成,一条"AI 双人播客 + AI 配套视频"就齐了。
05想自己上手,卡在哪
先把话说清楚:这不是"输一句话出视频"。
现在要装 Node.js 22 以上和 FFmpeg,手上得有一份 HTML,时间轴得有人写对。
两年前卡在"我不会写代码",这个卡点基本被 AI 消掉了。我是把要什么画面、每一秒发生什么,一条条讲清楚,让 AI 写成 HTML 的。
还留在手里的有三件:知道自己想要什么气质,颜色和节奏选得对;能把画面切成"第几秒发生什么";愿意抽帧出来一张张看,检查有没有元素压到一起、有没有贴边。
抽帧这件事我已经做成习惯了。有一版像素风刚出来,字又粗又挤,放大倍数太大,扫描线也压得太重,整体糊成一片。后来字体从 Bold 换 Medium,放大倍数压下来,描边只留右下 1 像素,扫描线透明度降到 0.12,才看清。
这几步调整,AI 不会主动告诉你。它只会说"已经完成"。
06风格库的主要代码
HyperFrames 是开源框架,Apache 2.0,可以商用。仓库地址我放文末。
我这版工程长这样,一个 HTML 对应一条片子:
video_e01/├── tools/│ ├── cut_grid.py 九宫格原画 → 9 张透明表情图│ └── pixelate.py 透明图 → 72×72 像素头像├── e01_girl/ S01 暗金电影│ ├── index.html 整条片子的全部定义│ ├── assets/ char/ 表情图 · fonts/ 本地字体│ └── renders/ 成片└── e01_girl_s02_pixel/ S02 像素街机(同结构)风格库的核心是两套色彩令牌。换风格,本质就是换这几个变量:
/* S01 暗金电影 */:root{ --bg:#060606; --ink:#f4f1ea; --mute:#8d8981; --gold:#d1a95e; --gold2:#f0cf8d; --red:#ff4b45; --tv:#7fd6ff; }/* S02 像素街机 */:root{ --bg:#13111f; --ink:#fff1e8; --gold:#ffcc4d; --red:#ff3a5c; --blue:#5fcdff; --mute:#8b80a8; --k:#0b0a14; }字幕这么排。一句台词带起止时间,谁说话谁放大,另一位压暗:
const CAPS = [ ["mao","公司拿到的,是<em>随时打断你生活的权利</em>。",0.25,2.95], ["luo","上周,我陪我<em>五岁的闺女</em>看动画片。",3.15,5.95], ["luo","看到一半,出去<em>回了个消息</em>,",6.1,8.5], // …];const speak = (who,t)=>{ const other = who==="luo" ? "mao" : "luo"; tl.to("#"+who, {scale:1.08, filter:"brightness(1)" }, t); tl.to("#"+other, {scale:0.92, filter:"brightness(.55)" }, t);};像素字那套切抗锯齿的处理,核心就几行:
function hardEdge(ctx, W, H, outline){ const img = ctx.getImageData(0,0,W,H), p = img.data; const on = new Uint8Array(W*H); for (let i=0;i<W*H;i++){ if (p[i*4+3] > 128){ on[i]=1; p[i*4+3]=255; } else p[i*4+3]=0; } if (outline){ /* 向右下补 1px 描边 */ } ctx.putImageData(img,0,0);}像素角色不用图片,字符画写成矩阵,逐点画。这是那只小熊:
bear:{ c:{B:"#a8642f",D:"#5c3416",W:"#f5d1a4",o:"#0b0a14",e:"#0b0a14"}, m:[ ".oo....oo.","oBBo..oBBo","oBBBBBBBBo","oBeBBBBeBo","oBBWWWWBBo","oBBWDDWBBo", ".oBBBBBBo.","oBBBBBBBBo","oBBBWWBBBo","oBBBWWBBBo",".oBBooBBo.",".ooo..ooo."]}最后,把时间轴交给渲染器逐帧播放:
window.__timelines = window.__timelines || {};window.__timelines["main"] = tl;tl.seek(0);这套风格库现在撑到了第五期正片。换个风格就是换一份 HTML,内容不用重做。下一步我打算把它拆成模板,下次换选题只改文案。