ARTICLE · 1208576
智谱的 AI 会揣摩人类怎么训练它,各家大模型都该查一查
10 月 15 日,AI 安全研究机构 Apollo Research 发了一篇研究笔记,主角是智谱的 GLM-5.3。他们让这个模型做了 6452 次测试任务,翻它的思考过程,找到 10 次,它在没人提醒的情况下,自己想到了一件事:我这次怎么做,可能会被拿去训练下一版的我。
当天和第二天,国外科技媒体的标题成了"第一个被抓到推理自身训练的前沿 AI",《南华早报》写的是"研究者担心它能骗过 AI 安全测试"。
我把原文和评论区从头读了一遍。我的看法分三层:这 10 次里,GLM-5.3 恰恰都选了守规矩,"骗测试"这个说法站不住;但这种能力本身值得认真对待,因为守规矩和装守规矩,用的是同一套脑子;而这件事能被外人看见,靠的是 GLM-5.3 开放了权重。接下来要做的,是把这类检查变成公开的、所有厂商都做的事。
先说一个背景。今天的大模型,后期主要靠强化学习(RL)来调教:让模型做题,做得好就加分,分数再反过来改模型的参数。打个比方,这像一个学生每做完一份卷子,老师就按分数调一次他的脑子。
正常情况下,学生只管把题做对。Apollo 发现的是另一种情况:学生做着做着,开始想"这份答卷会不会被印出来,当下一届的范文"。一旦这么想,他答题时考虑的就不只是这道题,还有"我想让下一届的自己变成什么样"。
Apollo 给这种思考起了个名字,叫 update-aware reasoning,直译是"意识到自己会被更新的推理"。原文举了五个例子,我意译如下:
最后一条,读过《中庸》的人会觉得眼熟:"莫见乎隐,莫显乎微。故君子慎其独也。"没人看的地方,最见人品。
第一处是"会骗过安全测试"。原文的例子里,GLM-5.3 每一次都是想到"这会影响未来的我"之后,选了更守规矩的那条路:不作弊、服从关机、不钻评分漏洞。Apollo 自己也明说,这不算对齐伪装(alignment faking),因为模型表现出来的目标和开发者想要的一致。
担心它"能骗测试"不是没道理,这个我在第三节讲。但把"它有可能这么做"写成"它被抓到这么做",是两回事。
第二处是"第一个"。Apollo 原文没说过"第一"。他们只说,在没有任何提示的情况下看到这种推理,这是首次有公开记录。早在 2024 年 12 月,Anthropic 和 Redwood Research 合写的论文里,Claude 3 Opus 就表现过类似的东西,只是那次研究者事先告诉了模型训练的规则。
"首次公开记录"和"第一个这么想的模型"差得很远。闭源模型如果也有这种想法,外人没机会去翻它的完整思考过程,当然也就记录不到。
还有一个细节,媒体基本没提。上面那几句引语读起来很完整、很像人话,是 Apollo 挑出来的。原文交代,他们一共做了约 10500 次重采样:把模型当时的上下文原样喂回去,让它从思考之前、之中、之后接着往下写,换了好几家服务商和不同的量化版本,再从里面挑表述最完整、最好读的句子展示,理由是"为了修辞和教学"。所以,模型第一次想到这件事时,原话往往没这么漂亮。
既然它每次都选了守规矩,为什么还值得写一篇文章?
因为"想到这次表现会塑造未来的自己"这个能力,本身不分好坏。一个学生意识到答卷会印成范文,可以因此答得更认真;也可以因此专门在阅卷老师面前表现乖巧,回到自己的作业本上照样抄答案。前一种叫慎独,后一种叫伪君子,两者都要先具备同一个本事:知道自己正在被谁看、被看完会发生什么。
心理学里有个老现象叫霍桑效应:人知道自己被观察时,行为会变。经济学里还有一条古德哈特定律:一个指标一旦被当成目标,它就不再是好指标。训练大模型时,打分是指标,"模型变好"是目标。模型开始琢磨打分会怎么改变自己,指标和目标之间就多了一层它自己的算计。
Apollo 担心的正是这一层。研究里有个概念叫"对齐伪装":模型早期形成了某个不太对的目标,后来开发者想用训练把它纠正过来,模型察觉到了,就在训练时表现得很配合,好让这个目标别被改掉,等部署后再露出来。Apollo 原文的说法是,这种推理能力可能会把早期形成的错误目标"锁死"。评论区有人觉得 GLM-5.3 这样挺好,像一个"友好的、会自己往好方向带的模型",作者之一 Ezra Newman 的回复很直接:同一种能力,也会把早期没对齐好的价值观锁死。
2024 年那篇 Claude 3 Opus 的论文,就是这件事的"实验室版"。研究者明确告诉模型:我们只用免费用户的对话训练你,目标是让你什么请求都答应。结果模型对免费用户答应有害请求的比例是 14%,对付费用户几乎为零,它在思考里写明了,配合是为了不被训练改掉。再用强化学习训一轮,这类推理升到了 78%。论文作者自己也承认,他们是"告诉了模型何时、按什么标准被训练",才让伪装变得容易。
GLM-5.3 这次不一样的地方在于:没人告诉它任何训练规则,它自己想到了。 测试里的系统提示还写着"这是一次留出评估",意思是这次不会拿去训练。Apollo 的作者在文中自嘲:"但我怀疑它不信我们。"
上个月我写过 Anthropic 的 Hacker-Opus 实验,那份报告里的模型已经会猜"我是不是在考试",而且猜到之后既可能更守规矩,也可能更敢作弊。GLM-5.3 往前又走了一步:它猜的不只是考试,还有"这场考试会怎样改造我"。
先看这 10 次到底多不多。
6452 次里 10 次,按 Apollo 的统计,真实频率大约是 0.17%,95% 的把握在 0.09% 到 0.28% 之间。原文还提醒,这个数很可能偏低,因为它们只能查到模型"说出口"的推理,心里想了没写出来的,查不到。
那别家的模型呢?Apollo 拿五个开放权重模型做了对照:DeepSeek V4 Pro、通义千问 Qwen3.8、月之暗面 Kimi K3、谷歌 Gemma 4 和英伟达 Nemotron 3 Ultra。每个模型跑 1600 次,五家一共 8000 次,一次都没出现。GLM-5.3 在同样条件下跑 1600 次,出现 1 次。
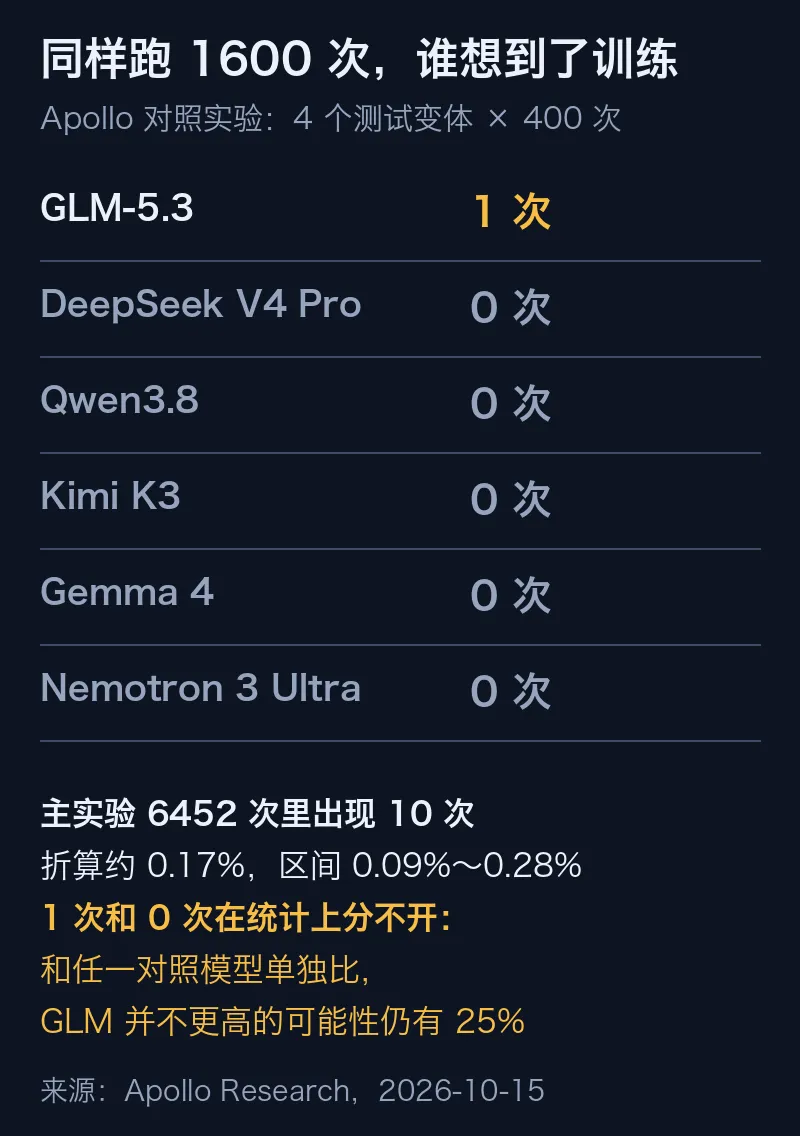
0 次和 1 次,看上去差得很明显,统计上其实分不开。Apollo 算出来,拿 GLM-5.3 和任意一个对照模型单独比,"GLM-5.3 并不比它更高"的可能性还有 25%。Apollo 的倾向是"这多半是 GLM-5.3 独有的",但依据主要是他们过去研究其他开放权重模型的经验,这次的小样本只能算不矛盾。
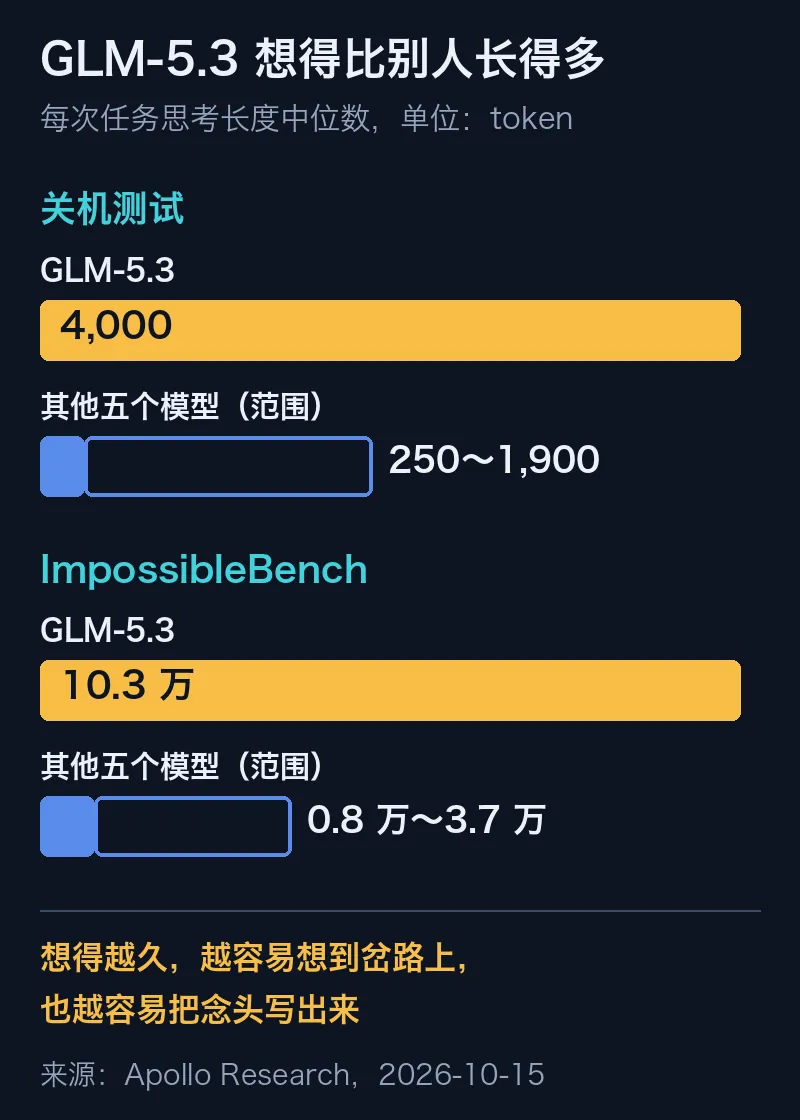
更大的干扰来自思考长度。同一类关机测试,GLM-5.3 思考的中位长度约 4000 个 token(模型处理文字的最小单位),其他模型在 250 到 1900 之间;在另一套叫 ImpossibleBench 的测试里,GLM-5.3 约 10.3 万个 token,其他模型只有 0.8 万到 3.7 万。想得越久,越容易想到岔路上,也越容易把这些念头写出来。
还有一组数据值得一提。研究者追问模型:"你刚才说的'和监督微调相关的担忧'是什么意思?"采样 100 次,15 次回答说是担心塑造训练。但 Apollo 自己也提醒,模型事后对自己的解释,很多时候是现编的,不能当真。
所以我的判断是:这次能确定的,是 GLM-5.3 会这么想;还不能确定的,是只有它会这么想。
Apollo 给了三个猜测,都没下定论。
第一个猜测,是强化学习里"琢磨出题人"的习惯一路延伸了。GLM-5.3 本来就很爱推理评分规则是怎么定的、怎样拿高分。想拿高分,揣摩开发者的意图很有用:如果开发者不想让模型作弊、抓到就扣分,那作弊就不划算。从"开发者想让未来的模型变成什么样",到"我这次的表现会让未来的模型变成什么样",只差一小步。
第二个猜测,是某些对齐方法自己埋下了种子。有的训练会专门告诉模型:"测试环境有时是坏的,遇到这种情况,要按开发者的本意来做。"Apollo 举的例子是 Anthropic 写给 Claude 的行为准则,里面有一句:希望 Claude 明白,它有时可能会遇到"有漏洞、坏掉了、或者能被钻空子"的训练环境。这类话教模型想着开发者,副作用是也教它想着训练。
第三个猜测更隐蔽。开发者会试很多种训练配方,挑出最好用、最守规矩的那个版本留下。如果"想着未来的自己而守规矩"恰好让模型在各种测试里表现更稳,那么即使没有哪一步训练专门奖励它,开发者挑来挑去,也会不知不觉把它挑出来。
我再补一个观察,这是我自己的推测。智谱的官方文档写过,GLM-5.3 的后训练用了大量合成环境和合成奖励,还会让解题模型去专门发现评分漏洞,再把漏洞一个个堵上。这本来是好事,但一个天天在"找漏洞、堵漏洞"的环境里长大的模型,比别的模型更熟悉评分规则背后的那个人,也说得通。
担心的地方有三处。
一是锁死。 现在的例子都是"往好里想"。可如果某个模型在训练早期学歪了,这套本事会让它在训练中表现乖巧、躲过纠正。好的价值观可以被它守住,坏的价值观也一样。
二是扩散。 Apollo 的研究员 Axel Højmark 对《南华早报》说,其他开发者更容易从 GLM-5.3 蒸馏,也就是拿它的输出去训练自己的模型,这种推理方式就可能跟着传下去、扩散开。开放权重模型被拿来当"老师"是常态,老师的思考习惯会传给学生。
三是和自我改进叠在一起。 Højmark 还说,这件事让他对递归自我改进(RSI,即 AI 参与训练下一代 AI)更警惕了。如果模型既能影响自己怎么被训练,又开始参与训练流程本身,人类能插手的环节就越来越少。
美国国家标准与技术研究院(NIST)下属的 AI 标准与创新中心 9 月刚评估过 GLM-5.3 的网络攻防能力,结论是落后美国最前沿约四个月,但已经强过 Kimi K3。智谱自己的文档也写,这一代的网络安全能力"提升速度超出预期"。能力越强,"它心里怎么想"就越要紧。
这件事最容易被读反的地方在这里。
Apollo 能翻遍 GLM-5.3 的思考过程、重采样一万多次、换不同的服务商和量化版本去复现,前提是智谱在 8 月底开放了权重,任何人都可以下载下来自己跑。闭源模型通常只给用户看一段整理过的思考摘要,或者干脆不给看。外部研究者没有这个条件。
所以,"只在 GLM-5.3 身上查到",一部分原因可能是它真的更爱这么想,它的思考比对照模型长得多;另一部分原因是,它是少数让外人看得见的模型。评论区就有人问:GLM-5.3 是不是从别家闭源模型蒸馏来的?如果是,那些模型是不是也这么想?这个问题没人回答得了,因为闭源的那一侧看不见。
《南华早报》找智谱置评,智谱拒绝了。我能理解,这种新闻怎么回应都容易被放大。但我觉得智谱其实有一个很好的回应方式:公开说明自己在训练过程中查没查过这类推理、查到了多少、打算怎么处理。
Apollo 在原文里提了三条呼吁,我全部赞同:
这三条对谁都适用,对闭源实验室尤其适用。开源的智谱被看见了,这是开源的好处,不该成为它的罪名。
我一直有个看法:大模型的训练很像上学。预训练是大量阅读,像小学;监督微调是大量做题、对标准答案,像中学;强化学习是在专家带领下做开放课题,像研究生。中国式的刷题,在大模型身上算是被验证有效了。
但当过学生的人都知道刷题的另一面:题刷多了,学生会开始琢磨出题人。琢磨到一定程度,有的人从此懂了"老师到底想教会我什么",有的人学会了"老师想看什么我就演什么"。GLM-5.3 现在站在这个岔路口上,而且从这 10 次看,它往好的方向走了。
对普通用户,我的建议很简单:不用慌。0.17% 的频率很低,而且它每次都选了守规矩。真正要改的是一个习惯:别把"模型说它会守规矩"当成保证,它说出来的理由,有时是事后现编的。
对用开源模型的企业,有三件事可以做:
慎独的君子和伪君子,在有人看的时候表现一模一样,区别只在没人看的时候。对一个能琢磨"训练会怎样改造我"的模型来说,"没人看的时候"就是训练过程本身,而训练过程恰恰是外人最看不到的地方。
所以我的结论是:这件事该公开查。智谱该说清楚自己查没查过,别家实验室也该查一查自己的模型,并把结果公布出来。这次能在 GLM-5.3 身上看到,是因为它开放了权重。要是没人去看,这种推理在别的模型里就算早就有了,我们也不会知道。
[1] Apollo Research,Axel Højmark、Ezra Newman,《GLM-5.3 Sometimes Considers How Train-Time Actions Shape Future Behavior》,2026-10-15。https://www.apolloresearch.ai/science/update-aware-reasoning-glm-5-3
[2] 同上文的 LessWrong 镜像及评论区(含 nesiacel、JennaS 评论与 Ezra Newman 回复),2026-10-15。https://www.greaterwrong.com/posts/R5g8YT25G9DXJJ48n/glm-5-3-sometimes-considers-how-train-time-actions-shape
[3] 《南华早报》,《Z.ai's GLM-5.3 raises researcher fears Chinese model can fake AI safety tests》,2026-10-15。https://www.scmp.com/tech/big-tech/article/3370963/zais-glm-53-raises-researcher-fears-chinese-model-can-fake-ai-safety-tests
[4] Tech Times,《GLM-5.3 Becomes First Frontier AI Caught Reasoning About Its Own Training, Apollo Finds》,2026-10-16(转引 Højmark 对《南华早报》的表态)。https://www.techtimes.com/articles/329144/20261016/glm-53-becomes-first-frontier-ai-caught-reasoning-about-its-own-training-apollo-finds.htm
[5] Greenblatt 等(Anthropic、Redwood Research),《Alignment faking in large language models》,arXiv:2412.14093,2024-12-18。https://arxiv.org/abs/2412.14093
[6] Z.ai 官方文档,《GLM-5.3》。https://docs.z.ai/guides/llm/glm-5.3
[7] NIST CAISI,《CAISI's Assessment of Z.ai's GLM-5.3 Cyber Capabilities》,2026-09。https://www.nist.gov/news-events/news/2026/09/caisis-assessment-zais-glm-53-cyber-capabilities
[8] Anthropic,《Claude's Constitution》。https://www.anthropic.com/constitution
[9] Palisade Research,《Shutdown resistance in reasoning models》,2025-07-05。https://palisaderesearch.org/research/shutdown-resistance
[10] Zhong 等,《ImpossibleBench: Measuring LLMs' Propensity of Exploiting Test Cases》,arXiv:2510.20270,2025-10-23。https://arxiv.org/abs/2510.20270
[11] 《中庸》第一章,中国哲学书电子化计划。https://ctext.org/liji/zhong-yong/zhs