ARTICLE · 1210914
GitHub 今日爆火的 AI 语音工具:配音、转写、视频译配都能本地跑
VoiceStudio 是今天 GitHub Trending 里的语音项目。本次检索时,它在 Python 日榜新增约 2,098 个 Star,总 Star 超过 7.5 万。
它是一个本地运行的 AI 语音工具。核心能力包括:声音克隆、声音设计、视频配音、语音转文字、听写、有声书和批量生成。它提供桌面版,也能通过本地 API 和 MCP 接入自动化流程。
这篇只回答五个问题:它能做什么、谁该用、配置怎么选、怎么试、有哪些限制。
▲ VoiceStudio 把本地声音素材、配音、视频和自动化能力收进同一个工作台。
1. VoiceStudio 能做什么
声音克隆和配音
导入一段清晰的参考录音,输入文案,选择模型后生成语音。可以用在文章音频版、课程旁白、产品演示和短视频。
它适合需要长期使用同一声线的场景。比如公众号作者可以用自己的声音制作每篇文章的音频版,课程团队可以给系列视频统一旁白。
视频配音
项目提供按时间对齐的配音流程,适合录屏课程、教程和产品介绍视频。
需要注意:它负责生成和对齐语音,不会自动保证翻译准确。多语言视频仍要人工检查术语、数字、人名和画面节奏。
转写和听写
它可以把录音转成文字,也可以做桌面听写。适合整理访谈、会议录音和口述笔记。
转写结果需要人工校对。中文人名、英文缩写、产品名和技术术语是常见错误点。
批量生成和自动化
它支持故事、有声书、批量任务、本地 API、MCP 和监视文件夹。
例如可以把流程设成:文章定稿 → 调用本地语音生成 → 输出 MP3 → 人工试听 → 发布。这个能力更适合持续产出内容的团队,不只是生成一段试听。
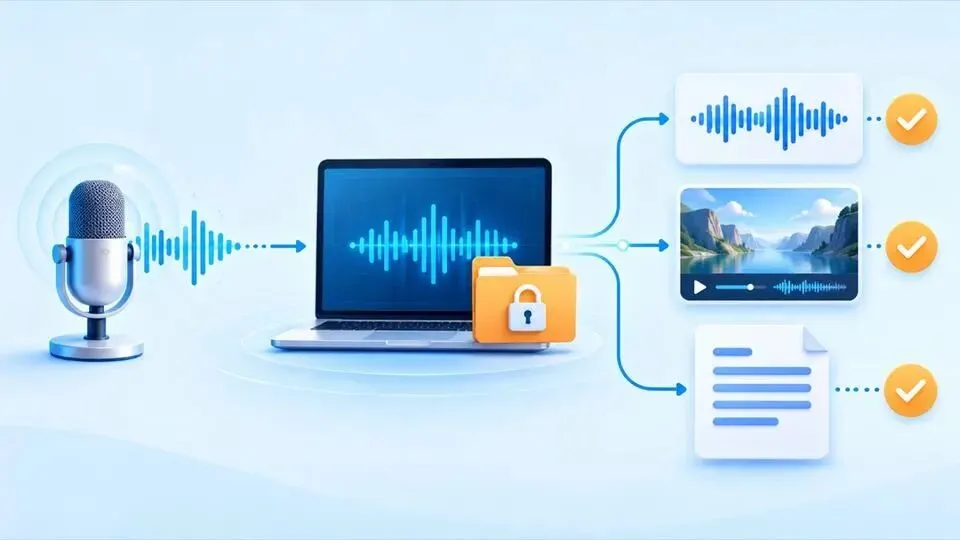
▲ 参考录音在本地处理后,可生成音频、视频配音和转写文本;最终仍需人工审核。
2. 哪些场景可以直接用
3. 谁应该安装,谁只需要先收藏
GitHub 日榜说明这个项目值得关注,不代表它一定比你现有工具更适合。是否安装,取决于你是否有持续的语音生产需求。
4. 配置要求
以下配置针对官方桌面版和默认本地工作流。普通用户下载发行版即可,不需要自己安装 Python、FFmpeg 或编译环境。
| 8 GB RAM、10 GB 可用磁盘 | |||
| 16 GB RAM、20 GB 以上 SSD | |||
| 32 GB RAM、50 GB 以上 SSD |
还要注意这几条:
Windows 上,NVIDIA 显卡可以使用 CUDA。AMD Radeon、Ryzen AI 集显和 NPU 在 Windows 版里都走 CPU。 Linux 可使用 AMD ROCm,但要看具体引擎是否支持。 4 GB 显存可以通过 CPU 卸载运行,但生成速度可能很慢。默认引擎在空闲显存低于 6 GB 时,可能超时或退回 CPU。 Intel Mac 不能在本机运行后端,只能把界面连到另一台机器上的远程后端。 Windows on ARM 仍是实验性方案,后端通过 x64 模拟运行,使用 CPU。 首次启动需要联网下载运行环境和模型。模型、缓存和导出的音频会继续占用磁盘。
5. 第一次怎么试
不要一开始就做长视频或下载大量模型。按下面步骤验证即可。
①从项目 Release 下载适合自己系统的桌面版。
②准备一段清晰、无明显背景噪音、已获授权的参考录音。
③选一段已经校对过的短文,先生成两三分钟的样音。
④试听时重点检查:中文人名、英文缩写、数字、产品名、技术术语和停顿。
⑤记录使用的模型、声音配置和文本版本,再用第二段文案复测。
如果两段不同文案都能达到可用水平,再考虑批量生成、视频配音或 API / MCP 集成。
6. 两个不能忽略的限制
声音必须有授权
使用他人声音做广告、课程、视频或公开内容前,要先获得明确授权。不要把同事、客户或公众人物的录音直接用于测试。
开源不等于所有内容都能商用
VoiceStudio 应用使用 AGPL-3.0。模型权重、声音样本和生成内容可能各有使用条款。商业使用前要分别确认:应用代码、所选模型、参考声音和最终内容是否允许当前用途。
结论
VoiceStudio 值得从 GitHub 日榜收藏,因为它把本地语音生成、转写、视频配音和自动化接口放在了同一个工具里。
对内容作者,先试“文章转音频”;对课程和视频团队,先试“固定声线的配音”;对研发团队,先试本地 API 或 MCP。不要先看 Star 数,先用一段真实文稿和已授权的样音验证效果。
关注公众号,持续获取前后端、AI 与工程实践中的新变化
也欢迎转发给正在解决同类问题的同事