ARTICLE · 1232197
从质谱到虚拟细胞:AI 蛋白质组学的六级台阶,与 ProteinTalks 的实践答卷
色谱质谱,物性表征测试(可合作),实验耗材,仪器设备,技术培训
质谱蛋白质组学AI 虚拟细胞扰动蛋白组神经 ODE
从质谱到虚拟细胞:AI 蛋白质组学的六级台阶,与 ProteinTalks 的实践答卷
2026 年,《Nature Methods》刊发了一篇由 Matthias Mann、Bing Zhang、郭天南等 90 余位学者联署的 Perspective,系统梳理了 AI 在质谱蛋白质组学中的六大关键领域,并把终点指向同一个词——AI 虚拟细胞(AIVC)。几乎同时,西湖大学、北京大学、哈尔滨医科大学联合深势科技在《Nature》上给出了一个可运行的答案:ProteinTalks。本文把这两份材料放在同一条逻辑线上,讲清楚三件事:原理是什么、方法怎么做、案例结果如何。
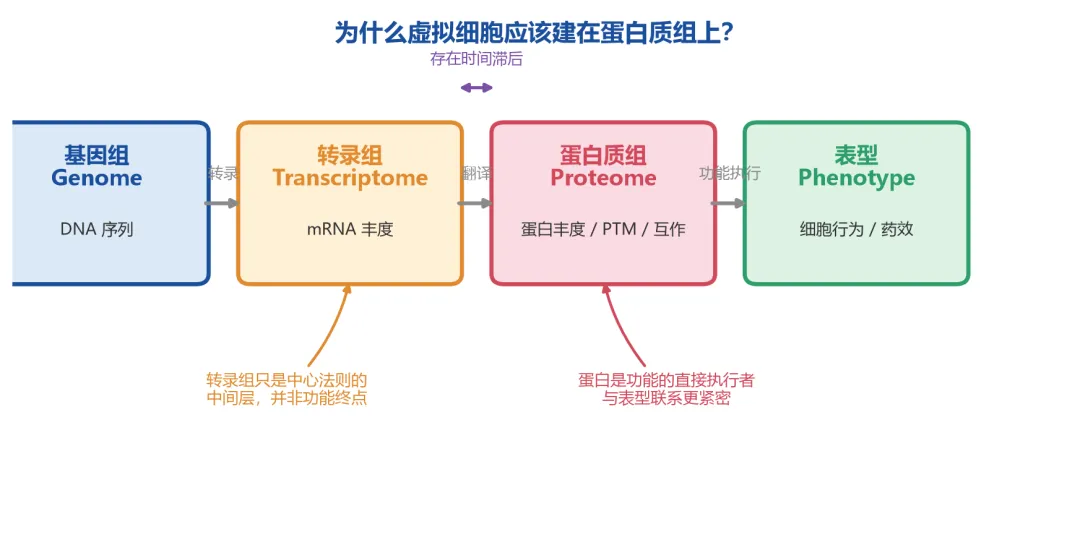
一、虚拟细胞:一个被反复许诺、却迟迟未兑现的目标
1.1 我们到底想要什么
在计算机里模拟一个细胞,让它对药物、基因敲除、环境变化做出可预测的响应——这就是"虚拟细胞"的核心诉求。它的价值非常直接:把一部分湿实验前移到硅基上完成,从而加速药物发现、支撑精准诊断与治疗决策。
难点在于,细胞过程本身是高度非线性的。这意味着虚拟细胞不能靠静态快照训练出来,它必须在真实的动态数据上学习,才能捕捉细胞行为的真实复杂性。这也是《Nature Methods》那篇 Perspective 反复强调的一点:准确建模细胞的响应与动力学,是虚拟细胞的中心难题。
1.2 早期尝试:从支原体到酵母
这个方向并不是新概念。最早的奠基性工作是用约束模型(constraint-based framework) 对最小生物体做全细胞建模:
这条路线的价值在于确立了"整细胞可计算"的可行性,但它的天花板也很明显:约束模型依赖已知的生化反应网络,难以刻画蛋白质层面的动态调控、翻译后修饰与亚细胞定位。
1.3 转录组路线的天花板
近几年,虚拟细胞的主流路线建在大规模单细胞转录组之上。Geneformer、scFoundation、UCE 通过自监督预训练从转录组快照中学习通用嵌入;基于 Perturb-seq 的 STATE、STACK、x-Cell、CellOT 进一步扩展到建模扰动响应;PRESCIENT、trajectorynet、DeepRUOT 则更关注细胞动力学。
但《Nature Methods》的判断很直接:RNA 类基础模型(如 Geneformer、scFoundation)缺乏空间与时间分辨率,这限制了它们捕捉真实动态的能力。
问题出在两个层面:
架构层面。 这些模型通常是为静态细胞嵌入、扰动终点、或在预定义潜空间(如 PCA 嵌入)内做轨迹插值而优化的,而不是从丰富的时序扰动动力学中学习可迁移的表征。
模态层面。 更根本的是,转录组测量只捕捉了中心法则的一个中间层——这可能部分解释了转录组基础模型泛化能力有限的原因。
1.4 为什么必须建在蛋白上
蛋白质编排着几乎所有关键的细胞功能:结构组织、信号传导、代谢、生长调控。它们是健康与疾病的关键参与者,也是主要的药物靶点与治疗制剂。
更关键的一点是:理解细胞状态远远超出"蛋白鉴定"这件事本身。因为功能取决于蛋白质的翻译后修饰(PTM)、亚细胞定位和结合伙伴。同一个基因编码的蛋白,在肿瘤微环境的不同区域可以呈现完全不同的磷酸化或糖基化模式——《Nature Methods》把这种现象称为"基因–蛋白表型不连续性(gene–protein phenotypic discontinuity)",并指出:仅仅扩大训练数据规模,无法解决蛋白功能的上下文依赖调控。
这里还有一个常被忽略的细节:mRNA 丰度与对应蛋白丰度之间的相关性,被多重生物过程精细调控——翻译调控(如 mRNA 二级结构影响核糖体结合效率)、共翻译修饰(如信号肽切割)、蛋白降解通路(如泛素–蛋白酶体系统)。这就是"转录–翻译滞后"的物理来源,也是为什么时间点设计在扰动蛋白组中如此重要。
二、原理篇:AI 正在重塑的六大关键领域
《Nature Methods》这篇 Perspective 把 AI 蛋白质组学切成了六个关键领域(Key Area, KA),并按"生物学复杂度与成熟度递增"的顺序排列。这是一张很好的领域地图。
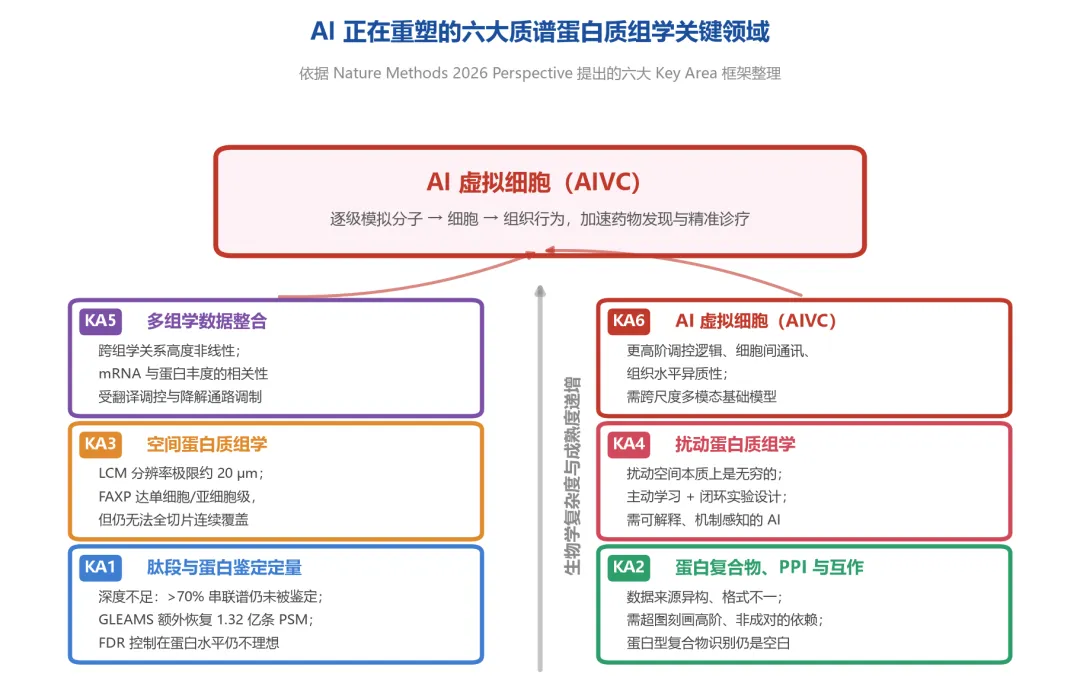
2.1 KA1|肽段与蛋白的鉴定与定量:蛋白质组的"暗物质"
这是整条流水线的地基。最刺眼的数字是:用传统工具分析 MassIVE-KB 原始数据,超过 70% 的串联质谱谱图仍未被鉴定。
这些未指认的谱图里,有多少是"噪声"或技术伪影,又有多少是等待被发现的真实肽段信号?为回答这个问题,GLEAMS 用一个深度神经网络把高质量 PSM 嵌入到低维空间,从 MassIVE-KB 中额外恢复了 1.32 亿条 PSM——但仍有超过 2 亿条聚类谱图未被指认。这是探索蛋白质组"暗物质"的一条现实路径。
暗物质的主体是未被表征的蛋白型(proteoform):单氨基酸变异、可变剪切异构体、PTM。规模有多大?
超过 95% 的人类多外显子基因通过可变剪切产生各种异构体 数百万个非同义单核苷酸多态性可能在人群中出现单氨基酸变异 文献已报道超过 400 种 PTM 类型,dbPTM 等数据库整理了数百万条实验支持的 PTM 位点注释
准确性方面的隐忧。 大多数数据库搜索平台用 target–decoy 策略控制错误发现率(FDR),但这个方法并不完美——近期研究指出,数据库搜索工具的 FDR 控制在蛋白水平和单细胞数据上尤其不理想。而 de novo 肽段测序工具至今仍缺乏内在的 FDR 控制,依赖数据库搜索结果作为 ground truth,这个假设未必总成立。
泛化方面的隐忧。 当前多数 de novo 测序模型训练在人类蛋白组数据 + 相对早期质谱仪上,跨物种、跨新型仪器、跨碎裂方法的能力缺乏稳健证据。
一个有意思的前瞻方向:让模型学会"推理"而不只是"记忆"。借鉴大语言模型的思维链(chain-of-thought)推理,结合混合专家(mixture-of-experts)架构的小型语言模型,可能提供可解释的推理能力,用来区分"正向幻觉"(有用的洞见)与"负向幻觉"(错误或伪影)。
2.2 KA2|蛋白复合物、PPI 与分子互作:从成对关系到超图
大多数蛋白在复合物中行使功能,参与同一细胞过程的蛋白常常相互作用。几十年积累下,已有超过 300 个专门的 PPI 资源,来自湿实验验证与干实验预测两类研究。
三个核心挑战:
- 构建 AI 友好的复合物数据库。
数据来自亲和纯化–质谱、共分级–质谱、交联–质谱、基因/蛋白表达、共免疫沉淀、X 射线晶体学、冷冻电镜、核磁共振……格式、分辨率、覆盖尺度全都不同,异构性严重阻碍归一化与整合。 - 识别蛋白型复合物(proteoform complex)。
已有方法能识别单个蛋白型,但扩展到复合物层面仍是空白。 - 刻画复合物的动态性。
PTM、异构体、单氨基酸变异驱动的成分与结构变化,恰恰是理解功能的关键。
由于蛋白复合物与互作网络本质上是高阶、非成对依赖的,引入超图(hypergraph)来表达它们,可能提供一个忠实的数学框架——这是这篇 Perspective 给出的一个具体技术建议,对应超图卷积网络(HGNN+)这类架构。
2.3 KA3|空间蛋白质组学:20 μm 的分辨率天花板
空间蛋白质组学被《Nature Methods》评为 2024 年度方法。它在两个尺度上工作:组织区域间的异质性,以及细胞内区室与亚细胞结构的蛋白分布。
技术路线分两支,各有短板:
质谱路线提升分辨率主要靠激光捕获显微切割(LCM)。但常规 LCM 有一个约 20 μm 的内禀分辨率极限,真正的单细胞分析很难做到。突破口是把 LCM 与组织膨胀水凝胶耦合——FAXP(filter-aided expansion proteomics)由此实现了单细胞乃至亚细胞分辨率,但仍无法提供连续的全切片覆盖。
AI 在这里的角色是空间推断:S4P 与 PLATO 用深度神经网络和迁移学习增强空间推断、提取潜在分子特征、整合多模态数据,把质谱空间蛋白质组学推向"计算重建的组织图谱"。虽然这些框架本身还没达到真正的单细胞精度,但与膨胀质谱工作流结合有潜力弥合这一差距——组织膨胀在物理上"疏散"了分子结构,提升了与质谱兼容的采样分辨率。
2.4 KA4|扰动蛋白质组学:无穷的扰动空间
这是本文案例(ProteinTalks)所属的领域,值得多说几句。
扰动蛋白质组学系统性地追问:生物系统如何响应遗传、化学或物理刺激?测量的是蛋白水平的变化。它的独特价值在于——蛋白质组学提供了对功能性细胞状态与动态响应的直接视角,补充了相对稳定的基因组背景与转录组捕获的调控信息。
扰动之后,可以测量的蛋白组特征远不止丰度:蛋白靶点定量、PPI、PTM、蛋白周转(turnover)、亚细胞定位、酶活性。把这些与表型数据整合,就能在分子改变与系统级结果之间建立因果链,为预测建模与治疗设计打基础。
但这里有一个根本性约束:扰动空间在本质上是无穷的。刺激、剂量、时程、细胞背景的组合变化,穷举实验是不可能的。而且传统的假设驱动设计,往往会漏掉那些超出既有生物学直觉的高信息量扰动。
《Nature Methods》给出的解法是闭环主动学习:
AI 模型可以通过检测"模型不确定性高、扰动表征不足"的区域,识别现有数据集中的信息缺口。主动学习框架优先安排那些单位成本信息增益最大的实验——比如预测能够解析网络歧义的新型化合物–时间–剂量组合。这形成一个闭环:初始蛋白组数据训练模型 → 模型优先排序生物学信息量高的扰动 → 新实验改进预测。
这个思路的底气来自一个判断:细胞响应并非混沌运作,而是受从分子互作的局部规则到反馈回路等全局网络组织原则的约束。神经网络能够从稀疏数据中识别这些约束,从而泛化到训练实验之外。
更远一步是生成式实验设计:让 AI 提出扰动去探测实验上尚未触及的生物学——未经验证的遗传靶点、调控角色不明的低研究度蛋白、机制不明的药物作用、尚未被实验解析的生理通路。这将把蛋白质组学从"观察性生物学"推向"预测性工程学"。
2.5 KA5|多组学整合:非线性是常态,不是例外
多组学整合面临两层障碍。
第一层是数据层面的。 跨组学协调很难,因为数据集常常不配对或不一致,在灵敏度、特异性、覆盖度、平台技术偏倚上各不相同。定量方法、数据尺度、预处理流程的差异进一步阻碍了基因、转录本、蛋白之间的直接比较。加上各机构与仓库存储格式不统一、可及性有限。
第二层是生物学层面的,也是更深的。蛋白与基因组、转录组、代谢组之间在丰度、修饰状态、互作网络上存在高度非线性的调控关系。单细胞蛋白质组学进一步揭示:蛋白复合物在不同细胞亚群间呈现不同的组装模式,而这些差异常常无法由基因组或转录组数据预测。
应对策略包括迁移学习、多任务学习、表示学习与数据增强。具体架构上:
- 图卷积网络
:建模蛋白–蛋白与药物–蛋白互作网络,预测多药联用副作用 - 联合嵌入(joint embedding)
:把质谱蛋白组与转录组映射到统一特征空间,消解平台间不一致 - 超图卷积网络
:捕捉高阶、非成对关系 - 神经常微分方程(neural ODE)
:对动态数据集,可同时建模代谢组(时序质谱数据)与磷酸化蛋白组(激酶活性动力学)的耦合动力学
注意最后一条——neural ODE 在这篇 Perspective 里被明确列为多组学动态建模的候选方案,而 ProteinTalks 正是这条思路的落地实现。
2.6 KA6|AI 虚拟细胞:终局
把前五个领域串起来,终点就是 AIVC:一个被设计用来模拟分子、细胞与组织行为的计算模型,有潜力加速发现并指导实验。
实现路径是逐级模拟:先模拟核心细胞分子(DNA、RNA、蛋白、代谢物)→ 再建模它们的互作与形成的复合物 → 进而逐步模拟亚细胞结构、细胞器、生物分子凝聚体 → 最终是整个细胞。
在这条链条里,蛋白不仅是结构组分,更是细胞最主要的功能单元。因此全面的时空蛋白表征对构建 AIVC 至关重要。
人类 AIVC 的独特挑战是:更高阶的调控逻辑、细胞间通讯、组织水平异质性。Human Cell Atlas 已生成跨多种人体组织器官的单细胞与空间分辨数据集,支撑了基于 Transformer 与图神经网络的细胞类型鉴定和互作网络重建。目前 laid the groundwork 的三项工作是:Geneformer、scFoundation(RNA 基础模型,但缺时空分辨率)、ProteinTalks(蛋白组基础模型)、State(在超过 1 亿个扰动细胞的基因表达数据上训练的 Transformer,能在未见过的细胞背景中识别有效扰动)。
六大领域速查表
三、方法篇:质谱数据如何变成 AI 能吃的"饲料"
3.1 DIA vs DDA:一个关于通量的取舍
要理解 ProteinTalks 的数据策略,得先理解它为什么选 DIA(数据独立采集) 而不是 DDA。
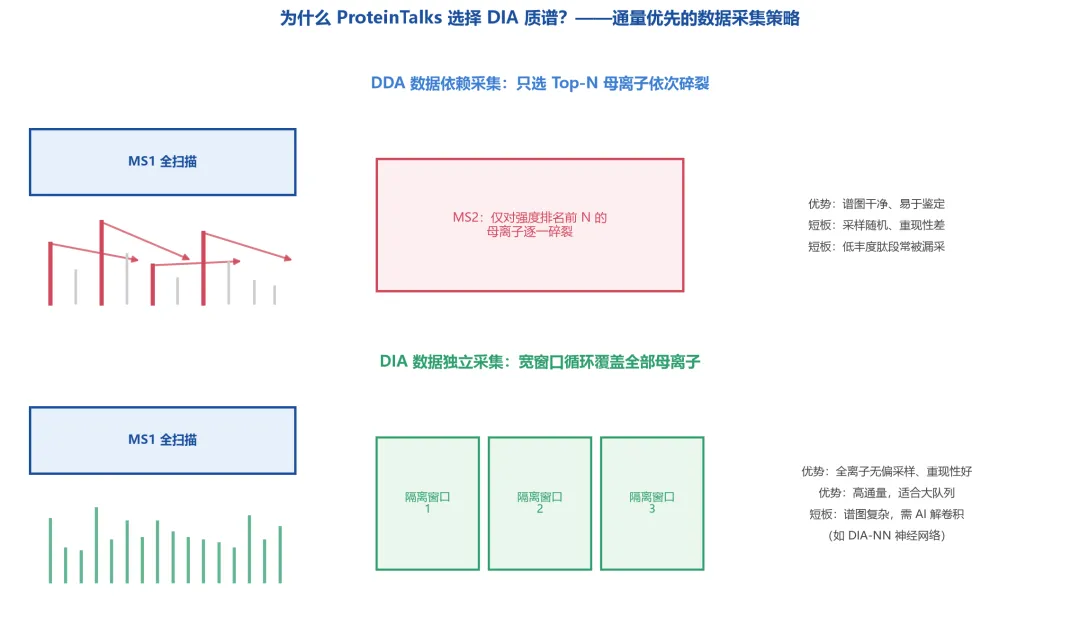
DIA 的核心价值是"通量优先",代价是牺牲了鉴定深度。ProteinTalks 明确承认这一权衡:它的 DIA-MS 策略优先保证通量而非深度,鉴定到的蛋白数(5,585 个)少于超深度方法。而支撑这个策略成立的技术前提,是 DIA-NN 这类基于神经网络的解卷积工具——DIA-NN 用神经网络与干扰校正实现了高通量下的深蛋白组覆盖,已成为该领域广泛采用的工具。
值得记住的是,AI 驱动的 DIA 数据分析仍在快速进步,这意味着"通量换深度"的代价正在变小。
3.2 AI 友好数据生态:蛋白质组学还缺一个 ImageNet
这是整篇 Perspective 最具战略性的呼吁。
AlphaFold 的成功给出了一个中心教训:攻克蛋白质组学的重大挑战,需要专门的大规模数据集用于训练和基准测试——就像计算机视觉的 ImageNet、蛋白结构预测的 Protein Data Bank。这类数据集应当具备代表性、高质量、且 AI-ready。
现状是:PRIDE 与 MassIVE 等公共仓库已托管数百万个质谱原始文件,但至今只有一小部分被用于深度学习模型训练。原因不是数据不够,而是缺乏 AI 友好的数据资源——即带有良好注释元数据、且采用 AI-ready 格式(如张量格式)的数据。
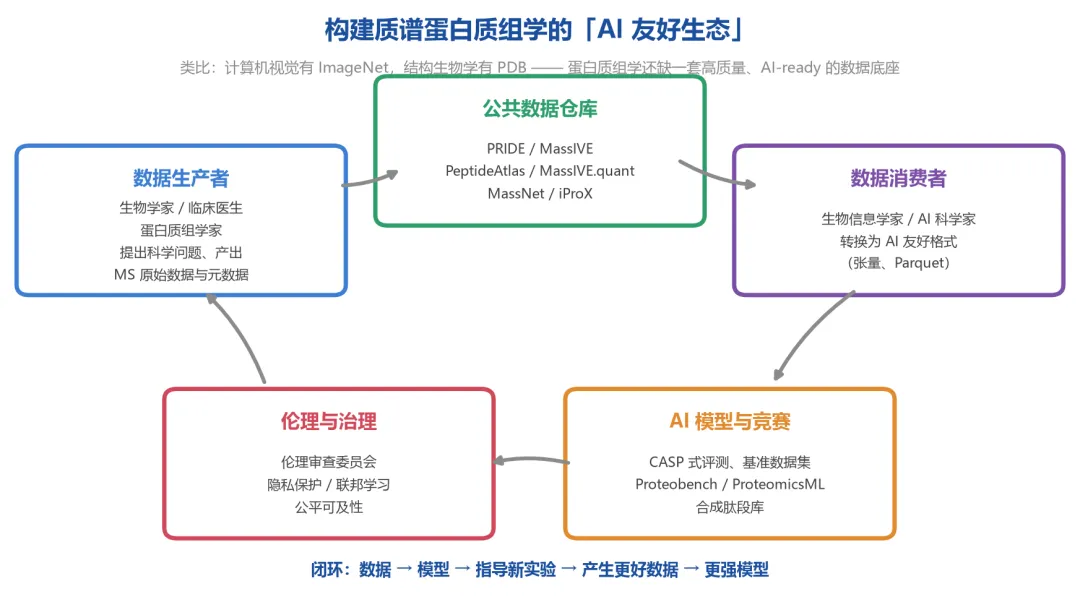
这个生态需要五方协同:
几个具体抓手:
- 训练数据
:PeptideAtlas(注释肽段与蛋白鉴定)、MassIVE.quant(定量重分析数据)、MassNet(AI 友好数据仓库)、quantms(云端定量重分析流水线) - 合成数据
:真实数据有限时,合成数据集提供有价值的补充。已有工作用合成数据预训练和微调蛋白质组学定量的 Transformer 模型并获得性能提升;但跨仪器、跨碎裂方法、跨复杂蛋白型地模拟真实谱图仍然困难 - 基准测试
:Proteobench、ProteomicsML、合成肽段库(ProteomeTools)支撑数据库搜索、de novo 测序、磷酸化位点定位、碎裂方法优化等任务的评测 - 质量控制
:通用 QC 仍然缺失。机器学习用于肽段前体选择与 LC–MS 性能预测已有前景;强化学习可让自主 AI 智能体评估数据质量并动态优化仪器参数(如碰撞能量、隔离窗口宽度) - 社区竞赛
:CASP 式的竞赛能激发协作
伦理层面的硬约束。临床蛋白质组数据经常公开共享,但新证据表明它们可能应被视为个人可识别信息,落入 GDPR 及其他法律限制——与长期以来需要受控访问共享的基因组数据类似。受控访问会因开放数据减少而给 AI 模型训练带来困难。联邦学习(federated learning)提供了一条路:在各站点本地训练模型、全局聚合、同时保护隐私,但它限制了数据与元数据的复用。而且 AI 本身带来了从蛋白组数据中重新识别个体的风险。
还有一个容易被忽视的现实问题: 对生物学家而言,用 AI 工具解决真实科学问题面临基础的实际障碍——GPU 可及性有限、缺乏 AI 训练。轻量级 CPU 友好模型、共享集群、云平台、工作坊与教程可以缓解。对软件开发者而言,提供容器化环境、标准训练流水线、文档完善的示例脚本以提升可复现性至关重要。
四、案例篇:ProteinTalks——把虚拟细胞建在扰动蛋白组上
理论讲完,来看一个跑通的实例。ProteinTalks 由西湖大学医学院/西湖实验室、北京大学机器学习研究中心、哈尔滨医科大学肿瘤医院、深势科技、西湖欧米联合完成,发表于《Nature》。
它的逻辑非常朴素:要建蛋白组的虚拟细胞,得先自己把数据造出来。
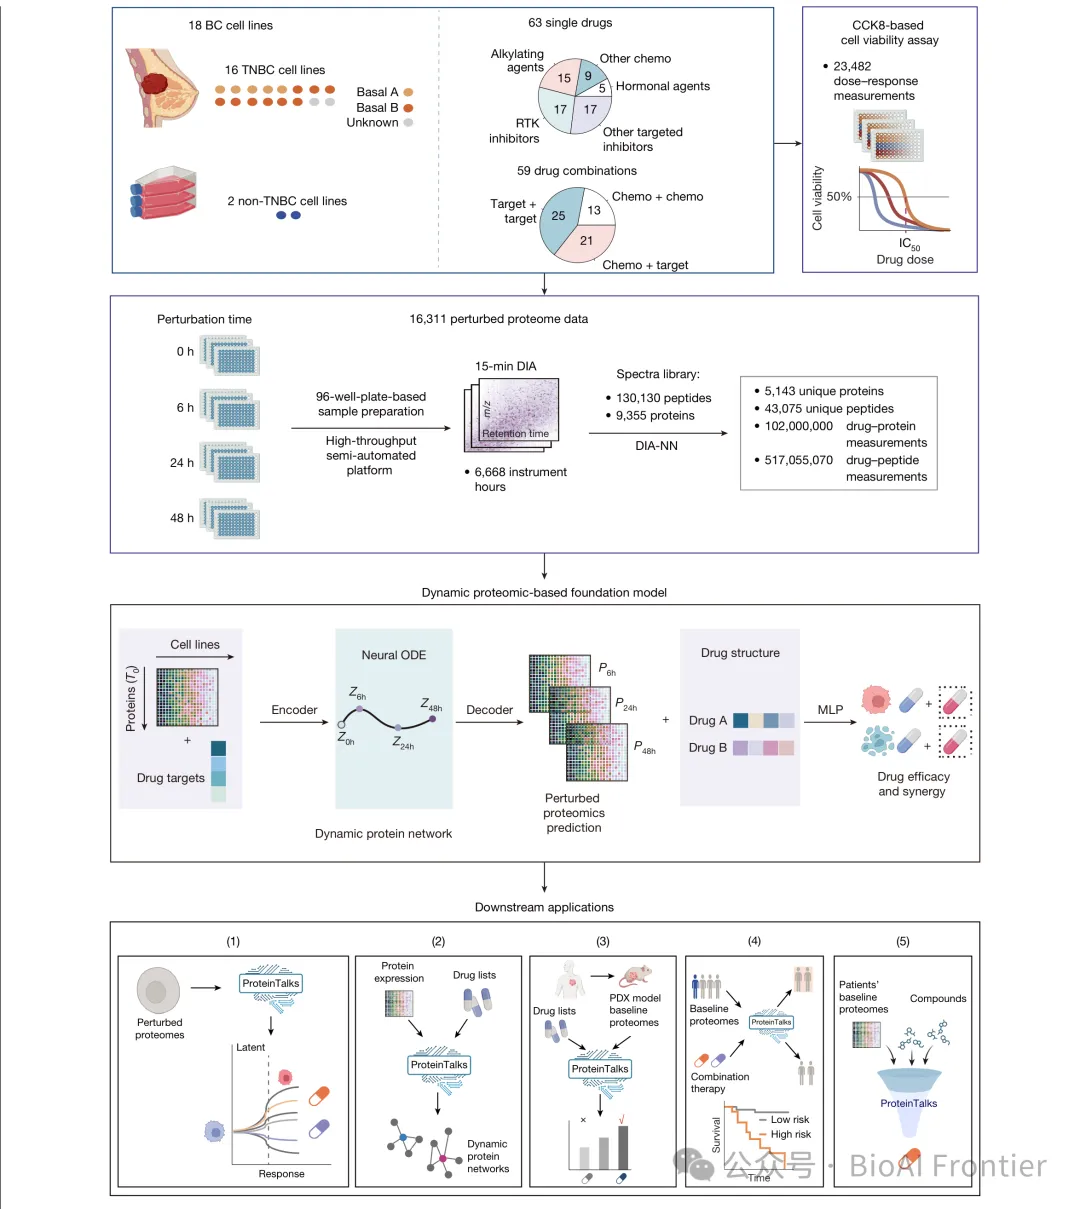
4.1 先造数据:PTDS 资源
这份资源被命名为 PTDS(ProteinTalks Dataset),是迄今报道的最大规模时序扰动蛋白组资源之一。
4.2 时间点怎么定:一次值得学习的实验设计
这是一个很容易被跳过、但方法论价值很高的细节。
既往扰动转录组研究通常在处理后 6–24 小时测量变化。但如前所述,转录到翻译之间存在滞后,直接照搬转录组的时间点未必合理。
作者的做法是先做一次更密的探索:在 3 株细胞系上、用 55 种单药和 57 种组合,在 11 个时间点采样,得到 2,528 份蛋白组样本(mtPTDS)。UMAP 显示样本按采样时间明显分开,形成三个时间簇:
据此选定 6 h、24 h、48 h 作为早/中/晚三相的代表点。
模型侧的验证也支持这个选择,而且揭示了一个有意思的权衡:增加时间点数量会小幅提升准确率(P = 0.03)但降低 AUPRC(P = 0.02)——这是判别力与精确率–召回之间的取舍。最终取四个时间点(0/6/24/48 h)来平衡两者。
这个设计的可迁移经验是:时间点的选择应当同时由数据结构(UMAP 分簇)和模型性能(多指标权衡)共同决定,而不是照搬其他组学的惯例。
4.3 数据本身就有信息:还没建模就先读出 MOA
在进入模型之前,作者先证明这份数据本身能读出药物作用机制(MOA)。这一步很重要,因为它把"数据质量"从模型性能中解耦出来单独验证。
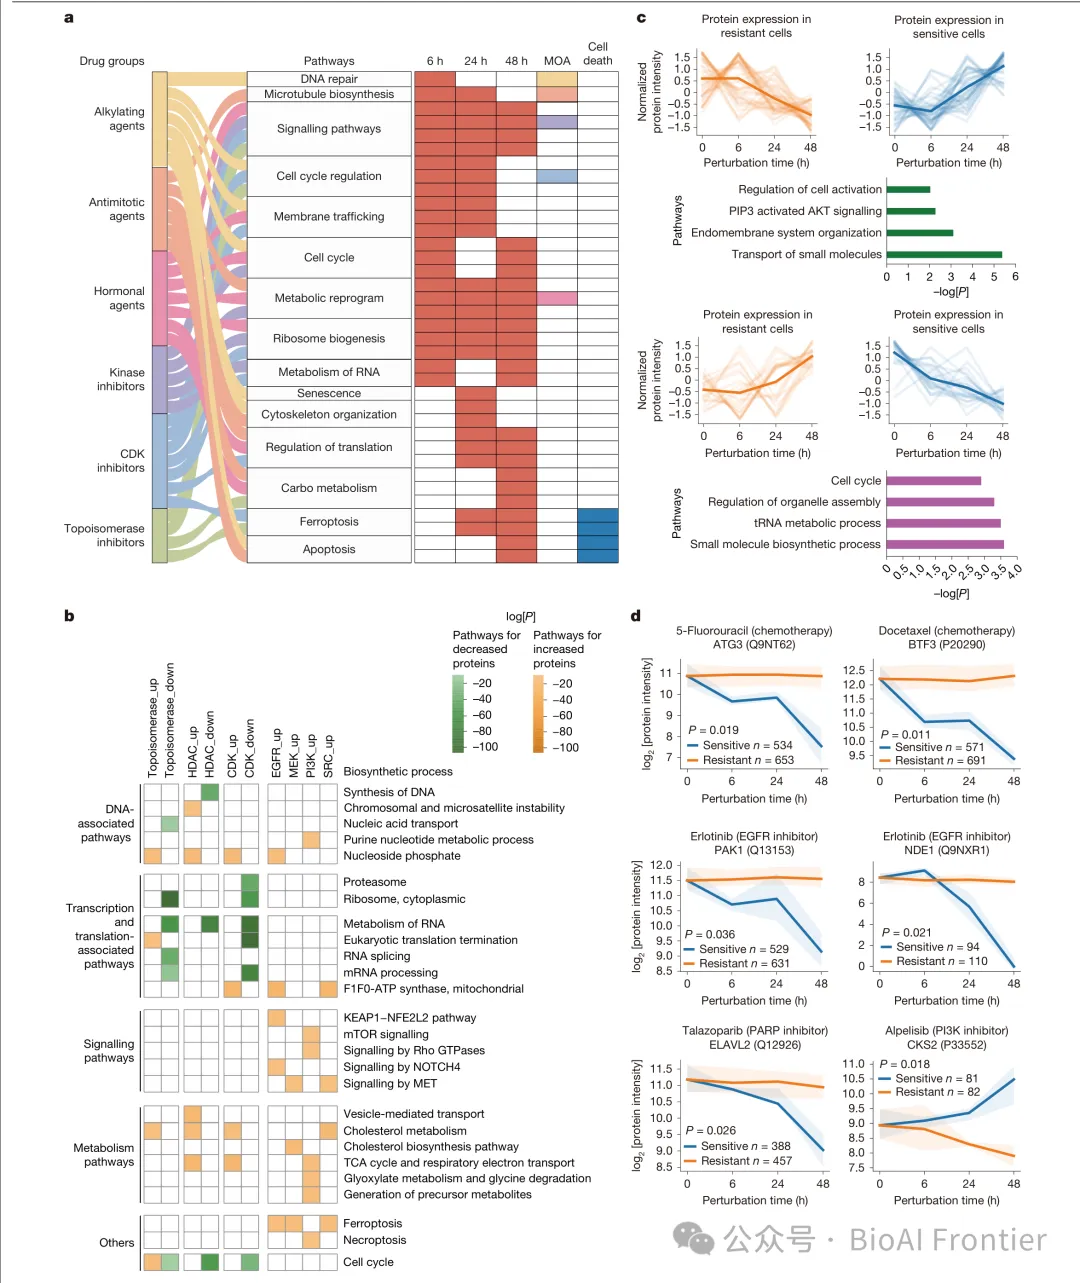
直接靶点。 63 种药物中识别出 61 个蛋白靶点(占全部药物靶点的 48.8%)。典型案例:胸苷酸合成酶 TYMS——卡培他滨代谢物的经典靶点——在卡培他滨耐药细胞中逐步升高;在 HCC1143 细胞中敲低 TYMS 可恢复卡培他滨敏感性,验证了 TYMS 上调是一种耐药机制。
间接响应。 作者开发 PertScore 量化蛋白变化,识别出 823 个扰动相关蛋白(PertScore ≥ 10,FDR < 0.05)。通路富集显示出一条清晰的时间轴:6 小时富集的是 MOA 相关通路,48 小时富集的是细胞死亡相关通路。这些蛋白与通路充当了癌细胞表型转变的"哨兵"。
药物类别特异性。 烷化剂优先影响 DNA 损伤修复;激素治疗改变代谢重编程通路;微管抑制剂调节细胞骨架组织;CDK 抑制剂扰动细胞周期通路——全部符合预期生物学。这是一次很好的"阳性对照"。
时序变化揭示耐药蛋白。 在 CDK 抑制剂耐药组与敏感组之间,63 个蛋白显示差异化动态表达(ANOVA,P < 0.05)。其中 41 个在耐药组中扰动后升高、敏感组中降低,富集于细胞周期、蛋白定位、嘌呤核糖核苷酸代谢与碳代谢;其余 22 个呈相反模式,主要与小分子转运、内膜系统组织和 AKT 信号通路相关。
按药物逐个看 48 小时时敏感/耐药差异最大的蛋白:
4.4 模型:神经 ODE 的双模块设计
ProteinTalks 由两个模块构成,在 3,800 万次蛋白测量(来自 16,311 份扰动谱)上预训练。
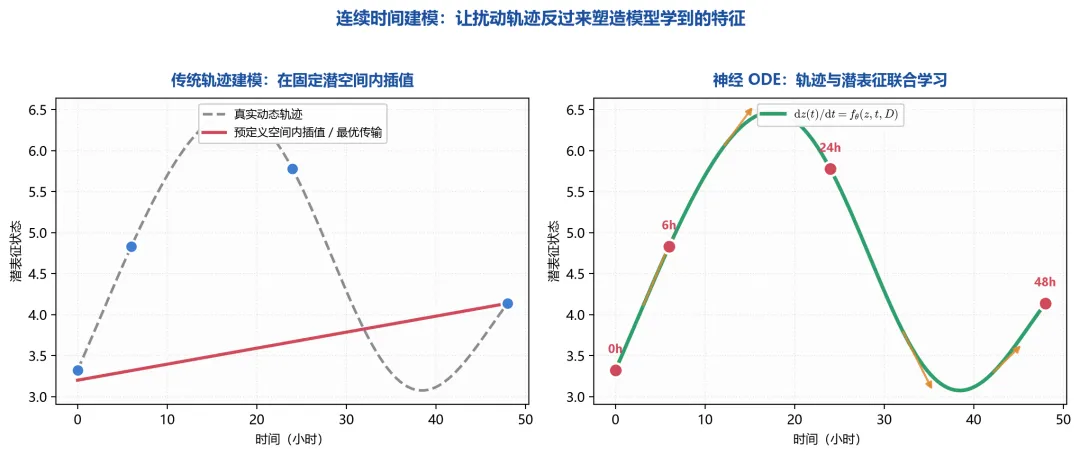
先理解 neural ODE 是什么。 神经常微分方程(Chen et al., NeurIPS 2018)的核心思想是:不把网络看成离散层的堆叠,而是看成一个连续动力系统的求解过程。传统残差网络 h(t+1) = h(t) + f(h(t)) 是欧拉法的一步;neural ODE 把它推广为 dh(t)/dt = f(h(t), t, θ),用标准 ODE 求解器(如 RK4)在任意时间点求值。
这带来三个对本任务至关重要的性质:
- 天然处理不等间距时间戳
——生物实验的采样时间点很少是均匀的 - 参数量与"深度"解耦
——网络深度由求解器步数决定,不由参数量决定 - 建模的是连续轨迹
——不是离散快照的拼接
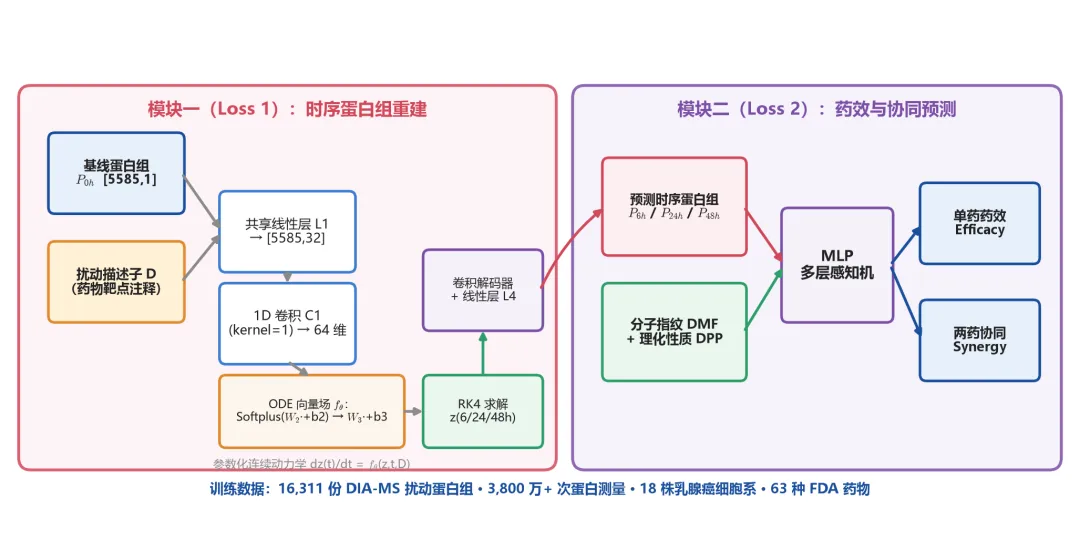
模块一(Loss 1) 编码基线蛋白组与药物靶点,用神经 ODE 预测时序蛋白组变化,再经解码器重建各时间点的扰动蛋白组。
模块二(Loss 2) 把预测出的蛋白组轨迹与药物结构(分子指纹 DMF + 理化性质 DPP)整合,通过 MLP 预测药效与两药组合的协同性。
具体张量流(实现环境:Python 3.10.6 + PyTorch 1.13.1 / CUDA 11.6 + torchdyn 1.0.4 + torchdiffeq 0.2.3):
第 ② 步有一个精巧的设计值得单独指出:用 kernel size = 1 的逐点卷积,而不是在蛋白轴上做全连接。好处有两个——参数量小且与蛋白数无关;并且把每个蛋白的嵌入绑定到它自身的特征,不混合相邻蛋白(蛋白索引轴本身没有"邻近即相似"的语义,混合相邻蛋白是错误的归纳偏置)。
与既往方法的根本差异。 这一点在讨论部分讲得很清楚:与在预定义表征(如 PCA 嵌入)内做插值或最优传输的轨迹建模方法不同,ProteinTalks 让扰动条件下的轨迹主动塑造模型发现什么特征。动力学不是在固定潜空间里跑,而是和潜空间一起被学出来。
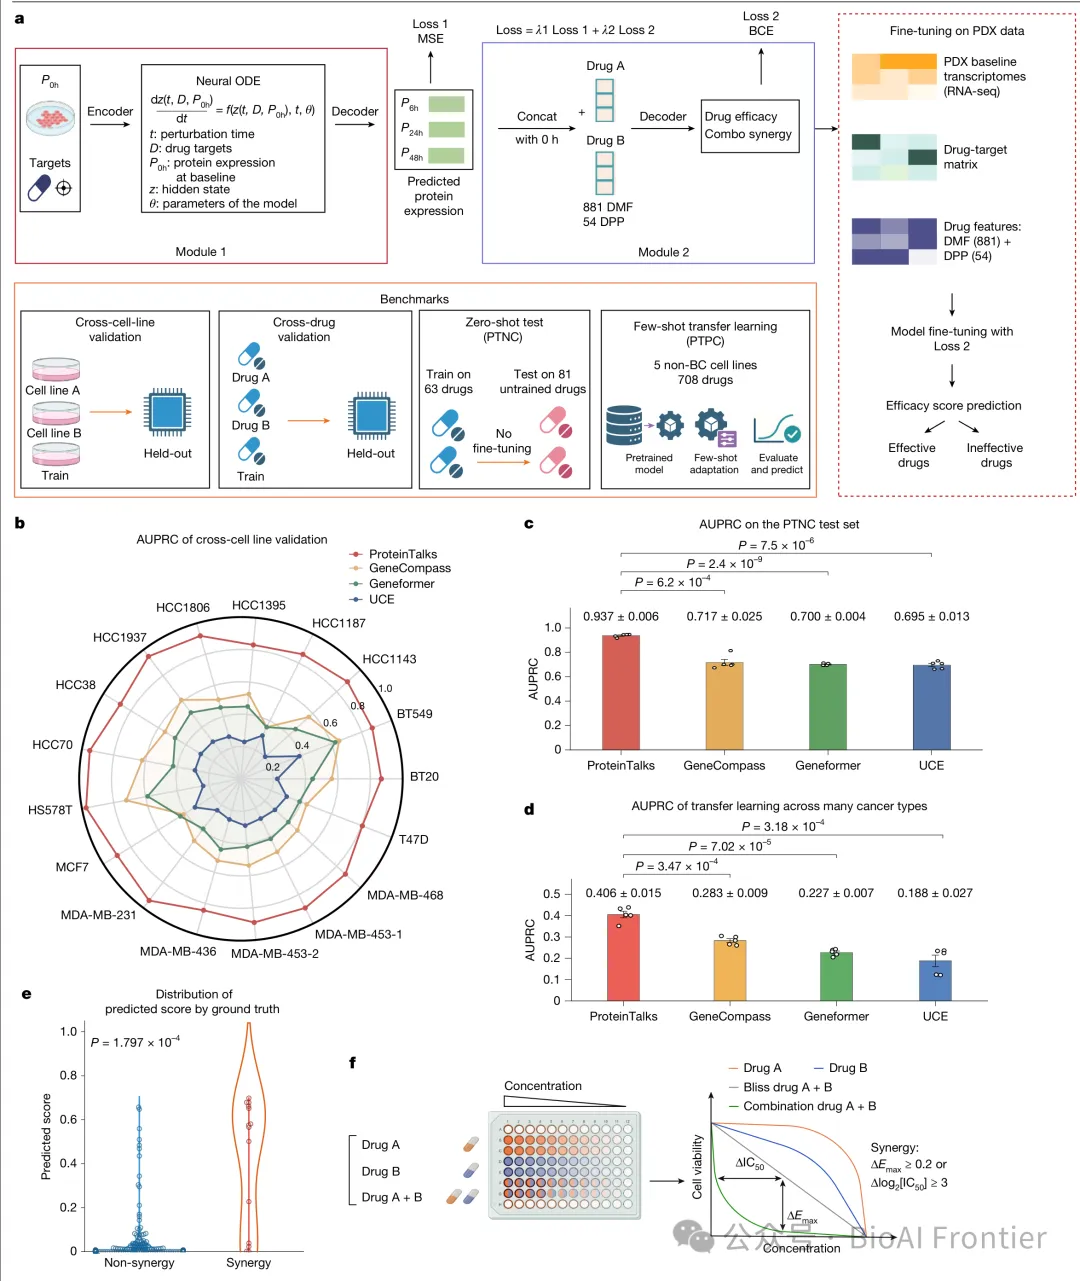
4.5 性能:小模型打赢大模型
对照组共 7 个:3 个转录组基础模型(GeneCompass、Geneformer、UCE)+ 4 个传统机器学习模型(bootstrap aggregation、KNN、随机森林、DeepSynergy)。
基础性能与两种留一交叉验证:
换药验证(PTNC 数据集)。 另外生成一份独立扰动蛋白组数据,覆盖 81 种未参与训练的抗癌化合物、4 株 PTDS 中的 TNBC 细胞系,得到 2,076 次剂量–响应测量以推导药效标签。
| ProteinTalks | 0.94 | 0.89 | 0.85 |
平均提升:AUPRC +32%、AUROC +73%、准确率 +150%。
注意三个转录组基础模型的 AUROC 全部落在 0.50–0.53——基本等同随机。这是一个非常有说服力的证据:在未见过的新药上,从转录组快照学到的表征几乎不携带药效预测信息。
换癌种验证(PTPC 数据集)。 再生成 2,307 份扰动蛋白组,来自 5 株非乳腺癌细胞系(黑色素瘤、结直肠癌、肺癌、胰腺癌),用 708 种再定位化合物处理,在 6 h 和 24 h 采样,定量 5,171 个蛋白。ProteinTalks 平均 AUPRC 0.41、AUROC 0.77,较三个转录组基础模型 AUPRC +74%、AUROC +28%。
药物协同:预测 + 湿实验验证。 预训练数据覆盖 914 个"药物组合–细胞系"对。ProteinTalks 给实验上确认协同的组合打出的协同分数,显著高于非协同组合(双侧 Welch t 检验)。
高排名预测中已有临床证据支持的例子:阿贝西利 + 来曲唑在 ER 阳性晚期/复发子宫内膜癌的 II 期试验(NCT03675893)中显示安全性与持久响应;奥拉帕利 + 替莫唑胺在经治子宫平滑肌肉瘤(NCT03880019)和经治小细胞肺癌中显示抗肿瘤活性。
更硬的是作者自己做的验证——用 CCK8 细胞活力实验测试 4 个高排名预测组合,4 个全部达到预定义的协同标准(ΔEmax ≥ 0.2 或 Δlog₂[IC₅₀] ≥ 3):
4.6 可解释性:动态 SHAP 找出耐药蛋白
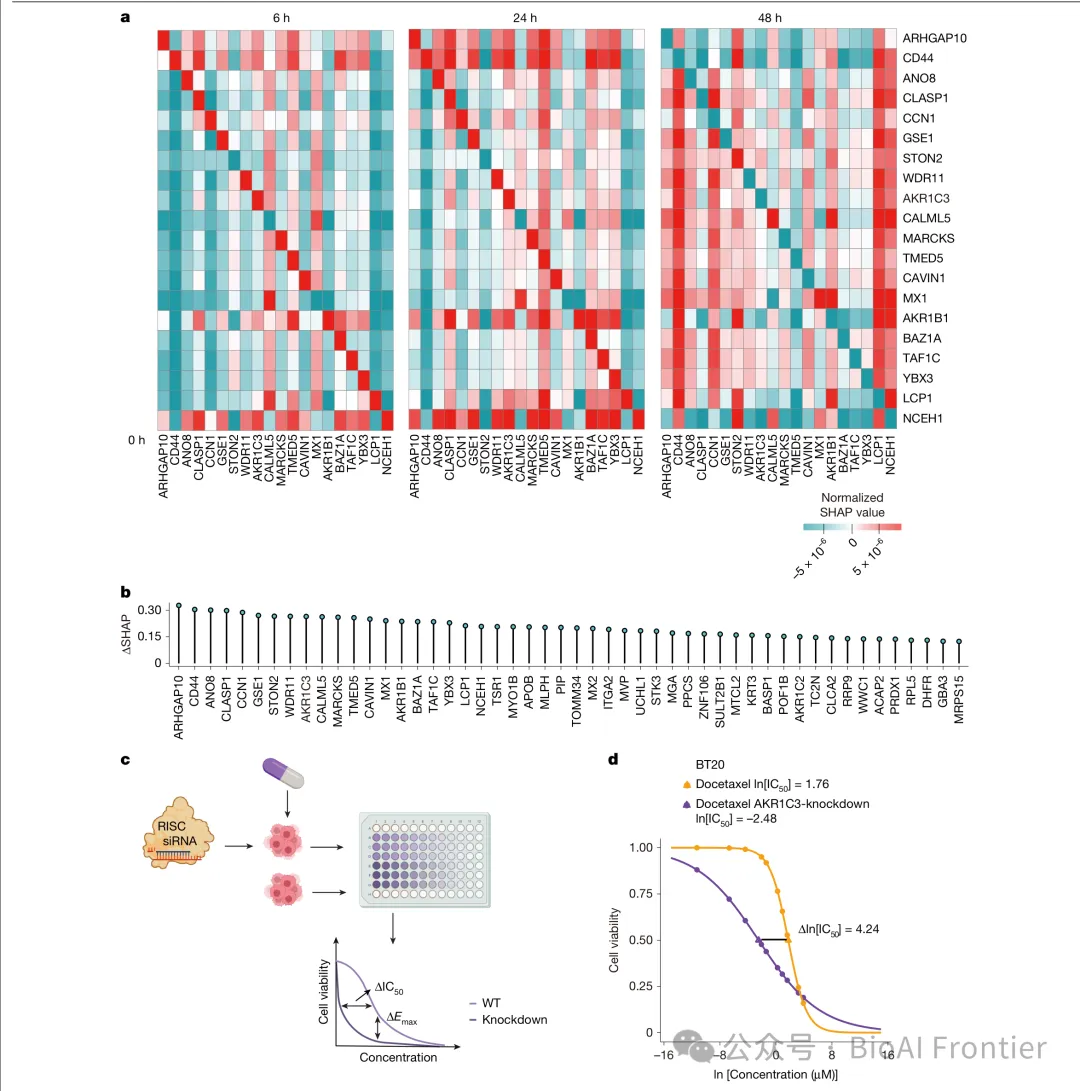
为了弄清药物扰动如何随时间重塑蛋白调控网络,作者从 ProteinTalks 对 6/24/48 小时扰动蛋白表达的预测中计算动态 SHAP 值(SHAP 是基于博弈论 Shapley 值的模型归因方法),并在每个药物类别内比较响应组与非响应组的归因模式。
药物类别特异的时间分化,这是本节最漂亮的结果:
也就是说,ProteinTalks 学到的潜轨迹复现了药物响应在生物学上真实的时间动力学,而不只是拟合了终点。这类"模型自发学出已知生物学规律"的证据,是判断一个黑箱模型是否真的学到了机制的关键指标。
AKR1C3:一个被模型挑出来、又被实验证实的靶点。 用药效 SHAP 值量化蛋白对药物响应的重要性时,除了已知的微管相关蛋白之外,醛酮还原酶 AKR1C3 成为抗有丝分裂药物中最重要的蛋白之一。
作者随即在 BT20 细胞中用 siRNA 敲低 AKR1C3(敲低效率经质谱确认),再做多西他赛细胞毒性实验。结果:敲低 AKR1C3 增强了 BT20 细胞对多西他赛的敏感性(Δln[IC₅₀] = 4.24)。
此外还报告了 18 个与化疗相关、但此前在癌症中功能表征有限的蛋白,例如 ZFYVE19、SYNE2 及若干锌指蛋白——这些是典型的"暗蛋白组"候选。
4.7 临床落地:从细胞系一路走到病人
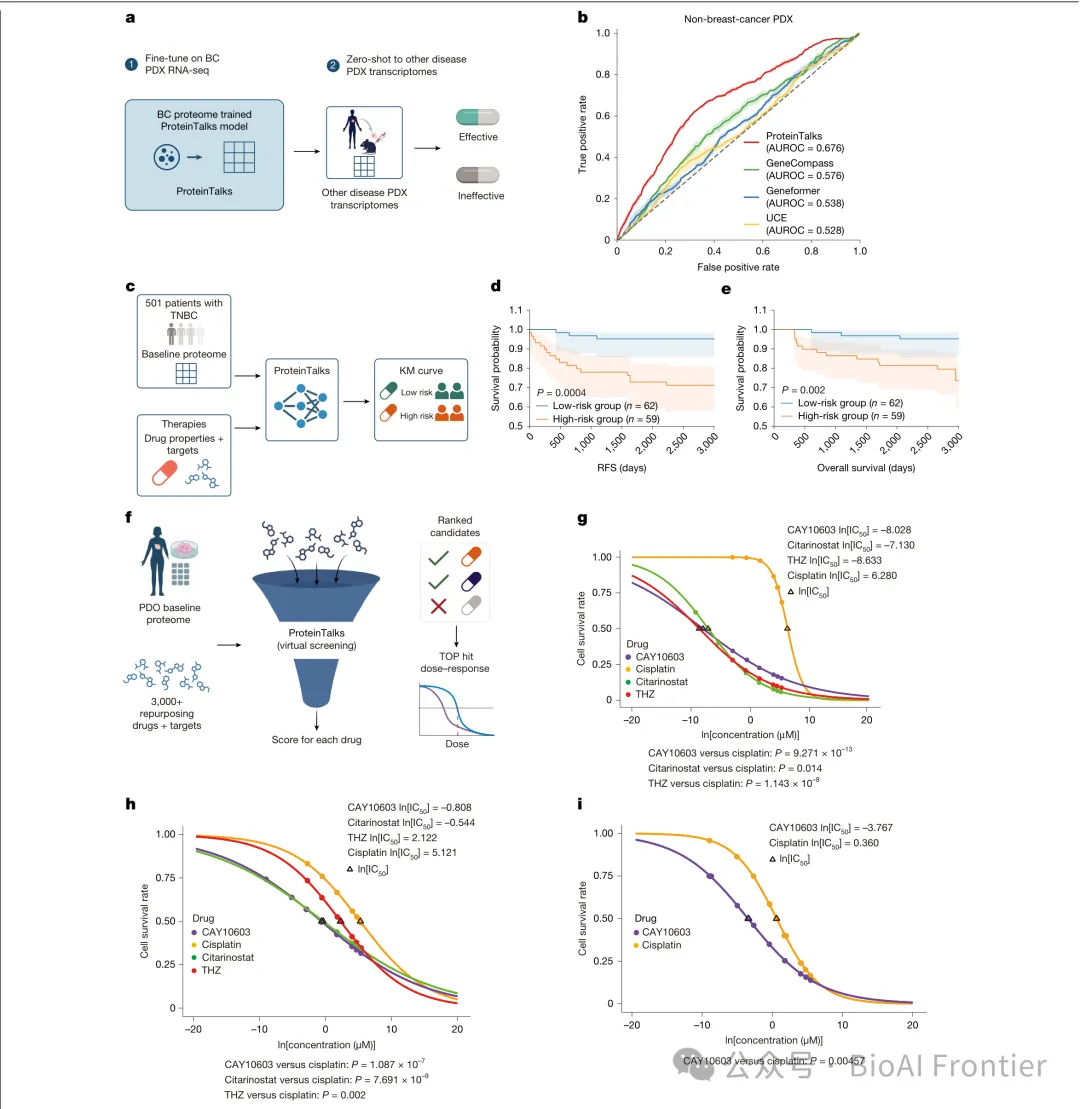
迁移到 PDX 与病人来源肿瘤细胞。 用 30 个乳腺癌病人来源肿瘤细胞模型(经 96 种化合物处理)的转录组微调 ProteinTalks,结果显示在扰动蛋白组上做预训练,比从零训练更好:平均准确率 0.65 → 0.71,AUROC 0.65 → 0.74,AUPRC 0.72 → 0.77。
进一步,用乳腺癌 PDX 转录组微调后,在 140 个非乳腺癌 PDX 转录组上做零样本评估,ProteinTalks 的 AUROC 平均比三个转录组基础模型高 24%(ProteinTalks 0.676 vs GeneCompass 0.576、Geneformer 0.538、UCE 0.528)。
501 例病人的预后分层。 对 501 例未经治疗的三阴性乳腺癌 FFPE 活检标本(这些病人随后接受化疗,队列称 TNBC-HMU)做蛋白组分析,定量 3,583 个蛋白。ProteinTalks 从基线肿瘤蛋白组与治疗方案计算个体化风险评分,按中位数分层后:
无复发生存:P = 0.0004(low-risk n = 62,high-risk n = 59,log-rank 检验) 总生存:P = 0.002
对于接受超出模型两药上限的多药方案的病人,作者还评估了由 SHAP 排名前 100 蛋白构成的生物标志物 panel——同样能分层无复发生存与总生存。这里有一个临床适用性的现实考量:真实治疗方案往往比模型支持的输入维度更复杂,用可解释的特征子集构造 panel 是一种务实的降级方案。
给三位病人的类器官从 3,000 个化合物里挑药。 这是最有临床想象力的一步:ProteinTalks 针对三位 TNBC 病人(P855、P831、P865)类器官的基线蛋白组,从 3,000 个已上市及临床阶段化合物中做虚拟筛选。
顺铂排在候选前列——与这三位病人对含铂治疗的临床敏感性一致(三人均在卡铂–紫杉醇–卡瑞利珠单抗方案下达到 Miller & Payne 5 级完全病理缓解)。这相当于一次天然的内对照:模型在没有看过这些病人临床结局的情况下,把已知有效的药排到了前面。
除标准铂类之外,模型还挑出三个再定位候选:西他司他(citarinostat,HDAC6 抑制剂,I b 期 NCT02551185)、THZ-1(CDK7 抑制剂)、CAY10603(HDAC6 抑制剂)。随后建立三位病人的类器官,做九点剂量–响应细胞毒性实验:
三个候选药在三位病人上的 IC₅₀ 全部显著低于顺铂(双侧似然比检验)。P855 上 CAY10603 与顺铂相差六个数量级(0.33 nM vs 0.53 mM),P = 9.271 × 10⁻¹³。
五、批判性讨论:局限与边界
一篇负责任的技术解读必须把局限讲透。作者自己列出的四条,加上我们从方法论角度补充的观察:
| 而 PTM 恰恰是"基因–蛋白表型不连续性"的核心来源 | |||
关于"小模型打赢大模型"的正确解读。 作者的立论很明确:数据采集与架构设计之间的对齐是 ProteinTalks 的关键特征。系统性时程测量提供了现有蛋白组资源普遍缺失的"时间分辨监督",而这种丰富的时间结构反过来才使得基于 neural ODE 的预训练框架成为可能。
他们特别指出:近期多项基准测试都报告,参数量巨大的基础模型在扰动响应预测上仍然不够用。ProteinTalks 依靠的是时序蛋白组监督和连续时间建模目标,而不是参数规模——用比转录组基础模型少三个数量级的参数,在 18 株乳腺癌细胞系、PDX 模型、501 例病人队列上都表现稳健,并从 63 种训练药物外推到 3,000 个化合物。
这个结论对领域的方法论启示是:在数据模态与学习目标错配时,堆参数是无效的。Geneformer 在 PTNC 上 AUROC 0.51 的表现,不是因为它"不够大",而是因为它学的东西(转录组快照嵌入)与要预测的东西(蛋白层面的药效)之间隔着翻译调控、蛋白周转、PTM 这几层非线性。
一个有意思的展望。 作者提到,ProteinTalks 作为一个"基于时间分辨蛋白组状态转变"的模块,可以自然整合进更广泛的智能体架构——比如 CellForge 那样的多智能体框架:自主设计并优化用于预测单细胞扰动响应的神经网络架构,包含轨迹感知编码器与扰动扩散模块。在这类系统中,ProteinTalks 学到的可泛化表征将充当动态蛋白组骨干,与其他组学专用模块互补,而自主智能体负责协调多组学感知、生物学假说生成与闭环实验验证。
《Nature Methods》的 Perspective 对此有对应的表述:AI 智能体正在催化科学发现的范式转移——从被动预测建模转向自主的闭环探索框架。这类系统可通过多智能体框架(如 Proteomics Lab Agent)大幅加速蛋白质组学的"假设–检验–评估"循环:用计算机视觉解读实验方案、实时监控质谱质量指标、自适应优化采集参数以改善"暗蛋白组"覆盖。
六、结语
把两份材料放在一起看,逻辑闭环非常清晰:
- 《Nature Methods》Perspective 给出领域地图
——六大关键领域按复杂度递增,终点是 AIVC;同时指出每一层的具体瓶颈与 AI 解法,并呼吁建立 AI 友好数据生态。 - ProteinTalks 给出一个跑通的实例
——它精准落在 KA4(扰动蛋白质组学)与 KA6(AIVC)的交汇处,用"先造数据、再造模型"的路径,验证了"虚拟细胞应该建在蛋白上、并且要有时间维度"这个命题。
用一句话概括这项工作的方法论启示:与其把虚拟细胞越堆越大,不如换一层分子(蛋白)、加一个维度(时间)。
而对整个领域,最值得记住的可能是那句关于数据底座的判断——计算机视觉有 ImageNet,结构生物学有 PDB,质谱蛋白质组学至今还缺一套同等量级、AI-ready 的数据基础设施。在这个底座建成之前,"自己造数据"恐怕仍是这个领域最可靠的前进方式。
资源与代码
参考文献
Sun Y, Jun A, Liu Z, Sun R, Qian L, Payne SH, Bittremieux W, Ralser M, ... Mann M, Zhang B, Guo T. AI proteomics: from protein identification to virtual cells. *Nature Methods*, 2026, 23: 1697–1709. DOI: 10.1038/s41592-026-03085-y Sun R, Qian L, Li Y, Liu T, Cheng H, Zhang X, ... Zhou P, Wen H, Zhu Y, Guo T. An operational perturbation proteomics-based virtual cell model. *Nature*, 2026. DOI: 10.1038/s41586-026-11001-9 Bunne C, Stark SG, Gut G, et al. How to build the virtual cell with artificial intelligence: priorities and opportunities. *Cell*, 2024, 187(25): 7045–7063. Qian L, Dong Z, Guo T. Grow AI virtual cells: three data pillars and closed-loop learning. *Cell Research*, 2025, 35: 319–321. Roohani YH, et al. Virtual Cell Challenge: toward a Turing test for the virtual cell. *Cell*, 2025, 188: 3370–3374. Guo T, Steen JA, Mann M. Mass-spectrometry-based proteomics: from single cells to clinical applications. *Nature*, 2025, 638: 901–911. Bittremieux W, May DH, Bilmes J, Noble WS. A learned embedding for efficient joint analysis of millions of mass spectra (GLEAMS). *Nature Methods*, 2022, 19: 675–678. Demichev V, Messner CB, Vernardis SI, Lilley KS, Ralser M. DIA-NN: neural networks and interference correction enable deep proteome coverage in high throughput. *Nature Methods*, 2020, 17: 41–44. Chen RTQ, Rubanova Y, Bettencourt J, Duvenaud D. Neural Ordinary Differential Equations. *Advances in Neural Information Processing Systems (NeurIPS)*, 2018, 31. Lundberg SM, Lee SI. A unified approach to interpreting model predictions (SHAP). *NeurIPS*, 2017, 30. Karr JR, Sanghvi JC, Macklin DN, et al. A whole-cell computational model predicts phenotype from genotype. *Cell*, 2012, 150(2): 389–401. Qian L, et al. Towards the construction of a virtual yeast. *Nature*, 2026, 655: 59–70. Theodoris CV, et al. Transfer learning enables predictions in network biology (Geneformer). *Nature*, 2023, 618: 616–624. Hao M, et al. Large-scale foundation model on single-cell transcriptomics (scFoundation). *Nature Methods*, 2024, 21: 1481–1491. Adduri AK, et al. Predicting cellular responses to perturbation across diverse contexts with State. *bioRxiv*, 2025. DOI: 10.1101/2025.06.26.661135 Zecha J, et al. Decrypting drug actions and protein modifications by dose- and time-resolved proteomics. *Science*, 2023, 380: 93–101. Mitchell DC, et al. A proteome-wide atlas of drug mechanism of action. *Nature Biotechnology*, 2023, 41: 845–857. Yuan B, et al. CellBox: interpretable machine learning for perturbation biology with application to the design of cancer combination therapy. *Cell Systems*, 2021, 12: 128–140.e4. Vogel C, Marcotte EM. Insights into the regulation of protein abundance from proteomic and transcriptomic analyses. *Nature Reviews Genetics*, 2012, 13: 227–232. Mund A, et al. Deep Visual Proteomics defines single-cell identity and heterogeneity. *Nature Biotechnology*, 2022, 40: 1231–1240. Dong Z, et al. Spatial proteomics of single cells and organelles on tissue slides using filter-aided expansion proteomics (FAXP). *Nature Communications*, 2024, 15: 9378. Hu B, et al. High-resolution spatially resolved proteomics of complex tissues based on microfluidics and transfer learning (PLATO). *Cell*, 2025, 188: 734–748.e22. Qin R, Ma J, He F, Qin W. In-depth and high-throughput spatial proteomics for whole-tissue slice profiling by deep learning-facilitated sparse sampling strategy (S4P). *Cell Discovery*, 2025, 11: 21. Wen B, et al. Assessment of false discovery rate control in tandem mass spectrometry analysis using entrapment. *Nature Methods*, 2025, 22: 1454–1463. Bittremieux W, et al. Deep learning methods for de novo peptide sequencing. *Mass Spectrometry Reviews*, 2026, 45: 507–526. Jun A, et al. MassNet: billion-scale AI-friendly mass spectral corpus enables robust de novo peptide sequencing. *bioRxiv*, 2025. DOI: 10.1101/2025.06.20.660691 Dai C, et al. quantms: a cloud-based pipeline for quantitative proteomics enables the reanalysis of public proteomics data. *Nature Methods*, 2024, 21: 1603–1607. Liu Z, et al. DIA-BERT: pre-trained end-to-end transformer models for enhanced DIA proteomics data analysis. *Nature Communications*, 2025, 16: 3530. Gao H, et al. iDIA-QC: AI-empowered data-independent acquisition mass spectrometry-based quality control. *Nature Communications*, 2025, 16: 892. Cai Z, et al. Federated deep learning enables cancer subtyping by proteomics. *Cancer Discovery*, 2025, 15: 1803–1818. Mann SP, Treit PV, Geyer PE, Omenn GS, Mann M. Ethical principles, constraints, and opportunities in clinical proteomics. *Molecular & Cellular Proteomics*, 2021, 20: 100046. He F, et al. π-HuB: the proteomic navigator of the human body. *Nature*, 2024, 636: 322–331. Kustatscher G, et al. Understudied proteins: opportunities and challenges for functional proteomics. *Nature Methods*, 2022, 19: 774–779. Qian L, et al. AI-empowered perturbation proteomics for complex biological systems. *Cell Genomics*, 2024, 4: 100691. Senior AW, et al. Improved protein structure prediction using potentials from deep learning (AlphaFold). *Nature*, 2020, 577: 706–710. 图文说明:本文中图 1(ProteinTalks 工作流总览)、图 4(纵向蛋白组响应)、图 6(架构与性能基准)、图 8(可解释性探索)、图 10(临床相关性评估)来源于 BioAI Frontier 公众号对 Sun et al., *Nature* (2026) 的解读文章,原论文插图版权归 Springer Nature 及原作者所有,此处仅作学术交流与科普传播之用。其余示意图(图 2、3、5、7、9、11)为本文依据文献内容自行绘制。
想要需要获取更完整更多相关学习内容和资料可以加入纷传资料库:仪器分析前沿资料信息库
仪器分析学苑是,致力于为广大科研工作者、技术人员和学生提供丰富的仪器分析知识、实验技巧和行业动态,可以获取您想要的技术文档,测试优惠,实验耗材,尤其对照品和塑料制品,目前开发了免费质谱工具和质谱解谱软件,一包烟可以加入小圈子获取持续更新仪器学习科研资料http://s.a0j.top/C8dcMnC/CBETB
···························································································································
AI人工智能问答资料库-内容含不限于仪器分析学苑知识库 仪器研发,代谢组学,分子网络,质谱分析,液相气相 访问链接:https://metaso.cn/s/d63ODAn
2. 如需要仪器分析学苑-质谱学堂 团队包年技术咨询,可以加入仪器分析学苑知识星球【含积累3年+的资料库,免费专家群包年咨询多对一解答问题】
https://t.zsxq.com/0fi0l3WGy
加入仪器分析知识星球享受的福利如图:
质谱辅助与解谱软件 ms assistant使用权限
!
3. 仪器分析学苑 可以提供SVIP贵宾服务:
苑主 SVIP个人咨询(单次一对一或单人包年):苑主玩耍质谱10年+,精通气相液相质谱化合物解析,方法开发,涉及empower软件,masslynx软件,unifi软件 qsight simplicity, waters,安捷伦,ab,pe质谱联用技术,分子网络GNPS等
相关的专业群聊:
盖独学难成, 唯友为益也,我们给大家建立了一个学习,交流,资源的专业分享平台,群里除了日常可以提问,大神会帮助解答以外,群中还有很多老师分享的文档、资料、书籍,绝对让你受益匪浅!为了防止机器人和无关人员加入:现有两种进群方式
行业动态,职业发展【科学家雄鹰计划】目前分为分析,制剂,生物三个板块【行业大佬背书】
加入一: 分析科学家雄鹰计划群聊a与b,已经超过200人,有大量资源,现转为收费群(19.9),
加入二:9.9元红包,直接入分析科学家雄鹰计划群C,生物科学家雄鹰计划A与制剂科学家雄鹰计划A,关注加星标公众号,在看点赞,转发公众号任意文章在朋友圈3h不删除,邀请入群
测试平台:
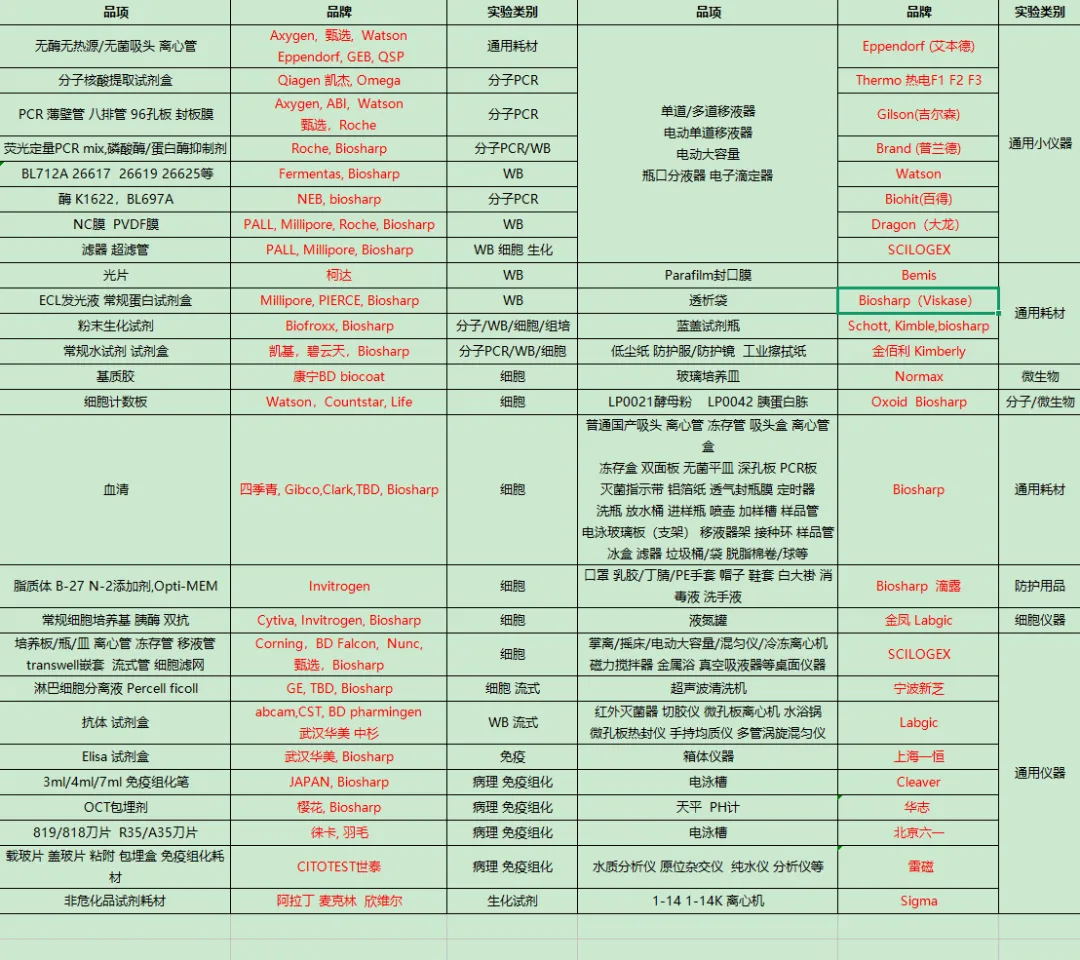
实验室生化环材耗材一站实服务,日常耗材,通用仪器
兰杰柯商城https://mall.labgic-ljk.com/,私聊下单,会员可有折扣或福利,优势代理,比克曼,白鲨等,代谢蛋白前处理耗材,其他材料
2. 对照品
20w种有证生化环标准物质bepure(特色同位素液标)https://www.bepurecrm.com/
有证杂质质控:https://www.cato-chem.com/
甄准https://www.zzsrm.cn/ 其他:中药 低聚糖 农残兽药脂质优势代理
3.化学中间体与材料供应
4 复杂中药定性定量测试分析,质谱解谱,代谢组【非靶广靶靶向空间代谢组】,蛋白组,分子网络培训,物性检测SEM ,冷冻SEM,XRD,DSC,TG,ITC,BET等
支持代购分子物质与生化试剂代理品牌:麦克林,阿拉丁,targetmol,sigma, 科进 洁特 耐思 碧云天 索莱宝 凯基 麦迪康 施睿康 源叶 三鹰 江莱 亚科因 陶术 Absea Apexbio,酶免,艾迪生欢迎咨询等
基于公众号的国内首个科研问答智能体上线了。
大家关注公众号这么久,有些知识搜不到,或者需要找色谱质谱科研资料,我们训练了几十本色谱质谱书籍及包括上千篇公众号文章,而且不断更新,现在关注公众号,后台发送需要提问问题,或者使用公众号中仪器分析学苑智能体小程序,就可以问答知识,快速找资料了 ,更多咨询问题和资料请关注仪器分析学苑知识星球
部分来源于互联网,B站,公众号等
END
声明:本公众号所有转载文章系出于传递更多信息之目的,且明确注明来源和作者,不希望被转载的媒体或个人可与我们联系,我们将立即进行删除处理。所有文章仅代表作者观点,不代表本站立场。