ARTICLE · 1239526
70B 模型下了一整天,我才知道下载模型不止一条路
【闫工的工具箱 · 第 31 弹|运维兵器库】
去年有次客户临时要个开源大模型,点名要 70B 那个档位的。我想着这不就是下个文件吗,多大点事。
结果下了整整一天。
中间断了七八次,每次断了我重跑命令,它从头开始;跑到 90% 断一次,我心态就崩一次。最后下完一算,有效下载时间加起来其实不到两小时,剩下的全耗在重来上——这笔账,怎么算都不划算。
复盘那天的时间线,大概是这样:
上午 9 点:直连,速度 30 KB/s 上下。我先让它跑着,去干别的活了; 上午 10 点多:才知道有镜像站这回事,速度上到 10 MB/s,心里刚松一口气; 下午:又断。重跑,再断。心态就是在这几次里磨没的; 快下班:最后一块权重总算拖完,一看表,一整天没了。
那天之后我就开始琢磨这事,把能走的路挨个试了一遍——不是拍脑袋列清单,是每条都真跑过。现在固定用其中两条,剩下三条也各有各的用处。
— — —
先说清楚这是个什么东西
Hugging Face 就是个放模型的仓库,跟放代码的 GitHub 是同一类,里头存的是训练好的模型权重,Qwen、Llama、DeepSeek、Mistral、Gemma 都在。所谓 70B,说的是 700 亿个参数,落到文件上是几十到一百多 GB——这不是下个软件,是搬一堆数据。
麻烦在两个地方:一是它大,大到网络稍微抖一下就前功尽弃;二是仓库在境外,直连速度看运气,几十 KB/s 是常态,连不上也不稀奇。
所以这件事的正解不是"找个更快的网",是换条路走。
— — —
路一:HF 镜像 + 官方命令行(我默认走这条)
这是我第二个试的。为什么不是第一个?因为那天上午,我连镜像站的存在都不知道。
设个环境变量,同一条命令重跑一遍,速度从 30 KB/s 提到 10 MB/s,那一刻的感觉是:"早干嘛去了。"
但这只是"能用",不是"最快"。下小模型够了,下 70B 还是慢,所以我又接着试下一条。
最省事的办法其实只有一行:
# 设置镜像端点,建议写进 ~/.bashrc,一劳永逸export HF_ENDPOINT=https://hf-mirror.com# Windows PowerShell 写法$env:HF_ENDPOINT = "https://hf-mirror.com"
设完之后,所有走 huggingface_hub 的调用都会自动改道镜像站——transformers、datasets、peft 全算,你自己的业务代码一行都不用改。这一点我觉得是它最大的价值:不用满项目去替换域名。
然后下载就一条命令:
# 下载模型到本地目录,带断点续传huggingface-cli download --resume-download Qwen/Qwen3-72B-Instruct \--local-dir ./qwen3-72b# 下载数据集(注意 --repo-type dataset)huggingface-cli download --repo-type dataset --resume-download wikitext \--local-dir ./wikitext
几个参数我用得最多:
--resume-download断点续传。这个必须有,没有它断一次就从头来一次,我第一天的悲剧就是这么来的; --local-dir指定存哪; --token <HF_TOKEN>下需要授权的模型时用。
⚠️ 有个坑我踩过:早年的写法要加 --local-dir-use-symlinks False,否则--local-dir底下是一堆软链接,看着有文件,实际内容在缓存目录里,你一打包拷走就全碎了。但新版本huggingface_hub已经把软链接这块改掉了,如果你执行时提示这个参数不存在,说明你的版本默认就下真实文件,把参数去掉即可。下完务必ls -l看一眼,确认是真文件不是箭头。
Python 里加载不用改任何代码,它自动跟着环境变量走镜像:
from transformers import AutoTokenizer, AutoModelForCausalLMmodel_name = "Qwen/Qwen3-72B-Instruct"tokenizer = AutoTokenizer.from_pretrained(model_name, cache_dir="./qwen3-72b")model = AutoModelForCausalLM.from_pretrained(model_name, cache_dir="./qwen3-72b")
什么时候走这条:绝大多数情况。尤其是你已经有代码在用 from_pretrained,加个环境变量就完事,改动成本为零。
— — —
路二:多线程下载器(赶时间就走这条)
镜像解决了"连不连得上",但 70B 的体量摆在那儿,单线程还是慢。我嫌它不够快,才找到这条:hf-mirror 提供了一个叫 hfd 的脚本,底层是 git 加 aria2,能把连接分片并发跑。
第一次跑还报了个错:找不到 aria2c。装上再跑,速度直接顶满带宽。
# 拿脚本,授权wget https://hf-mirror.com/hfd/hfd.shchmod +x hfd.sh# 基本用法export HF_ENDPOINT=https://hf-mirror.com./hfd.sh Qwen/Qwen2.5-1.5B-Instruct# 指定目录 + 开并发(千兆带宽开 16 条基本能跑满)./hfd.sh Qwen/Qwen2.5-1.5B-Instruct --tool aria2c -x 16 --local-dir ./qwen25-1.5b# 需要授权的模型:带上用户名和 token./hfd.sh meta-llama/Llama-3.3-70B-Instruct -u <用户名> -t <token> \--tool aria2c -x 16
-x 后面是并发连接数,我一般这么给:
开太大没意义,链路本身跑满了再加并发只是给自己找丢包。够用就行,别使蛮力。
📌 我自己的分界线是这样的:一个模型下两次以上,或者超过 50 GB,就上 hfd。 小模型用路一就行,多一事不如少一事。
— — —
路三:国内源(长尾模型之外的兜底)
真正让我把"一整天"压到二十分钟的,是这条路。
有些时候镜像站也不稳,或者你要的模型正好国内源有,那就直接用魔搭(ModelScope)。
pip install modelscopemodelscope download --model Qwen/Qwen3-72B-Instruct --local_dir ./qwen3-72b
它的 Python 接口跟 HuggingFace 是兼容的,代码基本不用改:
from modelscope import AutoModelForCausalLMm = AutoModelForCausalLM.from_pretrained("Qwen/Qwen3-72B-Instruct")
优点是稳,自带国内 CDN,主流模型基本都有。 缺点是长尾模型不一定同步——你要下个冷门的、刚放出来两天的研究性模型,魔搭上大概率没有,那就退回前两条路。
我的用法是:先看魔搭有没有,有就用它,没有就走镜像。 判断成本就一次搜索的事。
— — —
另外两条路,知道就行
直链批量下载和直接 Python 加载,这两条我没当主力用过,但各有各的场景,顺带提一句。
直链的做法,是在模型页面的 "Files and versions" 里把要的文件直链复制出来,攒进一个文本文件批量下:
# hf_model_download.txt 里每行一个直链aria2c -x 16 -s 16 -i hf_model_download.txt
-x 16 是每个文件 16 个并发连接,-s 16 是同时下 16 个文件。它适合"我只要仓库里一部分文件"的场合——有些仓库塞了 fp32、fp16、量化版全套,全下下来几百 GB,你其实只要一种,直链就比整包下省事,只是要多一点手工。
直接 Python 加载,就是最原始的 from_pretrained,不设任何环境变量,走默认域名 huggingface.co,境内就是慢——我那天上午 30 KB/s 的悲剧,就是这么来的。很多教程、很多老脚本都是这么写的,你不用改代码,加一个 HF_ENDPOINT 环境变量,它立刻变成路一。
— — —
一张图帮你挑路
五条路摆完了,但很多人还是会问:那我到底走哪条?我把选择逻辑画成一张图,按三个问题筛一遍就行。
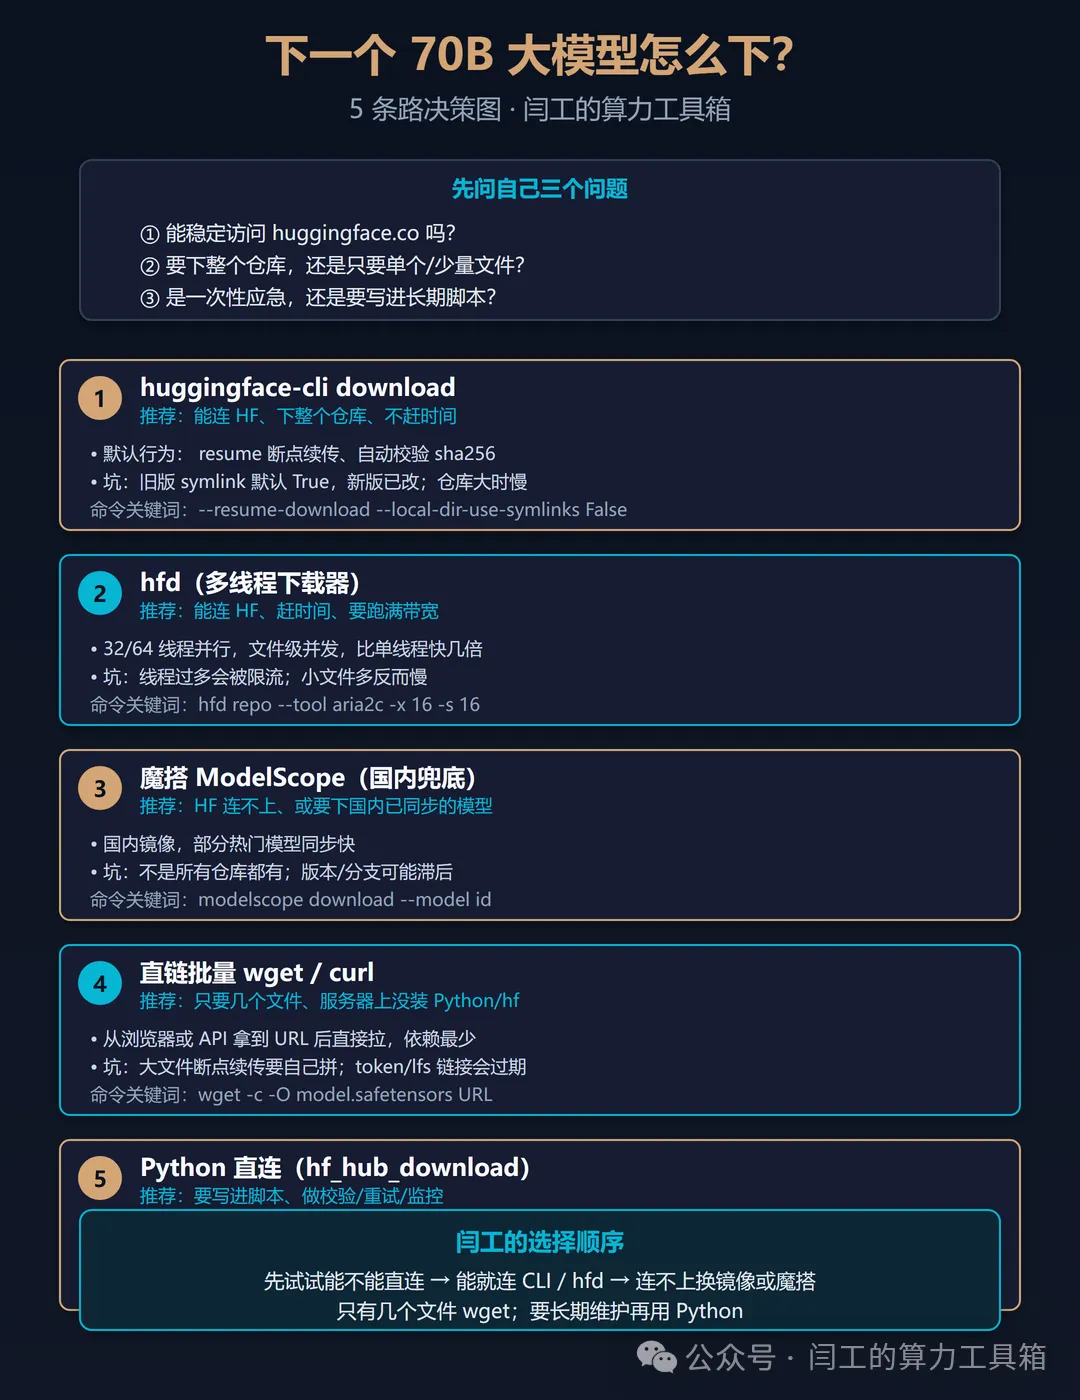
图:下 HuggingFace 模型的 5 条路决策图。先问自己能不能连 HF、要下多少文件、是不是长期脚本,答案基本就出来了。
— — —
下完之后怎么确认没坏
下载完成不等于能用。我固定过这四步:
看文件齐不齐: config.json、tokenizer.json、权重文件(*.safetensors或pytorch_model-*.bin)有没有缺;用 transformers试着加载一遍,能加载起来基本就没问题;断点续传验证一次:故意中断再重跑同一条命令,确认它是接着下而不是从头下; 关键权重做 sha256sum跟官方或镜像站给的校验值对一下。
第 4 步生产环境我一定做。权重文件下载损坏这种事不常见,但一旦发生,症状是训练跑到一半出莫名其妙的 loss 抖动,排查起来能要人命。下完就校验,是最便宜的保险。
— — —
我踩过的坑,都在这一张表里
HF_ENDPOINT 走镜像,或换 hfd / 魔搭 | ||
--token 传入 | ||
--local-dir | --local-dir-use-symlinks False | |
hfd | apt install aria2yum install aria2,或者用默认 git 模式 | |
df -h,留足余量 |
最后那条看着傻,但我真见过。70B 的模型解压完一百多 GB,有人下之前没看盘,下到 98% 报 No space left,从头再来。
— — —
两条安全上的规矩
第一,token 别写进脚本。 Hugging Face 的 Access Token 是个人凭据,你把它明文写在脚本里、提交到仓库、或者贴进日志,等于把账号交出去。要用就走环境变量或者命令行参数临时传,泄露了立刻去 Settings 里撤销重生成。
第二,下载前先看盘和合规。 一是空间,二是受限模型有许可协议,别下完就商用,那跟盗版没区别。
— — —
这套东西可以借鉴的地方
不是因为它有多高明,是因为这件事每个人都会遇到,而且第一次都会踩。
我第一天下那个模型的时候,浪费的不是时间,是耐心——每断一次你就得重新相信一次"这次能下完"。后来我把这几条路摸清楚,同样的事现在二十分钟搞定,中间不用盯着。
真正的差别不在网速,在于你知不知道有别的路。说穿了,五条路都只是手段,你缺的不是更快的网,是一套顺手的工具。
那天之后,我再也没有"从头下过一次"——不是因为网变快了,是因为我知道该走哪条路。
📌 顺带说一句:模型下下来之后那一头——怎么在本地把它跑起来、怎么搭一套不出机房的问答,我在被告警炸醒后,我把DeepSeek装进了机房:从一行命令到本地RAG的6个坑里写过,六个坑都记着。那篇是"装起来",这篇是"拿下来",两头接上才完整。
— — —
END
你们下大模型一般走哪条路?有没有更快的办法我没试过的?评论区说说,好用我下次补进来。
另外想问一句:你们下完权重会做校验吗? 我是一直做 sha256sum,但怀疑只有我这么轴。