ARTICLE · 1240669
AI圈刮起“Flash风”:小模型,大算盘
如果让你猜,过去这一周 AI 圈最热闹的事是什么?不是又冒出一个万亿参数的巨无霸,而是一个听起来很不起眼的词——Flash,也就是“闪电版”模型。曾经,谁的模型参数大、跑分高,谁就能在发布会上赢得掌声。可最近风向悄悄变了:大家不再比谁的块头更大,而是比谁的身材更小、出手更快、账单更薄。这场静悄悄的转向,正把整个行业拽进一个更务实的新赛段。
十月下旬,DeepSeek 把 V4.1 Flash 推到 1017 版本,MiniMax 紧接着开源了 M3.1 Flash。两家动作只隔了两天,像约好了一样。它们瞄准的,不是“谁更聪明”,而是“谁更便宜、更快、更顺手”。这股风,行内叫“小步快跑”。
过去我们习惯了主力模型半年一更、一年一磨。但 Flash 模型反其道而行:参数更少、推理更轻、迭代更快。MiniMax 的 M3.1 Flash 总参数有 4280 亿,可实际每次只激活 230 亿——相当于养了一支大军,但出战的永远是那支精锐小队。
效果却不含糊。开源上线仅仅七十二小时,全球开发者就把服务器“挤爆”了,真实处理的 Token 量超过一百万亿,差不多等于把《三体》全集翻来覆去读了好几百万遍。而它的调用价,输入每百万 Token 只要一块钱、输出四块,比上一代直接砍掉一半还多。
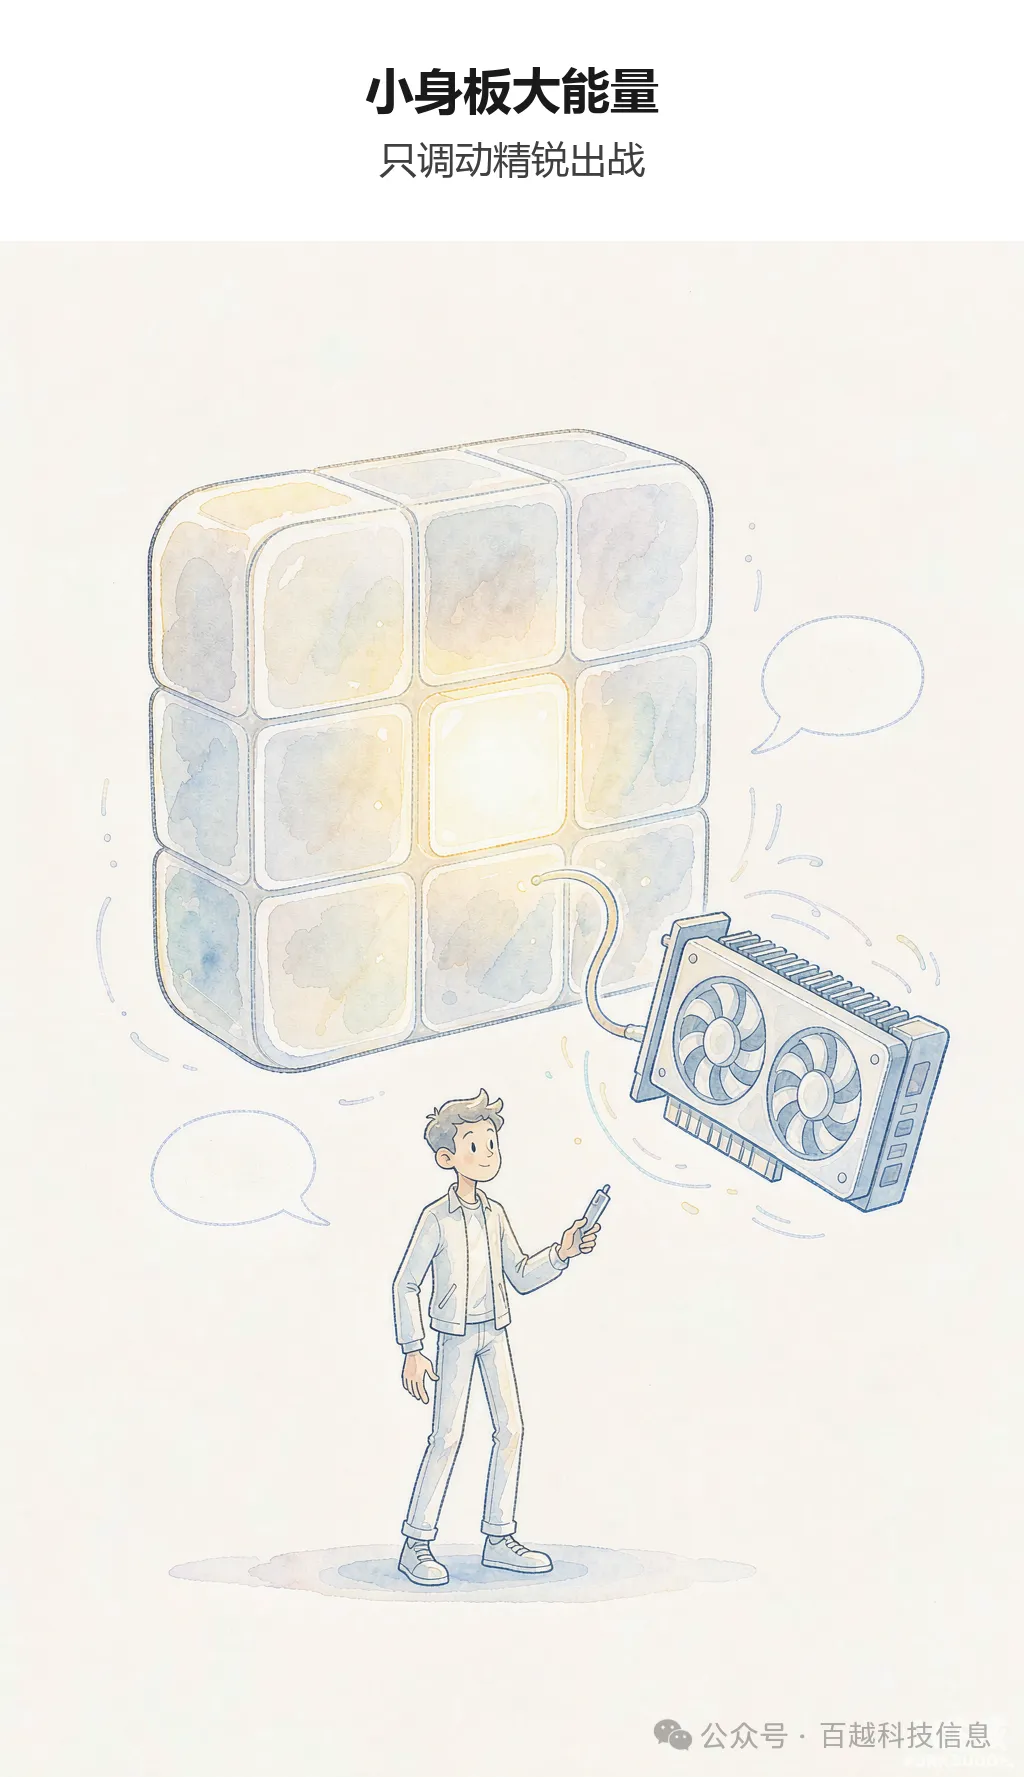
为什么能又便宜又能打?秘诀藏在工程细节里:把不需要全神贯注的注意力层换成稀疏注意力,让模型“该看的地方看,不该看的地方省”;再配合低比特量化和精细的功耗调度,同样一块显卡,能干过去两倍的活。对面 DeepSeek 的 1017 版也没闲着,它用自反馈的强化学习,把从零搭游戏、做三维建模这类“许愿式”编程能力往上提,还顺手把搜索和抓取接口向所有人敞开。
Flash 到底服务谁?说白了,是那些轻量需求。整理一份文案、读一篇长文、写个 PPT,这些事旗舰模型可能要磨十几分钟甚至半小时,Flash 几秒钟就能收工。一位接近厂商的人打了个比方:一个任务没必要从头到尾都请主角,把最烧脑的规划交给旗舰,把执行层的摘要和简单推理交给闪电,效率和成本才都划算。
Flash 突然站上 C 位,背后真正的推手是智能体。一个复杂的 Agent 任务,要在几十个环节里反复推理、调用工具、等待结果。如果每一步都祭出旗舰模型,延迟按秒累加,账单按 Token 疯涨。于是行业摸索出一套新分工:让主力模型负责顶层规划和复核,把摘要、简单推理这类执行层任务,交给又快又省的 Flash 去跑。这不只是省钱,而是算得过来的账。
算力这门账,正在越绷越紧。有报告预测,全球 AI 算力需求的满足率,将从二〇二四年的百分之七十九,一路滑到二〇二七年的百分之七十一——意味着近四分之一的需求,长期等不到供给。芯片、存储、能源的扩张速度,根本追不上模型规模的膨胀。当智能体开始规模化跑起来,每一轮推理都在实打实地啃食算力,缺口只会越来越大。
于是一种新的“两层架构”正在成型:旗舰模型像大脑,负责战略与判断;Flash 像手脚,负责把明确的子任务飞快跑完。算力不宽裕的时代,分工比单打独斗更聪明。这也解释了为什么连推理框架和芯片厂商都抢着首日适配——谁能让小模型跑得又稳又省,谁就卡住了应用爆发的关键位置。当基础模型的智商逐渐趋同,胜负手不再是峰值有多高,而是成本能不能压下来、速度能不能提上去。
很多人误以为 Flash 是“减配版”。其实它戳破了一个旧神话:互联网多一个用户几乎零成本,但大模型不是。每一次推理都在实打实烧算力和电。参数越大,成本越贵,收费注定越走越高。所以并不是所有人都需要一个无所不能的旗舰。绝大多数人的日常——整理文案、读文章、写 PPT、做轻量编程——Flash 完全能接住,占了八成以上的长尾场景。把最难的思考留给旗舰,把重复的执行交给闪电,整个系统的效率反而最高。
更耐人寻味的是生态反应。MiniMax 这次开源,华为昇腾、平头哥、摩尔线程等一众国产芯片,连同多家海外云厂商,首日就完成接入。不管你手里是什么卡、在哪个云上跑,都奔着“开箱即用”去。这场看似低调的闪电战,背后其实是算力与生态的卡位。谁能先把门槛降到地板上,谁就先吃到下一波应用红利。
AI 竞赛的下半场,主角可能不再是参数表上那个最大的数字,而是你手边那个“几秒钟就办好”的小模型。当算力成为真正稀缺的底牌,谁能把活干得又便宜又稳,谁就握住了落地的大门钥匙。下一个悬念是:这一百万亿 Token 里,有多少会变成你手机里那个越来越懂你的 AI 助手?