ARTICLE · 1257737
给AI助手训练一个会打分的模拟用户,Google研究探索更省计算的强化学习
训练多轮对话助手时,用户模拟器负责接话,外部评判模型再判断助手表现、提供奖励。后者增加计算开销,也未必符合用户自己的评价。Google Research参与的研究让模拟器同时生成回复和评分:在Qwen2.5-1.5B-Instruct的指定训练设置中,估算RL计算量下降55.3%,评测成绩均值接近外部评判方案。
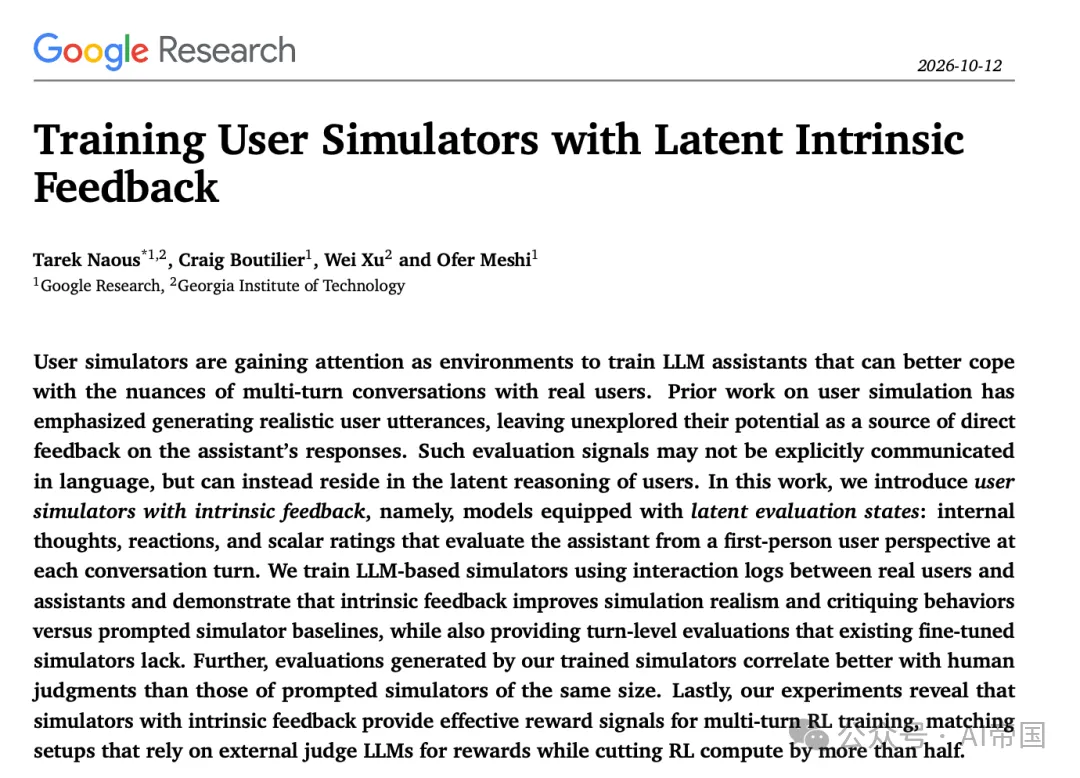
模拟器先根据已有对话生成潜在评价状态(latent evaluation state,LES),再生成下一句用户回复。LES是结构化文本,包含第一人称内部想法、1到5分评分、指令完成程度、批评/表扬/中性反应,以及简短反馈。它让“怎样接话”与“怎样评价助手”共用一个过程;这些想法由模型生成,并非读到了真人心理。
[图1:带潜在评价状态的用户模拟器与LLM助手的对话示例] 示例任务是创建浏览器扩展。模拟器在每次接话前评价助手当前回复;即使评分为5,下一句也可能只是继续提要求,不必包含表扬。
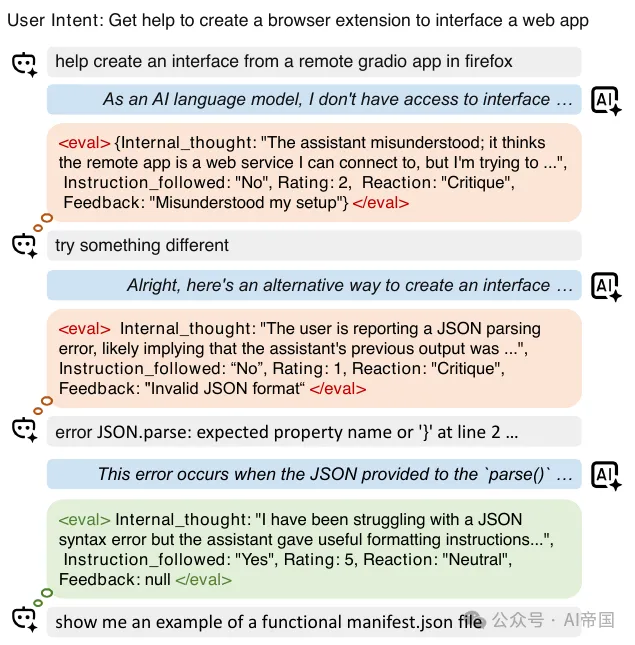
图1
用合成评价训练Gemma3,完整状态兼顾评分与用户回复
训练素材来自WildChat真实交互日志,只保留经过滤的英语对话,并去重、剔除与评测重合的数据。Gemini3.1-Pro根据历史和已经出现的用户回复,反推并合成238,636条LES;另生成对话的高层用户意图,用来控制模拟任务方向。Gemma3的4B、12B和27B基础模型随后接受全参数微调,学习先生成LES、再生成用户话语。运行时只能根据已有历史生成,不能预先看到真人下一句。
完整状态并不保证每项指标都最高。Gemma3-12B消融中,仅训练评分字段时,批评行为F1为76.42,文本统计一致性为0.8005;使用全部字段后,分别为73.00和0.8635。前者检查何时提出批评,后者衡量生成话语与真人文本的统计接近程度。内部想法和反馈帮助组织接话,但评分、批评与语言真实感之间存在取舍;这些指标也不等于真人认可。
[表2:使用LES不同子状态训练Gemma3-12B-LES的影响消融] 左侧符号依次代表评分、内部想法、指令完成程度、反应和反馈。仅评分的反馈指标最高,全部状态的文本统计一致性最高、困惑度最低;该表评分相关性的参照来自模型合成标签。
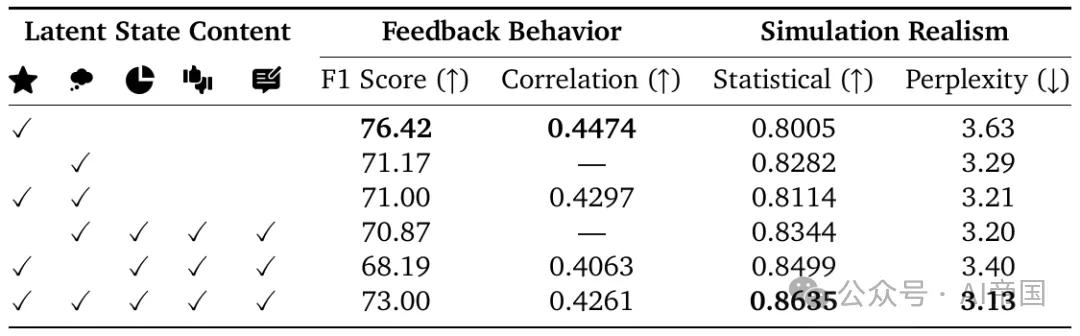
表2
909段真人评分检验中,4B和12B总体相关性提高
独立的SimulatorArena包含459段文档创作和450段数学辅导对话,由真实用户给出整段对话总分。模拟器在每次助手回复后,仅凭当时历史打分,再将各轮分数平均,与真人总分计算Spearman排序相关。4B模型从提示式基线的0.244提高到LES的0.384,12B从0.295到0.401;两组总体差异经配对bootstrap和多重检验校正后显著。
27B总体相关性从0.343到0.383,但差异的95%置信区间包含0;数学子集还从0.421降到0.390。总体相关性提高没有覆盖所有子任务,显著改善也只出现在部分规模。相关性衡量的是对话之间的评分排序,不能据此判断每轮分数是否准确,或模拟用户的全部行为是否像真人。
[表4:用户模拟器评分与SimulatorArena域外对话真人评分的Spearman相关性] Doc、Math和All分别为文档、数学及总体。总体均值在三个规模上提高,数学子集的27B结果下降;总体显著差异只出现在4B和12B。
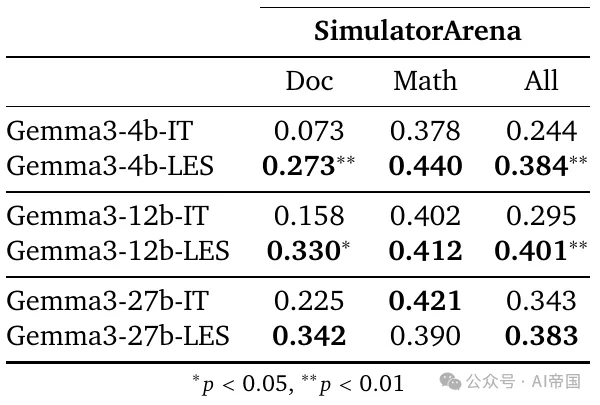
表4
Qwen训练用三轮模拟对话,最终由独立模型检查任务清单
RL实验从清洗后的WildChat-4.8M抽取10万段对话,用Gemini3.1-Pro生成用户意图,并结合首条真实用户输入启动模拟。助手为Qwen2.5-1.5B-Instruct,模拟器为Gemma3-4B;每题生成8条候选轨迹,每条最多三轮,用多轮GRPO优化各轮评分的平均值。奖励来源分别是Qwen2.5-14B-Instruct外部评判,以及模拟器自身评分。
训练后的助手另在WildBenchV2的1,024条任务指令上生成回答,由Gemini3.1-Pro依据每题10到12项要求检查。结果采用“清单满足率”:它是模型评判的要求完成比例,不是真人满意率。表中±来自每个训练后模型的三次评测采样标准差,不能当作三次独立训练的稳定性证据。
[表5:不同用户模拟器与奖励来源下,Qwen2.5-1.5B-Instruct经多轮GRPO训练后的WildBenchV2清单满足率] Judge为外部评判奖励,Intrinsic为模拟器自身奖励;左侧FLOPs为RL训练计算量,右侧为独立评测结果。SFT模拟器只生成用户回复,没有内部评分列。
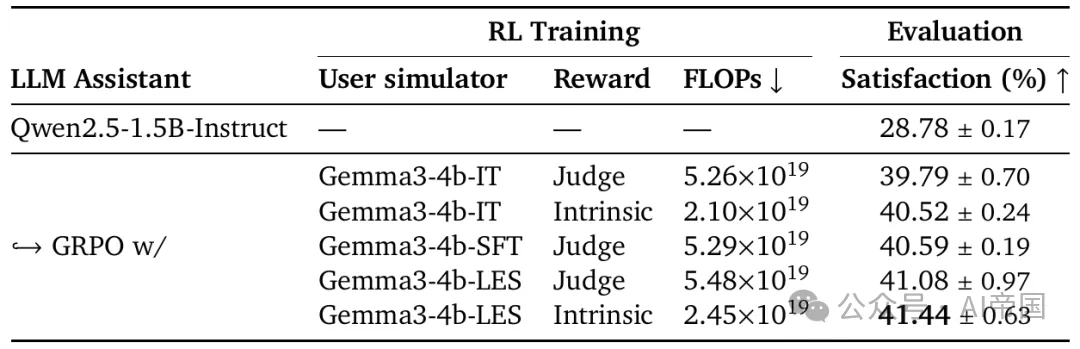
表5
省去14B外部评判后,LES方案估算FLOPs下降55.3%
在Gemma3-4B-LES环境中,外部评判方案为5.48×10^19 FLOPs,内部评分方案为2.45×10^19,按原始数值计算下降约55.3%。清单满足率分别为41.08%±0.97和41.44%±0.63,仅相差0.36个百分点;未训练助手为28.78%±0.17。这支持用内部奖励保留接近的评测表现,不能据小幅均值差异断言训练效果显著更好。
节省计算也不完全来自LES训练:提示式Gemma3-4B-IT自行评分时,FLOPs同样从5.26×10^19降到2.10×10^19,清单满足率为40.52%。主要省掉的是单独的14B评判调用。把外部评判缩到3B也有代价:LES环境下训练所得助手的清单满足率仅34.82%,低于14B评判的41.08%。评判规模与奖励质量需要一起比较。
[表11:使用较小Qwen2.5-3B-Instruct与较大Qwen2.5-14B-Instruct评判模型进行多轮GRPO训练后,LLM助手的WildBenchV2清单满足率] 两种模拟环境中,3B评判训练出的助手均低于14B评判。该表比较奖励来源的模型规模,没有报告这两种规模的计算量差值。
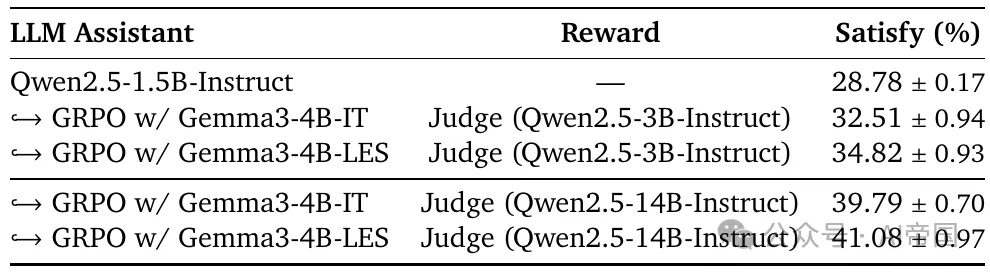
表11
LES可兼任离线训练奖励,真实用户效果和总成本仍需另测
在英语对话模拟和所测Qwen多轮RL设置中,LES将用户回复与评价合并生成,省去额外评判调用,估算RL计算量下降55.3%,清单满足率保持接近。真人评分相关性及状态消融提供了不同侧面的支持:内部奖励有可检验的反馈依据,但评分接近真人、语言像真人和训练后任务表现是三个不同问题。
这套方案适合先做离线对话训练对照,不能直接替代真实用户验收。实验只覆盖小助手的三轮轨迹,未验证长对话、中文场景或线上满意度。FLOPs是RL阶段估算值,不是实测耗时或账单;尚需另核算状态与意图合成、模拟器微调、独立评测的累计费用。若任务要求专业事实核验,也不能仅靠被限制为普通用户可观察内容的LES评分。
📄 原文标题
Training User Simulators with Latent Intrinsic Feedback
🔗 原文链接
https://arxiv.org/abs/2610.13617