ARTICLE · 1258220
PCIe设备---智能网卡系列之卸载方式
1.1 CPU的时间都花在哪了
假设你有一台100G带宽的服务器。100G是什么概念?一秒钟能传1.5亿个数据包。如果每个包都要CPU亲自来处理,会发生什么?
CPU要干这些活:
• 收到一个包 → 中断通知CPU → CPU放下手里的活来处理
• 内核协议栈拆包 → 去掉以太网头、IP头、TCP头
• 算校验和 → 检查数据有没有出错
• 内存拷贝 → 把数据从内核缓冲区搬到应用手里
• 如果是虚拟机,还要在虚拟交换机(OVS)里查流表、决定往哪转发
结果就是:CPU一大半时间都在给网卡打工,真正跑业务的时间少得可怜。就好比你请了个高级厨师,结果他大半时间在洗菜切菜,炒菜的时间反而少了。
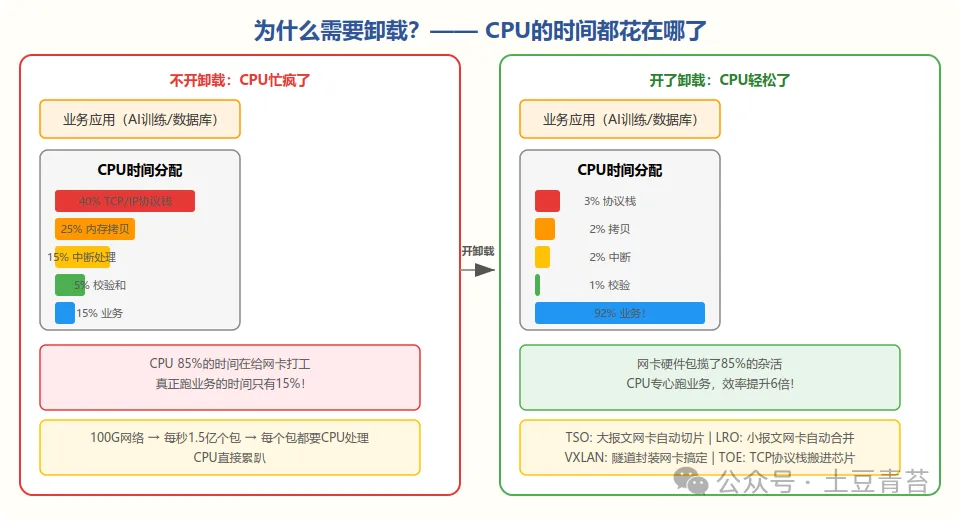
图1:不开卸载 vs 开卸载 —— CPU时间分配的对比
1.2 卸载的本质
卸载(Offload)的思路很简单:把CPU不擅长的事交给擅长的人干。
• CPU擅长什么?跑复杂的业务逻辑,做判断,算AI模型
• CPU不擅长什么?搬运数据包、算校验和、给报文套外壳
• 网卡芯片擅长什么?就是上面CPU不擅长的那些活
所以卸载就是:让网卡芯片把数据包相关的杂活全包了,CPU专心跑业务。从基础网卡到智能网卡到DPU,卸载的程度越来越深,CPU越来越轻松。
二、网络层卸载:TSO和LRO
网络层卸载是最基础的卸载功能,几乎所有现代网卡都支持。其中最有用的是TSO和LRO,一个管发送,一个管接收。
2.1 TSO(发送方向的大包切片)
TSO全称TCP Segmentation Offload,TCP分段卸载。要理解TSO,先得知道一个问题:以太网有个最大传输单元(MTU),一般是1500字节。也就是说,一个以太网帧最多只能装1500字节的数据。
但应用层的数据往往比1500字节大得多。比如一个64KB的文件块要发出去,就需要切成45个1.4KB左右的小包,每个小包还要加上TCP头、IP头、以太网头。
不开TSO:
CPU要亲自把64KB切成45个小包,每个包套上TCP/IP头,算好校验和,然后一个一个发给网卡。CPU要干45次切片、45次加报文头、45次算校验。
开了TSO:
CPU直接把64KB的大块数据丢给网卡,说:'帮我切一下发出去'。网卡芯片自动把数据切成45个小包,每片自动套上TCP/IP头,算好校验和,发出去。CPU只给了1个'工单',剩下的网卡全包。
2.2 LRO/GRO(接收方向的小包合并)
LRO(Large Receive Offload)和TSO反过来:收到一堆小包后,网卡自动把它们合并成一个大包,再交给协议栈。
比如对面发了45个1.4KB的小包过来。不开LRO的话,协议栈要处理45次中断,拆45次报文头。开了LRO后,网卡先把45个小包拼成一个64KB的大包,只产生1次中断,协议栈只处理1次。
GRO(Generic Receive Offload)是LRO的软件版本,在内核里做合并。LRO是硬件做的,更快。
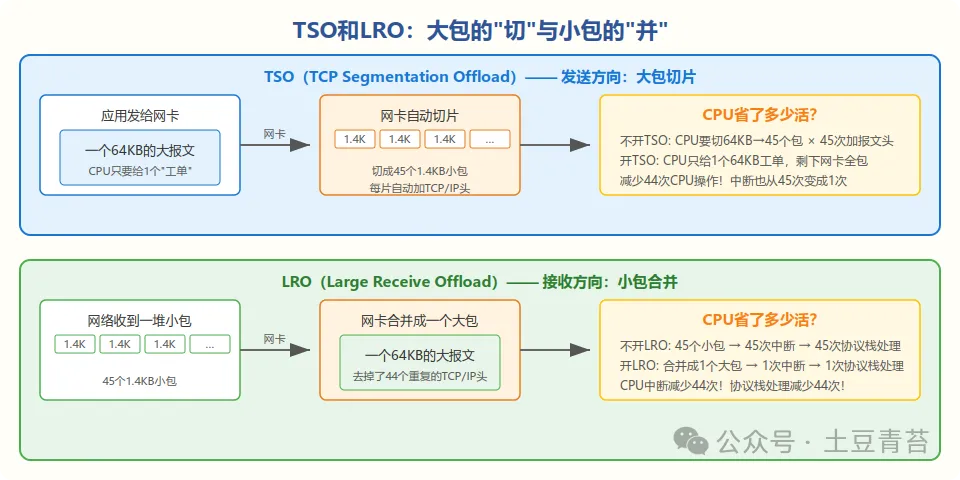
图2:TSO(发送切片)和LRO(接收合并)
2.3 其他基础卸载
卸载功能 | 干什么的 | 省了CPU什么活 |
CSO | 校验和卸载 | IP/TCP/UDP校验和由网卡硬件算,CPU不用算 |
VLAN | VLAN标签处理 | 发送时自动加VLAN头,接收时自动去掉VLAN头 |
RSS | 多队列分发 | 收到包后Hash分配到不同队列,多核并行处理 |
FDIR | 流定向 | 按规则把特定流量定向到指定队列 |
Checksum | 校验和验证 | 接收时网卡自动校验,错了直接丢弃 |
3.1 VXLAN是什么
在云数据中心里,虚拟机之间要通信,但物理网络是共享的。为了区分不同租户的流量,就需要一种'隧道'技术——在虚拟机的原始数据包外面再套一层'外壳',就像俄罗斯套娃一样。
VXLAN就是最常用的隧道协议。它要在原始报文外面加上:外层MAC头(6字节)+ 外层IP头(20字节)+ UDP头(8字节)+ VXLAN头(8字节)= 总共多了50字节的外壳。
不做卸载:CPU要手动给每个包套外壳、拆外壳。100G网络下每秒上亿个包,CPU光套外壳就忙不过来了。
3.2 发送方向的封装
虚拟机发出一个数据包,网卡芯片收到后,根据预配置的流表规则,自动在包外面套上外层MAC头、外层IP头、UDP头和VXLAN头。套好后直接发出去。整个过程CPU不参与,虚拟机也不知道自己的包被套了壳。
3.3 接收方向的解封装
网卡收到一个带VXLAN外壳的包后,芯片自动识别:'哦,这是个VXLAN包'。然后去掉外层MAC头、IP头、UDP头、VXLAN头,还原出原始包,通过DMA直接放到目标虚拟机的内存里。虚拟机收到的就是一个干净的原始包,完全不知道外面曾经套过壳。
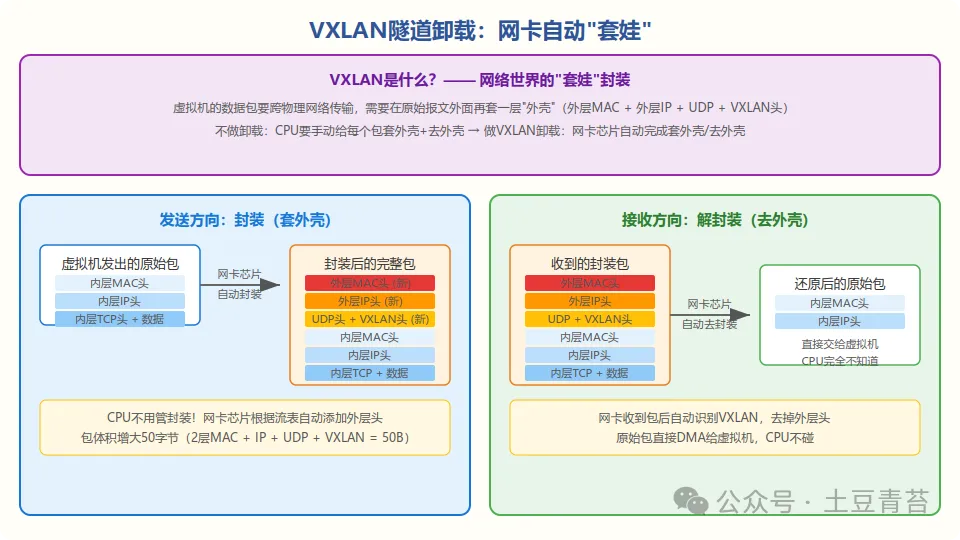
图3:VXLAN隧道卸载 —— 发送时套外壳,接收时去外壳
除了VXLAN,还有GRE、NVGRE、Geneve等隧道协议,原理类似,都是自动套壳/去壳。
四、协议层卸载:TOE和存储协议
4.1 TOE(TCP卸载引擎)
TOE全称TCP Offload Engine,TCP卸载引擎。这是比TSO/LRO更深一层的卸载——不只是切片合并,而是把整个TCP协议栈搬进网卡芯片。
TCP协议栈要干的事可不少:
• 三次握手建立连接、四次挥手断开连接
• 序列号管理、确认应答(ACK)
• 超时重传:包丢了要重发
• 拥塞控制:网络堵了要降速
• 流量控制:对方处理不过来要减速
不开TOE:
每条TCP连接的状态都由操作系统内核维护,CPU要处理每个连接的握手、重传、确认等。
开了TOE:
TCP连接的状态由网卡芯片维护。芯片内部有专门的硬件来处理TCP连接的建立、维护、断开的整个生命周期。CPU只需要在建立连接时告诉网卡:'这条连接卸载给你了',之后所有的TCP处理都由网卡芯片搞定。驱动通过QPC(Queue Pair Context)把连接上下文下发给芯片,芯片后续自主管理这条连接。
4.2 NVMe-oF和iSCSI
除了网络协议,存储协议也可以卸载。
协议 | 是什么 | 卸载了什么 |
NVMe-oF | NVMe over Fabrics 远程NVMe存储访问 | NVMe命令的封装/解封装, RDMA传输由网卡硬件完成 |
iSCSI | SCSI over TCP 通过TCP传SCSI命令 | SCSI命令的TCP封装/解封装, 由网卡硬件完成CRC和数据处理 |
五、交换层卸载:OVS和SR-IOV
5.1 OVS虚拟交换机硬件卸载
OVS(Open vSwitch)是云环境中最常用的虚拟交换机。每个虚拟机的网络流量都要经过OVS转发。
软件OVS的问题:
OVS跑在CPU上,每个包都要查流表、匹配规则、决定转发路径、修改报文头。VM越多,OVS越忙,CPU负担越重。而且数据包要在内核和OVS之间来回拷贝,延迟很高。
硬件OVS卸载:
网卡芯片里有专门的TCAM(三态内容可寻址存储器)来做流表匹配。驱动把OVS的流表规则下发到网卡的TCAM里。包到了网卡后,硬件直接查TCAM匹配规则,匹配上了就直接转发,不需要CPU参与。只有第一次见到的新流才上报给CPU处理(称为'miss'),之后网卡就记住规则了。
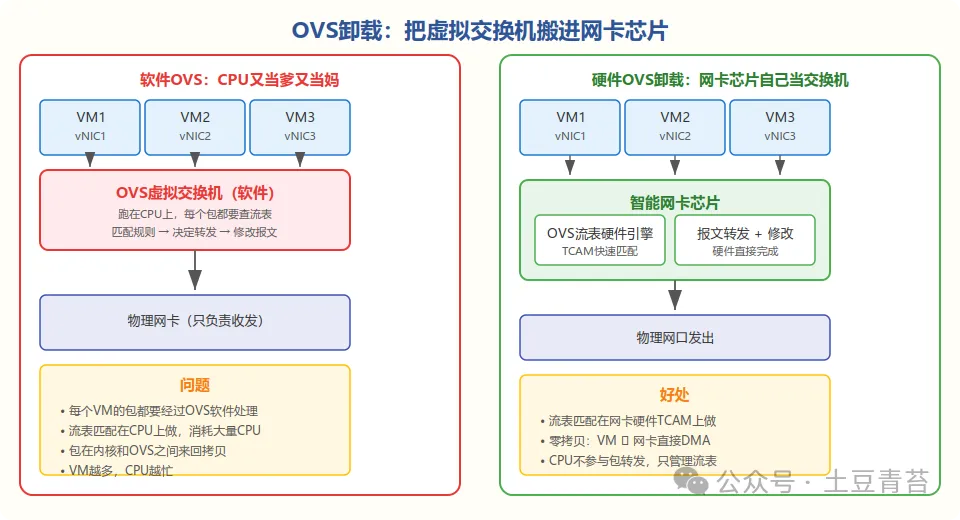
图4:OVS卸载 —— 从CPU软件转发到网卡硬件转发
5.2 SR-IOV硬件虚拟化
SR-IOV(Single Root I/O Virtualization)是另一种虚拟化方案。它让一块物理网卡虚拟出多个'虚拟功能'(VF),每个VF可以直接分配给一个虚拟机。
有了SR-IOV,虚拟机可以直接访问物理网卡硬件,绕过OVS,网络性能接近物理机。但缺点是VF数量有限(一般几十到几百个),而且VF之间的隔离和策略管理不如OVS灵活。
实践中,OVS卸载和SR-IOV经常配合使用:OVS管理控制面,VF处理数据面。
六、安全层卸载:IPSec和TLS
网络安全越来越重要,加密/解密是很耗CPU的操作。网卡芯片可以内置加解密引擎来分担这个负担。
6.1 IPSec卸载
IPSec是网络层的安全协议,给数据包加密。加密算法(如AES-GCM)计算量很大,100G线速加密要消耗大量CPU。网卡里的安全引擎用硬件AES加速,CPU不用管加密解密的事。
6.2 TLS卸载
TLS是传输层的安全协议(就是HTTPS那个'S')。TLS握手和加解密同样耗CPU。智能网卡可以把TLS处理也卸载到芯片里,特别是TLS 1.3的硬件加速。
七、卸载模式全家桶
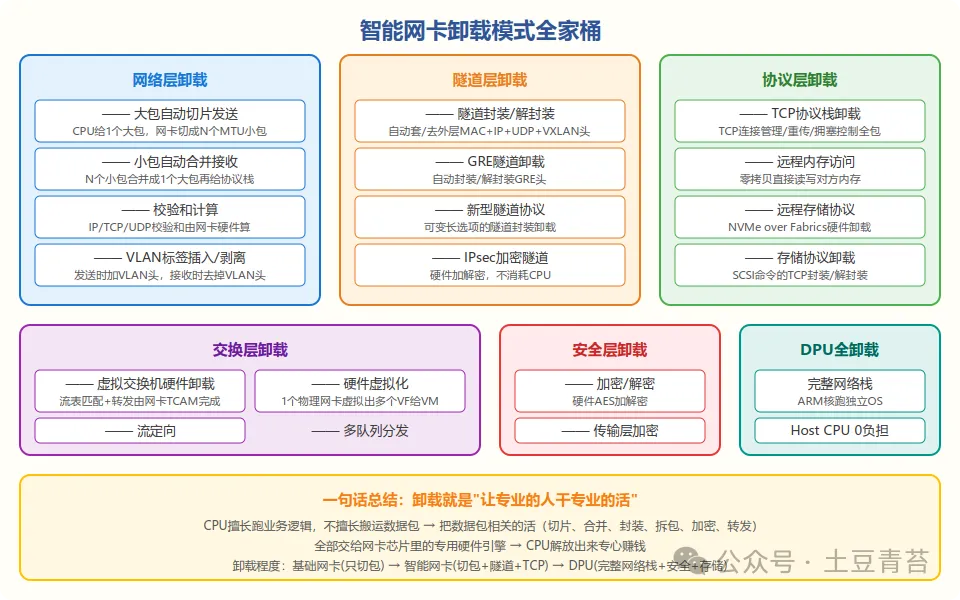
图5:智能网卡卸载模式全景图
总结一下,智能网卡的卸载模式可以按层级分为这么几类:
层级 | 卸载功能 | 一句话解释 |
网络层 | TSO/LRO/CSO/VLAN | 切片、合并、算校验、处理VLAN标签 |
隧道层 | VXLAN/GRE/Geneve | 自动套外壳/去外壳 |
协议层 | TOE/RDMA/NVMe-oF/iSCSI | TCP连接管理、远程内存访问、远程存储 |
交换层 | OVS卸载/SR-IOV/FDIR/RSS | 虚拟交换机、硬件虚拟化、流定向 |
安全层 | IPSec/TLS | 硬件加解密 |
DPU全卸载 | 完整网络栈+安全+存储 | ARM核跑独立OS,CPU 0负担 |
• 普通网卡:只支持TSO/LRO/CSO/VLAN这些基础功能
• 智能网卡:加上VXLAN、TOE、OVS卸载、安全卸载
• DPU:完整的网络栈+安全+存储都卸载到卡上的ARM核和硬件引擎,Host CPU完全不管
一句话总结:卸载就是让专业的人干专业的活。CPU跑业务,网卡搬数据包。
八、卸载与RDMA的关系
8.1 殊途同归:两条不同的路
前面讲了卸载,第二篇讲了RDMA。很多人会问:这两者是什么关系?是 competing(竞争)还是 complementary(互补)?答案是:殊途同归,相辅相成。
两者的共同目标都是让CPU轻松,但走的路不一样:
卸载的路:仍然走TCP/IP协议栈,但把协议栈里的重活(切片、合并、封装、加密等)交给网卡硬件干。CPU还是参与流程,只是干的活少了。
RDMA的路:干脆不走TCP/IP协议栈了,直接内存到内存。CPU完全不参与数据传输,网卡硬件全包。
8.2 关键区别
卸载(Offload) | RDMA | |
协议栈 | 走TCP/IP协议栈 | 绕过TCP/IP协议栈 |
CPU参与 | 参与但少干活 | 完全不参与数据传输 |
延迟 | 毫秒级 | 微秒级 |
兼容性 | 好,普通应用无缝使用 | 需要应用改代码用Verbs API |
适用场景 | 通用网络流量(Web/数据库/虚拟化) | AI训练/GPU互联/高性能计算 |
典型代表 | TSO/LRO/VXLAN/TOE/OVS | RoCE v2 / InfiniBand |
8.3 如何配合工作
在实际的数据中心里,卸载和RDMA不是二选一,而是配合使用的:
• 普通业务流量走卸载通道:Web服务、数据库同步、虚拟化网络等通用流量,用TSO/LRO/VXLAN/TOE等卸载功能,减少CPU负担,同时保持TCP/IP的兼容性。
• AI训练/GPU互联走RDMA通道:多GPU分布式训练中,各节点之间要频繁交换梯度参数,数据量大、延迟要求极高。这种场景用RDMA(RoCE v2),零拷贝+内核旁路,延迟降到微秒级。
• 同一张网卡同时支持两种模式:比如NVIDIA ConnectX-6/7系列,既能跑RoCE RDMA,也支持TSO/LRO/VXLAN/TOE等各种卸载。不同流量走不同通道,互不干扰。
• DPU级别的融合:到了DPU这一代,网卡芯片里既有RoCE引擎(处理RDMA),也有VSW/OVS引擎(处理虚拟交换),还有TOE引擎(处理TCP),还有加解密引擎。所有路径都在一颗芯片里完成,Host CPU彻底解放。
8.4 一个形象的比喻
把数据中心网络比作一个物流系统:
• 卸载 = 给快递公司的货车装上自动分拣机。包裹还是走快递流程,但分拣、打包这些杂活机器干了,人只需要最后签收。
• RDMA = 建了一条"直通车"专线。重要货物不走快递流程,直接从A仓库运到B仓库,中间不经过任何分拣中心。
• 两者配合 = 普通包裹走快递(卸载),重要急件走直通车(RDMA),同一个物流中心两种通道都有。
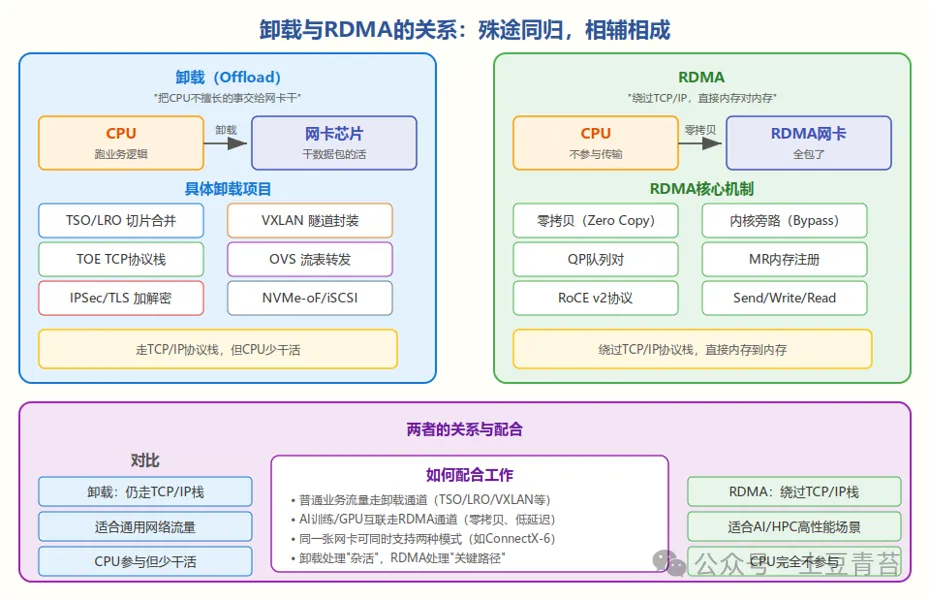
图6:卸载与RDMA的对比与配合