ARTICLE · 1266329
CrewAI 为何基于 LanceDB 重构 Agent Memory:支撑 20 亿+ 次 Agent 执行
本文翻译自 LanceDB
作者:CrewAI
TL;DR
CrewAI 推出了全新的“认知记忆”系统:通过选择性编码写入记忆、解决信息矛盾,并基于置信度控制记忆召回。
CrewAI 的记忆系统构建于 LanceDB 之上,将 Agent 记忆整合为精简的单表架构,并针对多模态数据进行了设计。
通过整合此前由两个系统组成的记忆技术栈,CrewAI 减少了系统依赖,提升了磁盘上的查询性能,同时为开发者提供了更加流畅的使用体验。
如今,LanceDB 已成为每个 CrewAI 开源安装包的默认向量后端。
CrewAI 运行于大规模开源生态之上,目前每月软件包下载量达到 1,200 万次,Agent 执行次数超过 20 亿次,使 LanceDB 成为业界应用最广泛的 Agent 框架之一背后的记忆层。
“整个系统的安装和配置过程,我完全没有遇到任何问题。”
—— Joao Moura,CrewAI CEO
CrewAI 是谁
CrewAI 是企业级 Agent 的构建、管理与运行平台。在同一个环境中,任何开发者都可以将 Agent 从创意一路推进到可信赖的生产环境,并以真正可导出、可掌控的代码形式拥有最终成果;开发者可以使用任意模型以及自有基础设施,不存在黑盒,也不存在厂商锁定。这也是为什么《财富》500 强企业中有 63% 在使用 CrewAI 构建 Agent,其中包括 PepsiCo、RBC、AB InBev 以及美国国防部,同时还有一个全球性的开源社区。开发者无需从零开始,每一次构建都可以复用来自超过 20 亿次执行所验证的 70 万多种成熟模式,而每月软件包下载量达到 1,200 万次。因此,团队能够真正交付推动业务发展的 Agent,而不是又一个最终停留在试点阶段的项目。
此前:两个系统,一个问题
CrewAI 的记忆技术栈过去由两个部分组成:一个用于存储 Embedding 的向量数据库,以及另一个用于保存结构化记忆状态的独立数据库。长期记忆、短期记忆、实体记忆以及基于 Embedding 的工具,都通过这套组合进行处理。最初系统可以正常运行,但随着成本开始不断累积,问题逐渐显现。
这种双系统架构带来了一系列传递依赖以及持续的运维摩擦,包括兼容性问题、密钥管理和版本追踪等,这些问题最终无法被团队长期忽视。用户同样会感受到安装和性能方面的摩擦,这些问题也陆续出现在 Discord、Reddit 和 GitHub 的讨论中。
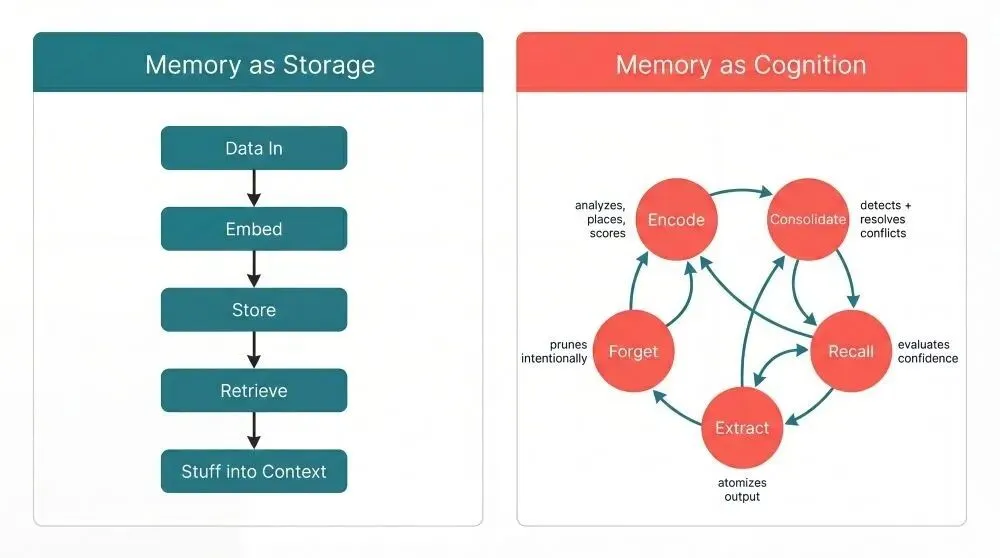
更深层的问题在于架构本身。过去,记忆被视为一个存储问题,其任务非常简单:保存 Embedding,通过相似度进行检索,然后结束。Agent 在运行过程中可能不断积累相互矛盾的事实,却没有任何机制对这些信息进行冲突消解。团队这样描述这一故障模式:“你的 Agent 周一学到了一件事,周五又学到了另一件相互冲突的事情。现在,它把两件事都记住了。”
从 LanceDB 的角度来看,这正是传统“向量存储 + 元数据数据库”模式开始失效的地方。Agent 记忆并不只是最近邻搜索,它还依赖于作用域、时效性、重要性、信息冲突以及更新机制。如果将 Embedding 与结构化状态拆分到不同系统中,那么每一次记忆召回和记忆整合都会变成一个数据同步问题;而实际上,这些操作本应通过一次同时处理向量和元数据的查询完成。
转折:从存储走向认知
CrewAI 决定从零开始重构记忆系统,从一个完全不同的前提出发:记忆并不是一个存储问题,而是一个认知问题。应该记住什么、如何解决信息冲突,以及何时遗忘,这些决策都应该属于记忆系统本身,而不是交由应用层来处理。
“我们重新构建了记忆系统,让它不再只是关注存储,而是真正成为一个独立的 Agentic 系统。”
—— Joao Moura,CrewAI CEO
来源:CrewAI,《How We Built Cognitive Memory for Agentic Systems》
基于这一思路,下一步需要找到一个能够支持主动式编码和召回流程,同时又不会重新引入运维开销的单一后端。团队通过 Claude Opus 对现有向量数据库进行了调研,以梳理不同方案之间的权衡。最终,LanceDB 凭借以下几个最先显现出的优势胜出:
“它给人的感觉更加具备可扩展性,而它基于磁盘存储这一点也是一个很大的优势。对于一个需要在本地运行的开源框架来说,它就是一种正确的选择。”
—— Joao Moura,CrewAI CEO
整个实现过程非常简单:安装一个库、指定一个本地目录路径,无需部署任何新的基础设施。
解决方案:
一张表、两条流程、零同步
新系统就是 CrewAI 所称的认知记忆。它以 CrewAI Flow 的形式构建,并运行在与其所服务的 Agent 相同的 Agentic 架构之上。
LanceDB 是面向 AI 的多模态湖仓,通过一张表统一存储向量、结构化元数据以及多模态数据,无需运行服务器,也不存在不同系统之间的同步层。在 CrewAI OSS 中,它是所有记忆和 Embedding 功能的默认后端;当用户启用记忆功能后,LanceDB 会自动安装并存储在 ./.crewai/memory 目录下。CrewAI 因此不再需要分别使用两个系统来处理结构化数据和 Embedding,也无需维护两者之间的数据同步层。
整个系统包含五种认知操作:编码、整合、召回、提取和遗忘。
编码与整合
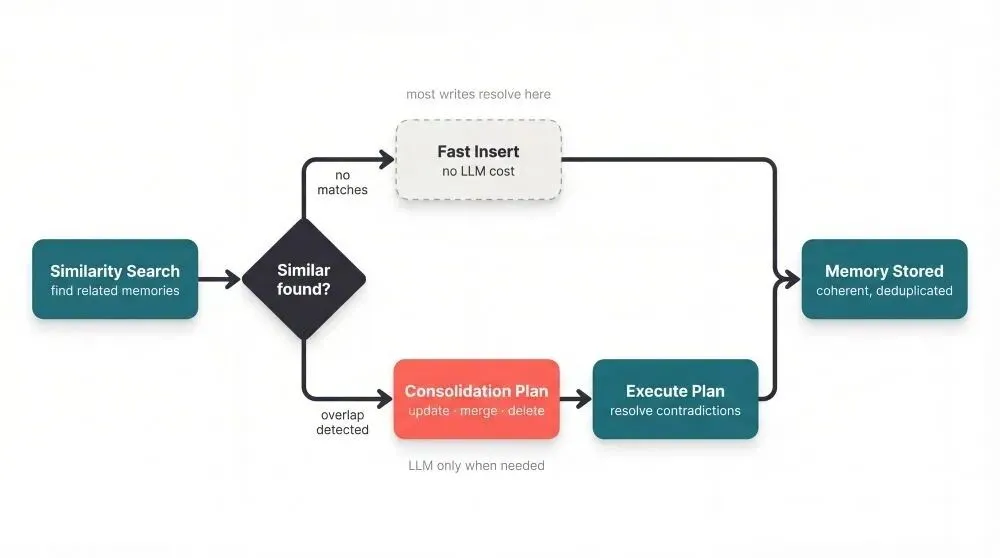
每一次写入都会首先经过编码流程。系统会对内容进行分析,为其分配作用域和类别,并在数据真正写入之前,以 0–1 的尺度评估其重要性。
当一条新记忆与已存储记忆发生冲突,且冲突对应的置信阈值超过0.85时,系统便会触发整合机制:更新旧记录、保留其上下文,同时移除已经过时的事实。
例如,当系统已经存储了“我们使用 PostgreSQL”,随后又接收到“我们上周迁移到了 MySQL”,系统会检测到两条信息之间存在冲突,并对其进行解析和更新记录。究竟哪条事实是当前有效的、哪条已经过时——这种判断恰恰是当记忆被拆分到多个系统中时,通常会被推给应用层处理,甚至完全没有得到处理的部分。
来源:CrewAI,《How We Built Cognitive Memory for Agentic Systems》
召回
“它并不只是检索,更重要的是发现。”
—— Joao Moura,CrewAI CEO
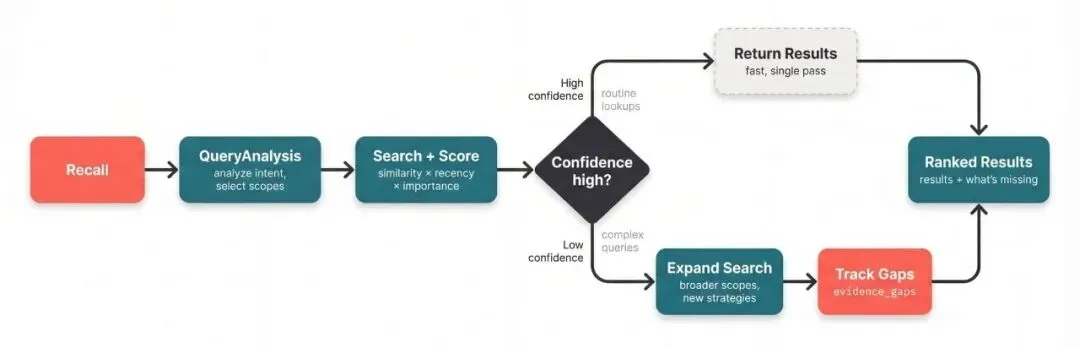
召回流程用动态、迭代式检索取代了静态的相似度查询。系统会使用一个综合评分机制对每一组检索结果进行评估:
score = (similarity × w_sim) + (recency × w_rec) + (importance × w_imp)六个月前做出的关键架构决策,其优先级高于昨天的一次无关紧要的提及。当系统的置信度不足时,它会在返回结果之前继续进行更深层次的搜索,通过补充证据缺口,而不是简单地返回距离最近的结果。
来源:CrewAI,《How We Built Cognitive Memory for Agentic Systems》
提取与遗忘
提取会在编码之前,将 Agent 产生的大段输出拆解为彼此独立的原子事实。例如,一份 500 字的基础设施评审报告,可以被拆分为四条离散且具有独立作用域的记忆,每条记忆都拥有各自的重要性权重。
系统支持根据作用域和时间显式删除记忆。一个同时处理多个项目的 Agent,可以将某个已经弃用项目的记忆进行清退,而不会影响其他项目中的任何记忆。
memory = Memory(storage=”./.crewai/memory”)# encode → consolidate → writememory.remember(”PostgreSQL is our primary database”)# composite scoring, confidence-gatedmemory.recall(”what database are we using?”)# atomic decomposition before encodememory.extract_memories(long_report)# purposeful, scoped deletionmemory.forget(scope=”/project/old”, older_than=cutoff)
一张表,通过元数据实现作用域隔离
与其按照记忆类型将数据拆分到不同的表中(例如,一张表存储长期记忆,一张表存储短期记忆,另一张表存储实体记忆),不如将所有数据统一存储在一张 LanceDB 表中。系统通过类似 SQL 的 WHERE 子句过滤实现作用域划分。针对作用域键建立 B-tree 索引后,过滤查询可以完全跳过全表扫描(full table scan)。原本需要跨系统协调的问题,如今只需要一个 WHERE 子句即可解决。
强类型 Schema 对于 Agent 如何处理召回的记忆同样至关重要。scope、importance 和 timestamp 等字段都作为具有明确类型的列进行存储。这样,Agent 获取的是可以直接用于后续操作的结构化数据,而不是需要自行解析的非结构化数据块。
写入操作采用非阻塞机制:remember_many() 会将写入任务提交至后台线程,随后立即返回。读取操作则会先清空(drain)所有待处理的写入任务,因此查询始终能够看到最新状态。当多个记忆实例指向同一个数据库时——包括 Agent Memory 和 Crew Memory 并发运行的场景——系统会通过序列化操作以及自动冲突重试机制保证一致性;应用层无需自行管理锁。
如果希望深入了解具体实现,包括五种认知操作是如何组合协同工作的,可以参阅 CrewAI 的技术文章:《How We Built Cognitive Memory for Agentic Systems》。
后来:更简单的技术栈,
更快的记忆召回
技术栈简化
两个系统最终合并为一个。如今,对于在 CrewAI OSS 中启用记忆功能的开发者而言,LanceDB 已成为唯一的存储依赖。在超过 20 亿次 Agent 执行和每月 1,200 万次下载的规模下,每一位启用记忆功能的开发者都会自动获得这一能力,同时享受约 200ms 延迟的快速记忆检索,而且无需调用LLM。在经历多年依赖管理所带来的额外开销之后,这种架构简化成为最先显现的实际收益。
它带来了什么
CrewAI 目前正在进一步构建组织级记忆:将组织内 Agent 在每一次运行过程中学习到的信息汇聚成一张知识图谱,并支持按照作用域和 Agent 进行查询。他们还推出了终端 UI(crewai memory --storage-path ./my_memory),用于浏览和审计已经存储的记忆。
这一能力的价值在作用域化记忆检查中得到了直接体现。过去,CrewAI 需要在所有 Agent 和项目的全部已存储记忆中进行扫描;现在,则可以借助 LanceDB 的元数据过滤器,针对特定作用域进行查询,例如某个项目、任务或 Agent 上下文。原本在旧技术栈中需要执行跨系统数据对账的步骤,如今变成了在一张表中,对向量和强类型元数据执行一次过滤查询。
“有了 LanceDB,记忆不再是一个有些模糊、难以落地的概念,而是真正变成了能够工作的东西。”
—— Joao Moura,CrewAI CEO
 点击阅读原文,跳转LanceDB GitHub