ARTICLE · 1269674
WPS多维表-链接转附件,可用来下图片,wps文档
WPS多维表-链接转附件,可用来下图片,wps文档不多做介绍了,请看下面动图看效果。 支持多平台图片链接转附件 
字符设置
自动化设置 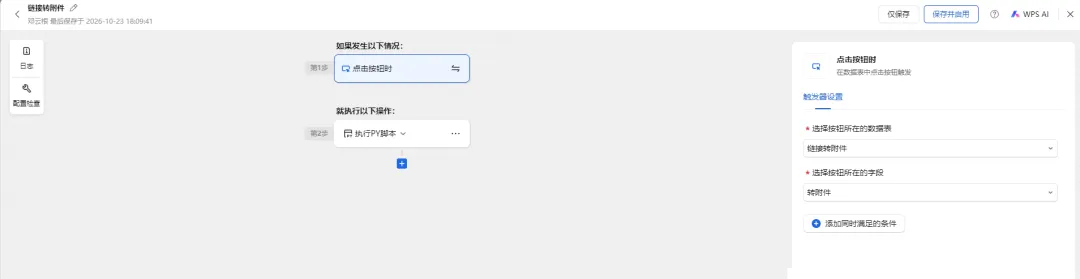
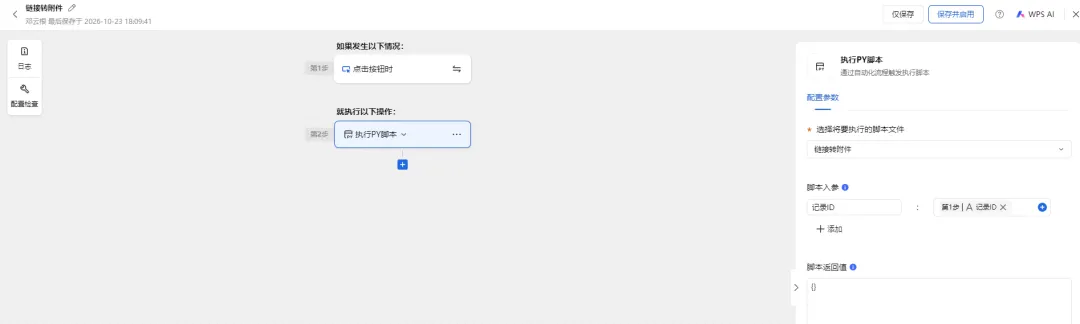
py脚本: airscript脚本
“在我主页或给我发「列表」二字,可用该功能
链接 | ||
#!/usr/bin/env python3# -*- coding: utf-8 -*-import base64 # Base64 编码(图片转 dataUrl)import io # 字节流缓冲区(图片转 dataUrl 前的临时存储)import json # JSON 序列化(webhook 调用与日志)import re # 文件名安全清理import requests # HTTP 请求(下载图片 + 调用 AirScript webhook)import pandas as pd # 金山内置:dbt() 返回的 DataFrame 判空用# ===================== 【配置区:webhook 脚本信息】=====================# 与「生成码」同一文档(「图片压缩」多维表),webhook 令牌通用;# 只需把新创建的「链接转附件写」脚本 ID 填进下方占位。文件ID = "******" # ★ 本文档 ID(脚本 webhook 链接中提取,同 generate_code.py)脚本令牌 = "****" # ★ AirScript 脚本令牌(盾牌图标生成)链接转附件写脚本ID = "V2-*****" # ★「链接转附件写」脚本 ID(webhook 中提取)# =============================================================# ===================== 【参数配置区:表与字段】=====================数据表名 = "链接转附件" # 多维表数据表名(与表名完全一致)链接字段 = "链接" # 链接 URL 字段名(MultiLineText)附件字段 = "附件" # 附件结果字段名(Attachment)入参_记录ID = "记录ID" # 自动化流程中「记录ID」入参的键名# =============================================================# 下载时的浏览器指纹(防盗链站点通常检查 UA/Referer)下载请求头 = {"User-Agent": ("Mozilla/5.0 (Windows NT 10.0; Win64; x64) AppleWebKit/537.36 ""(KHTML, like Gecko) Chrome/126.0.0.0 Safari/537.36"),"Accept": "image/avif,image/webp,image/apng,image/*,*/*;q=0.8","Accept-Language": "zh-CN,zh;q=0.9",}# ===================== 【平台防盗链规则表】=====================# 主机名后缀 → 推荐 Referer(None = 该平台无需 Referer,直连即可)# 匹配规则:按 URL 域名后缀从前往后匹配,第一个命中即用平台防盗链规则 = [("mmbiz.qpic.cn", "https://mp.weixin.qq.com/"), # 微信公众号文章图片("qpic.cn", "https://mp.weixin.qq.com/"), # 微信系其他图片(头像/表情等)("sinaimg.cn", "https://weibo.com/"), # 微博图片("baidu.com", "https://image.baidu.com/"), # 百度图片搜索页("zhimg.com", "https://www.zhihu.com/"), # 知乎图片("hdslb.com", "https://www.bilibili.com/"), # B 站图片("xhscdn.com", "https://www.xiaohongshu.com/"), # 小红书(多数仍要求登录态,仅尽力而为)("doubanio.com", "https://www.douban.com/"), # 豆瓣("jianshu.io", "https://www.jianshu.com/"), # 简书("byteimg.com", None), # 字节系(签名+过期链接,无需 Referer 直连)("aliyuncs.com", None), # 阿里云 OSS(通常直连)("myqcloud.com", None), # 腾讯云 COS(通常直连)("qcloudimg.com", None), # 腾讯云图片 CDN(通常直连)]# =============================================================# ===================== 【入参兼容处理】=====================# 编辑器内直接引用 Context 会报"未定义",但自动化运行时可用;此处兜底避免手动运行直接崩溃try:Contextexcept NameError:Context = {"argv": {}}def 取入参(主键名):"""从 Context['argv'] 取入参值:兼容数组形式(取第一个非空元素)。"""if 主键名 not in Context["argv"]:return None值 = Context["argv"][主键名]# 金山传参可能是数组(多值),取第一个非空元素if isinstance(值, list):return 值[0] if 值 else Nonereturn 值def 读字段(数据表, 记录ID, 字段名):"""安全读取记录字段:字段在表中才读取,字段不存在返回 None 不报错。"""if 字段名 not in 数据表.columns:return Nonereturn 数据表.loc[记录ID, 字段名]def 调用脚本(脚本ID, 入参, 脚本名="airscript"):"""通过 APIToken 同步调用 AirScript 脚本(POST sync_task,与 generate_code.py 同款)入参:脚本ID 脚本 ID(webhook 路径中的 V2-xxxx)入参 argv 字典(脚本的 Context.argv)脚本名 用于报错提示的名称返回:脚本返回的 result(dict;若为字符串则尝试 JSON 解析)"""接口地址 = "https://www.kdocs.cn/api/v3/ide/file/{}/script/{}/sync_task".format(文件ID, 脚本ID)请求头 = {"Content-Type": "application/json", "AirScript-Token": 脚本令牌}请求体 = {"Context": {"argv": 入参}}响应 = requests.post(接口地址, json=请求体, headers=请求头, timeout=300)响应.raise_for_status()返回体 = 响应.json()# 脚本执行出错 → 抛异常(含错误详情)if 返回体.get("error"):错误详情 = json.dumps(返回体.get("error_details") or {}, ensure_ascii=False)[:300]raise RuntimeError("{} 执行出错: {} {}".format(脚本名, 返回体.get("error"), 错误详情))if 返回体.get("status") != "finished":raise RuntimeError("{} 未执行完毕".format(脚本名))结果 = (返回体.get("data") or {}).get("result")if isinstance(结果, dict):return 结果文本 = (结果 or "").strip()try:return json.loads(文本)except Exception:return {"ok": True, "raw": 文本}def 规范化URL(图片URL):"""修正 URL 中 ? 的误用:百度图片链接常出现 f=JPEG?w=740 这种畸形写法(? 应作参数分隔符 &)。若第一个 ? 之前已含 = 或 &(说明 ? 出现在参数中间),把该 ? 替换为 & → f=JPEG&w=740。正常 URL(如 /path?id=1)不受影响。"""问号位置 = 图片URL.find("?")if 问号位置 > 0 and ("&" in 图片URL[:问号位置] or "=" in 图片URL[:问号位置]):return 图片URL[:问号位置] + "&" + 图片URL[问号位置 + 1:]return 图片URLdef 魔数识别图片类型(图片字节):"""按文件头魔数识别真实图片格式(不依赖 Content-Type)。fmt=auto 等场景下服务器返回格式多变,Content-Type 可能缺失或为 octet-stream,用魔数兜底最可靠。返回 (mime, 后缀);识别不出返回 None。"""if 图片字节[:8] == b'\x89PNG\r\n\x1a\n':return ("image/png", "png")if 图片字节[:3] == b'\xff\xd8\xff':return ("image/jpeg", "jpg")if 图片字节[:6] in (b'GIF87a', b'GIF89a'):return ("image/gif", "gif")if 图片字节[:4] == b'RIFF' and 图片字节[8:12] == b'WEBP':return ("image/webp", "webp")if 图片字节[:2] == b'BM':return ("image/bmp", "bmp")return None# 非图片文件:Content-Type → 扩展名(用于通用文件直链下载)文件类型映射 = {"application/vnd.openxmlformats-officedocument.spreadsheetml.sheet": "xlsx","application/vnd.ms-excel": "xls","application/pdf": "pdf","application/msword": "doc","application/vnd.openxmlformats-officedocument.wordprocessingml.document": "docx","application/vnd.openxmlformats-officedocument.presentationml.presentation": "pptx","application/vnd.ms-powerpoint": "ppt","application/zip": "zip","application/x-zip-compressed": "zip","text/csv": "csv","text/plain": "txt",}# 通用文件扩展名白名单:URL 带这些扩展名且响应类型未知时按扩展名命名通用文件扩展名 = {"xlsx", "xls", "pdf", "doc", "docx", "ppt", "pptx","zip", "rar", "7z", "csv", "txt", "mp3", "mp4"}# 金山系域名:分享/文档网页链接(非文件直链)金山分享域名 = ("kdocs.cn", "wps.cn", "wps365.com")def 是金山分享链接(链接):"""判断链接是否为金山文档/多维表/知识库的网页分享链接(如 www.kdocs.cn/l/xxx)。这类链接无需下载:直接作为 DBCellValue 的 fileData(云文档链接)写入附件,金山后端自行解析分享链接挂载(source=cloud 云引用,点开跳转文档)。与签名直链的区别:签名直链(带 KSSAccessKeyId)会下载成实体文件;分享网页链接落为云引用,无实体字节。"""from urllib.parse import urlparsetry:解析 = urlparse(链接)except Exception:return False主机 = (解析.netloc or "").lower()if not any(主机.endswith(域) for 域 in 金山分享域名):return False# 分享/文档页路径特征:/l/ /view/ /wiki/ /d/ /docx /sheet /ppt /x/ /w/ 等路径 = (解析.path or "").lower()return 路径.startswith(("/l/", "/view/", "/wiki/", "/d/", "/docx","/sheet", "/ppt", "/x/", "/w/", "/api/", "/k/"))def 是金山签名直链(链接):"""判断链接是否为金山对象存储的签名下载直链(带 KSSAccessKeyId + Signature)。这类直链免登录可直接下载,也可作为 DBCellValue 的 fileData(云文档链接)直写附件,无需下载转 base64。来源:WPS 客户端/网页「下载文件」导出的链接、或开放平台 download 接口返回的直链(有效期通常 10 分钟,需及时写入)。"""from urllib.parse import urlparse, parse_qstry:解析 = urlparse(链接)except Exception:return False主机 = (解析.netloc or "").lower()if not any(主机.endswith(域) for 域 in 金山分享域名):return False查询 = parse_qs(解析.query)return "KSSAccessKeyId" in 查询 and "Signature" in 查询def 从签名直链取文件名(链接):"""从签名直链的 response-content-disposition 参数解析文件名(如 filename*=utf-8''xxx.xlsx)。解析失败则回退 URL 最后一段。返回带扩展名的文件名。"""from urllib.parse import urlparse, parse_qs, unquotetry:查询 = parse_qs(urlparse(链接).query)cd = 查询.get("response-content-disposition", [""])[0]if "filename*=" in cd:return unquote(cd.split("filename*=")[1].split("''")[-1].split(";")[0])except Exception:pass末尾 = 链接.rstrip("/").rsplit("/", 1)[-1].split("?")[0]return 末尾 or "下载文件.bin"def 从金山分享链接取文件名(链接):"""免登录识别金山分享链接对应的真实文件名(含扩展名,如 xxx.xlsx / xxx.docx / xxx.pdf)。通道:GET https://drive.kdocs.cn/api/v5/links/{sid}(公开分享免登录可读,返回 fileinfo.fname)分享链接可能是 Excel / Word / PDF 等任意类型,金山后端按 fileName 后缀记录附件 type,所以必须拿到真实扩展名,避免类型错乱。失败(网络异常/非公开分享)返回 None,由调用方兜底。"""from urllib.parse import urlparsetry:sid = (urlparse(链接).path or "").rstrip("/").rsplit("/", 1)[-1]if not sid:return None响应 = requests.get("https://drive.kdocs.cn/api/v5/links/{}".format(sid),headers=下载请求头, timeout=15)if 响应.status_code != 200:return None数据 = 响应.json()文件名 = ((数据.get("fileinfo") or {}).get("fname") or "").strip()return 文件名 or Noneexcept Exception:return Nonedef 下载文件(链接):"""下载链接内容(图片 + 通用文件直链)→ (字节内容, 后缀)- 金山分享网页链接(kdocs.cn /l/ 等)→ 提前识别并报"需登录态"- 图片:平台防盗链规则 + URL 规范化 + 魔数识别(原 下载图片 全部能力)- 非图片文件(xlsx/pdf/docx 等直链):按 Content-Type 或 URL 扩展名命名防盗链应对:平台规则表命中 → 平台 Referer;未命中 → www.<主域>/<主域>/URL自身返回: (bytes, 后缀);全部尝试失败抛 RuntimeError(含原因汇总)"""from urllib.parse import urlparse# 0) 金山分享网页链接预检(无法自动下载,明确提示原因)if 是金山分享链接(链接):raise RuntimeError("金山分享/文档链接需要登录态,云端脚本无法直接下载。""请改为文件直链(如 xlsx 的下载直链),或让豆包用浏览器辅助下载落表")# 1) 图片后缀映射图片后缀映射 = {"image/png": "png", "image/jpeg": "jpg", "image/jpg": "jpg","image/webp": "webp", "image/gif": "gif", "image/bmp": "bmp",}# 2) 按 URL 域名生成候选 Referer:# 平台规则表命中 → 平台专用 Referer 优先(None 表示无需 Referer)# 未命中 → 通用:www.<主域> / <主域> / 图片 URL 自身主机 = (urlparse(链接).netloc or "").lower()主机部分 = 主机.split(".")主域 = ".".join(主机部分[-2:]) if len(主机部分) >= 2 else 主机平台Referer = Nonefor 域名后缀, 推荐Referer in 平台防盗链规则:if 主机.endswith(域名后缀):平台Referer = 推荐Refererbreakif 平台Referer is not None:Referer候选 = [平台Referer, 链接]else:Referer候选 = ["https://www.{}/".format(主域),"https://{}/".format(主域),链接,]# 3) URL 变体:原样 + 规范化(畸形 ? 修正)URL变体 = [链接, 规范化URL(链接)]失败原因集合 = []for 变体 in URL变体:for Referer in Referer候选:try:当前头 = dict(下载请求头)if Referer:当前头["Referer"] = Referer响应 = requests.get(变体, headers=当前头, timeout=20)if 响应.status_code != 200:失败原因集合.append("HTTP {}".format(响应.status_code))continue内容字节 = 响应.content内容类型 = (响应.headers.get("Content-Type") or "").lower().split(";")[0]# 4) 图片判定:Content-Type → 魔数if 内容类型 in 图片后缀映射:return 内容字节, 图片后缀映射[内容类型]魔数结果 = 魔数识别图片类型(内容字节)if 魔数结果:return 内容字节, 魔数结果[1]# 5) 文件判定:Content-Type 映射 → URL 扩展名白名单if 内容类型 in 文件类型映射:return 内容字节, 文件类型映射[内容类型]# URL 扩展名兜底(octet-stream 等未知类型时)URL末尾 = 变体.rstrip("/").rsplit("/", 1)[-1].split("?")[0].split("#")[0]URL扩展名 = URL末尾.rsplit(".", 1)[-1].lower() if "." in URL末尾 else ""if URL扩展名 in 通用文件扩展名:return 内容字节, URL扩展名失败原因集合.append("响应类型无法识别为图片或文件(Content-Type={})".format(内容类型 or "未知"))except Exception as 异常:失败原因集合.append(str(异常)[:80])# 6) 去重原因后汇总报错原因去重 = list(dict.fromkeys(失败原因集合))[:4]raise RuntimeError("下载失败(已尝试 {} 种组合):{}".format(len(URL变体) * len(Referer候选), ";".join(原因去重)))def 文件转DataUrl(字节, 后缀):"""文件/图片字节 → data URI 字符串(mime 按后缀查表,供写附件脚本使用)"""mime表 = {# 图片"png": "image/png", "jpg": "image/jpeg", "jpeg": "image/jpeg","webp": "image/webp", "gif": "image/gif", "bmp": "image/bmp",# 办公文档"xlsx": "application/vnd.openxmlformats-officedocument.spreadsheetml.sheet","xls": "application/vnd.ms-excel","pdf": "application/pdf","doc": "application/msword","docx": "application/vnd.openxmlformats-officedocument.wordprocessingml.document","pptx": "application/vnd.openxmlformats-officedocument.presentationml.presentation","ppt": "application/vnd.ms-powerpoint",# 压缩包 / 文本 / 音频视频"zip": "application/zip", "rar": "application/x-rar-compressed", "7z": "application/x-7z-compressed","csv": "text/csv", "txt": "text/plain","mp3": "audio/mpeg", "mp4": "video/mp4",}mime = mime表.get(后缀, "application/octet-stream")return "data:{};base64,{}".format(mime, base64.b64encode(字节).decode("ascii"))def 清理文件名(名称):"""去掉文件名中的非法字符(Windows 不允许 \\ / : * ? \" < > |)"""return re.sub(r'[\\/:*?"<>|]', '_', 名称)def 拆分链接列表(文本):"""把「链接」字段文本拆成多个图片 URL。分隔符自动识别(全部兼容,可混用):① 换行(每行一个链接)—— 推荐,MultiLineText 天然支持多行② 英文逗号 , / 中文逗号 ,③ 英文分号 ; / 中文分号 ;④ 空白(空格/Tab)只保留 http(s) 开头的有效链接,其余片段(如说明文字)自动忽略。"""链接们 = []for 行 in str(文本).replace("\r", "\n").split("\n"):# 每行再按常见符号拆分(逗号/分号/空白)片段们 = re.split(r'[,;,;\s]+', 行.strip())for 片段 in 片段们:片段 = 片段.strip()if 片段.startswith("http://") or 片段.startswith("https://"):链接们.append(片段)return 链接们def 主函数():"""读取入参 → 定位记录 → 拆分多链接 → 逐个下载转 dataUrl → 调写脚本一次落多附件。"""# 第一步:读取自动化入参(仅记录ID,链接从记录读取)记录ID = 取入参(入参_记录ID)if not 记录ID:return {"错误": "未收到「%s」入参,请在自动化流程脚本入参中配置" % 入参_记录ID}print("入参:记录ID=%s" % 记录ID)# 第二步:按记录ID 定位该行,读取「链接」字段(可含多个图片 URL)数据表 = dbt(sheet_name=数据表名)if 记录ID not in 数据表.index:return {"错误": "记录ID %s 在表「%s」中不存在" % (记录ID, 数据表名)}链接值 = 读字段(数据表, 记录ID, 链接字段)if pd.isna(链接值) or str(链接值).strip() == "":return {"错误": "记录 %s 的「%s」为空,请先填写图片链接" % (记录ID, 链接字段)}# 拆分多链接:换行/逗号/分号/空格 自动识别链接列表 = 拆分链接列表(链接值)if not 链接列表:return {"错误": "「%s」字段中未识别到有效 http(s) 链接,请检查填写格式" % 链接字段}print("识别到 %d 个链接:%s" % (len(链接列表), " / ".join(链接列表)))# 第三步:逐个下载图片(防盗链多重尝试;单个失败不中断,收集明细)成功项 = [] # [{fileData(dataUrl), fileName}]失败明细 = []已用文件名 = set() # 同批重名时追加序号,避免相互覆盖for 序号, 图片URL in enumerate(链接列表, start=1):# 分支一:金山签名直链 → 作为 fileData(云文档链接)直写,无需下载转 base64if 是金山签名直链(图片URL):try:文件名 = 从签名直链取文件名(图片URL)dataUrl = 图片URL # 直链即 fileData图片后缀 = 文件名.rsplit(".", 1)[-1].lower() if "." in 文件名 else "bin"print("[%d/%d] 金山签名直链,直写:%s → %s" % (序号, len(链接列表), 图片URL[:80], 文件名))except Exception as 异常:失败明细.append({"链接": 图片URL, "原因": "直链解析失败:" + str(异常)[:80]})print("[%d/%d] 直链解析失败:%s" % (序号, len(链接列表), str(异常)[:80]))continue# 分支二:金山分享网页链接 → 直接作为 fileData(云引用)直写,# 金山后端自行解析分享链接挂载附件(source=cloud 云引用,点开跳转文档)elif 是金山分享链接(图片URL):真实文件名 = 从金山分享链接取文件名(图片URL)if 真实文件名:文件名 = 清理文件名(真实文件名) # 真实名带正确扩展名(.xlsx/.docx/.pdf)print("[%d/%d] 金山分享链接,云引用直写(识别类型:%s)" %(序号, len(链接列表), 文件名))else:# 识别失败兜底:无后缀命名(避免误导 type),金山后端仍按链接挂载from urllib.parse import urlparsesid = (urlparse(图片URL).path or "").rstrip("/").rsplit("/", 1)[-1] or "分享文档"文件名 = "金山分享文档-{}".format(sid)print("[%d/%d] 金山分享链接,云引用直写(类型识别失败,兜底命名)" %(序号, len(链接列表)))dataUrl = 图片URL # 分享链接即 fileData# 分支三:普通链接 → 下载后转 dataUrl(图片/文件通用)else:try:图片字节, 图片后缀 = 下载文件(图片URL)except Exception as 异常:失败明细.append({"链接": 图片URL, "原因": str(异常)[:120]})print("[%d/%d] 下载失败:%s(%s)" % (序号, len(链接列表), 图片URL, str(异常)[:80]))continue# 转 data URI + 文件名(去重扩展名;同批重名加序号)dataUrl = 文件转DataUrl(图片字节, 图片后缀)基础名 = 图片URL.rstrip("/").rsplit("/", 1)[-1].split("?")[0]基础名去扩展 = 基础名.rsplit(".", 1)[0] if "." in 基础名 else 基础名候选名 = 清理文件名("{}.{}".format(基础名去扩展 or "图片", 图片后缀))文件名 = 候选名print("[%d/%d] 已下载:%s → %s(%d 字节)" %(序号, len(链接列表), 图片URL, 文件名, len(图片字节)))# 同批重名加序号,避免相互覆盖序号计数 = 2最终文件名 = 文件名while 最终文件名 in 已用文件名:根名 = 文件名.rsplit(".", 1)[0] if "." in 文件名 else 文件名扩展名 = 文件名.rsplit(".", 1)[1] if "." in 文件名 else ""最终文件名 = "{}_{}.{}".format(根名, 序号计数, 扩展名) if 扩展名 else "{}_{}".format(根名, 序号计数)序号计数 += 1已用文件名.add(最终文件名)成功项.append({"fileData": dataUrl, "fileName": 最终文件名})# 全部失败 → 明确报错if not 成功项:return {"错误": "所有链接下载失败","detail": ";".join("%s: %s" % (项["链接"][:60], 项["原因"]) for 项 in 失败明细)[:300]}# 第四步:调「链接转附件写」脚本:一次写入全部附件(表「替换」写「附件」字段)if not 链接转附件写脚本ID:return {"错误": "未配置「链接转附件写」脚本ID","detail": "请在多维表脚本 IDE 创建 airscript_link_to_attachment_write.js 并填入配置区"}写入入参 = {"record_id": 记录ID, "files": 成功项}try:写入结果 = 调用脚本(链接转附件写脚本ID, 写入入参, "链接转附件写")except Exception as 异常:return {"错误": "写入附件失败", "detail": "链接转附件写 脚本调用异常:" + str(异常)[:200]}if not 写入结果 or not 写入结果.get("ok"):return {"错误": "写入附件失败", "detail": json.dumps(写入结果, ensure_ascii=False)[:200]}写入数 = 写入结果.get("count") or len(成功项)print("已写入 %d 个附件到「%s」字段" % (写入数, 附件字段))# 返回结果字典,自动化流程日志可查看return {"记录ID": 记录ID,"识别链接数": len(链接列表),"成功下载数": len(成功项),"失败数": len(失败明细),"失败明细": 失败明细[:5],"写入附件数": 写入数,}# 脚本直接运行时执行主函数(被 import 时不执行)if __name__ == "__main__":print(主函数())
// =========================================================================// AirScript「链接转附件写」v1:把 PY 传入的图片 dataUrl 写回「附件」字段// (由「生成码写」v1 改造:表名换为「替换」,目标字段换为「附件」)// 入参(PY 通过 sync_task 传入,接口键保持英文):// record_id : 记录 ID// files : [{fileData, fileName}, ...](一次写回「附件」附件字段)// 返回(接口键保持英文):{ ok, count }// 兼容:1.0 环境全局 DBCellValue 可用;2.0 需 Application.DBCellValue → 自动适配// =========================================================================function main() {// ---------- 读取入参 ----------// 金山运行时注入全局 Context;本地调试/直接运行可能没有 → 兜底空对象var 运行上下文 = (typeof Context !== 'undefined' && Context.argv) ? Context.argv : {};// 入参:记录 ID(兼容数组形式,取第一个元素)var 记录ID原始 = 运行上下文.record_id;var 记录ID = Array.isArray(记录ID原始) ? 记录ID原始[0] : 记录ID原始;// 没有记录 ID → 直接返回错误if (!记录ID) { return { ok: false, error: 'no record_id' }; }// 入参:文件列表(兼容三种形态:JSON 字符串 / 单个对象 / 数组)var 文件列表 = 运行上下文.files;// 字符串 → 尝试 JSON 解析;解析失败按单对象处理if (typeof 文件列表 === 'string') {try { 文件列表 = JSON.parse(文件列表); } catch (错误) { 文件列表 = [文件列表]; }}// 非数组 → 包成数组(单图场景)if (!Array.isArray(文件列表)) { 文件列表 = [文件列表]; }// ---------- 清理文件列表:只保留 {fileData, fileName} ----------// 无文件数据的项直接丢弃(防止空 Base64 写坏附件)var 干净列表 = [];for (var 索引 = 0; 索引 < 文件列表.length; 索引++) {// 当前项(兼容空项 null)var 单项 = 文件列表[索引] || {};// 兼容「fileData / dataUrl」两种键if (单项.fileData || 单项.dataUrl) {干净列表.push({fileData: 单项.fileData || 单项.dataUrl, // Base64 dataUrl 字符串fileName: 单项.fileName || '图片.png' // 附件文件名(缺省兜底)});}}// 没有有效数据 → 返回错误(避免写空附件)if (干净列表.length === 0) { return { ok: false, error: 'no valid fileData' }; }// ---------- 写回图片 ----------// 自动适配 DBCellValue:1.0 环境全局函数;2.0 需 Application 前缀var 写附件函数 = (typeof DBCellValue === 'function') ? DBCellValue : Application.DBCellValue;// 打开数据表「替换」(链接转附件专用表名)var 数据表 = Application.Sheets('链接转附件');// 写回「附件」附件字段(一次写入全部图片)数据表.RecordRange(记录ID, '@附件').Value = 写附件函数(干净列表);// ---------- 返回结果给 PY(接口键保持英文) ----------return {ok: true, // 是否成功count: 干净列表.length // 写入的图片数量};}return main();