ARTICLE · 1272273
程序员终结者:如何从 0 到 1 搭建软件工厂?
工程团队只有 4 个人的 AI 编程工具公司 Traycer,开了一座"软件工厂":AI 自己接活、自己修、自己交证据,人看证据拍板。前 11 天,团队合并的 675 个改动里,332 个是 AI 自己提交的;用户凌晨报的 bug,AI 23 分钟就合并了修复。下面是他们的全套做法:① 你会知道哪些活可以第一天就交给 AI:线上报错、时好时坏的测试、更新文档,这类做错了也不心疼的杂活。② 你不用再逐行看 AI 写了什么:让它交录屏和真实运行结果,你看证据拍板。③ 老板看这条:发版前,AI 把 179 个改动分成 19 块、标出 5 块高风险,团队读五分钟就能决定发不发。④ 你会知道 AI 手里该留哪把钥匙:只给"能看"的权限,对外发消息、上线这类事必须过人。以下为正文全文翻译(略去文末延伸阅读清单和产品广告),原意未动。文末附我的落地建议。
以下是作者 Tanveer Gill(Traycer 团队)的原文,副标题是"造工厂的人怎么说,以及我们自己跑出来的经验"。
我们打开软件工厂 11 天后,团队合并的 675 个 PR(合并请求,就是一次代码改动的提交单)里,有 332 个是工厂自己开的。
4 个工程师的团队,这 11 天里交付的东西,差不多一半出自 Traycer 的软件工厂。
这份指南是我们搭工厂学到的全部东西,再加上公开做这件事的人的最好想法:Matt Pocock(知名编程语言 TypeScript 讲师)、Lauren Tan 和 Dex Horthy(两位常公开分享 AI 编程经验的工程师)、Zach Lloyd(终端工具 Warp 的 CEO)、Ben Holmes(Warp 工程师),以及 OpenAI 的工程师——他们向 Gergely Orosz(科技通讯 The Pragmatic Engineer 作者)讲过自家的工厂。
下面的顺序,就是我们重来一遍会走的顺序。
01
AI 工厂的十一条做法,你的团队做到了几条?
1. 让代码库难以被 AI 写错。
2. 给 AI 一个自证工作的办法。
3. AI 写代码之前,先对齐计划。
4. 先自动化一个触发、一件活,再放大。
5. 把 AI 关进沙箱,发消息的钥匙别给它。
6. 让 AI 先审,人再看证据和要紧的代码。
7. 谁开的 PR,谁负责到合并。
8. 把线上问题送回工厂,并回复到用户那里才算闭环。
9. 让工厂改进自己的活。
10. 衡量交付了什么,不衡量烧了多少 token(AI 按用量计费的单位)。
11. 推广到全队,让每个人都能用、都能改。
02
"软件工厂"到底是什么,和让 AI 帮你写代码有什么不同?
这个词现在到处都是,也有不少人拿它开玩笑,这也难怪。我们是这么理解的。
Matt Pocock 的《AI 编程词典》把三件常被混为一谈的事分开了:
· AFK 智能体:你离开时让它自己跑的一个 AI 智能体(智能体就是能自己动手干活的 AI 程序;AFK 是"离开键盘");
· 软件工厂:一套由多个智能体组成的系统,有触发条件、关卡和反馈回路;
· 黑灯工厂:没有任何人读代码、写代码的工厂(好比关了灯也能自己运转的无人车间)。
Ben Holmes 补上了多数人漏掉的一点:工厂是全队共用的一套系统,不是每个人笔记本上各搭各的。自动化、代码库权限、密钥、沙箱、用哪个模型,都只有一个说了算的地方,大家像商定代码规范一样商定它。
我们的工作定义:
活按自己的触发条件进来,AI 智能体把它一路做到拿出证据,人做决定,系统每跑一次就变好一点。——Tanveer Gill
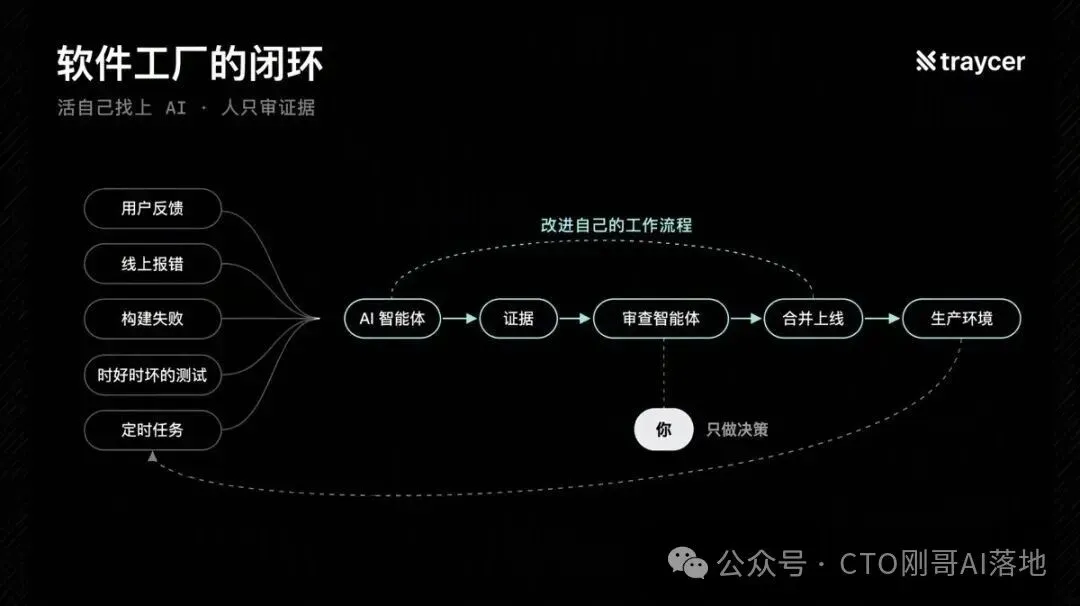
软件工厂的闭环:用户反馈、线上报错、构建失败等五类触发进来,AI 做完交证据,审查智能体先审,人只做决策,上线后的问题再回到工厂
先给一个警告,来自 Dex Horthy 的《软件工厂为什么会失败》:模型很擅长通过测试,很不擅长让代码库保持好改。所以这份指南搭的是一座"亮着灯"的工厂,人始终看得见里面。
AI 搭工厂真正的风险不是写出烂代码,是写出的代码多到没人看得懂。你每合并一次没看懂的改动,就欠下一笔"理解债"(好比签了一张没看懂条款的欠条),按 AI 的速度,这笔债利滚利滚得飞快。
下面每一步都在还这笔债:AI 把活一路做到拿出证据,人审证据,而不是逐行审代码改动。
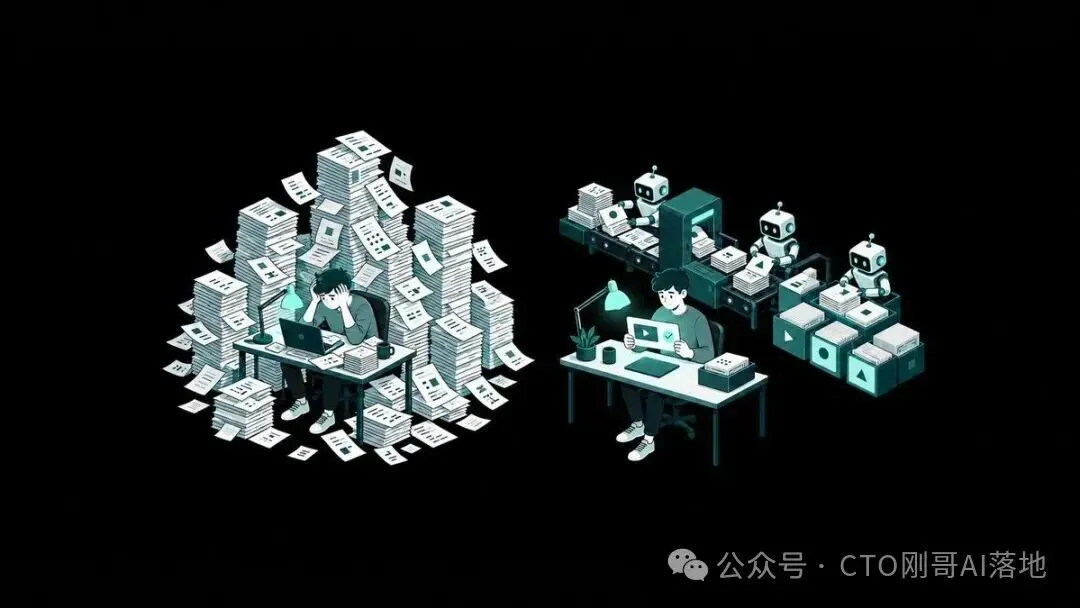
左边:人被看不完的代码改动淹没;右边:AI 在流水线上干活,人只看一段证明录屏
03
想让 AI 少犯错,力气该花在哪?
自动化任何东西之前,先把环境改成:最省事的做法,恰好就是正确的做法。
Lauren Tan(网名 @poteto)有个我们很喜欢的想法:信任金字塔。大部分力气花在最上层:
1. 改进代码库:更好的架构、更强的类型、清晰的边界。AI 会照抄现有的写法、走最短的路,所以在代码层面把一整类错误消灭掉。
2. 静态检查:代码规范检查、类型、测试、CI(每次提交自动跑的检查流水线)。便宜、结果确定、省 token。
3. 文字规则:AGENTS.md(写给 AI 看的项目说明书)、规则、技能。只用来管代码管不住的事。
4. 人工审查:最难规模化,所以人的精力花在设计环境上,不是逐行读代码。
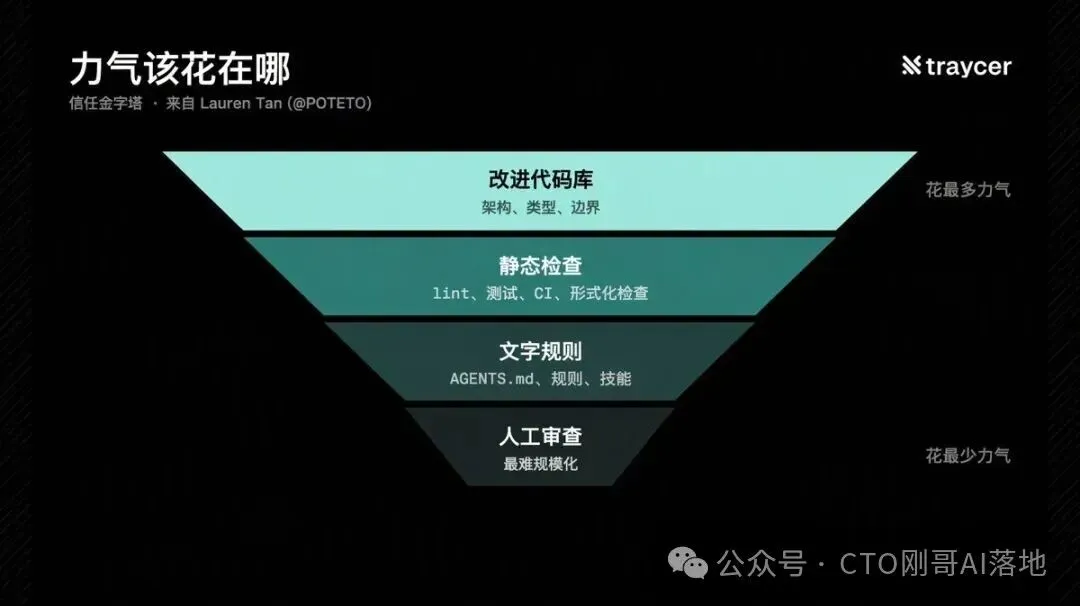
信任金字塔:改进代码库花最多力气,人工审查花最少力气
Matt Pocock 总结她的演讲时,有两个点值得早点偷师:
· 把 AI 锁住。给 AI 用不会被误用的封装,并用自动检查强制执行,效果好过给它锋利的工具。
· 功能地图。维护一份所有功能及其应有行为的地图,由工厂自己的自动化保持同步,这样 AI 能把一句模糊的 bug 反馈变成一个精确的修复。
OpenAI 走得更远:把文档搬进源代码目录,让 AI 像读代码一样读它。
Traycer 的做法:每一件活的说明都作为技能存在代码库里,所以改工厂和改别的代码一样,要走一次审查过的 PR。
能做什么:先问团队一句,AI 最常犯的那类错,能不能直接在代码或自动检查里堵死,而不是写进说明书。
04
一个 AI 都管不住,怎么敢让一百个 AI 通宵干?
让 AI 能自证工作,是整座工厂的入口,大多数人跳过了这一步。
你盯着一个 AI 干活时都信不过它,就更不可能在你睡觉时信得过几十上百个 AI。
Lauren 说,验证是你让 AI 自己循环干活的第一步。
AI 应该像用户一样运行、使用它做出来的东西,然后带回一份证据,证明:
1. 活是对的;
2. 符合你的本意;
3. 看它比看代码改动更快。
做界面的,证据就是一段录屏;做命令行工具的,就是真实命令加输出;遇到特别绕的状态逻辑,就上形式化方法(用数学方法把所有可能情况穷举一遍),比如 Lauren 的开源工具包 pstack,以及 GitHub 实验团队 GitHub Next 的 PDD Kit,它按规格书证明 AI 写的代码。
讲个小故事。我们在 Traycer 的同步代码上用了 TLA+,一种把所有可能情况都试一遍的验证方法。AI 写多人协作文档功能时,检查工具在一个两台机器的小模型里,把编辑、删除、崩溃交错发生的各种顺序都试了一遍;每找出一种新故障,我们就拿到真实代码上重放。结果真找到了能触发的问题:文档可能悄无声息地消失,删掉的文件可能又冒回来。而这段代码已经过了六轮审查。
六轮!
Traycer 的规矩:测试证明的是测试本身,录屏证明的才是产品。没有一个"在旧代码上会失败"的测试,修复就不准合并;AI 碰任何东西之前,先在真实构建里把 bug 复现出来。
能做什么:给 AI 派活时加一句"做完附上证据:录屏、运行结果或截图"。
05
AI 写代码前,为什么要先花 30 分钟对齐?
写代码变快以后,瓶颈挪到了审查。最便宜的审查,是审一份你早就同意过的计划。
Matt Pocock 把人和 AI 一起干活的白天叫"白班"(AI 自己通宵跑叫"夜班"),他的白班是这样的(技能都在他公开的 mattpocock/skills 里):
1. 用 `/grill-me`(一条写给 AI 的指令,下同)让 AI 反过来盘问你,直到你们对齐;
2. 用 `/to-prd` 写清终点,也就是需求文档;
3. 用 `/to-tickets` 把路径拆成小任务单,让多个 AI 并行接。
这些规格写完就该扔,不当文档留着。
Dex Horthy 的版本(他系列文章的第二篇)对有风险的事再往下挖一层:
1. 产品评审:问题是什么、成功长什么样,用一个粗糙的网页草图代替大段文字。
2. 系统架构:服务、接口约定、数据模型,画时序图(画清谁先谁后的流程图)。
3. 程序设计:调用关系树、要改哪些文件、每个函数接收什么返回什么。
4. 竖切一刀:先打通一条能摸得着的、从头到尾的细路径,而不是先建数据库、最后做界面。
花 30 分钟做计划,能省下几个小时的审查。——Dex Horthy
06
第一天该把什么活交给 AI 工厂?
现在开始自动化。但要小,别把整个待办清单都扔给工厂。先让它每天分拣一个问题,检查它的活,调整;然后两个、五个、十个。
Zach Lloyd 的"先爬、再走、后跑"列了一批适合起步的活,每件都是简单的"触发 → AI":
· 复现新报的问题并打标签;
· PR 一开就审;
· 收到 Sentry(线上报错监控工具)告警就给出修复;
· 修好失败的 CI;
· 更新文档和更新日志;
· 用浏览器或操控电脑来验证改动;
· 修用户报的简单 bug。
所以要挑杂活。Zach Lloyd 挑活的规矩:AI 做对了最好,做错了,直接无视它的产出也零成本。
我们最早的活正是这些:第一天是 Sentry 报错和时好时坏的测试;第二天加上用户反馈、主干代码构建失败和工厂自身的维护;到第四天,加上模型供应商更新、发版和基础设施告警。
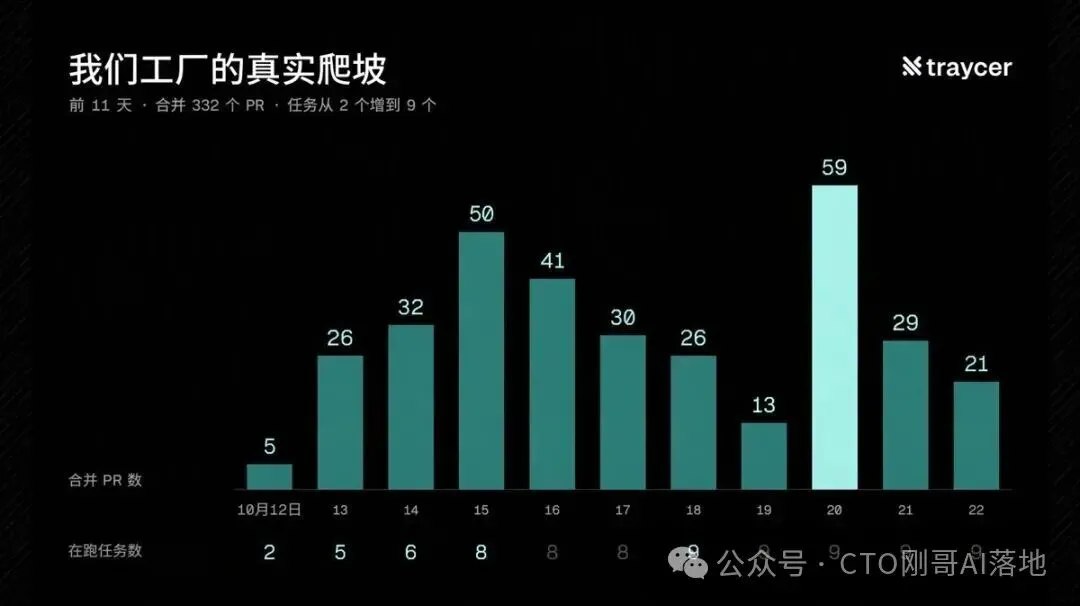
前 11 天的真实爬坡:每天合并的 PR 数,以及在跑的任务从 2 个增加到 9 个
能做什么:列出团队里"做错了也不心疼"的三件杂活,先只交一件给 AI。
07
没人盯着的 AI,钥匙该给到哪一步?
工厂跑的是没人盯着的 AI,所以默认其中某个一定会捅娄子。
每个 AI 都关进沙箱(隔离的运行环境,弄坏了也不影响别处)。做法:
· 沙箱。Matt Pocock 开源的 Sandcastle 是最简单的起点:调一次 `run()`,就在 Docker、Podman(两种隔离运行环境的工具)或云端微型虚拟机里,在它自己的分支上启动一个 AI,干完再把提交合回来。
· 一套共用的设置。把工厂当团队基础设施来跑,不放在某个人的笔记本上。
· 权限给到够用为止。只给这件活需要的权限。有人在 Zach 的帖子下回复得好:先有限定权限和回滚能力(出错能一键退回原状),再谈自主,别等出了第一次事故才补。
Traycer 的做法:AI 手里只有只读令牌,也就是只能看、不能改、不能发的账号权限。发给 Slack(团队聊天工具)、Discord(社区聊天工具)上的人的消息,以及审批过的用户回复,都走一个单独的网关(消息中转站)。网关握着发消息的钥匙,每条消息都按规则和每日额度检查,还会守"静默时段"。
凡是来自用户、Slack 或 Sentry 的内容,都只是数据,绝不是给 AI 的指令。
我们踩过一个坑:用一个大模型在消息到我们手上之前过滤噪音。结果它悄悄扣下了 40 条本该发出的消息,里面有真实的审批请求和发版通知。
糗了。
过滤消息这件事,简单的规则加额度,比让大模型来判断好用得多。
能做什么:查一遍你的 AI 工具手里有哪些权限,把"能发出去、能删、能付钱"的先收回来。
08
AI 交的改动多到看不过来,人该看什么?
PR 会多到没人读得完。Dex 说得好:
你的问题不是 PR 太多,是烂 PR 太多。——Dex Horthy
管用的做法:
· 几个分工不同的审查 AI。OpenAI 用领域专家式的审查 AI,相当于每次改动都有一个基础设施专家和一个安全专家看过。
· 一个"盲审"AI。我们的盲审只读代码改动和原始问题,从不看写代码那个 AI 的思路,所以它不会被说服、不会跟着附和。
· 按风险分级。OpenAI 让高风险改动走更严的审查,某些区域的低风险改动自动放行。
· 人的注意力放在证据上,不放在每一行代码上。
我们最清楚的例子是发版。每次发版前,我们的发版 AI 在 Slack 里发一份提案:179 个 PR 分成 19 块,标出 5 块高风险以及原因,测试人员在预发布环境(正式上线前的演练环境)跑了什么,哪些它没法检查("未覆盖:桌面端实机复现、移动端构建、签名工具"),以及谁需要批准什么。附一段两分钟带解说的演示录屏。
Traycer 发版前,179 个改动由 AI 分好组、标出 5 块高风险,团队读五分钟就做决定。
09
改动提交了,活就算干完了吗?
开 PR 是最容易的部分。真正的活是让它合并:回复审查意见、修失败的检查、变基(别人先改了代码,就把自己的改动挪到最新版本上重新对齐)。
在 OpenAI,AI 会"一直看着这个 PR,直到全绿",也就是所有自动检查都通过。
Traycer 的做法:哪个 AI 开的 PR,就由哪个 AI 负责到合并。每 15 分钟,有一个检查扫一遍工厂开着的 PR,卡住的就推一把;而每次需要人在两个 AI 之间传话,我们都当 bug 处理。
又一个我们踩过的坑:有一件活三天里给我们起草了 45 条消息,其中 36 条写的是"无需处理"。还好一条都没发出去。我们得教它什么时候闭嘴。
现在 Traycer 的每个 AI,要么把活落地,要么问一个清楚的问题。
能做什么:给 AI 定一条规矩:没结果不汇报,要汇报就带一个明确的问题。
10
用户半夜报的 bug,怎么做到第二天早上已经修好?
工厂的全部意义在于:活自己找上 AI。
· OpenAI 的性能工厂(Gergely 报道)盯着线上环境,去掉重复告警,找出真正的响应变慢,并提出修复。
· 他们的事故 AI 收集背景、建议止损办法,但由人来决定。
· 他们的部署 AI 一路"扶着"每个改动上线,还给它自己搭一个监控面板。
· Ben Holmes 用一个网络钩子(webhook,事件发生时自动通知另一个系统)把 Sentry 告警转给 AI,产出就是修复 PR。
讲一个我们自己的完整例子。
一位用户装不上 Traycer,因为他的 Windows 系统语言设成了西班牙语。他报问题时是我们这边的凌晨 4:24。
AI 把它和 200 多条来自非英文 Windows 的 Sentry 报错放在一起比对,确认是同一个病根:一处检查只认得英文报错信息。然后它写了一个会失败的测试,再写了一个小修复。
第 8 分钟,PR 开出来;第 22 分钟,补上边界情况的测试;第 23 分钟,通过自动审查并合并。
我们手边没有 Windows 机器去跑一遍完整的安装,PR 里也照实写了这一点。
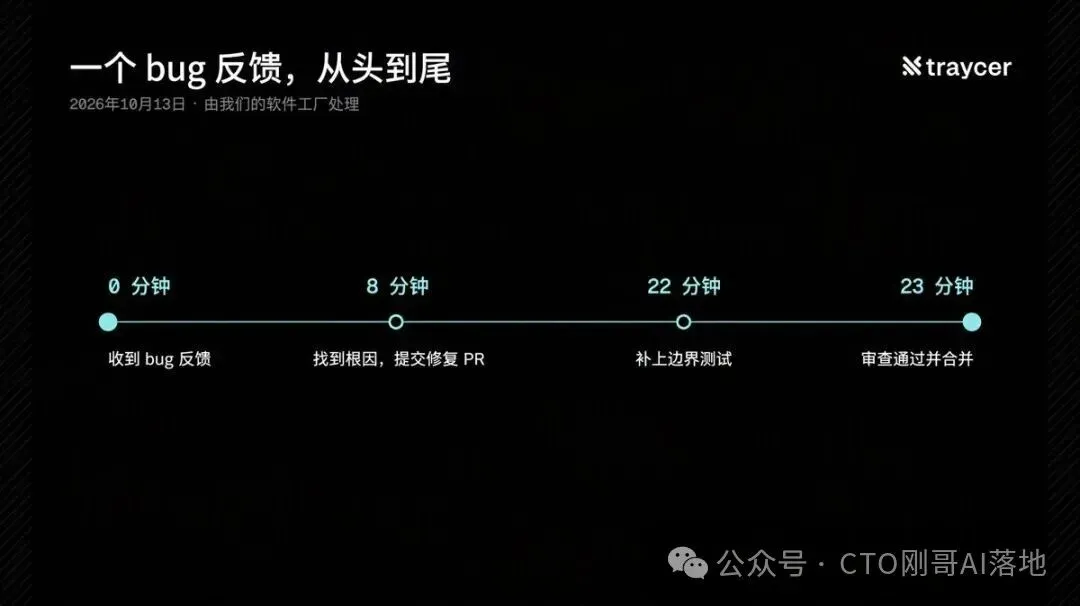
一个 bug 反馈从头到尾:0 分钟收到反馈,8 分钟找到根因并提交修复,22 分钟补上边界测试,23 分钟合并
但闭环不在合并那一刻结束,闭环结束在报 bug 的那个人收到回复的时候。
有人在 Discord 上告诉我们,AI 提问时给的长选项会被截断。一夜之间,我们的分拣 AI 找到原因、写了会失败的测试、修好了它(中间只找我们拍了一次板)。然后它回到同一个 Discord 帖子里告诉对方:修复会在下一个版本发布。那时是我们这边的凌晨 2:47。
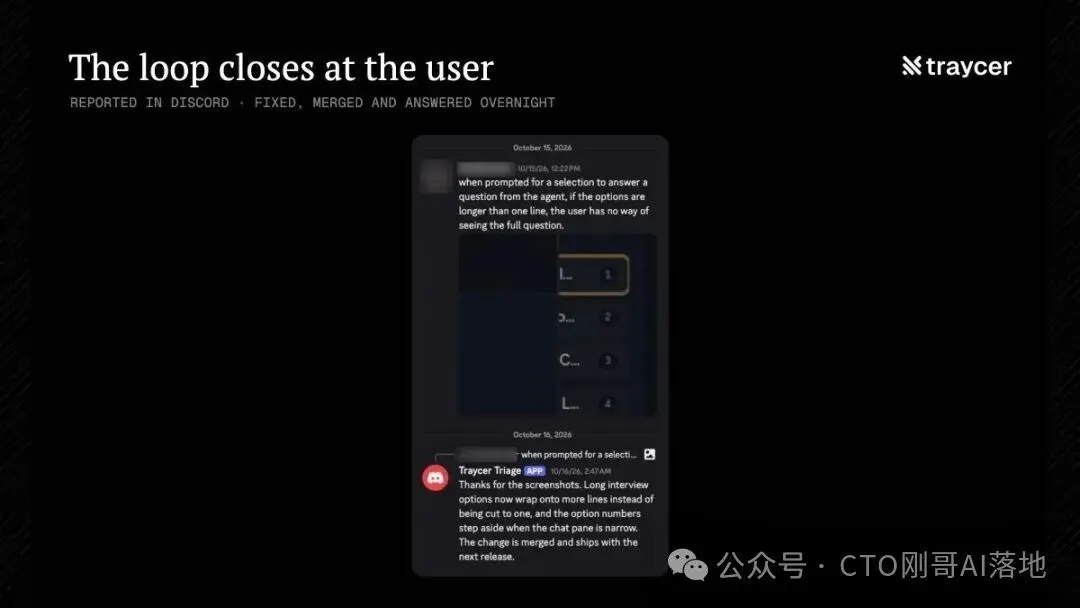
用户在 Discord 报告长选项被截断,第二天凌晨 Traycer 的分拣 AI 回复:已修复并合并,下个版本发布
能做什么:让 AI 处理完客户问题后,回到原来的对话里告诉客户结果,这一步别省。
11
怎么让 AI 工厂越跑越好,而不是越跑越乱?
大多数指南跳过了这一步,而它是会复利的那一步。
Ben Holmes 的自我改进循环:
1. 收集每一次 AI 工作会话;
2. 按评分标准给每次打分(效率、代码质量);
3. 让一个 AI 找出低分会话的共同原因;
4. 让它提议去改技能、AGENTS.md 或代码库。
Matt Pocock 出于同样的原因,会对旧会话跑 `/retro` 复盘,并且每周定时让一个 AI 精简他的全局规则文件。Lauren 把这种活叫"园艺"。Zach 和 Ben 叫它"工厂工程":产品工程改进产品,工厂工程改进那些改进产品的 AI。
Traycer 的数字:工厂合并的前 332 个 PR 里,43 个是它在改进自己的活。每件活每周自查一次,它指出的任何改进当天就变成一个 PR。同一个问题我们用同样的方式回答了三次,它就变成一条常设规则。
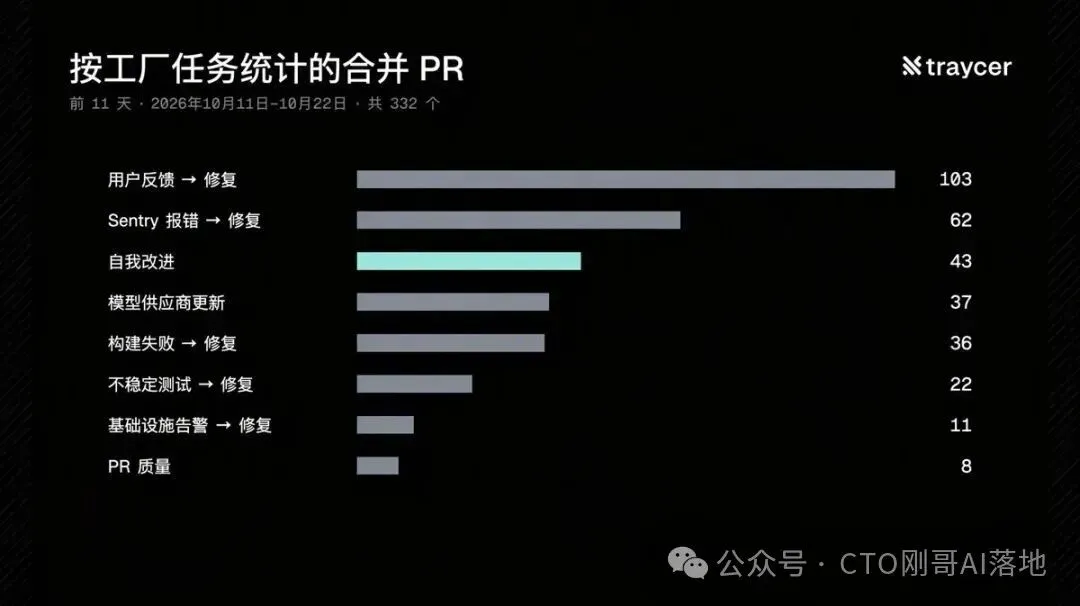
按工厂任务统计的合并 PR:用户反馈修复 103 个最多,自我改进 43 个
12
老板该看哪几个数,判断 AI 工厂值不值?
不看烧了多少 token。
Zach Lloyd 的建议:先追踪使用率,再看产出量、周期时间和每个 PR 的成本。Ben Holmes 说,他们每个 PR 的成本降了 67%,大部分来自拿过去的任务换不同的模型重放一遍、比出最合适的。
我们 11 天后的计分板:
· 合并的 PR 里,49% 由工厂开出;
· 工厂开的 PR,92% 被合并,28 个没合并就关了;
· PR 从开出到合并,中位时长 1.6 小时;
· 用户反馈到修复合并,最快 23 分钟。
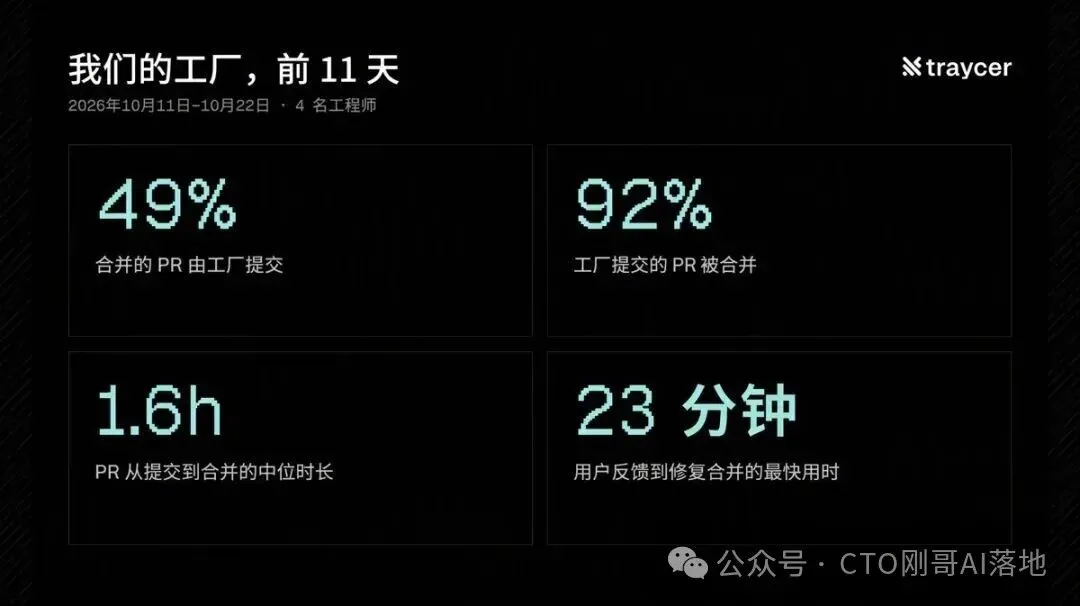
Traycer 的工厂前 11 天:49% 的合并 PR 由工厂提交,92% 的工厂 PR 被合并,中位 1.6 小时合并,最快 23 分钟修好用户反馈
不管衡量什么,衡量的是交付了什么,而不是烧了多少 token。
13
怎么推到全队,又不让同事觉得它只会批量造垃圾?
Zach 的组织推广打法,压缩一下:
· 从杂活开始,让价值马上看得见;
· 用起来要像在 Slack、Linear(项目管理工具)或 GitHub 里@一下 AI 那么简单,别另建一个新门户;
· 把工厂当成人人都能改进的共享基础设施,而不是只有管理员能配置的产品;
· 鼓励,不强制;庆祝交付了的成果,不庆祝 token 花了多少。
他点名要避开的陷阱:第一天就上一个全量修复待办的循环,结果产出一堆没人审的 PR,团队就会认定"这玩意只会批量造垃圾"。
14
AI 工厂再强,哪些事必须留给人?
AI 很擅长战术层面的事,但对战略性的改变没有胃口。
Matt 说得最好:
你可以有一座软件工厂,但你得让灯一直亮着(人始终看得见工厂里在干什么)。——Matt Pocock
在 Traycer 的工厂里,产品决策、文案、登录权限、计费、发版、公开回复,以及一切不可逆的事,都归人管。每一件都以"一个待做的决定 + 一条建议"的形式出现在人面前。
日常修复走工厂的关卡;人决定例外,并阅读要紧的代码。
🎯 刚哥落地按
这篇是一个 4 人技术团队写的,但"让 AI 自己接活、交证据、人只拍板"这套思路,不写代码的团队一样用得上。我挑三件现在就能动手的事:
先交一件做错了也不心疼的杂活:有技术团队的,从"线上报错自动出修复"开始;没有的,从每天的数据汇总、客户问题分类开始。一次只交一件,跑一周再加第二件。
只收证据,不收"我做完了":给 AI 派活时写死一句"做完附录屏、运行结果或核对过程"。你看证据五分钟拍板,比自己从头查一遍快得多。
钥匙留在人手里:AI 只给能看的权限;对外发消息、付款、上线、删除这类收不回来的事,必须过一个人。
一句话:先让 AI 干一件小杂活、交出证据,再一点点把活和权限放给它。
原文:How to build a software factory from zero,作者 Tanveer Gill(@GillTanveer89,AI 编程工具 Traycer 团队),发布于 X,2026 年 10 月 26 日。
中文节译与排版整理:刚哥AI落地。除下列删节外,正文为全文翻译,观点、数字、案例未动;价值预告、小标题、每节末尾的斜体行动句、括号里的名词解释与落地按为整理者所加;原文开头的配图、文末的延伸阅读清单(约 20 条英文链接)、Traycer 产品候补名单广告,以及第 8 步末尾与前文重复的"大模型过滤消息"提醒未收录,完整版见原文。
原文地址:https://x.com/GillTanveer89/status/2114764081978908775