ARTICLE · 1295984
从废料到精品:AI反转五千年冶金铁律,100%废钢炼出更强更韧的铸铁
@
关注下方公众号
获取更多前沿期刊速递
冶金史上有一条写了五千年的铁律:想炼出好金属,先除掉杂质。再生铸造的常规做法是往废钢里掺入30%以上的原生铁(铁矿、焦炭、石灰石)来"稀释"杂质——废钢占比一旦超过70 wt%,强度和塑性会同步不可逆劣化。这篇发表于《Science Advances》的论文干脆把铁律反过来:不提纯合金,而是设计合金去容纳并利用杂质。研究团队提出DAS-DAO框架(Design of Alloys from Scraps using Deep Alloy Optimization),用深度神经网络引导的树搜索,在真实工业产线上用100%废钢设计出系列高性能球墨铸铁——强度最高提升15.2%、延伸率提升73.2%,打破了强度-塑性此消彼长的经典取舍,还把制造成本降了8.1%。
为什么选球墨铸铁?它占全球铸铁消费的28%、年产约1.2亿吨,对杂质容忍度较高,是"脏合金设计"的理想试验田;也正因其成分-工艺-组织耦合复杂,传统热力学与动力学计算在这里常常力不从心。团队把AI的搜索能力直接架在"成分+工艺 → 性能"之上,绕开了对微观组织特征的完全参数化——这是它能落地的关键一步。
该成果以 "From scrap to prime: Designing high-performance alloys from dirty feedstocks with machine learning" 为题刊于 Science Advances。
工作要点
01观念反转:不除杂,而是"用脏"
废钢成分不可预测,Ni、Ti、Al、V等杂质随来源波动。传统路线靠掺原生料稀释或高价提纯,与熵打消耗战。本文给合金装上"废钢兼容基因":把杂质效应整合进有目的的微观组织设计,实现完全可回收。
02双数据集 + 双CNN:330条×2400条
330条再生球铁全流程数据(成分+工艺+组织+性能,来自MES系统)训出"懂工艺"的代理模型,约2400条原生球铁数据训出"懂成分"的复筛模型;两级筛选从海量候选中锁定3~6个配方送实验。含工艺的模型对强度预测误差近乎减半(MSE 189 vs 660)。
03MOPC:把搜索拽向帕累托前沿
不加约束的优化会扎堆在低强度-高塑性的"舒适区"。MOPC用已知帕累托前沿拟合出二次多项式,构造"想象前沿",强制AI沿前沿均匀撒点:数据稀疏区延伸率+73.2%,数据密集区强度+9.0%~13.9%——对数据不均衡天然稳健。
04实验硬验证:17个配方14个突破
AI设计的17个合金中14个显著超越旧帕累托前沿。对照实验设计精巧:只改成分(DAO1-C)或只改工艺(DAO1-P)都不如原配方——证明成分与工艺必须"组合拳"式协同优化。
05机理到产线:杂质变成强化相
三重强化:Si/Cu固溶强化约148.3 MPa、Cu富集纳米析出Orowan强化114~152 MPa、更细更圆更密的石墨+珠光体比例调控。数字孪生产线(参数偏差<2%)在徐工精密落地:成本645→592美元/吨,回收率70%→100%。
SECTION 01
废钢之"脏":为什么100%回收料这么难
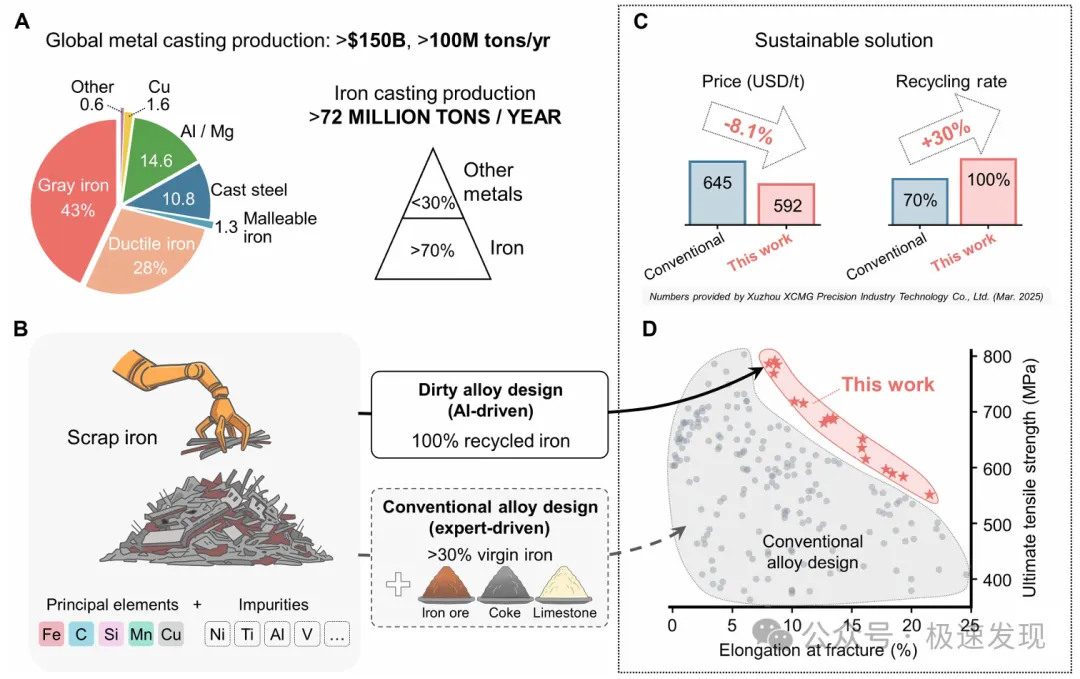
FIG. 1|全球铸造产量超1亿吨/年、产值超1500亿美元;AI设计用100%废钢,成本降8.1%、回收率提至100%
先把问题讲透:全球金属生产每年采矿超30亿吨,贡献约40%的工业温室气体排放和10%的全球能耗;回收金属产量预计2030年超过原生金属,100%废钢冶炼将是可持续冶金的关键战场。但废钢是化学上"脏"的混合物——主量元素(Fe、C、Si、Mn、Cu)之外,还混着随来源波动的Ni、Ti、Al、V等杂质,它们通常使材料脆化。行业默认解法是"暴力稀释":掺30%以上原生铁把杂质浓度压下去,代价是废钢利用率受限、组织设计自由度受限、成本与减碳优势被吞噬。
DAS-DAO的破局思路有两条:其一,承认杂质如果管理得当反而可能增强性能(后文的纳米析出强化就是证据);其二,不追求对微观组织每个参数的完全刻画,而是让AI直接学习"成分+工艺 → 性能"的统计稳健关联——正如作者所言,DAS-DAO不寻找新的物理定律,而是在天文数字的可能性中高效找出最优解。
SECTION 02
DAS-DAO框架:数据、代理、树搜索的闭环
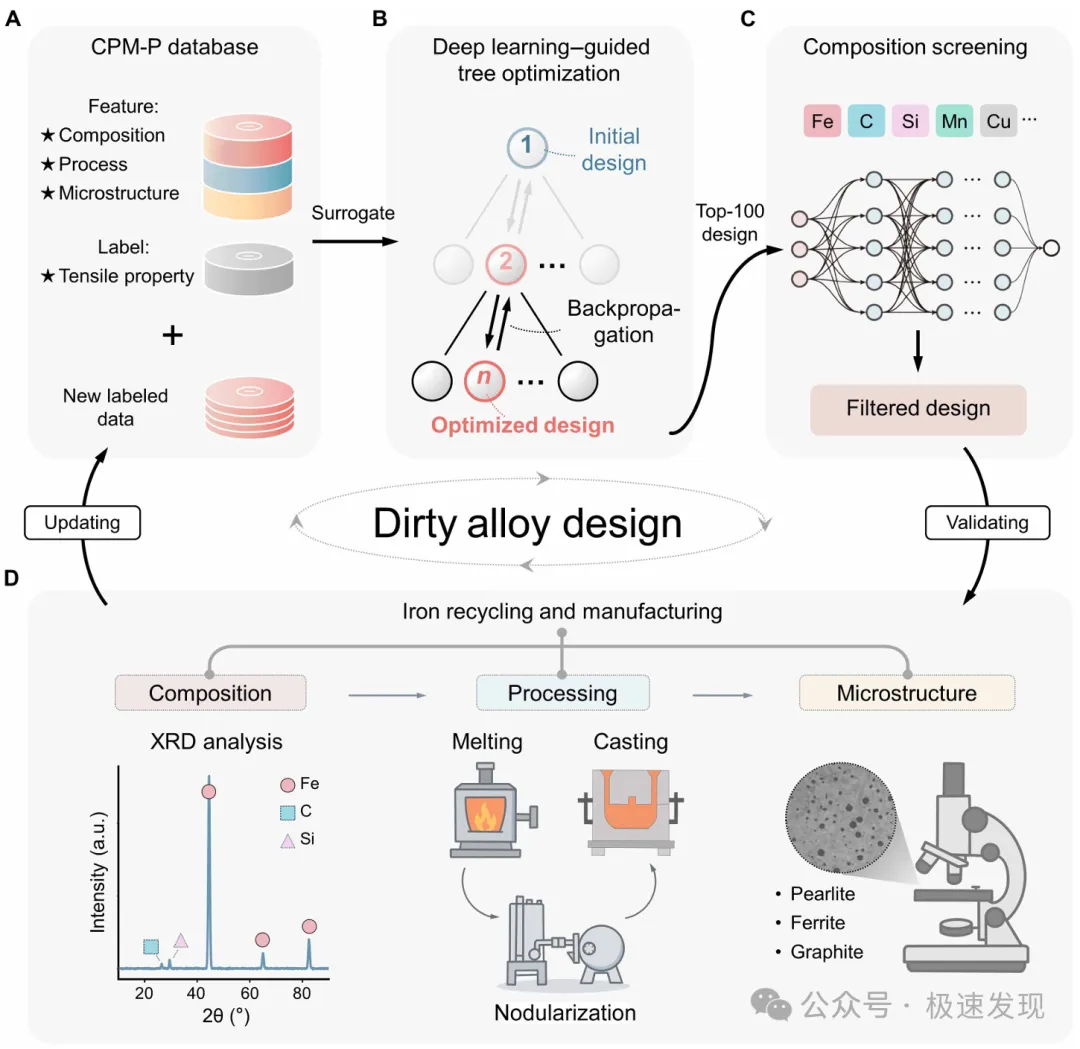
FIG. 2|数据库→树优化→成分筛选→回收制造,四步闭环、持续自我更新
框架的地基是两份数据集:CPM-P数据集——330条再生球墨铸铁的全流程数据,涵盖化学成分、5项可控工艺参数(出炉温度T₁、始浇温度T₂、球化时间t₁、孕育时间t₂、浇注时间t₃)外加11项砂型参数、组织特征(珠光体分数、石墨球化率、铁素体分数)与拉伸性能,全部经制造执行系统(MES)采集;C-P数据集——约2400条原生球铁的成分-性能数据,成分覆盖更广。
代理模型是"双CNN接力":第一个CNN基于CPM-P训练,输入10个设计变量(4种主元素+5项工艺+珠光体分数),给出初始排序筛出Top 100;第二个CNN基于更大的C-P库复筛至Top 50,最终每轮选3~6个合金做实验验证。一个关键发现:含工艺与组织信息的CPM-P模型对强度预测明显更准(MSE 189、MAPE 2.49%,对比只用成分的660、3.16%)——工艺不是配角,省略工艺等于扔掉一半信息。搜索层用随机突变(单步微调/单点突变/多点缩放,各占1/3概率)扩展树节点,以数据驱动置信上界DUCB(v_ML + 0.05×c(ρ)×√(2logN/(n+1)))平衡"利用已知好区"与"探索未知区域",每轮实验数据回灌训练,闭环自我纠错。
SECTION 03
MOPC:给优化装上"帕累托导航"
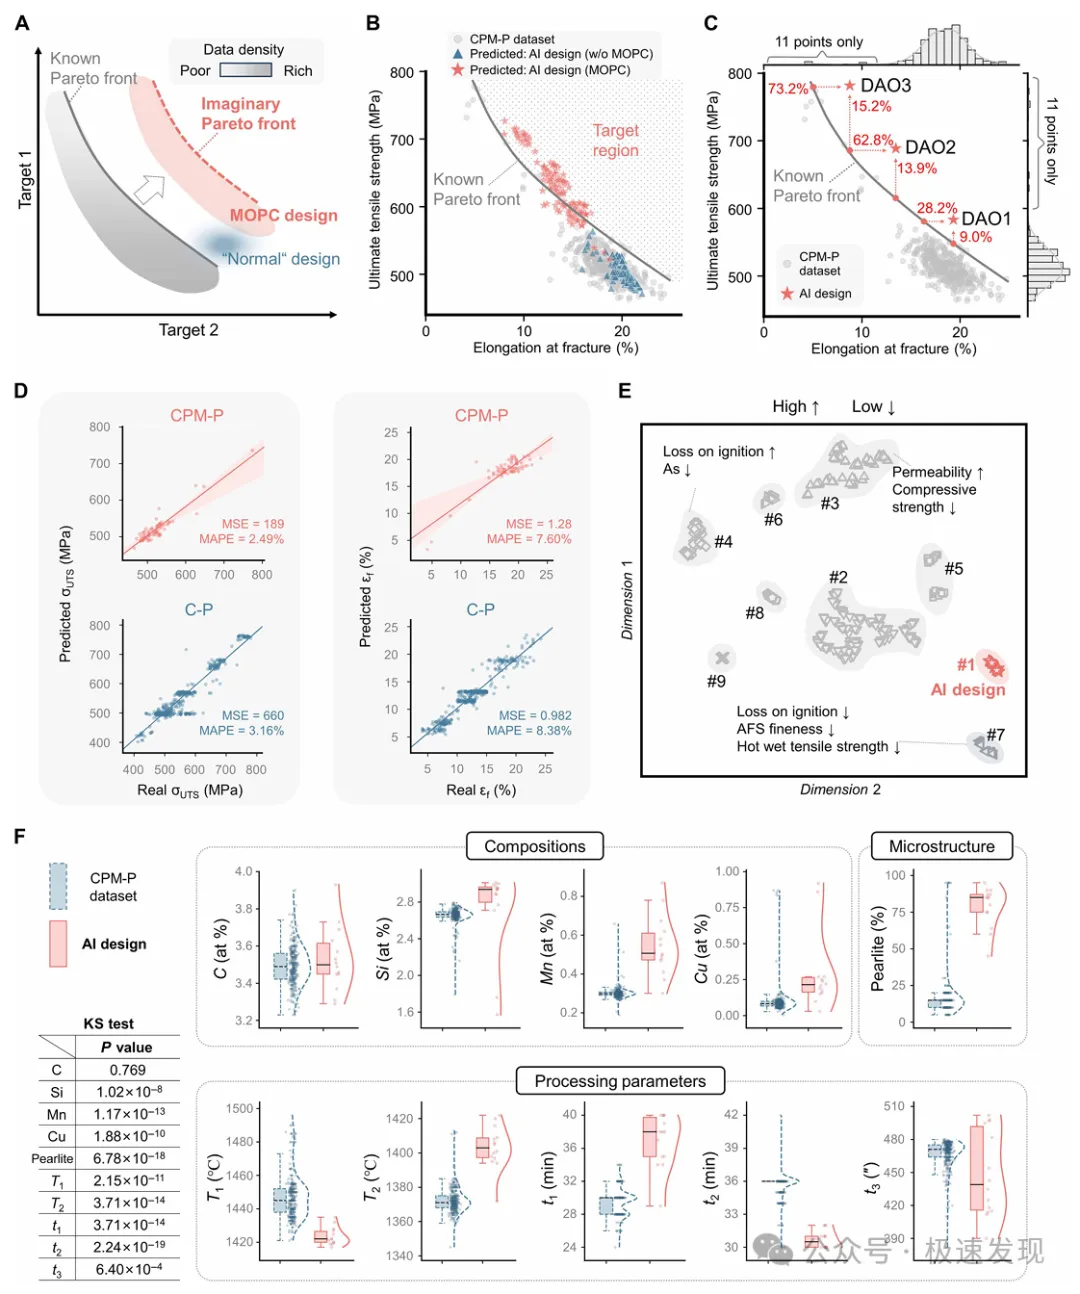 | 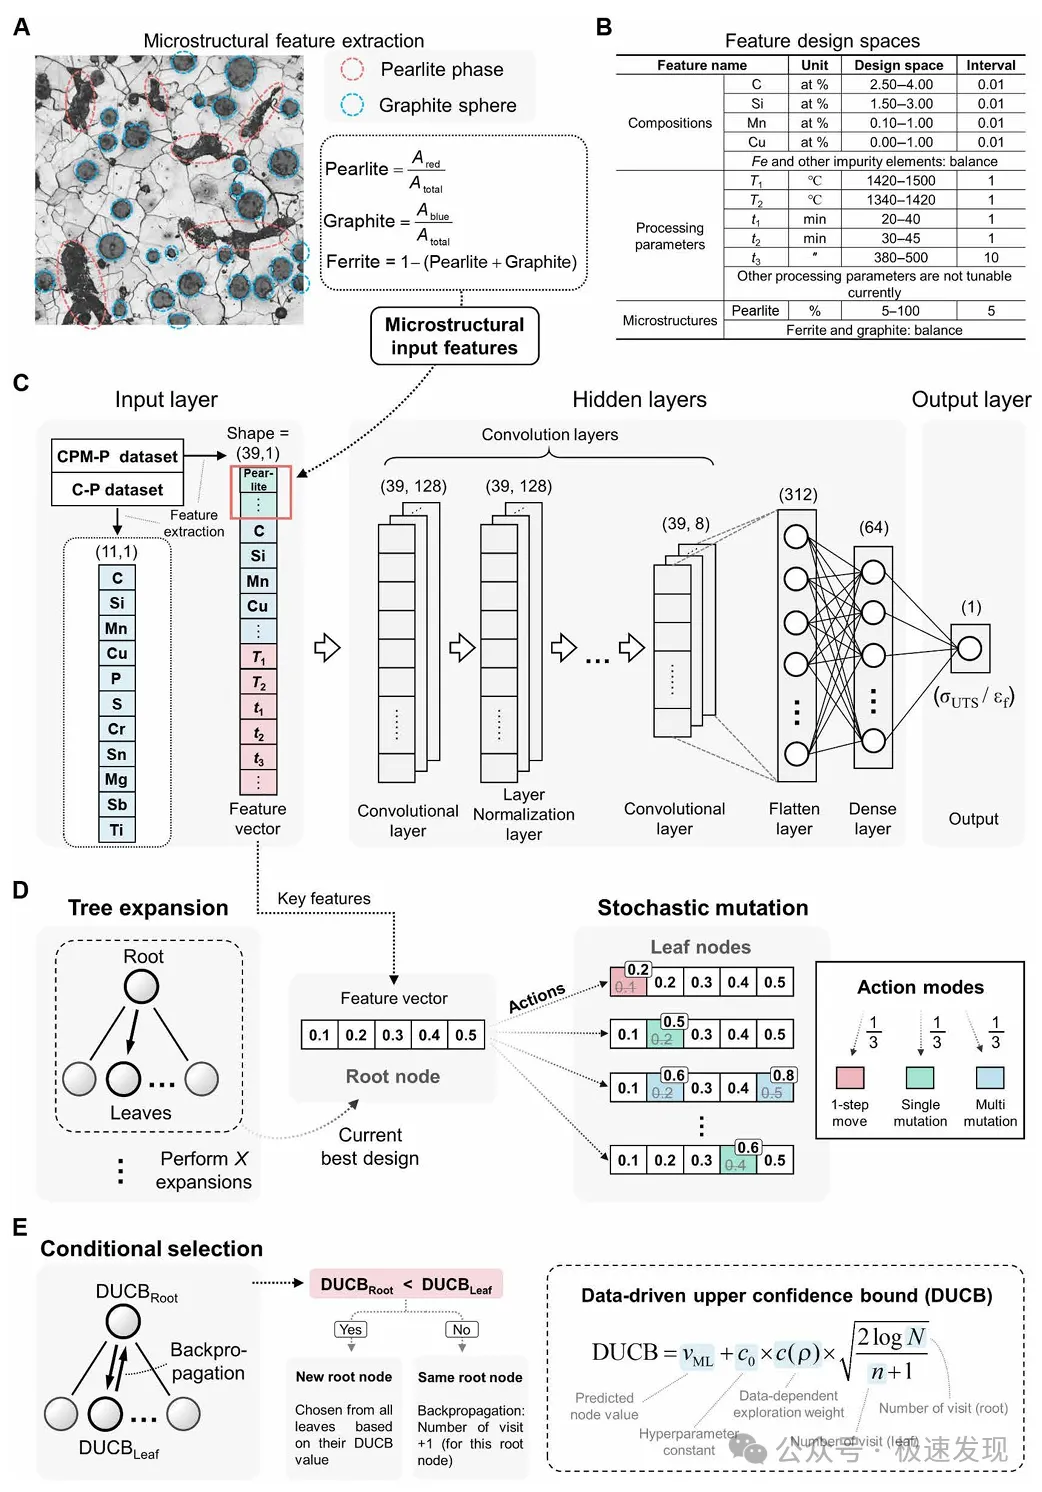 |
FIG. 3 & 7|想象帕累托前沿引导设计;DAO1在数据稀疏区延伸率提升73.2%
多目标优化有个经典陷阱:强度和塑性往往此消彼长(如NbVTaSi中熵合金强度高达2.6 GPa、延伸率却不足1%)。若简单以σUTS×εf为目标,AI生成的设计会扎堆在低强度-高塑性的"舒适区"——那里数据多、预测有把握。团队为此提出带帕累托前沿约束的多性能目标(MOPC):先用CPM-P数据拟合已知帕累托前沿的二次多项式(ε = 0.01518σ² − 2.577σ + 113.7),再构造一条"想象帕累托前沿",把目标函数改写为预测延伸率与前缘延伸率之比,强制算法沿前沿均匀撒点,而不是死磕某个角落。这个目标函数比"划定固定目标区域"的方法计算上更便宜。
结果直观:无MOPC时AI设计聚在原分布附近;有MOPC时设计均匀铺满整个前沿,实验验证在数据稀疏区实现延伸率+73.2%/62.8%(DAO3/DAO2方向),在数据密集区实现强度+9.0%/13.9%(DAO1/DAO2方向)——在数据多和数据少的地方都赢,说明方法对数据不均衡天然稳健。对神经网络外推可靠性的疑虑,团队也做了系统评估:外推区误差确实更大,但有界且不破坏帕累托排序,且每轮实验回灌会持续缩小外推差距。最终选出的17个AI设计合金中,14个显著超越旧帕累托前沿。
SECTION 04
对照实验:成分与工艺必须打"组合拳"
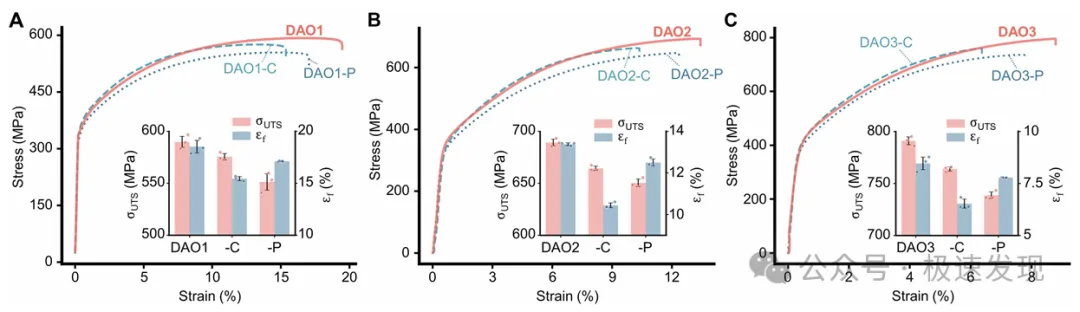
FIG. 6|DAO1:589.9 MPa/18.53%;DAO2:689.3 MPa/13.39%;DAO3:791.1 MPa/8.47%,全面优于对照
这组实验设计堪称消融研究的范本。以DAO1为例,团队制备了两个"半改"对照:DAO1-C——工艺参数完全不变,成分改为数据集中位数;DAO1-P——成分完全不变,工艺参数改为中位数。结果DAO1在强度(589.9 MPa)和延伸率(18.53%)上都同时压过DAO1-C(575.5 MPa/15.45%)和DAO1-P(551.3 MPa/17.11%)。DAO2、DAO3重复同样规律。结论清晰:单改成分或单改工艺都不行,AI的价值正在于协同搜索这两个耦合维度。而两个表现不及预期的配方,经系统对比也被定位为偏离了优化窗口的若干关键参数——失败同样转化为了设计知识。
统计上,AI设计也确实"另起炉灶":KS检验表明除碳元素外,AI设计在几乎所有设计维度上的分布都与人类专家数据显著不同;UMAP降维可视化中,DAS-DAO设计自成一簇、与九个专家设计簇明显分离。
SECTION 05
机理透视:杂质如何被"点废成金"
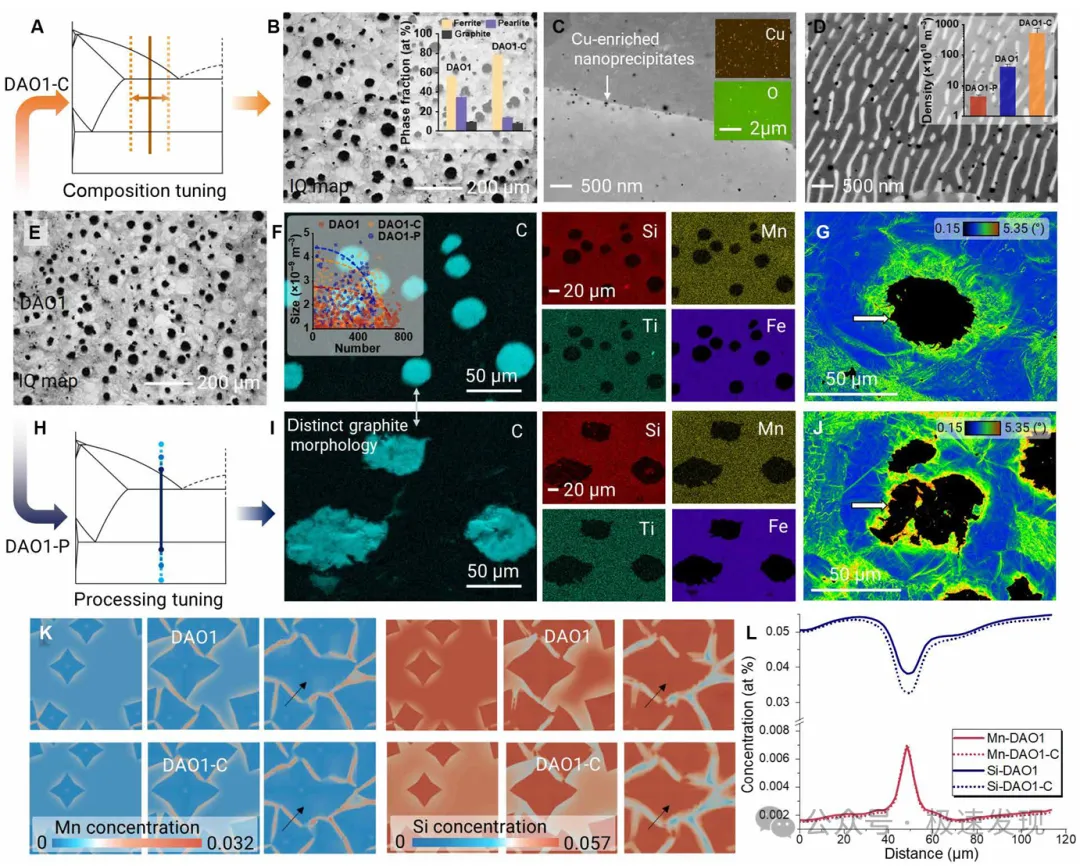 | 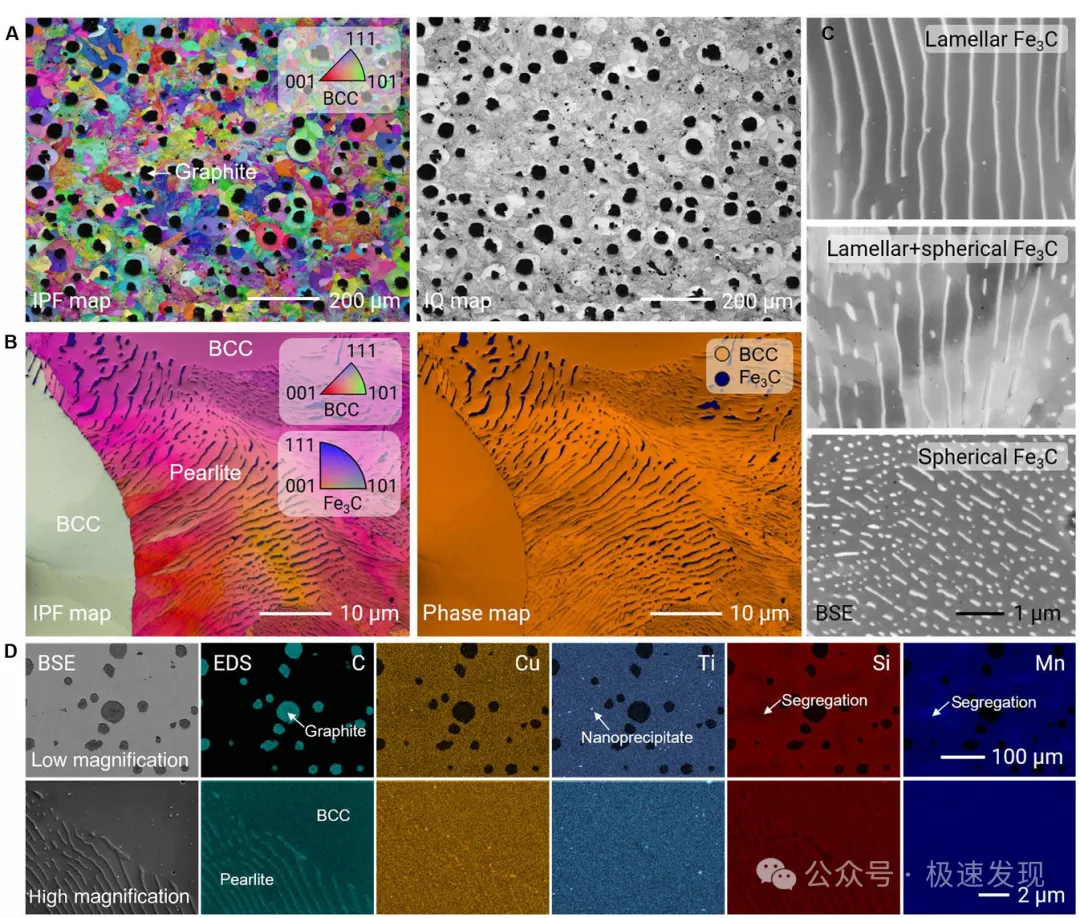 |
FIG. 4–5|Cu富集纳米析出钉扎位错;更细更圆更密的石墨+梯度珠光体协同强化
表征把强化机制拆成三层。固溶强化:DAO1铁素体中Si(5.7 at%)和Cu(0.3 at%)浓度高于对照,贡献约148.3 MPa;同时Si被控制在4.3 wt%以下,避免Fe-Si长程序化引发的脆化。纳米析出强化:100%废钢带入的多种微量杂质元素促成四类纳米析出相,其中Cu、O富集的近球形纳米颗粒与基体非共格,构成不可剪切钉扎点,Orowan强化贡献约114~152 MPa。有意思的是反面教材:DAO1-C中纳米颗粒数密度反而高出两个数量级,但偏聚于晶界与相界附近,成为微裂纹优先形核点——强化看的不是"有多少",而是"在哪、怎么分布"。
组织调控:DAO1的石墨相含量更高(13.2% vs 专家设计的12.5%)、平均尺寸更细(21.25 μm vs 23.81 μm)、数密度更高(292.8 mm⁻² vs 234.1 mm⁻²);珠光体/铁素体比0.62,远高于商业QT450的0.30;珠光体片层间距196 nm,落在文献最优区间。断口附近的KAM分析显示DAO1局部取向差约3.3°,而只改工艺的DAO1-P高达5.1%——应变局域化程度高54.5%,裂纹更早萌生。凝固速率是幕后推手:快凝促进高过冷度、石墨均匀形核;慢凝延长液相停留、引发多元素共偏聚、球化退化。这些跨尺度的组织差异,正是人类专家难以凭经验同时调优的部分。
SECTION 06
从配方到产线:设计准则与数字孪生落地
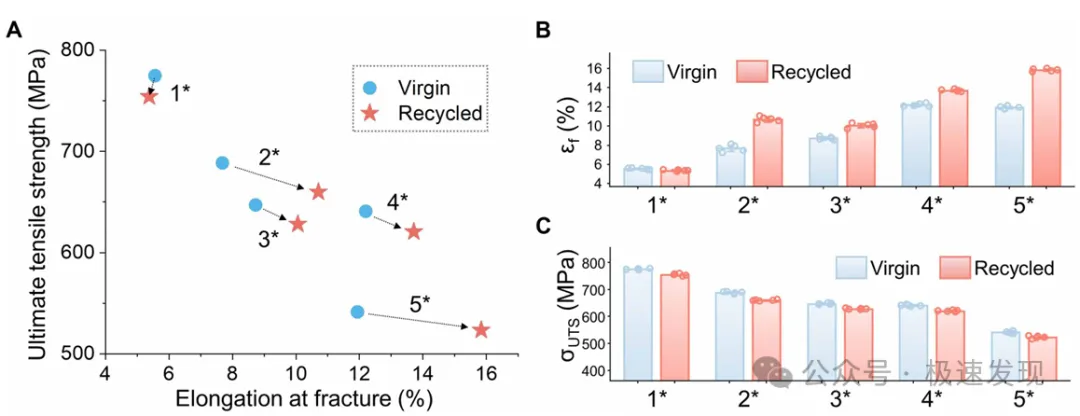 |
FIG. 8–9|珠光体是最强特征(强度贡献43.4%);相同成分工艺下再生料塑性普遍更高
SHAP归因给出了模型的可解释性答案:珠光体分数是对强度和塑性影响最大的特征(贡献分别达43.4%和34.4%),其后依次是球化时间t₁、Cu、Mn、Si。基于对失败配方的系统分析,团队还提炼出一份"避坑指南":碳应大于3.2 wt%,否则珠光体形成与石墨球化受限;出炉温度T₁不宜超过1435℃,高温延长液相停留、促使多元素共偏聚毁掉石墨形态;球化时间t₁应不低于30分钟;硅保持在2.0~3.0 wt%区间;铜不低于0.15 wt%以保证纳米析出强化。每一条都直接来自"低性能组 vs 优化组"的统计对比,且与物理冶金原理自洽。
更难得的是这不是纸面研究:所有合金都在徐州徐工精密的自动化铸造产线上生产——数字孪生系统通过工业物联网传感器全程调控(10 Hz采样、虚实同步延迟小于0.5秒、参数偏差小于2%),QR码批次标识实现从原料成分到最终性能的全流程追溯,在线直读光谱仪+质量平衡计算完成废钢配比。结果:制造成本从645降至592美元/吨(-8.1%),回收率从70%提升至100%。团队还做了五组"孪生对照":成分与工艺几乎相同的原生料和再生料对打,再生料的延伸率普遍更高、强度略低——杂质并非只有害处,这为"脏合金设计"提供了直觉注脚。
SECTION 07
边界与展望:第三范式的适用清单
DAS-DAO的四大可迁移组件
① 精心策展的CPM-P数据集;② CNN代理模型;③ 树搜索优化器;④ 带帕累托前沿约束的多性能目标(MOPC)。原则上适用于任何能采集成分-工艺-性能数据的合金体系,优先目标是钢、铝合金、铜合金等再生密集型结构金属。
作者同时如实划出边界:代理模型的精度取决于训练数据的数量与代表性,迁移到新体系需要数据积累;"脏合金"概念最适用于杂质可冶金化管理的工程合金,对半导体、部分生物植入物等超高纯体系并不直接适用。另一个深刻观察是:成分-组织-性能关系并非严格一一对应,不同成分-工艺组合可能收敛到相似组织——但DAS-DAO捕捉的正是统计稳健关联,非唯一性不损害可靠性,反而提供了通往目标性能的多条可行路径,增强了设计柔性。
定位上,作者把AI驱动方法视为继传统实验、模拟仿真之后的球墨铸铁设计"第三范式":不是替代实验与模拟,而是与之互补——在概念框架、实验空间或物理框架内可能组合呈天文数字时,用AI bypass"逐一量化每个组织参数"的不可能任务,直接把成分与工艺连到性能。对资源约束的未来,这是把合金设计从"经验试错"推向"智能设计"、并推进金属大规模保守循环经济的一步。
结论
这篇论文的分量在于"全链条打通":观念上反转五千年提纯铁律,方法上用双数据集+双CNN+MOPC解决了"数据稀缺、分布不均、多目标取舍"三重难题,机理上证明杂质可以被整合进有目的的微观组织,工程上在真实产线用100%废钢做出降本增效的合格产品。对材料界,它示范了"实验-数据-AI-产线"闭环的完整样本;对产业界,废钢不再是需要被稀释的负担,而是可以被设计的资源。
边界说明:模型精度依赖训练数据量与代表性;17个设计合金中仍有2个未达预期(已被转化为避坑准则);成本数据由企业(徐工精密,2025年3月)提供;框架对超高纯依赖体系不适用。论文数据与代码已在Zenodo与GitHub开源。
本文链接
论文:Chao Yang, Bo Peng, Binhan Sun, et al. From scrap to prime: Designing high-performance alloys from dirty feedstocks with machine learning. Science Advances, 2026, 12(42): eaeg9183.
DOI:https://doi.org/10.1126/sciadv.aeg9183
开源代码与数据:GitHub github.com/Bop2000/DAS-DAO;Zenodo doi.org/10.5281/zenodo.21613930

科研云

线上直播/精品课程
资讯追踪/期刊速递/科研工具