ARTICLE · 1300180
【周二见·AI+教育论文解读】点亮火花:大语言模型如何赋能资源不足的中国高中生重新想象英语写作
AI + 教育论文解读 · 每周更新
点亮火花:大语言模型如何赋能资源不足的中国高中生重新想象英语写作
主题B · AI 教学应用与智能助教 · 2026-10-20
论文名片 · CITATION
Lighting the spark: How LLMs empower underprivileged Chinese high school students to reimagine EFL writing
Xinyu Ma(马来西亚国立大学教育学院)、Deliang Wang、Gaowei Chen(香港大学教育学院)
作者机构:Xinyu Ma(马来西亚国立大学教育学院)、Deliang Wang、Gaowei Chen(香港大学教育学院)
发表期刊:The Journal of Educational Research(T&F,SSCI),2026 年 8 月 12 日在线
关键词:LLM;英语写作;高中;教育公平;反馈采纳
在一所资源吃紧的高中,当学校引入一个能随时调用的 AI 工具,来补上老师做不过来的写作反馈,学生身上会发生什么变化。
论文把出发点定在教育公平上。中国县域高中的英语写作教学,长期面临一个具体困难:写作需要密集的、针对每篇作文的个别化反馈,而一个老师要带好几个班、还要处理行政事务,这部分作业的评价反馈很难稳定给到每位学生。作者引用反馈研究里一条被反复验证的结论——学生拿到针对具体错误的反馈后,会做出有针对性的修改,写作质量可测量地提升。也就是说,反馈量本身直接影响教学效果。
研究者发现既有 AI 写作反馈研究的实证基础,几乎全部来自大学环境。县域高中的学生英语基础更弱、AI 素养近乎空白、教师负担更重,AI 在那里还能不能起作用,没人验证过。论文提出三个研究空白:中学阶段尤其是资源不足地区缺少实证;反馈供给增加之后学习过程如何变化少有追踪;引入 AI 后学生会不会因为反馈太容易反而放弃深入思考。
作者没有把问题设成“AI 反馈和教师反馈哪个更好”。他们更关注:当AI补上评价反馈的缺口之后,学生的行为、心理、元认知三个层面各自发生了什么变化,哪些旧问题被缓解,哪些新问题冒出来。
研究在东北一所三年制县域高中进行。当地经济总量位居全国末位,财政能力有限。参与的是两个完整建制的高二班,由同一名英语教师任教,期中考写作分数没有显著差异。
两个班通过程序脚本随机分配:实验组 22 人(8 名男生、14 名女生,平均年龄 18.86),对照组 24 人(7 名男生、17 名女生,平均年龄 18.33)。随机分配加上同师同教材,是为了排除教师差异带来的干扰。
干预持续九周。第 1 周填基线问卷并收集期中考写作分数作为前测;第 2 至 7 周是两个“写作—反馈—修改”循环,每个循环学生在规定时间内独立完成约 150 词的作文,模拟考场条件;第 8 周期末考,后测写作没有反馈可用;第 9 周访谈 10 名实验组学生。
写作任务全部取自此前已学过的教材单元,主题包括“健康生活方式”“城市规划”。这样安排是为了排除话题不熟悉这个干扰项——学生具备完成所需的背景知识与词汇,这样测的才是评价反馈本身的作用。
两组的反馈机制不同。实验组在机房由教师监督访问 DeepSeek,输入草稿拿实时反馈。生成反馈的首条提示词由研究者设计,要求从内容、组织、语言使用三个维度给建议,用中文书写,并且不直接给修改后的范文。用中文给反馈有三条理由:学生英语水平有限,全英文反馈他们用不了;第一语言反馈是他们本地教学的标准做法;有研究支持 L1 反馈有助这一水平的学习者理解复杂的修改点。首轮交互限制学生改参数,保证起点一致,之后解除限制。
对照组由两位教师给反馈,其中一位教同一学段超过五年。两位教师知道研究里有两种反馈条件,但不知道实验组用了什么工具和怎么操作,为的是避免偏差。他们先各自独立审阅初稿,再讨论达成共识后给出最终评语,评语同样覆盖内容、组织、语言三个方面。不使用统一模板,是为了保留反馈的自然性;两人协作,是为了保证非标准化反馈的可靠性。
反馈之后,两组都在课堂上用 Word 的修订功能改自己的作文。所有学生必须提交修改后的电子版。写作练习在期末总评中占比不到 10%——这样设计是为了不让参与度和成绩挂钩,学生不会为了分数去应付修改。
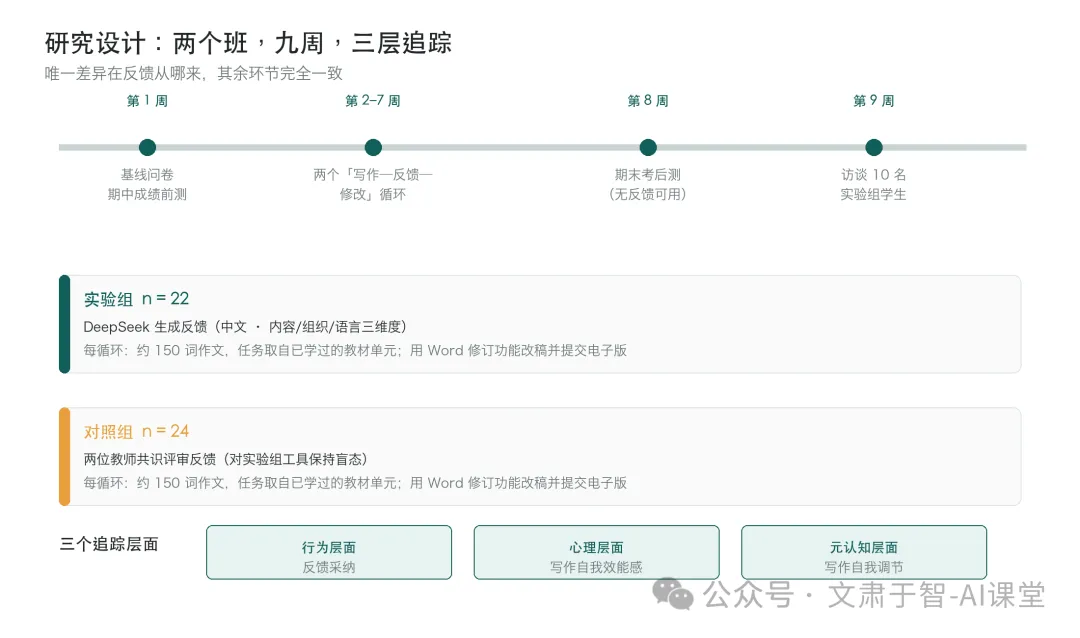 图一 研究设计:两个班,九周,三层追踪
配图追问:
两个班只差在反馈从哪来,其余环节完全一致——这九周的对比里,哪些差异才可能归到 AI 头上?*
数字来自三处。反馈采纳的编码覆盖两个班全部修改后的作文(其中 6 篇先用于编码练习);写作表现、写作自我效能感、写作自我调节三项,用的是第 8 周期末考后的后测数据,前测分数作为协变量做协方差分析;访谈数据来自实验组 10 名学生。
反馈量上,DeepSeek 生成的可执行反馈单元中位数是 10(极差 8–15),教师反馈是 8(极差 6–10),差异显著(z = −4.258,p < 0.001)。成功采纳的次数中位数 5 次对 2.5 次(z = −4.148,p < 0.001)。
两组反馈量不同,所以按比例看更有信息量。成功采纳的中位比例,实验组 0.481 对照组 0.333(z = −3.099,p < 0.001);未成功采纳 0.000 对 0.125(z = −2.384,p < 0.05);未尝试采纳 0.375 对 0.500(z = −2.814,p < 0.01)。部分采纳的比例两组没有显著差异(z = −1.321)——这是四类采纳行为中唯一没有出现组间差异的一类。
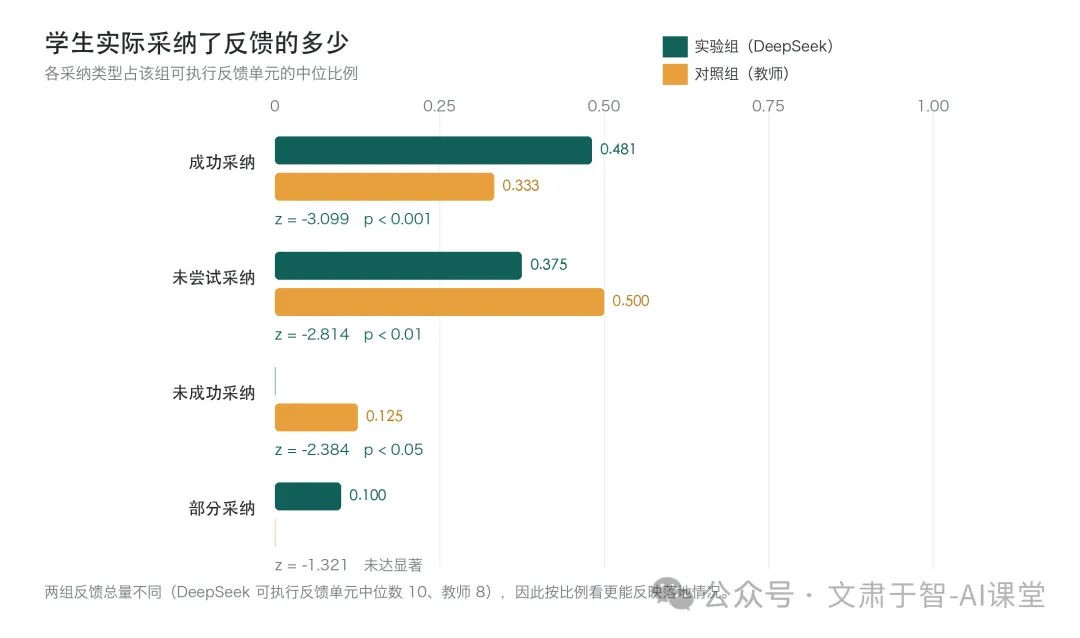 图二 学生实际采纳了反馈的多少
图片内容:
横向条形图,四行分别是成功采纳、未尝试采纳、未成功采纳、部分采纳;每行两条,深青为实验组(DeepSeek)、暖橙为对照组(教师);条形右端标出中位比例数值,行下方标出 Mann–Whitney 检验的 z 值与 p 值。
配图追问:
成功采纳的比例升上去的同时,未尝试采纳的比例降下来——AI 补上的反馈,是被学生用掉了,还是只是让他们少放弃了?*
图二把这四类放在一起看。成功采纳一栏两组差距最明显,未尝试采纳一栏则是对照组更高。两个数字方向相反:实验组的学生动手改的次数没少,未成功采纳的比例也降到 0.000,改对的比例随之升上去。
后测写作满分 100 分,实验组调整后均值 89.388 分,对照组 85.686 分,相差约 3.7 分(F = 20.072,p < 0.001,偏效应量 0.318)。写作自我效能感是 6 级李克特量表,实验组调整后均值 4.712 分,对照组 3.573 分,差 1.14 分,接近一个等级差(F = 38.319,p < 0.001,偏效应量 0.417)。写作自我调节同样是 6 级量表,实验组调整后均值 4.875 分,对照组 3.268 分,差 1.61 分(F = 59.159,p < 0.001,偏效应量 0.579)。偏效应量的取值范围是 0 至 1,0.14 是学界惯用的大效应分界,这三项都超过它,写作自我调节的 0.579 最强。三项前测基线均无显著差异。
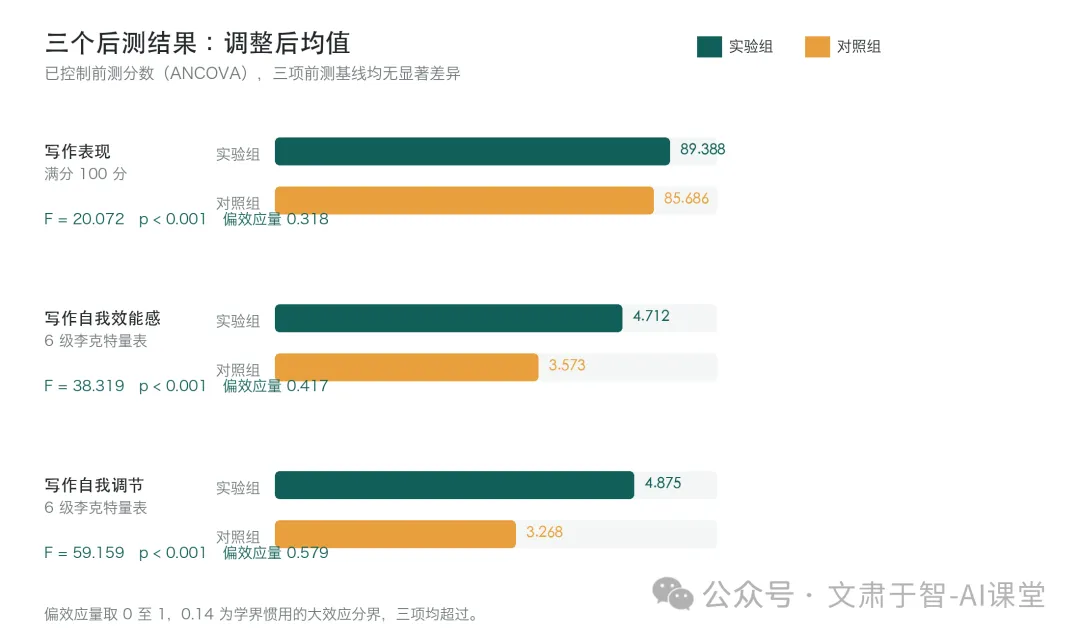
图三 三个后测结果:调整后均值
图片内容:
三组横向条形图,分别是写作表现(满分 100 分)、写作自我效能感(6 级量表)、写作自我调节(6 级量表);每组两条,深青为实验组、暖橙为对照组,条形右端标出调整后均值,组下方标出 F 值、p 值与偏效应量。
配图追问:
三根条形的差距看起来差不多,但后两个指标的效应量明显更大——是因为量表本身差距更大,还是因为写作分数本来就接近满分、压缩了上升空间?*
图三里效应量的排序是自我调节最高、自我效能感次之、写作表现最低。三个指标的口径不同:写作分是百分制,实验组调整后均值已到 89.388 分,接近上限;两个自我效能量表是 6 级,实验组分别是 4.712 和 4.875,都还在量程中段。论文没有解释这一排序,成稿也不替它解释。
论文把机制定位到反馈的形态上。基线课堂里老师给的评语常是“润色这一段”“把论证再展开些”这类高推断性说法,教学法上没错,但学生得自己判断到底要改什么、怎么改,对写作水平有限的学生就是一道坎。AI 生成的反馈更具体、更能直接执行——给出具体的替换词、句子层面的重组方案。论文由此提出一个更窄的判断:资源不足课堂的问题不只是反馈少,而是给出的反馈对最需要它的学生来说更没法执行。
访谈里学生自述的交互过程是“提问—追问—采纳”:遇到不懂的建议就反复问,问到懂了再改。有一位学生说,DeepSeek 本质上是个“资源库”,以前查词得翻词典再搜范文,那些材料不解释,最后还是得自己总结。
还有几个问题没有被解决。AI 补上的那部分反馈天然偏向表层语言问题,深层结构反馈——让学生重新思考论证、重组推理——仍主要靠老师。资源差距被缩小了,但远未弥合。写作增益能否在撤走工具后持续、自我效能感能否内化成独立能力,都是开放问题。
教师视角。
反馈的“可执行性”是一个独立于数量的指标。同样一句“润色这一段”,对水平有限的学生等于没有反馈。这篇论文提供了一套可复用的编码框架,把学生的修改分成成功、部分、未成功、未尝试四类,其中把“表面化修改”(只分段却没给出主旨)单列为未成功,与真实的“部分采纳”区分开。教师想知道自己给的反馈有没有落地,可以按这套分类回看自己的评语。
学校与教研视角。
论文的分工模型值得讨论:让 AI 承担高频、表层的诊断性反馈,迅速建立学生信心,把教师解放出来做深度结构协商、文化情境化和情感支持。论文自己说明这个整合模型没有经过实证检验,属于理论上有前景的方向。
实践者视角。
反馈用第一语言给,是论文里一条可迁移的操作细节。学生的英语水平有限时,全英文反馈本身就构成使用障碍。
家长视角。
这篇论文没有研究家长场景。家长从论文逻辑往外延伸的用法是:孩子用 AI 改作文时,“用了没有”其实问不到点上;孩子有没有在追问和判断,才是能留意的信号——论文记录的那些“AI 自己在打自己脸”“越改越没完没了”的情况都属于这一类。
论文自述了四条局限。没有延迟后测,现有发现主要反映即时增益,长期保持性有待证实;两个条件在反馈量、覆盖深度、认知复杂度上本就存在差异,作者承认这在统计上可以视为混淆变量,反馈质量的净效应难以与高可得性完全剥离;样本来自单一地区且工具新颖,无法排除霍桑效应;访谈还发现部分学生在时间压力下跳过主动思考直接采纳建议,可能削弱自我监控。
论文给研究者留的方向包括:用控制反馈量与认知复杂度的设计,隔离出 AI 反馈质量本身的净效应;探索人机协同模型;从公平视角看,研究应优先以资源不足情境为中心,用更大规模的跨区域样本并纳入纵向追踪。
给实践者的起点有两个。一是把“反馈是否可执行”做成一节自评:拿到一条学生改不动的反馈,先判断是内容没讲清还是学生不知道从哪下手。二是用四类采纳编码做一次抽样回看,20 篇作文足够看出反馈的落点集中在哪一层。
在一个反馈长期给不够的高中,AI 补上的主要是数量和表层语言问题,写作分数、写作信心和自我调节能力都随之上升,但深度反馈和独立判断仍然留在老师手里。
本文是对 Ma, Wang & Chen (2026) 发表在 The Journal of Educational Research 的论文的中文解读,DOI 10.1080/00220671.2026.2710208。数据与结论均取自原文,解读部分为本文作者观点。