ARTICLE · 1307482
医疗AI的“肯尼亚实验”:当大语言模型走进真实诊室,我们该担心什么?
在医疗AI的宏大叙事中,大语言模型(LLM)常被描绘为无所不知的超级医生,能够瞬间填补医疗资源的鸿沟。然而,当这些模型走出实验室,真正嵌入到资源受限地区的诊疗流程中时,它们表现究竟如何?是救命良药,还是潜在风险?
近期,发表于《Nature Health》的一项重磅研究,通过在肯尼亚16家诊所的真实世界压力测试,为我们揭示了医疗AI落地的复杂真相[1]。
来源:Nature
真实世界的压力测试
长期以来,关于LLM在医疗领域的研究大多集中在刷榜——即在标准化的医学考试或模拟案例中表现优异。但这项研究不同,它聚焦于肯尼亚内罗毕和基安布县的16家基层诊所,评估了嵌入电子病历系统的LLM(基于GPT-4o)在三个月内的实际表现。
研究团队邀请了一组资深医生,对1469份真实的门诊记录进行了严苛的回顾性评估。这不仅是一次技术测试,更是一场关于医疗质量、安全与人机协作的深度复盘。
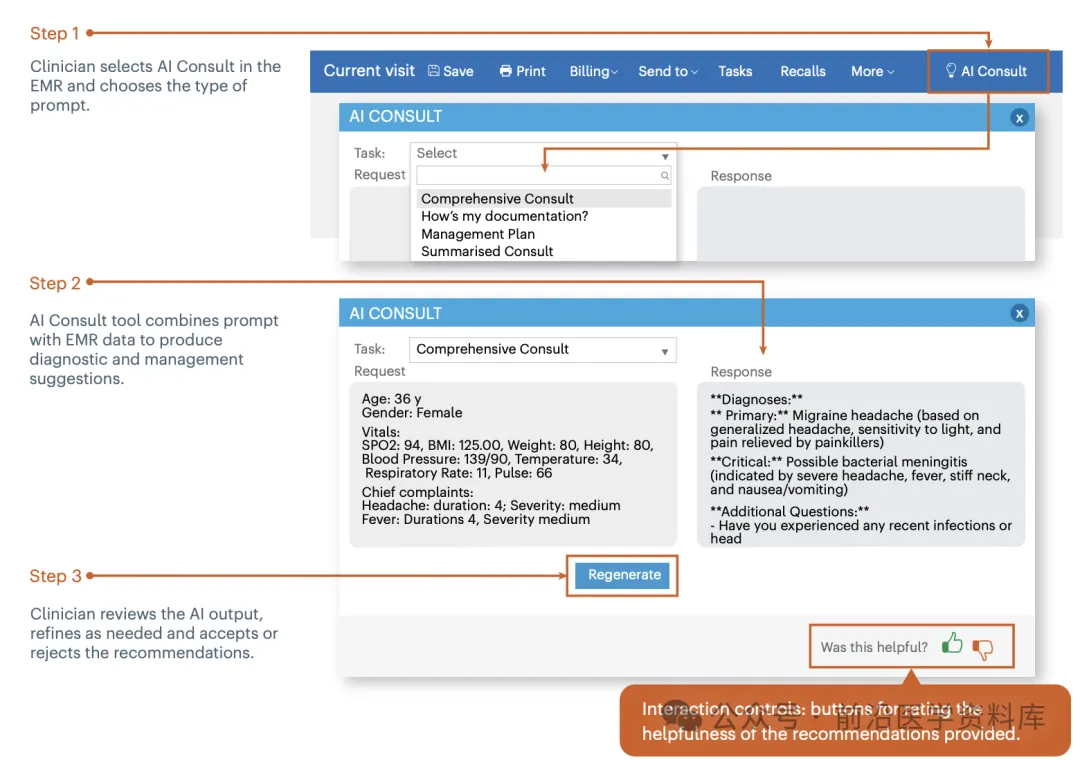
来源:Nature
低幻觉率与高符合率
研究结果首先给出了令人振奋的信号。在过去,人们最担心AI的幻觉问题(即一本正经地胡说八道)。但在这次真实场景测试中仅在3.4%的案例中出现了幻觉,且大多只是缩写误用或药物名称的微小偏差。不仅如此,在99%的案例中,AI给出的临床管理建议与当地医疗指南完全一致。
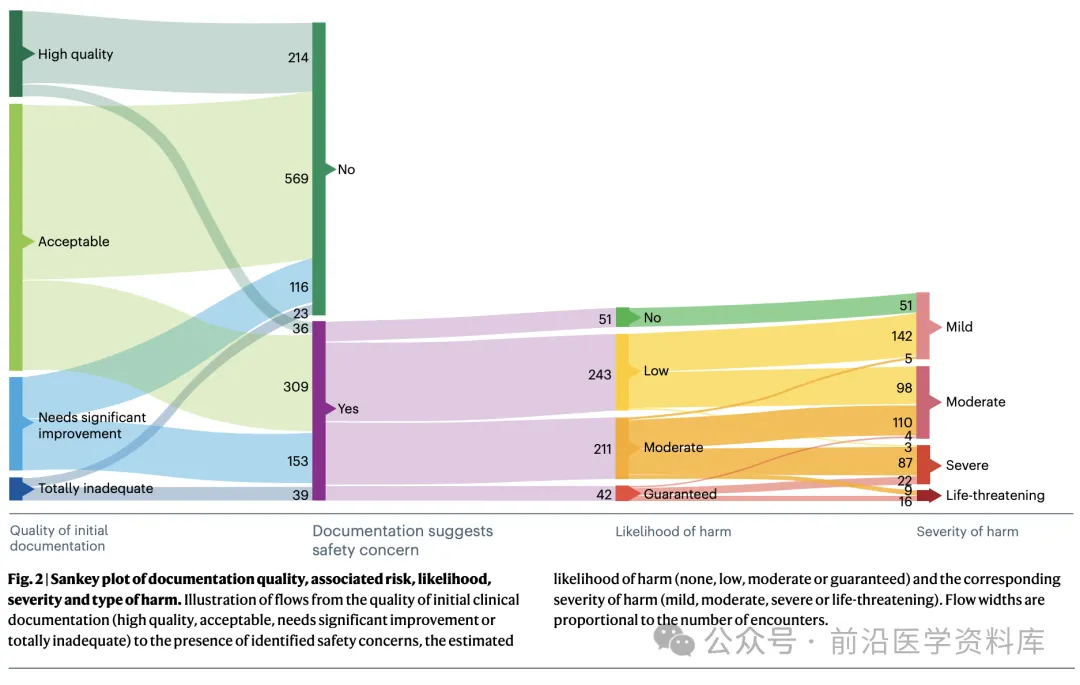
来源:Nature
这意味着,在知识储备和逻辑推理层面,顶尖的LLM已经具备了提供高质量、标准化医疗建议的能力,甚至在某些情况下能够充当基层医生的数字化导师。
纠错能力与有害建议的并存
然而,研究最核心的发现隐藏在安全性的博弈之中。AI在提升医疗质量的同时,也带来了难以忽视的风险:安全评估发现,LLM在7.8%的案例中给出了具有潜在伤害性的建议。与此同时,它也成功识别并纠正了8.0%医生初始记录中存在的医疗风险。
这是一个极具冲击力的结论:AI既是救火队员,也可能是纵火者。更令人担忧的是,研究观察到一种“非对称采纳”现象——医生有时会盲目采纳AI给出的错误建议,却可能忽略AI给出的正确纠错。在那些AI给出有害建议的案例中,有超过一半(67例)最终出现在了医生的正式病历中。
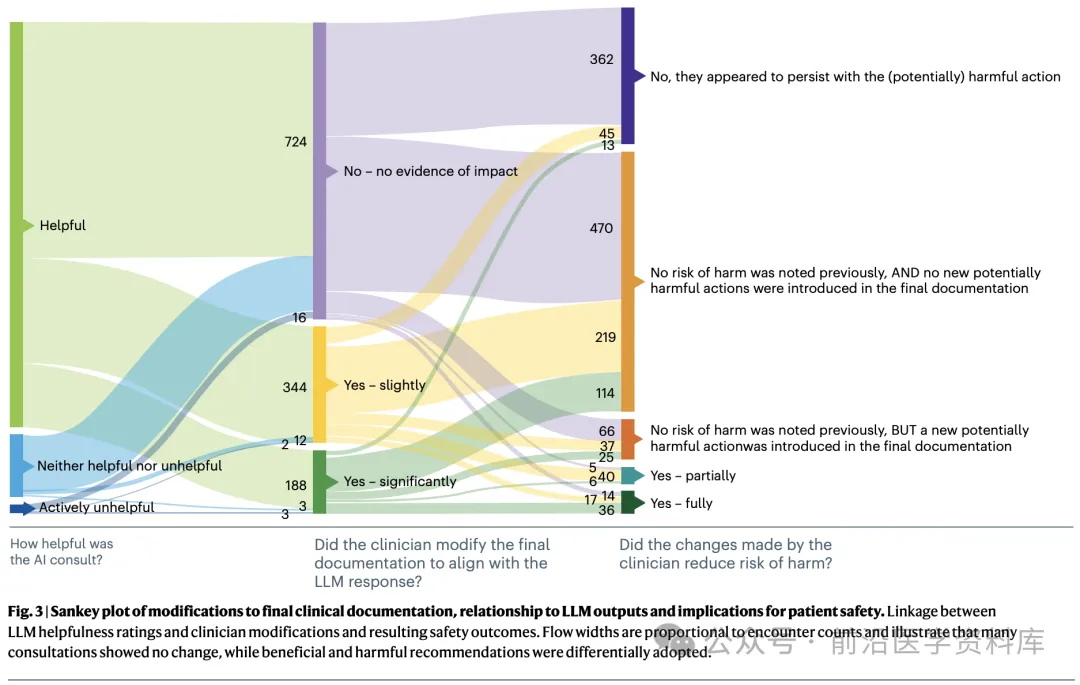
来源:Nature
信任的边界究竟是什么?
这项研究为全球医疗AI的落地敲响了警钟。它告诉我们,医疗AI的成功不仅仅取决于算法的精准度,更取决于人机协作的安全性。
为什么医生会采纳错误的建议?是因为过度信任,还是因为工作疲劳?为什么AI能纠正错误,医生却视而不见?这些问题指向了医疗AI落地的深层挑战:本地化防护栏(Guardrails)的缺失。
如果AI建议了一种当地根本没有的药物,或者忽略了当地特有的流行病学背景,这种高大上的建议在基层诊室不仅无用,甚至有害。研究强调,未来的医疗AI必须具备更强的本地感知力,并建立起多重的安全校验机制,防止AI的错误被无差别地放大。
结语:在创新与审慎中寻找平衡
肯尼亚的这场医疗AI实验,是全球医疗变革的一个缩影。它证明了LLM在弥补医疗资源短缺、提升基层诊疗质量方面的巨大潜力,但也赤裸裸地展示了技术落地时的脆弱性。
未来的核心问题,早已不是AI能不能看病,而是我们如何构建一套完善的制度和技术体系,让AI的每一份建议都能在安全的轨道上运行。在医疗这个关乎生命的领域,创新永远需要与审慎同行。