ARTICLE · 1308972
【虹羽看书】免费!拳打WPS,脚踢鲁大师
你是不是也受够了?WPS用个什么功能,都要弹个二维码。。。都钻钱眼里去了!曾经的屠龙少年已变成恶龙。
另外就是电脑里躺着几百个 PDF:论文、电子书、扫描版老资料、下载站拖下来的报告。想读的时候,打开慢、翻页卡;想整理的时候,文件名一塌糊涂——
P31710919_1793283.pdf
s41586-026-10338-5.pdf
Type of the Paper (Article.pdf……
过两个月再打开文件夹,你已经想不起来哪个文件是哪篇了。
于是我决定自己开发一款PDF阅读器。除了看书,还有一些批量处理工具。有一些是我的个性化功能,如果你需要什么功能,我也可以为你添加哦,欢迎留言。
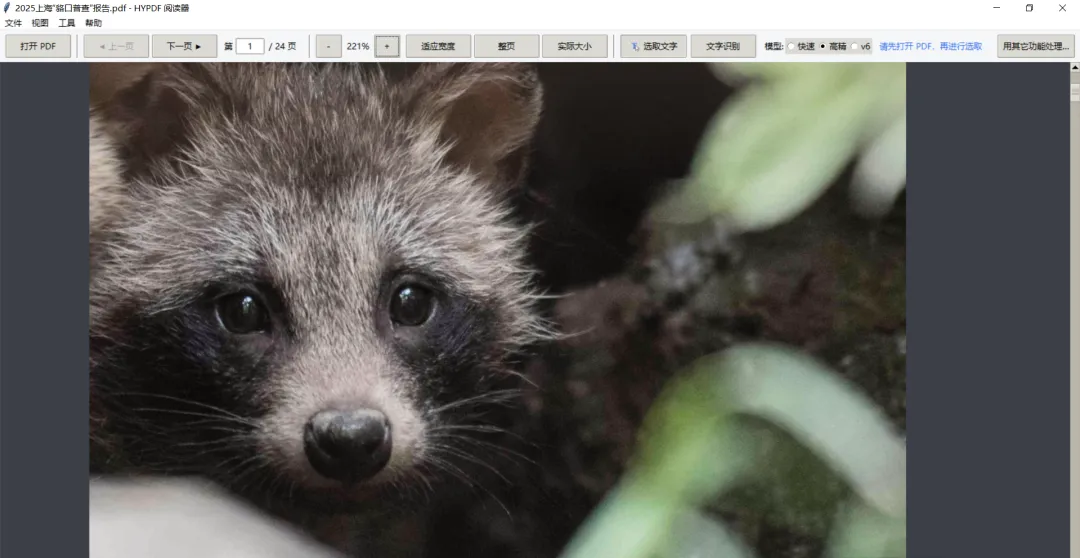
一、阅读器:把「翻 PDF」变回「看书」
打开就是连续滚动——所有页面纵向排开,鼠标滚轮往下滚就自然进入下一页,不用一页页点「下一页」。
•缩放:适应宽度、整页、实际大小,三种一键切换
•页码跳转:输入页码直达,几百页的厚书也不用拖滚动条
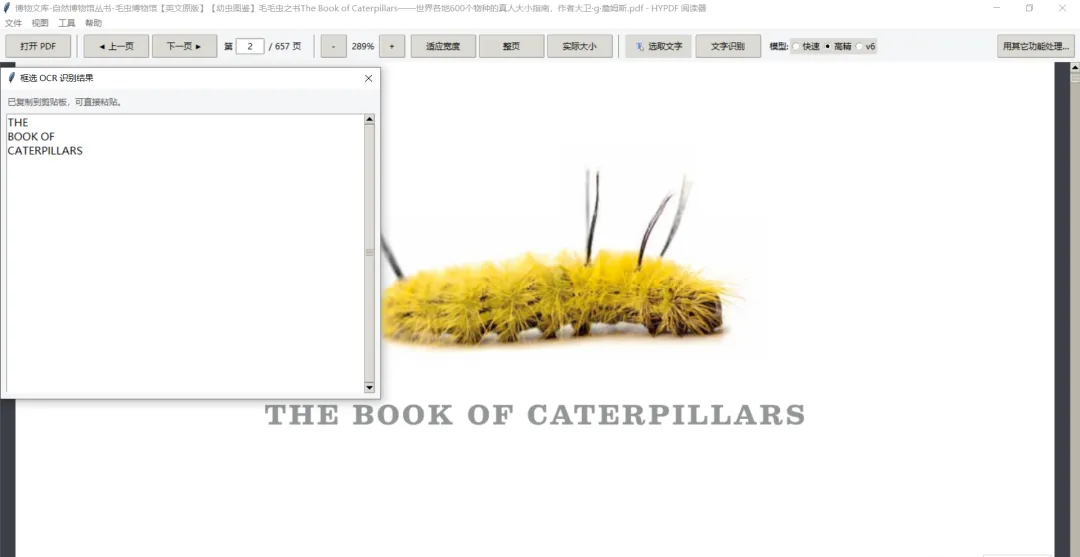
•选中即复制:文字层里的内容可以直接框选复制
•框选识别文字:扫描版没有文字层?框住那一块,直接 OCR 出文字
•一键转交:读到一半想把这本书拆开、转换、改名,点「用其它功能处理…」,当前文件直接带进工具里,不用重新找文件
还能把它关联成系统默认的 PDF 打开方式,以后双击 PDF 就是它。
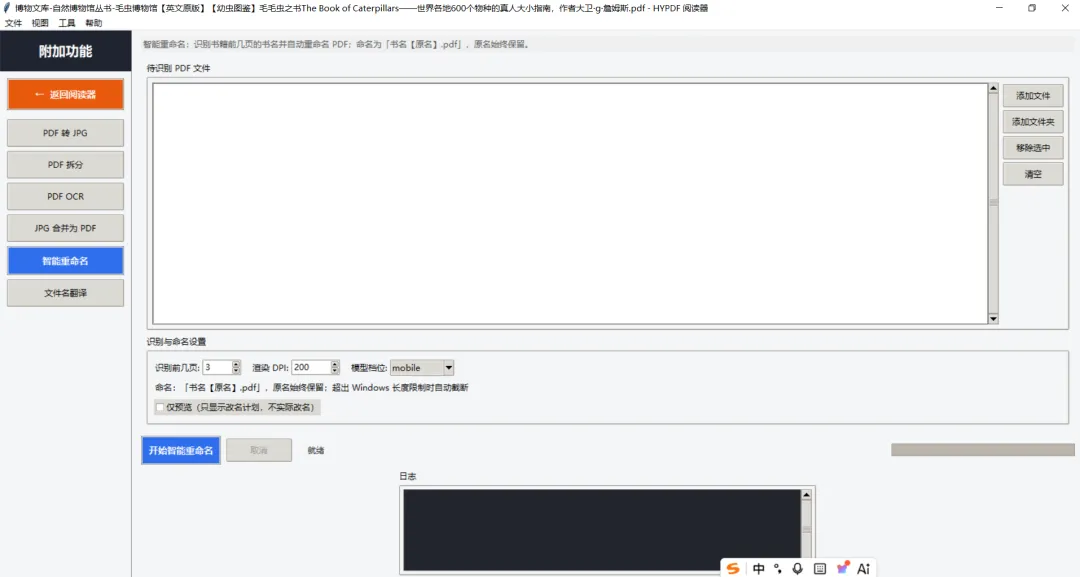
二、智能重命名:让文件名自己变回书名
这是整套工具里最「省命」的一个。
很多 PDF 的正文第一页就印着书名,但文件名是下载站、投稿系统、数据库导出的乱码。HYPDF 会打开前几页,判断哪个是标题,然后改名成:
书名【原文件名】.pdf
原名用【】留在后面,既能一眼认出,也不丢原始信息。
听起来简单,真正难的是各种「脏」排版。开发过程中踩过的坑包括:
•期刊预印本首页只有 Journal Pre-proof 模板文字,真标题在第二页 → 自动跳过模板页
•arXiv 的竖排印章 arXiv:xxxx.xxxxx [math.xx] 字号比标题还大 → 竖排/斜排水印直接不计分
•封面是整页图片,文字层只剩一句 Official Use Only → 自动改走 OCR
•标题和正文一样大(9.96pt vs 9.97pt)→ 退回「页首第一块」兜底
•元数据里的标题其实是文件名、页眉期刊名、或 ATAXE-2026.00126_proof 76..109 这种排版名 → 判为垃圾,改读正文
识别失败的不会硬改,会保留原名并写进日志,你可以事后手动处理。
三、另外四个常用工具
•PDF 转 JPG:逐页渲染成图片,支持批量、页码范围、DPI 与质量
•PDF 拆分:按页码范围拆出几页,或每页拆成一个文件
•PDF OCR:整本扫描件识别成 TXT,中英文都支持
•JPG 合并为 PDF:多张图片按列表顺序合成一本 PDF,手机拍的书页也能拼
每个工具都是「选文件 → 设参数 → 开始执行」,有进度条、有日志、可中途取消。批量跑几十个文件时不会卡界面。
五、几个使用建议
1.先预览再动手。智能重命名和文件名翻译都建议先小批量试跑,确认命名规则符合你的习惯。
2.整理顺序:智能重命名(正名)→ 文件名翻译(加中文)→ 需要时再拆分/OCR。
3.原文备份。改名是原地改名,重要资料建议先复制一份再批量处理。
4.文件名长度受 Windows 260 字符限制,超长时软件会自动截断中文、保留精简原名,不会写出非法文件名。
最后
虹羽看书 不是那种「万能 PDF 神器」式的软件——它没做云同步、没做在线协作、也没塞一堆用不上的编辑功能。它只解决两件事:
读得顺,理得清。
如果你也有一堆「打开就头疼」的 PDF 文件夹,可以试试。
获取方式:关注公众号,回复「看书」获取软件
系统要求:Windows 10/11,绿色版,无需安装