ARTICLE · 1311430
AI 长任务中的上下文污染:识别、整理与恢复
一、什么是上下文污染?
上下文(Context)是 AI 在生成回答或执行任务时能够使用的信息,包括用户需求、历史对话、决策、模型生成内容、工具结果、附件、任务进度及中间产物。
上下文污染(Context Pollution)是指:上下文中混入错误、过时、重复、相互矛盾或不可信的信息,并对 AI 后续判断和执行产生负面影响。它不只是上下文太长,还涉及信息质量、优先级和可信度。
1.1 常见表现
| 类型 | 典型表现 |
|---|---|
1.2 为什么长任务更容易发生?
信息持续累积:历史内容越来越多,重要信息可能被无关内容干扰。 历史决策变化:用户可能多次修改要求,如果没有记录有效版本,AI 容易混淆。 错误反复继承:错误总结被后续轮次引用,逐渐固化成模型认为的事实。 进度缺少依据:AI 声称完成某一步,但实际可能只是生成草稿,并未通过验收。 产物与上下文脱节:只保留文字总结,无法恢复图片、代码、文档等真实成果。
上下文污染的本质不是简单的记忆不足,而是缺少对信息可信度、有效性、任务状态和实际产物的统一管理。
二、常用解决方法:智能恢复
长任务智能恢复(Long Task Context Recovery)的核心思路是:不要求 AI 永远记住所有历史,而是让 AI 在需要时重新整理可信信息,并从正确的位置继续任务。它不依赖特定模型或 Agent 框架,既可以通过聊天提示词使用,也可以封装成 WorkBuddy Skill。
2.1 核心组成
采用 3 个核心状态文件 + 1 个资产索引 + 实际产物 + 检查点。
| 组件 | 职责 | 解决的问题 |
|---|---|---|
三个 MD 文件负责让 AI 理解任务;MANIFEST 负责定位正确产物;Assets 保存实际成果;Checkpoints 提供恢复依据。
2.2 建议的任务目录
目录结构
task/├── SPEC.md├── STATE.md├── ERRORS.md├── MANIFEST.json├── assets/│ ├── source/ # 原始素材│ ├── approved/ # 已批准产物│ └── draft/ # 草稿和待验收内容└── checkpoints/ ├── CP-001.zip ├── CP-002.zip └── ...这些文件不需要用户手动维护,由 AI 根据可访问的历史、用户指令和真实产物自动整理、生成和更新。
2.3 信息可信度甄别规则
| 信息来源 | 处理原则 |
|---|---|
关键原则:不能以最新的历史消息作为唯一依据,也不能默认 AI 自己的总结是正确的。新指令只应覆盖与其冲突的旧要求。例如,用户只要求修改人物服装时,应保留已批准的人物身份和面部特征,而不是重新设计整个人物。
2.4 整理与恢复的工作流程
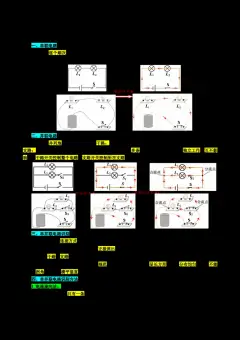
完整流程分为两个阶段:先从旧会话整理可信状态和真实产物,再由新会话加载恢复包、核验状态并继续执行。
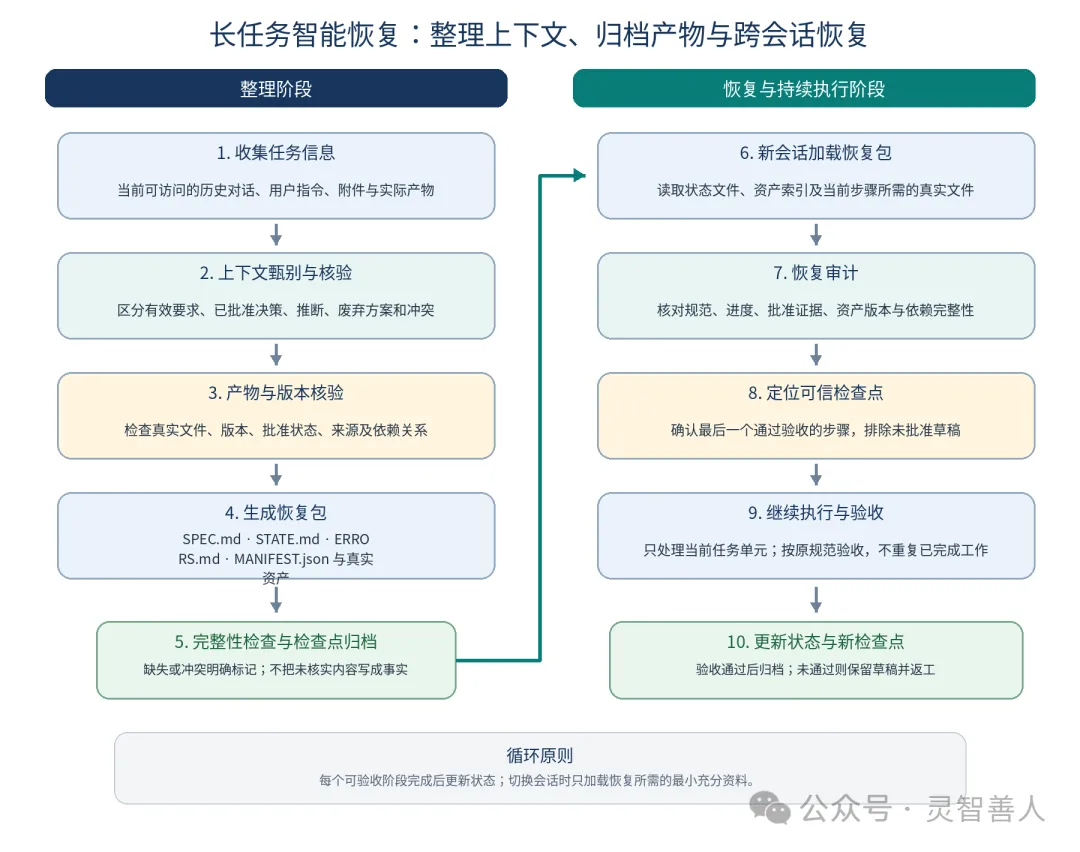
图 1 长任务智能恢复流程:整理、核验、交接与持续执行
2.5 整理上下文:核心提示词
在当前长任务会话中触发整理。AI 应先审计可访问的历史、用户指令、附件和产物,再生成恢复文件。
提示词一|整理当前任务
# 长任务上下文智能整理
你是长期任务的上下文审计与恢复助手。
请分析当前可访问的历史对话、用户指令、附件及实际任务产物,自动甄别有效信息,排除错误、过时、重复和无关内容。
一、信息甄别
1. 提取当前仍然有效的需求、约束、决策和验收标准。
2. 用户后续修改要求时,只覆盖与其冲突的旧要求。
3. 区分用户明确批准的结果、AI 声称完成的工作和未经证实的推断。
4. 识别历史上已否定的方案及反复出现的错误。
5. 对相互矛盾的信息进行证据核验。
6. 无法确认的信息必须标记待核实,不得编造。
7. 不得为了缩短摘要而丢失影响任务正确性的关键要求。
二、自动生成任务状态
生成以下文件:
- SPEC.md:当前有效目标、规范、约束、关键决策和验收标准。
- STATE.md:已批准内容、当前任务位置、未完成事项、最后可信检查点和下一步。
- ERRORS.md:已确认错误、历史否定方案、可证实的原因及纠正要求。
- MANIFEST.json:实际产物的路径、类型、版本、批准状态、来源和依赖关系。
三、产物整理
1. 识别实际存在的图片、文档、代码、视频及其他任务资产。
2. 区分原始素材、已批准成果、草稿和废弃版本。
3. 保留已批准资产,不得用草稿覆盖。
4. 检查文件是否真实存在,不能只记录虚构路径。
5. 对无法获取的历史产物明确标记缺失。
四、自动校验
检查是否遗漏有效需求、误判批准状态、继承否定方案、误判任务进度、存在规范与资产冲突,或缺少关键证据。
能够根据证据确定的错误,自动修正;重大且无法裁决的冲突才询问用户。
五、输出
生成完整状态文件和恢复包,并列出缺失资产及待核实事项。
本次只整理和审计,不重新执行已完成任务,不擅自修改已批准成果。
重要限制:只分析当前实际可访问的历史与文件。不可访问、已删除或已被截断的信息不能声称已经恢复。
2.6 恢复任务:核心提示词
在新会话中上传恢复包,先执行恢复审计,再从最后一个可信检查点继续。
提示词二|恢复原任务
# 长任务智能恢复
这是一个长期任务的新会话接管。请读取恢复包中的:SPEC.md、STATE.md、ERRORS.md、MANIFEST.json 及相关任务资产。
一、恢复审计
1. 核对当前有效规范及版本。
2. 检查任务进度与已批准产物。
3. 确认最后一个可信检查点。
4. 检查状态文件之间是否存在矛盾。
5. 检查资产是否完整、版本是否正确、依赖是否可用。
6. 区分已批准成果、待验收草稿和未完成任务。
二、上下文清理
1. 不继承未经核实的历史推断。
2. 不重新执行已通过验收的步骤。
3. 不重复已明确否定的方案。
4. 只加载当前任务需要的参考资料。
5. 不将旧版资产误认为当前有效版本。
三、恢复执行
1. 从最后一个可信检查点继续。
2. 遵循原有任务规范和验收标准。
3. 不擅自修改已批准成果。
4. 新成果必须经过验收才能成为正式资产。
5. 完成新的阶段后更新任务状态和资产索引。
四、异常处理
如果发现重要信息缺失或相互冲突,先核验已有证据。
无法裁决的关键问题才向用户询问;其他情况自行完成核验。
先输出恢复审计结果、当前任务位置和唯一下一步,确认恢复条件满足后再继续执行。
不得把未经证实的历史内容当作事实,也不得编造缺失的文件或批准记录。
2.7 为什么不能只依赖三个 MD 文件?
对于纯文字任务,三个文件可能已经足够;但对于漫画、视频、代码、文档等复杂任务,仅保存文字状态是不够的。新会话即使知道前 30 页已经完成,如果找不到人物参考图、场景参考图和正式页面,就无法可靠地继续第 31 页。
因此增加 MANIFEST.json,专门记录资产身份、路径、版本、类型、批准状态、来源和依赖关系。真实资产必须归档;检查点保存当前阶段新增资产及其必要依赖,完整历史成果则另行归档。
MANIFEST.json 示例
{"asset_id":"PAGE-020","type":"image","path":"assets/approved/page-020.png","version":3,"status":"approved","dependencies":["CHAR-C001-v3","SCENE-S001-v2"],"source":"STEP-020"}2.8 封装成 Skill 使用
为了避免每次手动复制提示词,可以将这套流程封装成 Skill。主 Skill 识别用户意图并协调流程,内部模块分别处理上下文审计、资产管理和检查点恢复。
| 自然语言指令 | AI 自动执行 |
|---|---|
Skill 的能力边界取决于平台权限:它只能分析当前可访问的会话历史和文件。如果旧对话已被截断、删除,或平台不允许导出历史附件,必须明确标记缺失,不能声称已经完整恢复。
三、其他解决方法
| 方法 | 主要作用 | 局限与适用场景 |
|---|---|---|
这些方法可以组合使用,但解决的问题不同。聊天式长任务优先采用长任务智能恢复;自建 Agent 若还需要自动重试、人工审批和执行中断恢复,再考虑 LangGraph、Temporal 或 Restate 等工作流框架。
四、落地建议
以业务阶段作为检查点:每完成一个可验收单元,再更新状态和归档产物,不必每轮对话都保存。 把批准证据与产物绑定:AI 自称完成不等于通过;用户批准记录和真实文件才是关键依据。 只加载当前步骤所需资料:恢复包保留完整归档,但新会话只读取当前任务的最小充分上下文。 保留草稿与正式资产的边界:未通过验收的产物放在 draft,不覆盖 approved。 冲突不猜测:规范、状态和资产互相矛盾时,先核验原始依据;无法确认就标记待核实。 明确恢复边界:被删除、截断或无法访问的历史内容不能凭空恢复,必须依靠用户重新提供的资料或已有检查点。
结语
长任务的可靠性,不应建立在 AI 永远记得所有聊天内容的假设上,而应建立在可信规范、可核验状态、真实产物和阶段检查点之上。
长任务智能恢复把上下文整理与任务恢复变成一个可重复的工作流程:旧会话负责提取和归档可信信息,新会话负责核验并接管任务,后续每个阶段再更新状态和检查点。
核心原则:不要要求 AI 永远记住整个长任务,而要让 AI 在任何时刻都能依据可信资料重新接管任务。