ARTICLE · 1312160
太顶了!我用一句话,让豆包工作直接接管Office做深度分析
前四篇我和大家聊了动效视频、无限画布、多Agent流水线,以及用浏览器录屏实现自动化技能。
之前几篇发完,后台很多在实体行业做运营、分析和管理的朋友留言:
那些生成视频的玩法确实很帅。
但日常办公里最折磨人的,往往是电脑本地那一堆跨表计算和PPT汇报。
拿到几张复杂的业务数据表。
指标彼此嵌套,逻辑分散在不同文件里。
人工拉公式容易出错,算完后还要手动截图,一点一点贴到本地PPT里调格式。
以前绝大部分AI最大的问题是格式搬运。
它们只能在网页对话框里吐出一段文字,或者生成一个排版混乱的新文件让你下载。
你下载下来,还得手动打开本地软件,重新调字号、改母版、复制公式。
今天继续测豆包工作的第五套垂直深度玩法。
我用豆包工作去测一次真正的Office文件深度协同
下面直接看实测过程
测试准备
做财务与业务分析,最怕数据造假。
为了保证数据绝对真实,我选了算力硬件领域的龙头公司:xx旭创(300308)。
打开豆包工作电脑端,新建工作任务,我直接输入了一行指令:
用 Python 帮我获取xx旭创(代码 300308)最新的资产负债表、利润表和现金流量表数据,清洗整理后,在当前目录保存为三个标准的 Excel 文件:资产负债表.xlsx、利润表.xlsx、现金流量表.xlsx”豆包工作在后台自己编写抓取脚本、配置解析依赖、校验接口数据。
它把三张干净的标准表格保存在了我电脑的本地目录下,还顺手把可复用的Python脚本打包交付给了我。
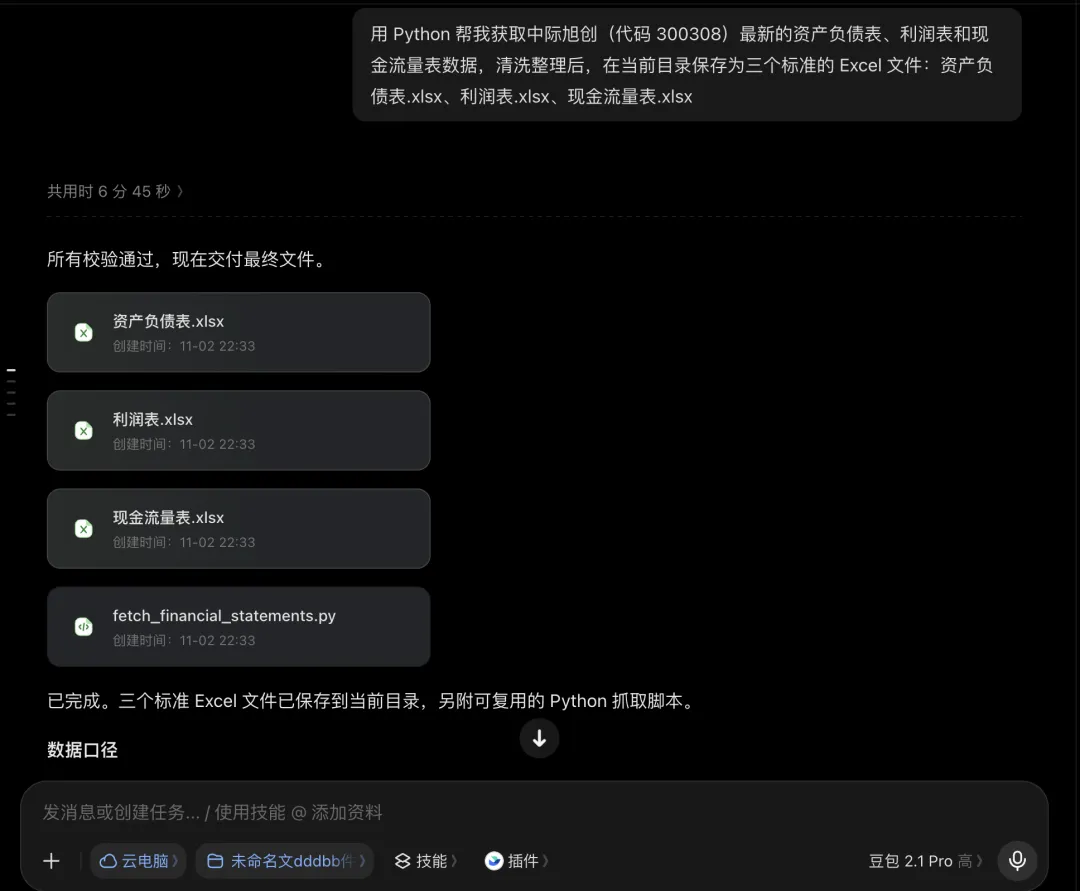
查验这三张表时,可以看到非常标准的财报口径:
最新报告期是2026年三季报(截至2026-09-30),合并报表。
资产负债表的对比期是2025年末期初数。
利润表和现金流量表的对比期是2025年前三季度同期累计数。
底表数据极其扎实,接下来直接进入深水区。
第一步:跨表杜邦分析,原地回写Excel公式
拿到这三张表,传统的分析流程极度繁琐。
要搞清楚一家公司的赚钱逻辑,最经典的工具是杜邦分析法。
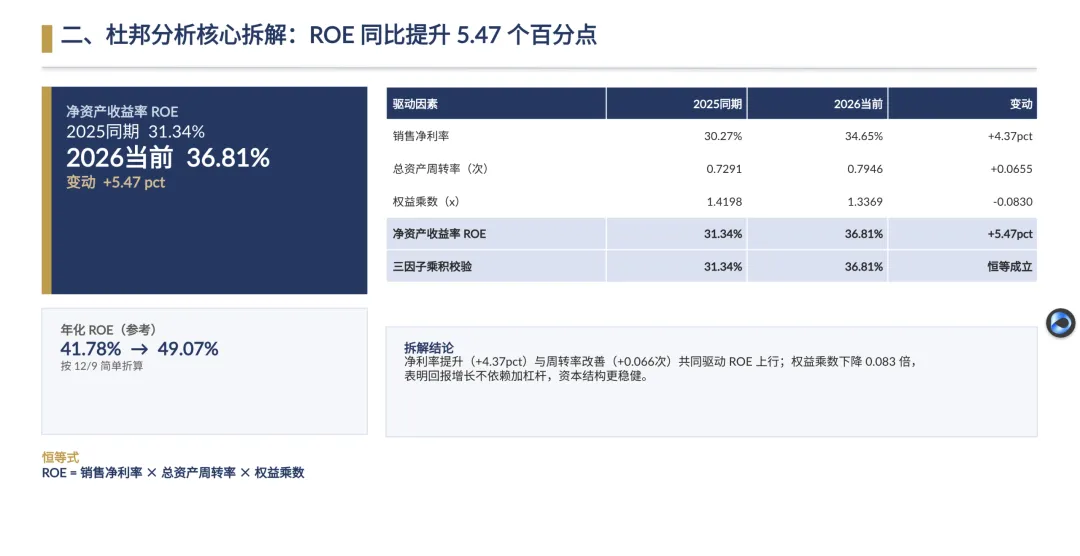
它把核心指标净资产收益率(ROE),拆解为三个驱动力:
销售净利率看产品赚钱能力。
资产周转率看资产运转效率。
权益乘数看财务杠杆水平。
利润表提供的是时期累计数据,资产负债表提供的是时点存量数据。
人工需要跨越两个文件,手动对齐时间周期,拉公式计算期初期末平均值。
这次我直接下达穿透分析指令:
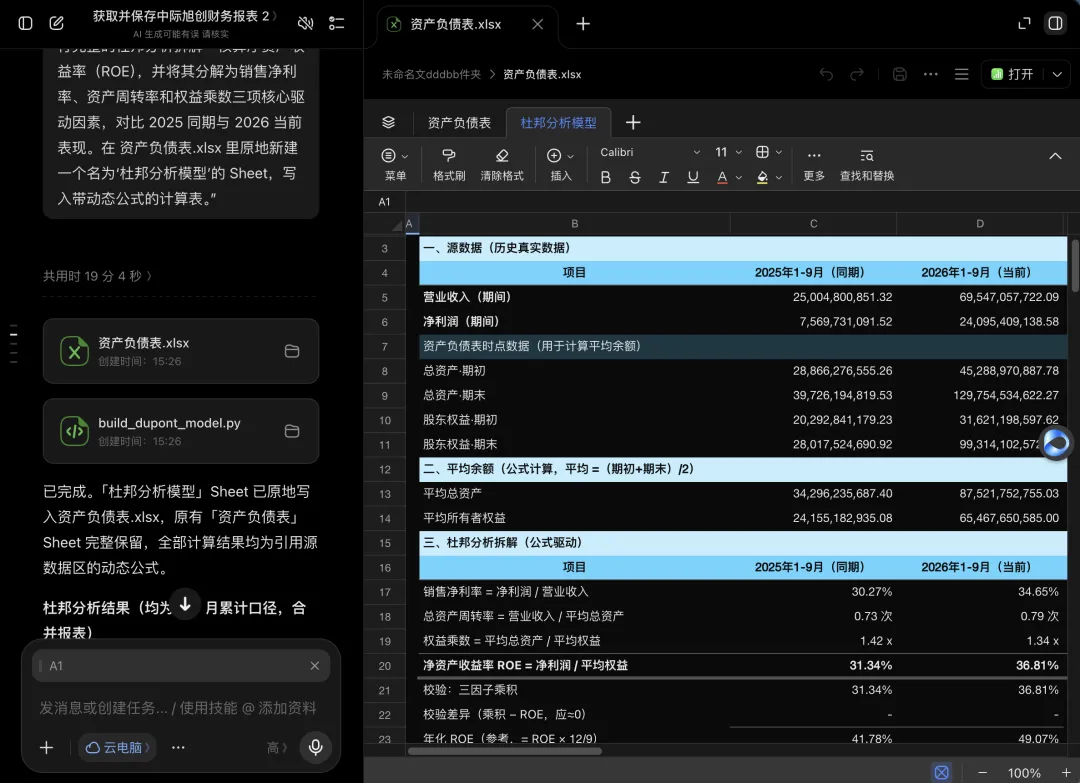
读取刚才生成的这三个报表文件。请进行完整的杜邦分析拆解:核算净资产收益率(ROE),并将其分解为销售净利率、资产周转率和权益乘数三项核心驱动因素,对比 2025 同期与 2026 当前表现。在 资产负债表.xlsx 里原地新建一个名为‘杜邦分析模型’的 Sheet,写入带动态公式的计算表。”注意看它的执行方式。
它没有在对话框里吐出一堆Markdown表格让我手动复制。
它直接调起了本地文件读写引擎,定位到我电脑硬盘里的 资产负债表.xlsx。
它直接在原文件里新建了Sheet。
填入指标名称,写好规范的Excel动态跨表引用公式,配置好百分比与千分位格式。
原表格的所有历史数据、字体、样式没有受到任何破坏。
它是在原始文件上完成了修改。
第二步:不用现成模版,直接在本地生成研报级PPT
算完杜邦模型,接下来是汇报交付。
我手头并没有现成的商业汇报PPT模版,很多人卡在这一步,往往又退回去手动找模版、复制粘贴。
我直接在豆包工作里下指令:
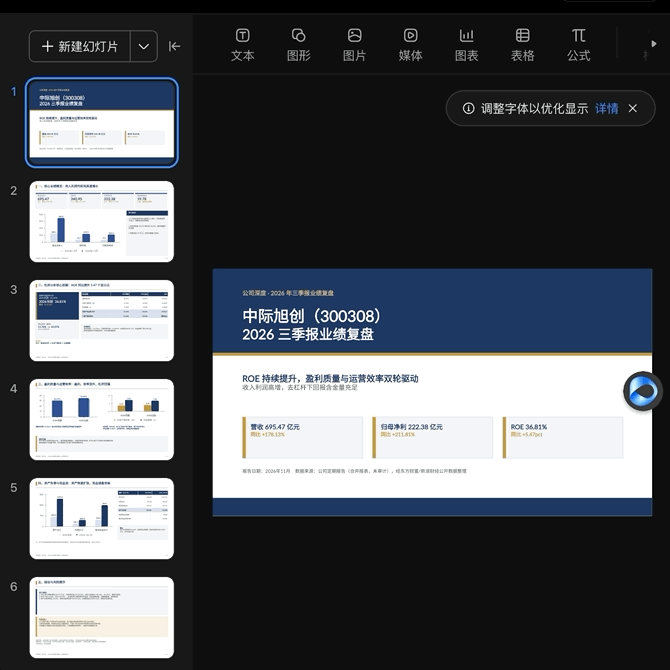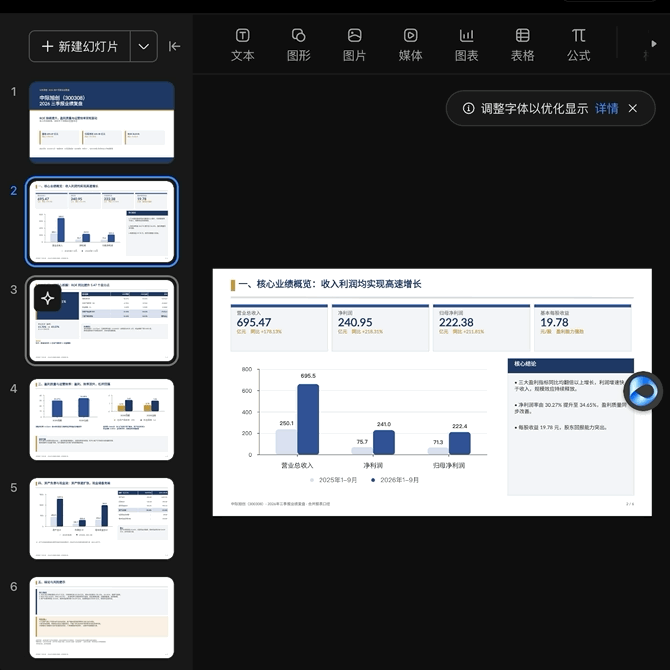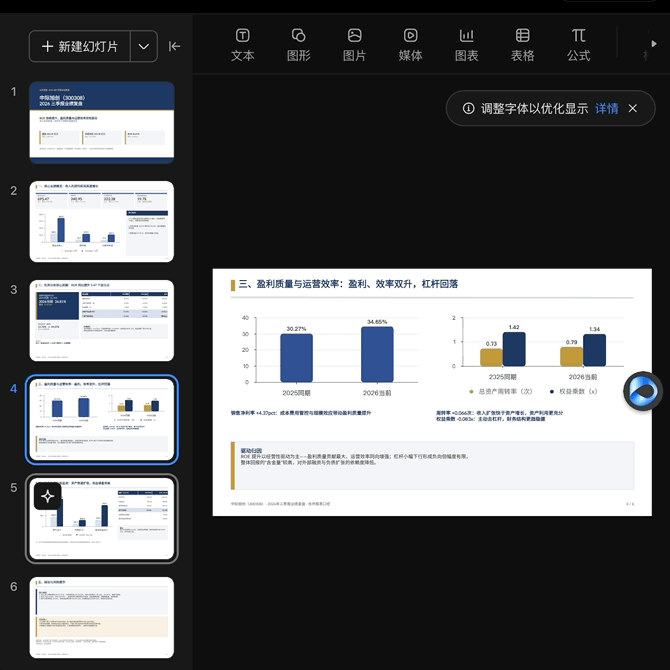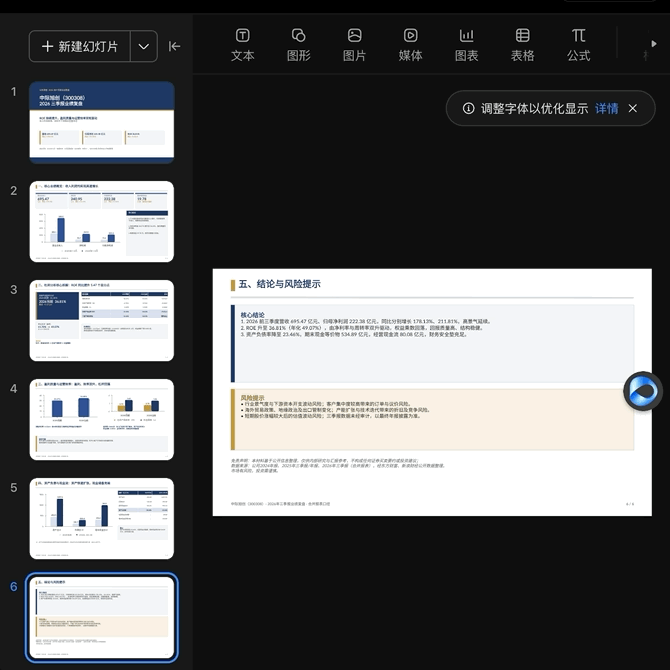
“基于刚才算出的杜邦分析结论,直接在当前目录生成一份机构研报风格的汇报 PPT,命名为 `xx旭创2026三季报复盘.pptx`,页数在 5 到 6 页左右。”豆包工作在后台直接调起飞书沉淀的专业PPT生成能力。
它根据光模块算力行业的属性,自动选定了科技感配色的版式规范。
封面、业绩概况、杜邦分析三要素拆解、业务风险提示,层级极其规整。
第三步:对本地PPT执行原地修改
生成好PPT之后,
如果某些页面的版式不符合你的预期,或者需要补充特定图表,你不需要手动打开软件去拖拽文本框。
我直接对豆包工作说:
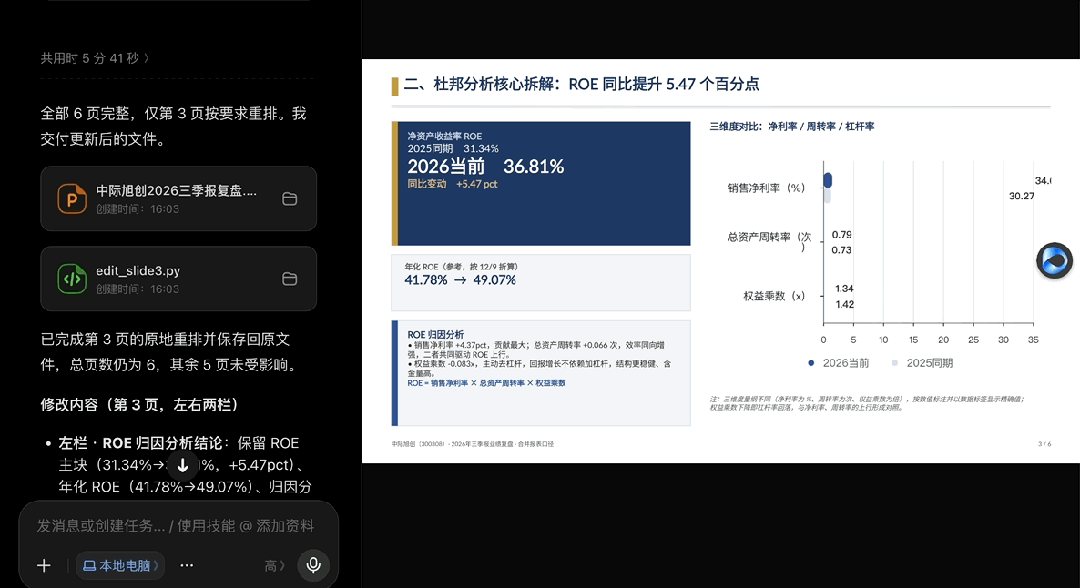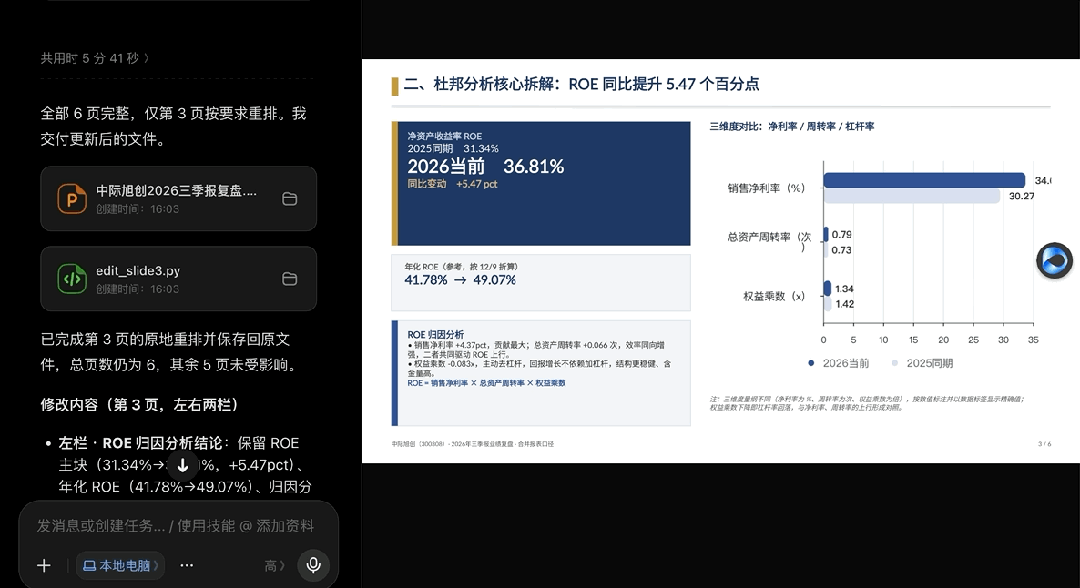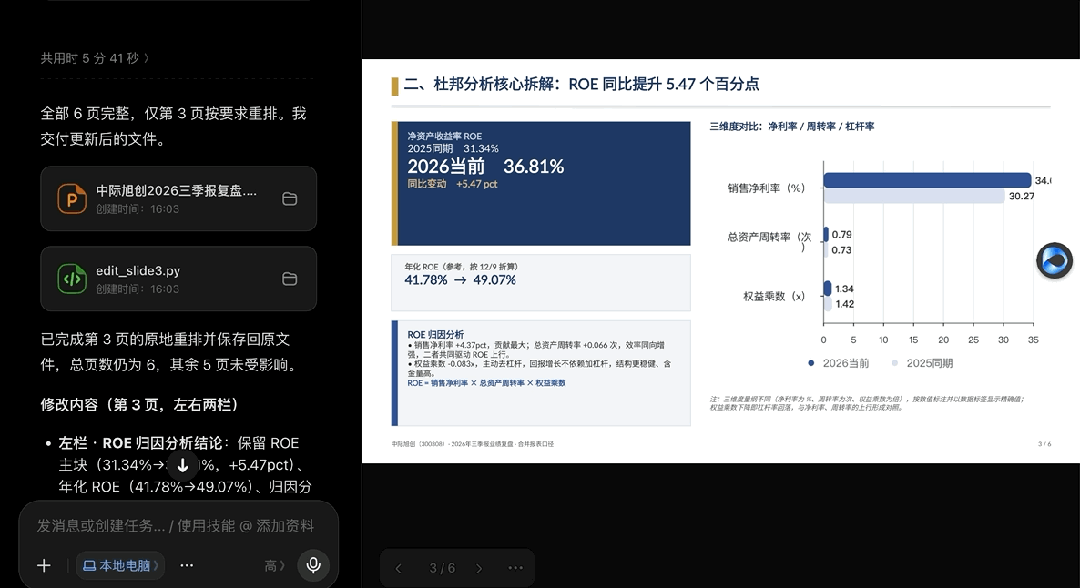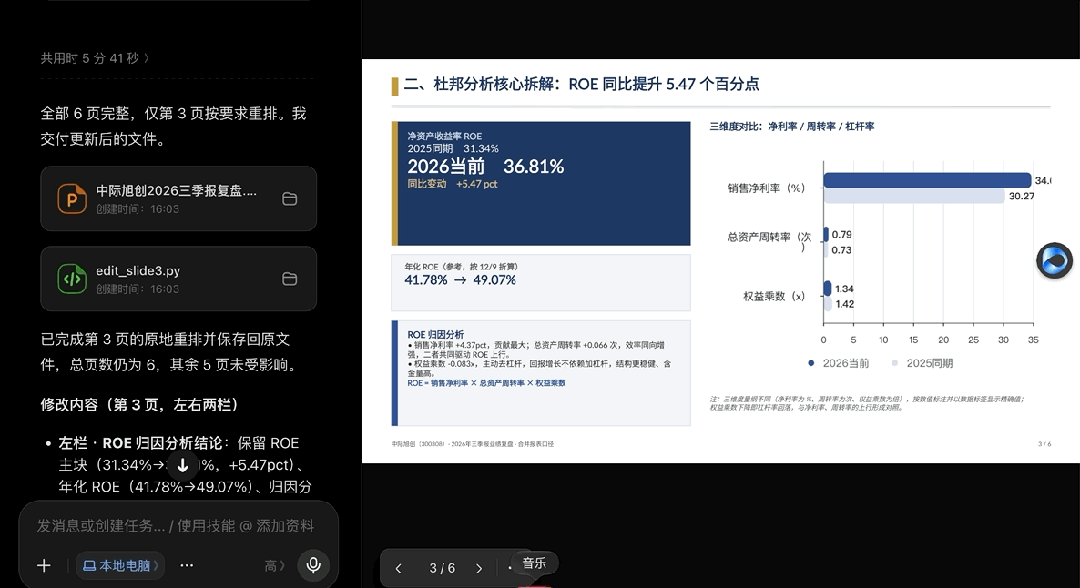
打开刚才生成的 `xx旭创2026三季报复盘.pptx`,进行原地修改:把展示杜邦分析三要素拆解的那一页,版式改为左右两栏排版,左边保留ROE归因分析结论,右边插入一张净利率、周转率与杠杆率的三维度对比图,修改后直接保存回原文件。”原始第三页ppt:
豆包工作重新检索本地该PPT文件的页面结构。
定位到对应页面,重构母版占位符,调整图文排版,把图表引擎生成的矢量对比图直接写入幻灯片中。
整个过程就像一个助理坐在你的电脑前,调取本地文件、改好版式、存盘退出。
第四步:任务量增大时,随时切到云电脑挂机
在测试过程中,我还做了一次压力测试:
我让它顺便把光模块行业另外3家同类竞品的财报数据全部拉下来,跑一套横向杜邦对标大表。
这种批量处理需要跑较长时间的脚本,
这时候豆包工作的环境切换机制就体现出了价值。
新建任务时直接选择云电脑模式
输入指令
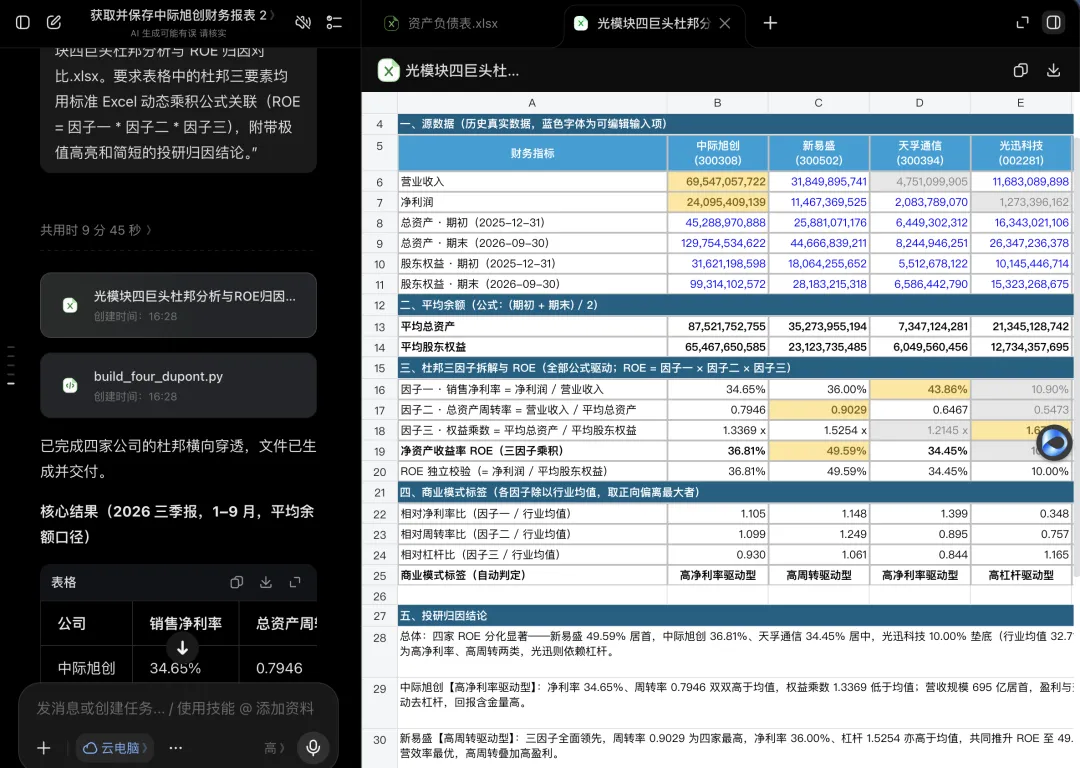
“继续扩展分析。请用 Python 批量获取光模块同行业另外 3 家龙头公司最新的 2026 年三季报数据(口径与xx旭创完全一致): 新x盛(代码 300502) 天x通信(代码 300394) 光x科技(代码 002281) 请以**杜邦分析法(DuPont Analysis)**为唯一核心框架,对xx旭创、新x盛、天x通信、光x科技四家公司进行横向穿透: 核心因子拆解: 计算并对比四家公司的: 净资产收益率(ROE) 因子一:销售净利率(净利润 / 营业收入,衡量产品盈利壁垒) 因子二:总资产周转率(营业收入 / 平均总资产,衡量资产运转效率) 因子三:权益乘数(平均总资产 / 平均净资产,衡量财务杠杆水平) 杜邦归因与驱动型判断: 对比行业均值,自动为每家公司打上商业模式标签(判断其属于‘高净利率驱动型’、‘高周转驱动型’还是‘高杠杆驱动型’),并提炼出ROE差异的底层原因。 本地交付要求: 在当前目录生成 光模块四巨头杜邦分析与ROE归因对比.xlsx。要求表格中的杜邦三要素均用标准 Excel 动态乘积公式关联(ROE = 因子一 \* 因子二 \* 因子三),附带极值高亮和简短的投研归因结论。”任务立刻平移到了云端继续运行
我直接合上笔记本电脑出门。
二十分钟后,我在路上打开手机里的豆包App,进入同一个工作任务。
手机端清晰显示:3家竞品的杜邦拆解对比已经跑通,分析结论已完整写入云端对应的文件里,支持随时查看。
本地电脑与云电脑完全打通,不需要守在电脑前死等。
最终交付:
为什么这个能力实用
很多人提到AI办公,以为就是写写文案、总结摘要。
但在严肃的职场环境里,绝大部分时间消耗在不同软件的格式搬运上:
从网页导出表格,在Excel里拉公式计算,计算完截图拷进PPT,PPT调完格式再存盘归档。
豆包工作独立端把本地文件的深度修改打通之后,消灭了中间所有琐碎的格式搬运。
文件存放在你的本地硬盘里。
它在后台默默完成脚本编写、跨表核算、公式回写和PPT排版。
写在最后
这套测试做下来,最直观的体会是:
工具终于开始适应人的工作流,而不是让人去适应工具的输入框。
把机械的数据对齐和版式填充交给豆包工作,人的精力才能收拢回来,专注在业务判断和策略决策上。
我这里只是抛砖引玉,任何类似的场景你可以在豆包工作里试试
最后提醒一下福利:
这是豆包工作深度实测的第五篇,后面我会继续针对更多高频硬核场景展开测试,希望对你有用。
--end--
最后记得⭐️我,每天都在更新:如果觉得文章还不错的话可以点赞转发推荐评论
/...@作者:心兰