ARTICLE · 1312463
AI 查公司数据老答错,先给它一本口径字典
AI 查公司数据老答错,先给它一本口径字典
让 AI 连上公司数据库问数,最先崩的不是语法,是口径。同一个「营收」,销售算开票金额,财务算回款,AI 拿着两张表名猜一个,猜得理直气壮。NVIDIA 开源的 Auto-Ontology 不在这上面优化模型,它换了个下手的地方:先把「这个词在这套数据里指什么」写成一本账,人签过字,AI 才准照着回答。
那本账里记三样东西
它编译出来的东西叫 ontology(本体),说白了是一份业务说法和数据库字段的对照账,记三类。术语:客户、订单行这种业务概念,带描述和同义词,挂到具体的列上。SQL 口径:某个指标怎么算,是一段人审过的 SQL,「利润率」只有一份算法,谁问都用它。关系:表和表怎么 join,包括那种必须经过中间表的桥。
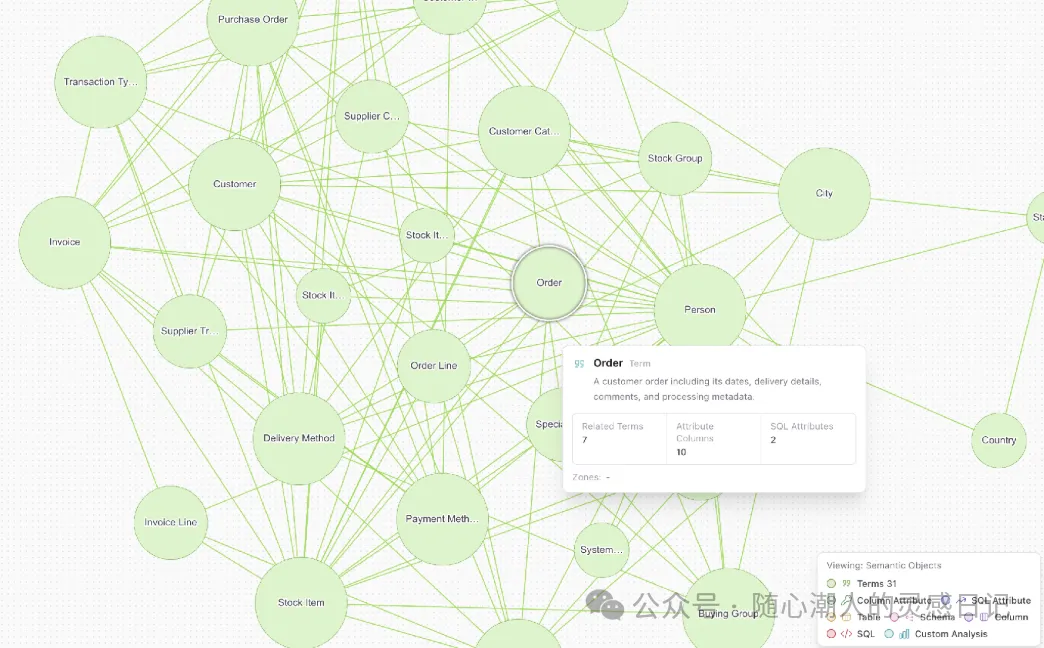
初版是机器拼的:读表结构、字段取值分布和查询历史,拼出一份草稿。机器拼的东西不敢直接信,所以流程里留了人在的位置:在界面上改描述、改 SQL 表达式,改对了点认证。之后 AI 只能问签过字的内容。
多出来的一道「这题能不能答」
最常见的偷懒做法是把建表语句贴进提示词。贴 schema 的时候,字段名是给完了,含义靠模型自己猜,join 每次现编,问一个数据里根本没有的东西,它照样回你一个数。
Auto-Ontology 在提问之前先问一遍能不能答:把问题拆成实体,逐个去向量库里找距离够近的候选,覆盖到几个就按几个算分。README 里那个例子,问「2015 年 6 月这款寿司卷闪存的广告投入产出比」,样本库是微软那套 Wide World Importers,没有广告数据,拆出来的实体只覆盖上一半,得分 0.5。AI 于是没硬答:销售额我能给你,广告花费不在这份数据里,你要的是六月销售额,还是花费记在别的库。
代码里能看出踩过坑
编译按表并行,但写回术语要排队,按一个固定的表顺序提交。注释写了原因:两张表可能抽出同名术语,谁先占住这个名字得可复现,不能取决于哪个线程先跑完。给宽表补字段说明时按 15 列切一批,一次让模型为几百个列各吐一个 JSON 会超时;一批挂了也不至于把整张表的说明全丢掉。
SQL 跑完之后还有两道检查。结果零行而语句里有 LIKE,就再叫模型判一次哪些过滤条件是顺手加的,去掉重写;JSONB 取键取出来全是 NULL,直接判定路径写错,重写时连模型都不用问。
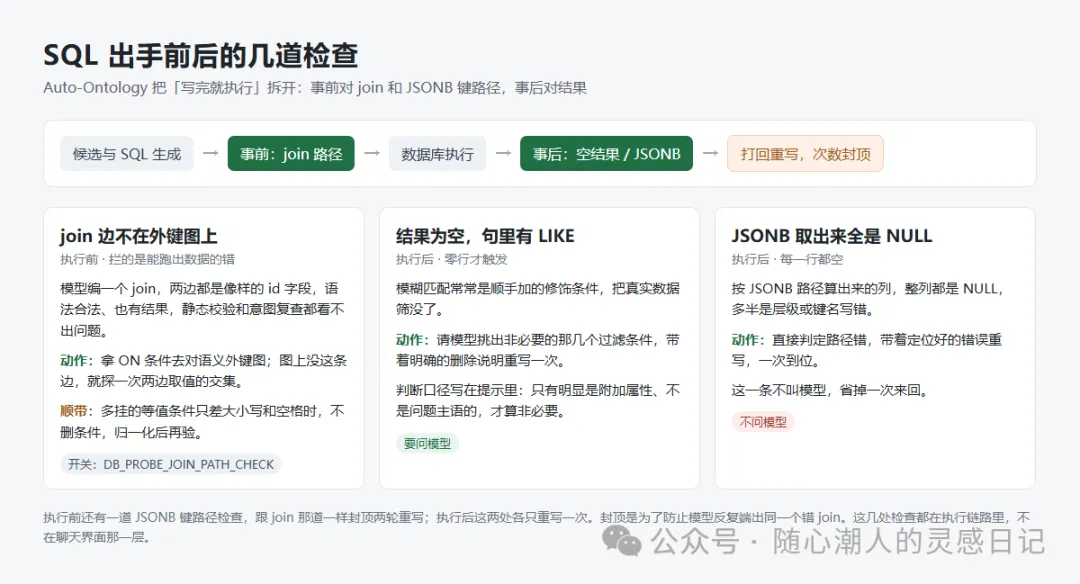
最狠的是 join 那道,跑在执行之前,注释把风险讲得直白:模型瞎编一个 join,两边都是看着合理的 id 字段,语法合法,也能跑出数据,流程里没人拦得住它。所以它把 ON 条件拿去跟外键图对,图上没这条边就现场探一次两边取值有没有交集。还有一种更隐蔽的:join 本身没错,多挂了一个等值条件,两列的值只差大小写和空格,真实数据就这么被悄悄筛掉了。它不删条件,先归一化再验一遍。
给 AI 用的那层 MCP server 只读,工具都是查术语、看列、问问题这一类。ask_question 是手写的,后端回的是事件流,FastMCP 按 OpenAPI 规格套出来的一问一答式工具接不住。每一步进度转成 MCP 的 progress 通知,客户端看得见它走到哪。最多回 100 行,超了会一并告诉你总共多少行、被截了,不悄悄丢数据。
接什么库,跑什么模型
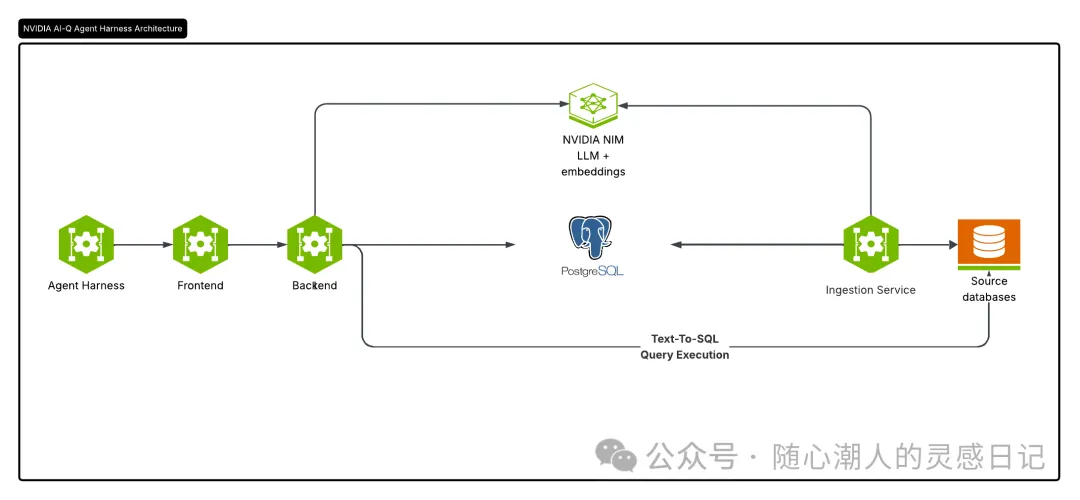
能接十种引擎:Postgres、MySQL、Snowflake、Databricks、ClickHouse、Trino、Kyuubi、HeavyDB、DuckDB、SQLite,后两个只能写在连接串里,界面上加不了。界面是 Next.js,登录用 Better Auth,后端 FastAPI 加 LangChain,本体和向量都落在 Postgres 的 pgvector 里。
模型分四个角色:建本体和写 SQL 的推理位、拆实体这类快手活的非推理位、嵌入位、重排位。默认全用 NVIDIA 自己那套 Nemotron,换成任何 OpenAI 兼容端点都行,留空的字段回落到公共那一组。嵌入模型必须编译和查询用同一个,这条写在注释里。
边界先看清
后端那两个端口自己不带鉴权,它信的是界面转发过来的用户身份头,README 明说这部分要放内网 —— 直接暴露等于谁都能调你的编译接口。注册入口是关着的,第一个账号只能从环境变量里那个管理员账号进。
想让 AI 回答预测类的问题,得接 Kumo 的托管服务,开了之后会把连上的表传过去,默认最多 20 张。开之前先过一遍你们的数据审批。外部 PR 不收,只收 issue 和 bug 报告,想改深一点得自己 fork。License 是 Apache-2.0。
它还有个配套的评测仓库,方法挺干净:同一批题、同一个模型跑两遍,一遍把 schema 塞进提示词,一遍走本体,判分看两条 SQL 的执行结果是否一致。报告除了差值,还单独列出本体修好的题和搞砸的题。
库只有十几张表、字段名起得清楚,别折腾这个,直接把 schema 给 AI 更省事。真值得上的是那种「营收有三个定义、跨了五六个库」的团队。卡住 AI 报数的一直是口径,不是模型。