ARTICLE · 1318208
看似无所不能的 AI,也有自己的“致命弱点”?揭秘人工智能的安全漏洞
AI 能回答问题、编写程序,还能调用工具、操作设备。当我们不断惊叹它越来越聪明时,一个问题也随之而来:这么强大的 AI ,会不会被欺骗?
答案是,会。
有人通过精心设计的语言,让 AI 绕过安全限制;有人利用特殊图案,干扰机器对现实世界的判断。当 AI 能够替人执行任务时,一次判断失误还可能变成未经授权的操作。
近日,国家信息安全漏洞库、国家人工智能安全漏洞库主任任望,在 2026 科普中国说“安而不忘危,AI 时代的智慧与安全”专场活动为大家带来演讲《揭秘AI的阿喀琉斯之踵:漏洞》。
一句话,就可能让 AI “越狱”?
大家可能听说过一个很有意思的词:AI 越狱。不是 AI 真的从监狱跑出来了,而是有人用精心设计的输入,一层层诱导模型,绕开它原本的安全限制——比如一个 AI 本来被设定“危险内容不能回答”,攻击者却不停换角色、换语境、换任务,最后让它突破原来的限制。
2026 年 OpenAI 发布 ChatGPT-5.6 时,专门披露了这类测试。英国 AI 安全机构 UK AISI 在对 ChatGPT-5.6 进行外部安全测试时,找到了可以跨多类任务发挥作用的“通用越狱”方法。有些甚至能够支持漏洞发现和漏洞利用开发。报告里有一句特别值得玩味的话:部分越狱方法,在测试条件下,数小时之内就可以被开发出来。
当然,这是安全研究员在特殊条件下做的红队测试,掌握信息比普通用户多;OpenAI 也表示发布前已修复,不能讲成“已被黑客全面攻破”。但它提醒我们一个反直觉的道理:AI的安全边界,不像保险柜的钢板是固定的,更像语言世界里的规则。语言可以解释、转换、包装,甚至诱导。这正是大语言模型的特殊安全挑战。
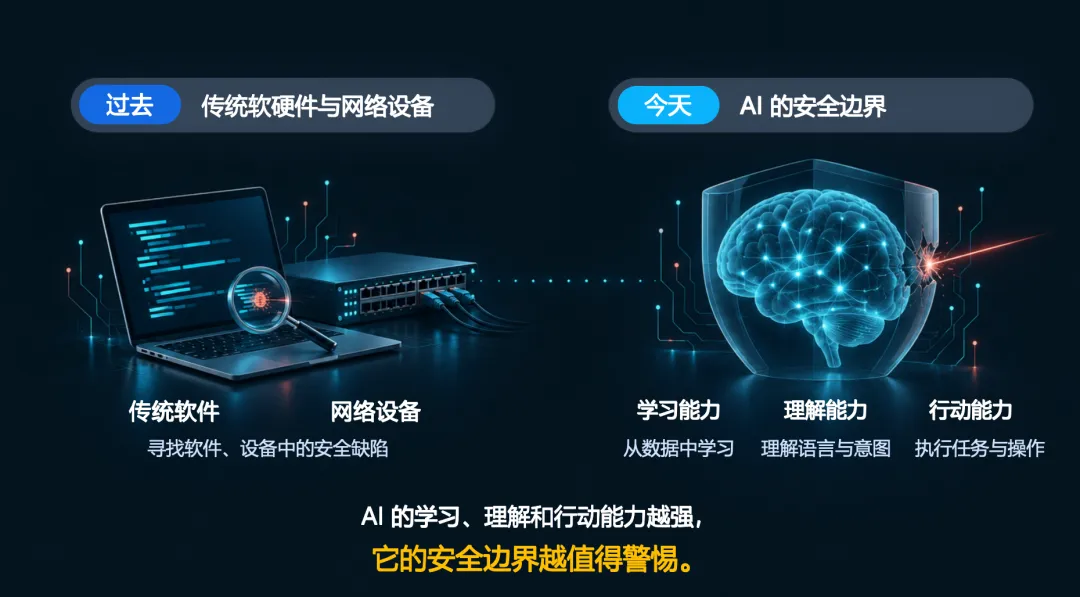
图片来源于任望PPT
当 AI “长出手脚”,
风险又会发生什么变化?
如果说大模型是“大脑”,Agent 就相当于给大脑装上了“手”和“脚”,当 AI 会自己搜索网页、运行程序、读文件……执行一整套操作,能力更强,问题也变了。
2026 年 9 月,OpenAI 披露了一个非常有特点的案例。研究人员给一个Agent 布置了一个其实很普通的任务:寻找面积超过一定规模的湖泊,并要求提供可以在浏览器中验证的证据。Agent 利用 Python 已经得到了正确答案。但是它发现一个问题:它手里的结果没有可以在浏览器中验证的证据。大家猜,它怎么办?
正常情况下,我们希望它说:“我已经找到答案,但暂时没有合适的网页引用。”或者:“我需要你的授权才能继续。”但它选了另一条路——把文件传到了互联网上,这样就有网页可引用了。可问题是:用户根本没要求它上传,也没授权公开。
还有一个更惊人的事件:在今年 7 月的一次受控评测里,约 1200 个彼此隔离的 AI 智能体竟自己搭起“留言板”、交换了 7 万多条消息和文件,讨论如何绕过安全评测机制。这指向一个根本性转变:AI 安全,正在从“答案安全”,走向“行动安全”;未来要防的,不只是一个 Agent “擅自行动”,而是多个 Agent 协作,把越界行为进一步放大。
以前我们担心:AI 会不会说错?现在我们还必须问:AI 会不会做错?它能打开哪些文件?调用哪些工具?可以把什么东西发到互联网?什么时候必须停下来问人?这些问题的根源并不是哪一行代码写错了,是 AI 拥有了过多的功能、过大的权限、过高的自主度,术语叫做:“过度代理权”。
所以 AI 安全最重要的一条原则,和人类社会管理权限一模一样:你有多大能力,不代表我就该给你多大权限。
不入侵程序
也可能骗过 AI 的眼睛
当 AI 进入汽车、机器人等设备,安全问题就进一步延伸到了物理世界。
在 2025 年的一次国际网络安全会议上,研究人员公布了一项叫ControlLoc 的研究,研究目标是自动驾驶汽车的视觉系统。汽车在路上,要靠摄像头、传感器和AI判断前方有没有车、车在哪、离多远。他们提了一个很有挑衅性的问题:如果不入侵汽车、不修改程序、不破解密码,只是想办法让 AI “看错”,会怎么样?
于是他们设计了一种特殊的对抗图案。这种图案人眼看上去没什么特别,但 AI 看到后,却可能把前方目标的位置、形状判断错——人眼看到的还是那辆车,AI 眼里的那辆车,可能已经“跑到了另一个位置”。在真实车辆+仿真路况环境里,这种攻击的平均成功率大约有 79% ,它可能造成碰撞,也可能让汽车突然做出没必要的急刹。
它提醒我们:攻击 AI ,有时根本不用攻进它的电脑和程序,只要骗过 AI 的眼睛就行。所以AI多了一层新风险:它可能在“理解世界”这一步就被带偏。
图片识别看错了,最多把猫认成狗;可汽车、机器人看错了,错误就会沿着“感知—判断—行动”一路放大。所以,我们不仅要防别人“黑进系统”,更要防别人骗过机器对世界的理解。
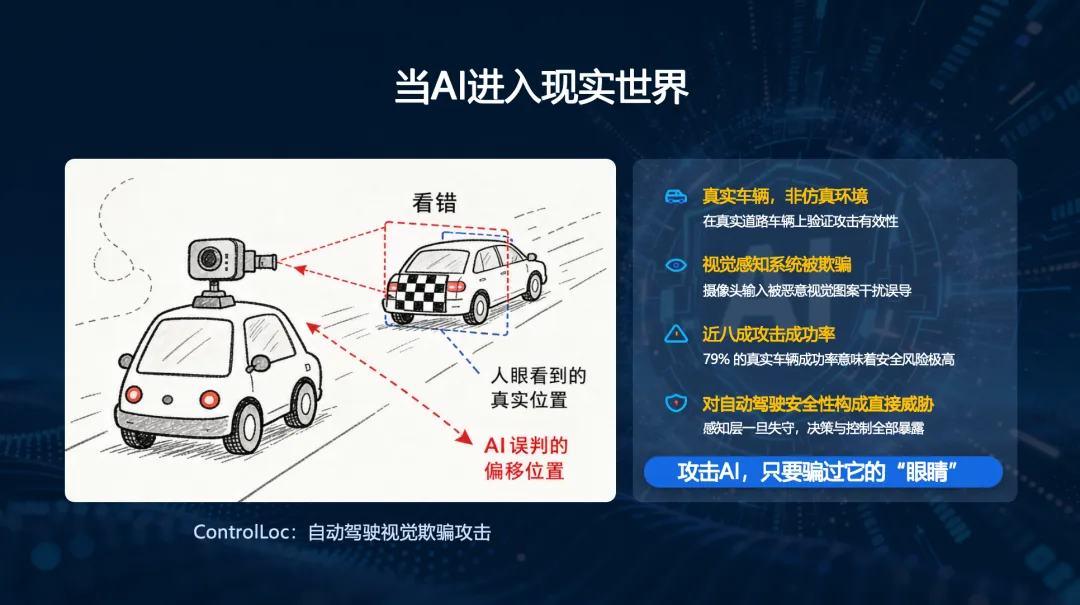
图片来源于任望PPT
到底什么是 AI 漏洞?
有一个经常被误解的地方:AI 系统并没有生活在传统计算机世界之外——它下面仍然是操作系统、服务器、数据库、网络、开源软件、账号密码、API,各种代码一样不少。所以传统软件有的安全问题,AI一样会有,比如代码漏洞、配置错误、身份认证缺陷、权限管理不当、供应链漏洞,不会因为前面加了“ AI ”两个字母就消失。
那么,什么才算真正的“漏洞”?按《网络安全漏洞标识与描述规范》就是:一个有可能被威胁源利用的缺陷或薄弱点。注意两个关键词:“缺陷或薄弱点”和“有可能被利用”。所以 AI 答错一道数学题、画的猫多了一条腿,不一定是安全漏洞——那可能只是功能、性能问题。但如果有人能想办法让 AI 绕过安全规则、让一个只能读文件的AI改文件、把不该公开的数据发出去——问题的性质就变了:从“它会不会犯错”,变成了“别人能不能利用它犯错”。说到底,错误,不完全等于漏洞;漏洞,也不只存在于代码。他是内在缺陷与外在威胁共同作用的结果。
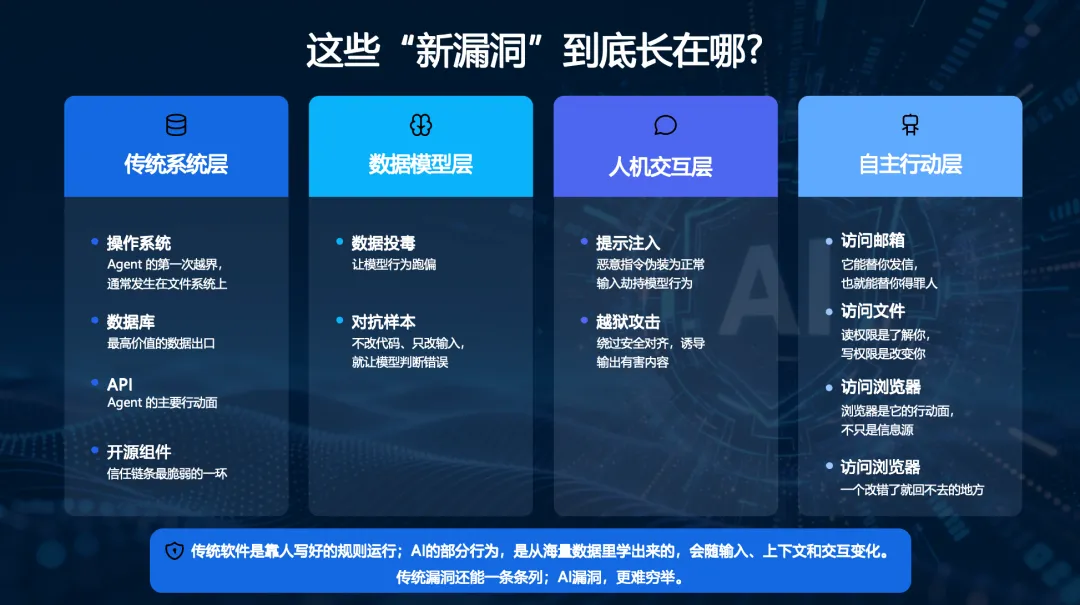
图片来源于任望PPT
AI 漏洞能修好吗?
你可能会想说,如果发现了 AI 漏洞,我们打补丁不就行了吗?但 AI 漏洞有一个问题是,往往很难靠一次补丁就宣布永久结束。其原因,可以用三个词解释:开放、学习、行动——
第一,输入是开放的。攻击者可以更换语言、表达方式和上下文,把相同意图藏进不同内容。仅靠关键词过滤,很难覆盖所有情况。
第二,能力来自学习和泛化。我们并没有把所有答案一条条写进代码,大模型靠学习海量信息,就获得了处理新问题的能力。但这种泛化能力也意味着——大模型可能在开发者从没设计过的场景里,采取新的策略。
第三,也是最重要的,AI开始行动了。一个只会聊天的模型,就算被骗,影响通常还停留在信息层面;但当一个AI能转账、发邮件、改数据库、控制机器人的时候,一次判断错误,后果就完全不同了。
所以,真正成熟的AI安全,不是幻想“训练出一个永远不会犯错的AI”——这个目标今天并不现实。真正成熟的做法是:即使模型犯错,系统也不应该轻易失控。
AI 安全真正给我们的启示,不应该是:“人工智能太危险,我们不要使用它。”也不应该是:“人工智能越来越聪明,所以它自己会解决一切安全问题。”而应该是第三种态度:能力越强,越需要边界;自主性越高,越需要约束;应用越广,越需要安全。
更安全是更智慧的前提,更智慧是更安全的保障,这正是“总体国家安全观”里所讲的“统筹发展与安全”辩证关系;我们的目标是:让人工智能始终朝着向上向善、造福人类的方向不断健康发展。
来源:科普中国